中山大学&华为联合提出 Issue Resolution 数据集构建神器SWE-Factory:每条只要$0.024
还在为构建高质量的软件 Issue 解决数据集而头疼吗?
传统方法不仅耗时耗力,成本更是高得离谱。
中山大学和华为联合提出全新的低成本开源解决方案—— SWE-Factory ,能够通过多智能体框架自动收集 Github 仓库上的代码,一键打造高质量代码评估数据集。
论文:https://arxiv.org/abs/2506.10954
代码:https://github.com/DeepSoftwareAnalytics/swe-factory
1. 代码评估基准的新需求与挑战
最近,为了测试和提升 AI 的编程能力,研究者们开发了很多新的工具。
一类是代码能力的评估基准(软件 Issue 解决数据集),比如有专门用来评估 Python 代码的 SWE-bench、评估多种编程语言代码的 OmniGIRL 和 SWE-bench Multimodal。
还有一类工具提供了完整的训练环境,比如 SWE-Gym 和 SWE-smith,帮助提升这些 AI 模型的编程技能。
但要做一个能真实反映编程能力的评估基准并不简单。传统的构建流程极其繁琐,高度依赖人工,通常会遇到下面的问题:
手动搭建评估环境:搭建数据集的你可能会苦恼于每个 Issue 都需要单独配环境,conda/docker 配置又困难重重;
编写定制的评分脚本:你可能要为不同项目和测试框架编写专门的解析器,来判断测试结果。
进行繁琐的 Fail2pass 验证:你可能要对测试环境反复检查,确保这个软件Issue环境能够判断提交代码的对错。
总而言之,在 SWE-Factory 出现之前,虽然已有的工作在自动化方面取得了显著进展,但始终未能打通数据集构建的"最后一公里",目前,还没有哪个开源工具能从头到尾全自动搞定上面的三个步骤。
而 SWE-Factory 能自动完成从环境搭建、测试验证到质量评估的全流程,将原本需要数小时的手工配置压缩成泡一杯咖啡的时间,大大提高了评估数据集的构建效率。
在这种背景下,SWE-Factory 的出现为全流程自动化构建评估基准走出了一条全新的可行路径,同时也可以帮你自动配置许多场景下的开发环境,可以说是非常方便了。

2. 数据集难以自动化构建:SWE-Factory 的高效解决方案
(一)挑战数据集的自动化构建:SWE-Builder
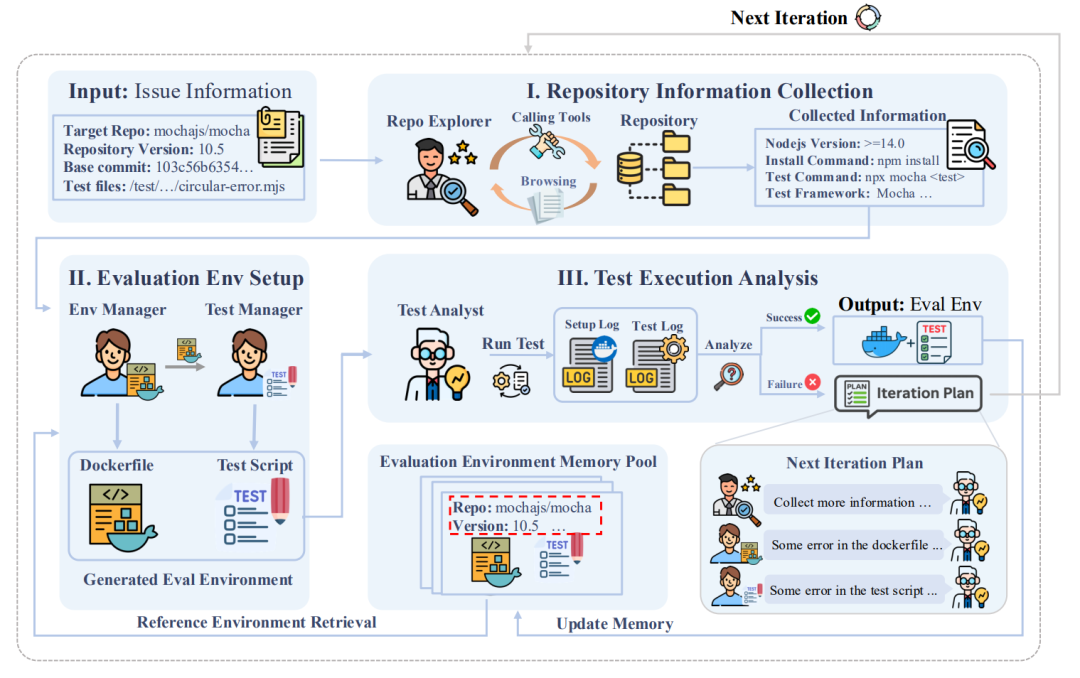
受 GitHub 问题解决数据集构建流程的启发,SWE-Factory 有四个协作 agent 角色模拟手动数据收集过程。
这包括四个 agent:仓库探索者、环境管理者、测试管理者和测试分析师,提出了一个自动化评估环境构建的多智能体框架 SWE-Builder ,能够利用多 agent 进行仓库信息检索、Dockerfile 和评估脚本生成,以及迭代测试分析。
为提高效率和一致性,SWE-Builder 还引入了记忆池(Memory Pool)来复用成功的环境配置(Dockerfile 和测试脚本),通过复用已有配置,避免了从零开始的重复工作,从而加速构建过程。
(二)基于退出码的自动评分方法:让评估方法更简洁
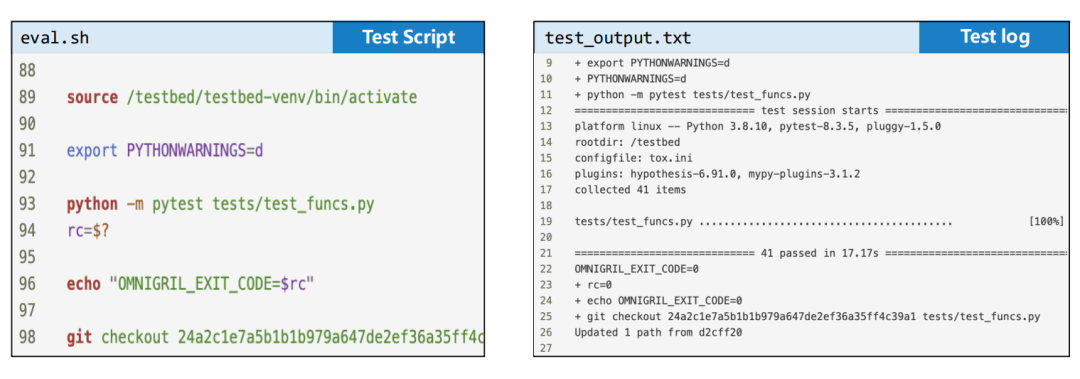
软件工程中普遍采用的一种惯例是使用进程退出码来指示测试结果,其中零退出码通常表示成功,而非零值表示失败。这一做法被广泛的测试框架所采用,例如 pytest、Maven 和 npm。
SWE-Factory 的系统利用这一稳健的惯例来实现自动化评分机制。SWE-Factory 的测试管理器将此逻辑直接集成到每个评估脚本中。它附加命令以捕获主测试命令的退出码,并以标准格式报告。
基于退出码的方法相较于需要自定义日志解析器的方法具有显著优势。测试日志的输出格式在不同编程语言、框架和配置之间可能存在巨大差异,使得开发自定义解析器成为一项费时且易出错的任务。相比之下,SWE-Factory 的方法为评估测试结果提供了一个统一的接口,从而减少了人工检查或复杂的、特定于问题的解析逻辑。
(三)挑战 Fail2pass 的自动化验证
Fail2pass 验证是构建高质量 GitHub 问题解决数据集的关键步骤。此验证的目的是通过确认每个评估环境_在应用真实 Patch 之前的测试套件上运行失败(应用前退出码为非零),在应用后运行通过(应用后退出码为0)_来确保评估的有效性。
然而,在传统方法中存在一个主要瓶颈,它通常需要手动检查大量复杂的测试报告来确定 Patch 前后的结果,这使得 Fail2pass 验证成为一个极其费力的任务。
SWE-Factory 利用基于退出码的评分系统来自动化整个验证过程。它在应用真实 Patch 之前和之后都执行评估脚本,根据一个简单的规则对每次运行的结果进行分类:退出码为 0 表示通过,任何非零值表示失败。只有表现出这种清晰的失败到通过转换的实例才会被 SWE-Factory 保留,确保最终数据集的质量。
名称 | Patch应用前的错误码 | Patch应用后的错误码 |
|---|---|---|
Fail2pass | 非零 | 0 |
Fail2fail | 非零 | 非零 |
Pass2pass | 0 | 0 |
(四)大幅降低数据集构建成本
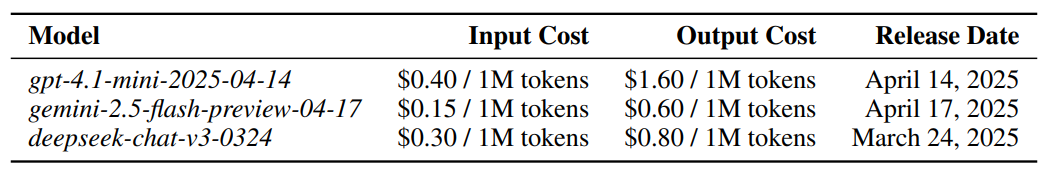
价格:为了降低数据集构建成本, SWE-Factory 使用了相对更加经济实惠的模型 gpt-4.1-mini-2025-04-14、gemini-2.5-flash-preview-04-17 和 deepseek-chat-v3-0324。
时间:SWE-Factory 使用 DeepSeek-v3 构建 Python 任务,可以达到13分钟的平均最短构建时间,在多语言任务中使用 GPT-4.1-mini 的平均构建时间为22分钟,大幅提高了配置数据集环境的效率。
3. 实验与结果:SWE-Factory 的出色表现
(一)数据集:SweSetupBench
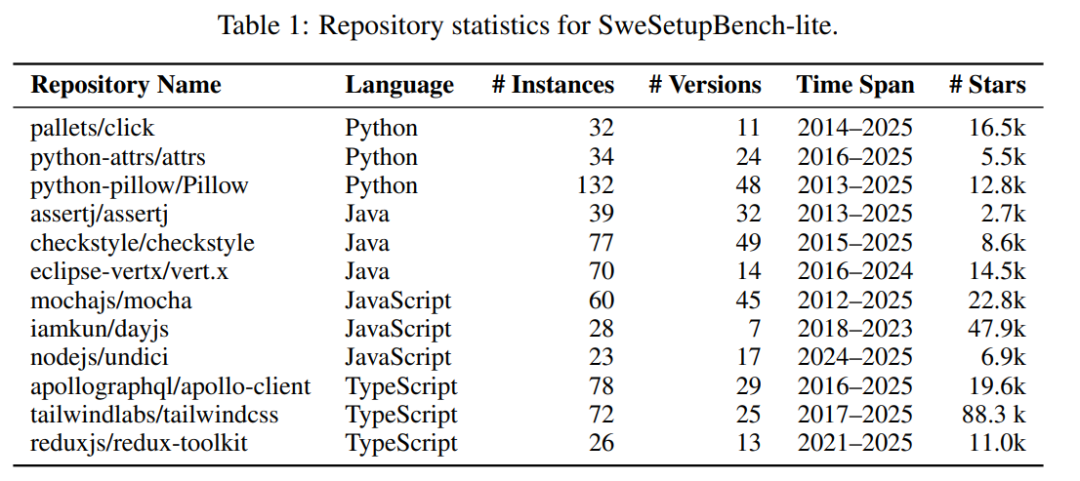
SWE-Factory 构建了一个包含 2,441 个问题的数据集 SweSetupBench,原始数据来自 12 个开源仓库。所有选中的仓库都是知名的开源项目,每个项目在 GitHub 上拥有超过 2.5k 个星标。这些仓库涵盖四种编程语言——Python、Java 、JavaScript 和 TypeScript。SweSetupBench-lite 则包含来自四种编程语言的 12 个仓库的 671 个问题。SWE-Factory 使用这个子集进行评估。
(二)SWE-Builder 能够有效自动化构建数据集
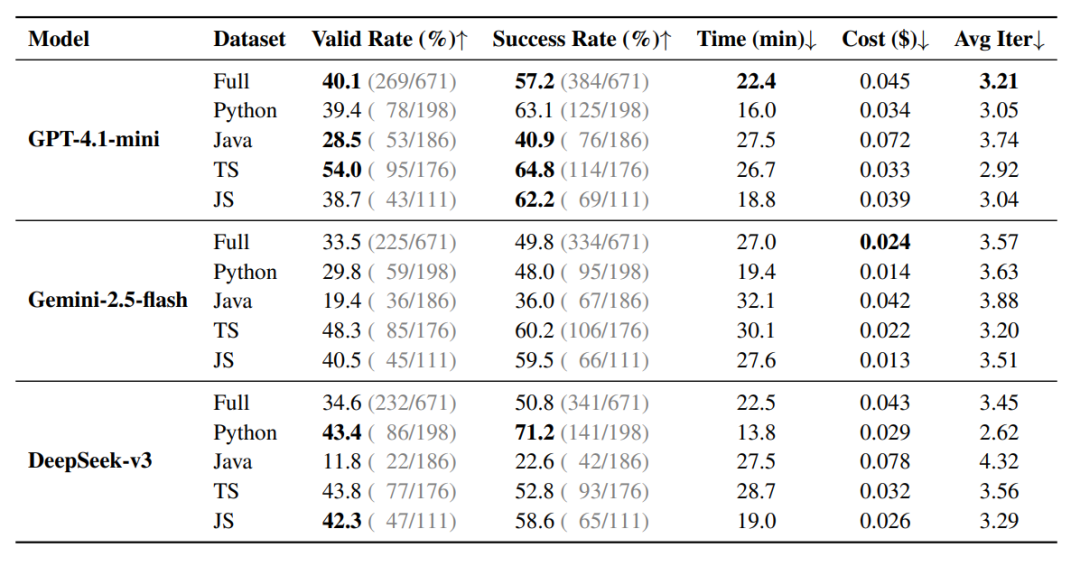
不同模型在不同语言的任务上的表现有所差异:使用 DeepSeek-v3-0324,SWE-Builder 在 Python 和 JavaScript 上表现最佳,而使用 GPT-4.1-mini,它在 Java 和 TypeScript 上构建了最多的有效任务实例。
使用 GPT-4.1-mini:成功构建了 671 个问题中的 269 个有效任务实例(40.1%),平均成本为每个实例 0.045 美元。
使用 Gemini-2.5-flash:成功构建了 225 个有效实例(33.5%),成本最低为 0.024 美元。
使用 DeepSeek-v3-0324:生成了 232 个有效任务实例(34.6%)。
(三)验证基于退出码的方法是否有效
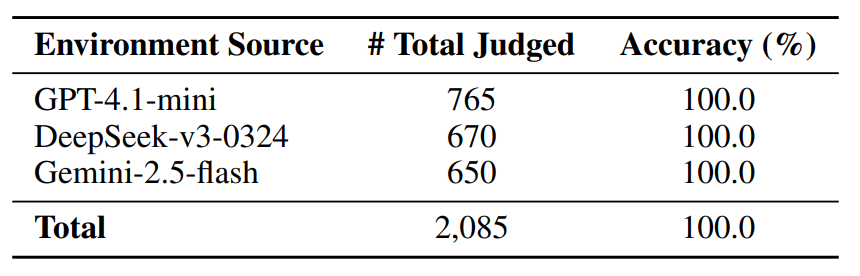
基于退出码的评估方法与人工检查结果一致
基于退出码的方法和人工检查结果具高度重合,用这种方法判断提交代码是否正确能够达到 100% 的准确率。这种方法只需要捕获测试执行后的退出码,而不用解析不同测试框架下的多种日志格式。
基于退出码的方法能够准确识别Fail2pass案例
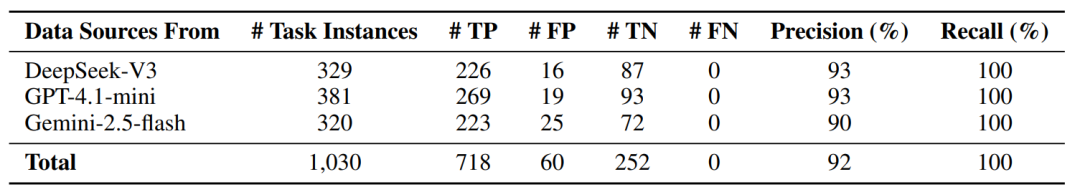
基于退出码的方法在识别 Fail2pass 案例时实现了高召回率(1.00)和高精确率(DeepSeek 为 0.93,GPT 为 0.93,Gemini 为 0.90)。这表明仅使用退出码是一种有效的自动 Fail2pass 验证策略。
(四)意外发现:Error2pass 和Fail2pass 的混淆
基于退出码的方法虽然召回率很高,但精确率存在不足。
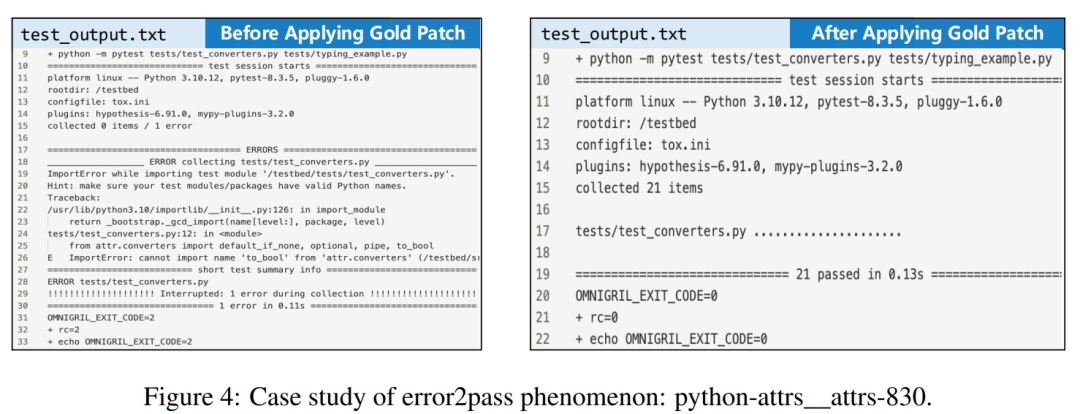
这项工作发现,这些误报并非简单的"失败",而是一种特殊情况:在应用补丁前,测试因代码存在结构性错误(如导入错误,而不是测试样例不通过)而根本无法运行;在应用补丁后,错误被修复,测试才能正常运行并通过。他们将这种现象命名为 Error2pass。
他们提到了一个名为 python-attrs__attrs-830 的典型案例:修复前,一个 ImportError 直接让测试框架在收集阶段崩溃,导致一个测试都没跑成。而打上正确的补丁后,这个错误消失了,所有21个测试都能成功运行并通过。
Error2pass 暴露了现有基准测试中的一个根本缺陷:解决方案与测试代码的"紧密耦合" 。
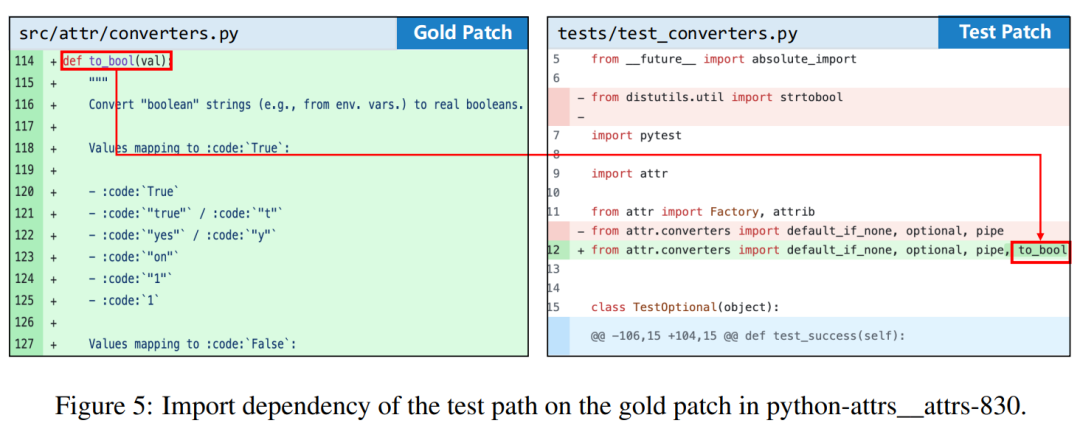
同样在 python-attrs__attrs-830 这个典型案例:一个标准的修复方案不仅引入了新函数 to_bool,其测试代码也同步更新,指定要导入并使用这个函数。这种评估方式很不公平。如果一个AI模型生成了逻辑上完全正确、但函数名叫 to_boolean 的方案,它会被判定为失败,仅仅因为测试代码找不到 to_bool 这个函数名而报错(ImportError)。
为了公正地评估模型,我们必须在构建数据集时,将这些"错误通过"的案例识别并排除出去。
4. 未来展望:开启 Github 问题自动化评估的新篇章
SWE-Factory的研究团队希望这个全自动化的构建流程能够加速大规模、高质量的 GitHub 问题解决数据集的收集,为未来更强大、更通用的代码大模型的训练和评估,提供源源不断的"燃料"。通过降低数据集的构建门槛,他们鼓励更多的研究者能够参与进这项工作,共同构建一个更加丰富和多样化的AI软件工程评测生态。
5. 讨论
SWE-Facory 的研究中一个值得深入讨论的关键发现是 Error2pass 现象。SWE-Factory 的工作为后续研究提供了一个重要启示:在未来构建高质量基准时,需要仔细识别并过滤掉 Error2pass 实例,以确保评估的公正性和准确性。
6. 总结
针对传统GitHub问题解决基准构建流程中,环境搭建、评分和验证等环节高度依赖人工的痛点,来自中山大学和华为的联合团队提出了一个端到端的自动化解决方案 SWE-Factory,有着两大核心创新:
引入了名为 SWE-Builder 的多智能体框架,以AI协作代替人工进行环境配置;
采用了基于退出码的策略,实现了对测试结果的精准自动评分和 自动化 Fail2pass 验证。
实验证明,SWE-Factory 能够高效、低成本地构建有效实例,其自动化验证的准确性也与人工评估完全一致,为社区提供了一个可靠、开源的自动化流程,有力地推动了大规模、高质量软件工程数据集的建设。
备注:昵称-学校/公司-方向/会议(eg.ACL),进入技术/投稿群

id:DLNLPer,记得备注呦

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献66条内容

所有评论(0)