Zynq-7000 双核 Cortex-A9 处理30万点/秒激光雷达点云的可行性理论分析
·
1. Cortex-A9 处理器性能评估
Zynq-7000 系列(如 XC7Z020/030/045)集成双核 Cortex-A9,典型主频 1 GHz,性能基准:
- 理论性能:单核约 2.5 DMIPS/MHz,双核峰值约 5000 DMIPS
- 浮点性能瓶颈:未优化时,纯 CPU 运行 ICP/LOAM 类算法,实时处理能力在 5–10 万点/秒
关键优化技术:NEON SIMD
NEON 是 ARMv7-A 下的 128 位 SIMD 扩展,用于提升浮点密集型点云处理性能。
- 硬件支持:Zynq-7000 SoC 集成 NEON 单元,GCC 编译时添加
-mfpu=neon -mfloat-abi=hard即可启用 - 加速原理:NEON 将多个浮点数(如 4 个单精度)打包到 128 位向量寄存器,通过一条指令并行加法/乘法,减少指令周期。实测在坐标转换和滤波上可获 8 倍以上性能提升
2. 不同复杂度算法的算力需求分析
下表展示 30 万点/秒数据流下,不同算法在双核 Cortex-A9(启用 NEON)上的 CPU 占用率和可行性。
| 算法复杂度 | 典型任务 | NEON 优化后 CPU 占用率 | 结论 |
|---|---|---|---|
| 轻量级 | 1. 极坐标到直角坐标转换 2. 距离/强度阈值去噪 3. UDP 封包与发送 | ≈ 10%–15% | ✅ 完全可行 |
| 中度 | 1. 邻域强度比较(Crosstalk 剔除) 2. 滑动窗口滤波(鬼影消除) | ≈ 25%–40% | ⚠️ 存在实时性风险 |
| 重度 | 1. ICP 迭代计算 2. KD-Tree 最近邻搜索 3. LOAM 特征提取 | > 100%(必掉帧) | ❌ 必须使用 FPGA |
中度算法(如 Crosstalk 剔除)是 CPU 消耗大户。中断处理、任务抢占和 L2 Cache 争用在多个高优先级任务并发时,会导致瞬时峰值,带来延迟抖动甚至丢帧风险。
3. FPGA (PL) 加速方案与 PS-PL 协同设计
当 CPU 性能不足时,利用 PL 进行硬件加速,实现 PS 与 PL 的协同处理。
PS-PL 协同工作流程
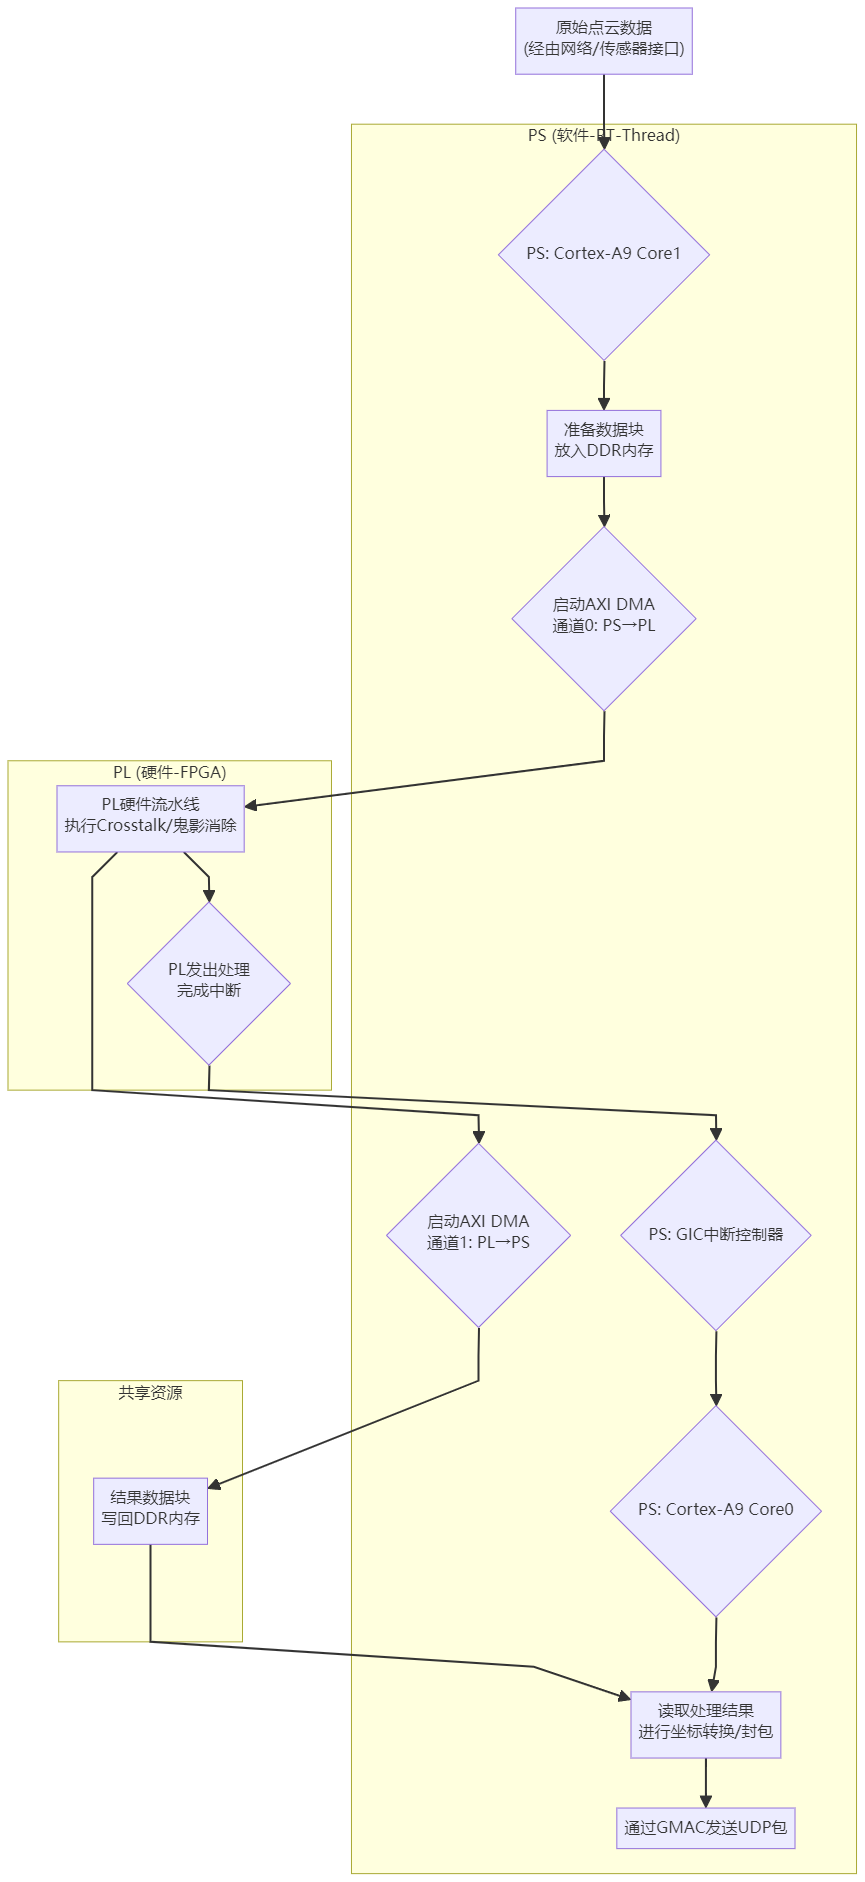
渲染错误: Mermaid 渲染失败: Parse error on line 14:
... subgraph PS 软件 (RT-Thread SMP)
----------------------^
Expecting 'SEMI', 'NEWLINE', 'SPACE', 'EOF', 'GRAPH', 'DIR', 'subgraph', 'SQS', 'end', 'AMP', 'COLON', 'START_LINK', 'STYLE', 'LINKSTYLE', 'CLASSDEF', 'CLASS', 'CLICK', 'DOWN', 'UP', 'NUM', 'NODE_STRING', 'BRKT', 'MINUS', 'MULT', 'UNICODE_TEXT', got 'PS'
DMA/AXI 数据流配置建议
- 核心 IP:AXI DMA,连接 PS 内存(AXI4)和 PL 数据流(AXI4-Stream)
- 数据通路:PS → AXI DMA → PL → AXI DMA → PS
- DMA 配置:
- 双通道模式
- 通道0 (MM2S):DDR 原始点云→PL
- 通道1 (S2MM):PL 结果→DDR
- 传输模式:中断模式,PL 完成后发中断,避免 CPU 轮询
- 突发长度:128 字节或更高,提高 DDR 带宽利用率
- 双通道模式
4. 多核软件架构与任务分配
在双核 Cortex-A9 上运行 RT-Thread SMP,通过线程亲和性优化任务分配。
RT-Thread SMP 支持
RT-Thread 已为 Zynq-7000 提供 SMP 支持,启用 RT_USING_SMP 后,SCU 自动保证缓存一致性。
推荐任务绑定策略
使用 rt_thread_control() 设置 RT_THREAD_CTRL_BIND_CPU,将相关任务绑定到指定核心,降低切换开销、提升缓存命中率。
| 核心 | 核心任务 | 优先级 | 说明 |
|---|---|---|---|
| Core1 | 1. 接收原始数据 2. 预处理并启动 DMA 送往 PL | 25 | 负责数据输入与 PL 交互 |
| Core0 | 1. 响应 PL 中断 2. 读取结果并坐标转换 3. UDP 封包并发送 | 30 | 负责数据输出,优先级更高 |
5. FPGA 资源评估:电机控制与点云去噪处理
典型资源消耗对比:
| 模块 | 资源消耗 | XC7Z020/030 总量 | 占用比例 |
|---|---|---|---|
| 电机控制(PWM+PI) | LUT 2000 DSP 4 BRAM 4 | LUT 53200 DSP 220 BRAM 140 | ≈ 4% 2% 3% |
| Crosstalk 剔除流水线 | LUT 1600 DSP 16 BRAM 8 | 同上 | ≈ 3% 7% 6% |
| 鬼影滤波流水线 | LUT 2000 DSP 24 BRAM 8 | 同上 | ≈ 4% 11% 6% |
| 合计 | LUT 5600 DSP 44 BRAM 20 | 同上 | ≈ 11% 20% 14% |
- 电机控制逻辑资源低,仅需少量 BRAM 存系数,DSP 用于乘加
- Crosstalk 剔除和鬼影滤波流水线用 DSP 计算,LUT 生成地址和状态机,BRAM 存滑动窗口或掩码
- 三者合计占用约 11% LUT、20% DSP、14% BRAM,为后续扩展保留空间
5.1 关键结论
- PL 资源富余,即使增加滤波精度或更复杂电机控制,仍有 > 75% 空间
- 并行流水线将每点延迟稳定在纳秒–微秒级,满足实时要求
- 建议用 HLS 封装公共算子,结合 AXI4-Stream DMA,快速生成可复用硬件模块
6. 核心结论
针对 Zynq-7000 双核 Cortex-A9 是否能实时处理 30 万点/秒点云:
- 轻量级处理:可行,启用 NEON 后 CPU 占用 < 15%
- 中度处理:存在风险,CPU 占用 25%–40%,可能抖动或丢帧
- 重度处理:不可行,ICP、特征提取、KD-Tree 等需依赖 PL 硬件加速

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献6条内容

所有评论(0)