深入理解LSTM、GRU与注意力机制
一、LSTM网络:长短时记忆
LSTM(Long Short-Term Memory) 是传统RNN的改进版,通过引入“门控”结构,有效缓解了梯度消失问题,能够捕捉长序列中的语义关联。
1.1 LSTM的核心结构
LSTM在一个时间步内包含四个关键部分:遗忘门、输入门、细胞状态 和 输出门。
① 遗忘门
决定从上一细胞状态 中丢弃多少信息。
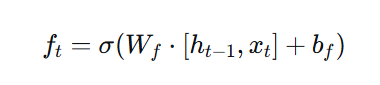
输出 是一个0~1之间的值,1表示“完全保留”,0表示“完全遗忘”。
② 输入门
决定当前输入有多少信息被存入细胞状态。
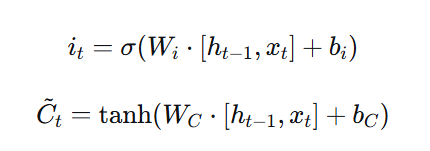
其中 为输入门门值,
为候选细胞状态。
③ 细胞状态更新
将遗忘门和输入门的结果作用于旧细胞状态和候选状态:
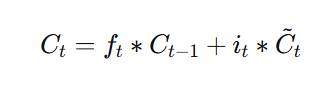
④ 输出门
决定当前时间步的隐层输出 。
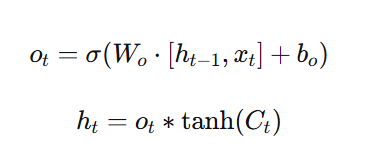
1.2 Bi-LSTM:双向LSTM
双向LSTM 将两个方向相反的LSTM应用于同一序列,并将两个输出拼接起来。这种结构可以捕捉前后文信息,常用于文本分类、序列标注等任务。缺点是参数量翻倍,计算开销更大。
1.3 PyTorch中的LSTM
import torch
import torch.nn as nn

lstm = nn.LSTM(input_size=5, hidden_size=6, num_layers=2, bidirectional=False)
input = torch.randn(1, 3, 5)
h0 = torch.randn(2, 3, 6)
c0 = torch.randn(2, 3, 6)
output, (hn, cn) = lstm(input, (h0, c0))

print(output.shape)  # torch.Size([1, 3, 6])
-
若设置
bidirectional=True,则hidden_size会翻倍输出。 -
LSTM额外需要细胞状态
c0。
1.4 LSTM的优势与缺点
优势:门控机制有效缓解梯度消失,能处理更长序列。
缺点:结构复杂,训练速度慢于传统RNN。
二、GRU网络:门控循环单元
GRU(Gated Recurrent Unit) 是LSTM的简化版本,将遗忘门和输入门合并为更新门,并引入了重置门。GRU参数更少,计算效率更高,但在许多任务上表现与LSTM相当。
2.1 GRU的核心结构
-
更新门 ztzt:控制上一时刻隐层状态有多少被保留。
-
重置门 rtrt:控制上一时刻隐层状态有多少被忽略。
计算公式:
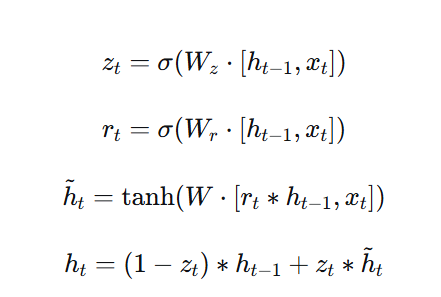
当更新门 接近1时,模型倾向于使用新的候选状态;接近0时,则几乎完全保留旧状态。
2.2 PyTorch中的GRU
import torch
import torch.nn as nn

gru = nn.GRU(input_size=5, hidden_size=6, num_layers=2)
input = torch.randn(1, 3, 5)
h0 = torch.randn(2, 3, 6)
output, hn = gru(input, h0)

print(output.shape)  # torch.Size([1, 3, 6])
2.3 GRU的优势与缺点
优势:效果与LSTM相近,但计算复杂度更低。
缺点:仍无法完全避免梯度消失,且RNN家族固有的不可并行计算问题限制了其在超大规模数据上的应用。
三、注意力机制
3.1 什么是注意力?
注意力机制模仿人类视觉认知:在观察事物时,我们不会从头到尾扫描所有细节,而是将注意力集中在最具有辨识度的部分。在深度学习中,注意力机制通过计算查询(Query)、键(Key)、值(Value)三者的关系,为不同位置分配不同的权重。
3.2 常见的注意力计算规则
-
拼接法:将Q和K拼接后线性变换,再softmax。
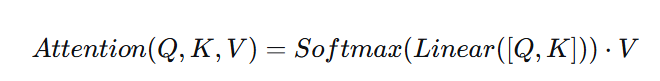
-
加法注意力:拼接后经tanh激活,再求和,最后softmax。
-
点积注意力(缩放点积):
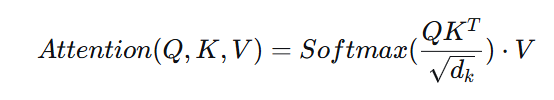
这是Transformer中使用的计算方式。
当 Q=K=VQ=K=V 时,称为自注意力(Self-Attention),用于提取序列内部的特征表示。
3.3 注意力机制的作用
-
解码器端注意力:让解码器在生成每一步时,动态关注编码器输出中的不同部分,解决编码器输出固定长度向量的信息瓶颈问题。
-
编码器端注意力(自注意力):对输入序列进行特征重标定,捕捉长距离依赖关系,是Transformer等大模型的核心组件。
3.4 注意力机制的实现步骤
-
根据计算规则,对Q、K、V进行计算,得到注意力权重矩阵。
-
将权重矩阵与V相乘,得到加权后的特征。
-
(可选)将加权结果与原始Q拼接,再通过线性层得到最终输出。
下面是一个基于“拼接法”的简单注意力模块实现(PyTorch):
import torch
import torch.nn as nn
import torch.nn.functional as F

class Attn(nn.Module):
    def __init__(self, query_size, key_size, value_size1, value_size2, output_size):
        super(Attn, self).__init__()
        self.query_size = query_size
        self.key_size = key_size
        self.value_size1 = value_size1
        self.value_size2 = value_size2
        self.output_size = output_size

        self.attn = nn.Linear(query_size + key_size, value_size1)
        self.attn_combine = nn.Linear(query_size + value_size2, output_size)

    def forward(self, Q, K, V):
        # Q, K, V 形状均为 (batch, seq_len, feature)
        # 这里为简化,假设 batch=1
        attn_weights = F.softmax(self.attn(torch.cat([Q[0], K[0]], 1)), dim=1)
        attn_applied = torch.bmm(attn_weights.unsqueeze(0), V)
        output = torch.cat([Q[0], attn_applied[0]], 1)
        output = self.attn_combine(output).unsqueeze(0)
        return output, attn_weights

# 测试
query_size = 32
key_size = 32
value_size1 = 32
value_size2 = 64
output_size = 64

attn = Attn(query_size, key_size, value_size1, value_size2, output_size)
Q = torch.randn(1, 1, 32)
K = torch.randn(1, 1, 32)
V = torch.randn(1, 32, 64)
out, weights = attn(Q, K, V)
print(out.shape)   # torch.Size([1, 1, 64])
print(weights.shape)  # torch.Size([1, 32])
四、总结
-
LSTM 的门控机制(遗忘门、输入门、输出门)和细胞状态更新,以及双向LSTM。
-
GRU 作为LSTM的轻量级替代,使用更新门和重置门。
-
注意力机制 的基本概念、常见计算规则以及在编码器/解码器中的作用,并给出了一个可运行的注意力模块示例。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)