0413 DataCollator模型微调
·
简介
用的和0412BERT文本分类实例是同一个。
区别:0412用的是Pandas读取;本处用Datasets。
0412的Dataload的collate_fn是自定义的;本处使用DataCollatorWithPadding
这里主要是,对Datasets一个使用,及DataCollatorWithPadding。
注意:这里就是官方提供了个Collator,并不适用与复杂数据!要求输入的Dataset字段=【input_ids , token_type_ids , attention_mask , labels】
Step1 数据加载、预处理
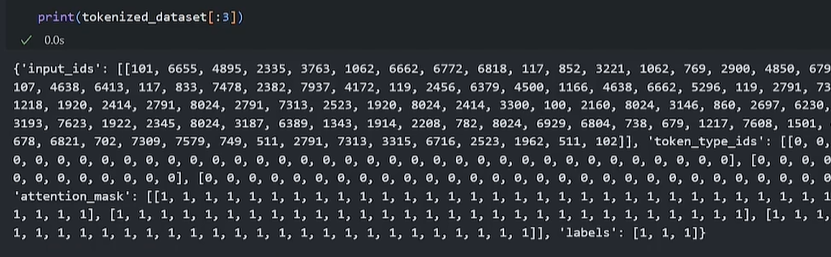
通过load_dataset加载数据、并用filter过滤空数据;再用map对数据进行tokenizer,#截断: truncation=True 。
# 加载数据
dataset = load_dataset("csv"
    , data_files="./ChnSentiCorp_htl_all.csv"
    , split='train')
# 过滤空数据
dataset = dataset.filter(lambda x: x["review"] is not None)
# 划分数据集
datasets = dataset.train_test_split(test_size=0.1)
dataset

def process_function(examples):
    tokenized_examples = tokenizer(examples["review"]
        , max_length=128, truncation=True)
    tokenized_examples["labels"] = examples["label"]
    return tokenized_examples

# 序列化、提取标签。去除非需字段
tokenized_dataset = dataset.map(process_function, batched=True,,
    remove_columns=dataset.column_names)

tokenized_dataset
OutPut:
Step2 创建collator、Dataloader
from torch.utils.data import DataLoader
from transformers import DataCollatorWithPadding

trainset, validset = tokenized_datasets["train"], tokenized_datasets["test"]

trainloader = DataLoader(trainset, batch_size=32, shuffle=True,
     collate_fn=DataCollatorWithPadding(tokenizer))
validloader = DataLoader(validset, batch_size=64, shuffle=False,
    collate_fn=DataCollatorWithPadding(tokenizer))
但是此处,并不会都填充至 max_length;因为,当一个批次里最长数据<max_L时,只需要填充至最长数据。

Step3 模型训练与验证
和0412一样

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)