卡尔曼滤波推导
前言
- 本文主要是跟着B站大佬 DR_CAN 的视频一起推导,并在其基础上添加了部分自己理解。因数学公式过多,可能存在部分字母打错情况。
- 个人邮箱:zhangyixu02@gmail.com
- 微信公众号:风正豪

先置内容
公式符号说明
t:当前时刻t-1:上一时刻^(帽子符号):表示估计值 (不是真实值,真实值永远未知)-(上标负号):表示先验估计 (即预测值,在测量更新之前的值)x:系统的状态向量 (例如:[位置, 速度]ᵀ)P:状态估计的误差协方差矩阵 (表示估计的不确定度)u:控制输入向量 (可选,如果有外部控制则加入)z:测量向量 (传感器读数)A:状态转移矩阵 (描述系统如何从t-1状态演化到t状态,强调惯性)B:控制输入矩阵 (将控制输入u的影响映射到状态,有外力因素导致)H:观测矩阵 (将系统状态x映射到预测测量值)Q:过程噪声协方差矩阵 (描述模型预测的不确定度,噪声w的协方差)R:测量噪声协方差矩阵 (描述传感器测量的不确定度,噪声v的协方差)K:卡尔曼增益 (核心的“权重分配器”)
公式介绍
预测
- 这一步根据上一时刻的最优估计,预测当前时刻的状态。
状态预测(先验状态估计)
- 根据汽车的上一秒位置,以及他的速度,推测它当前所在位置。
预测的位置 = 上一秒最佳估计的位置 + 速度 × 时间间隔
x ^ t − = A x ^ t − 1 + B u t − 1 {\hat{x}_{t}}^{-} = A\hat{x}_{t-1} + Bu_{t-1} x^t−=Ax^t−1+But−1A:状态转移矩阵 (描述系统如何从t-1状态演化到t状态,强调惯性)B:控制输入矩阵 (将控制输入u的影响映射到状态,有外力因素导致)u:控制输入向量 (可选,如果有外部控制则加入)- x ^ t − {\hat{x}_{t}}^{-} x^t−:当前时刻的状态的预测值,也称先验状态估计值
- x ^ t − 1 \hat{x}_{t-1} x^t−1:上一时刻的状态预测值
- u t − 1 u_{t-1} ut−1:上一时刻的外部控制向量(如外部力,风速)
预测协方差(先验误差协方差估计)
- 因为汽车可能因各种因素导致无法匀速运动,所以状态预测方程并不完美,预测后对位置的不确定性会增大。
预测的不可信程度 = 上一秒估计的不可信程度 + 过程噪声
P t − = A P t − 1 A T + Q {P_{t}}^{-} = AP_{t-1}A^{T} + Q Pt−=APt−1AT+QA:状态转移矩阵 (描述系统如何从t-1状态演化到t状态,强调惯性)Q:过程噪声协方差矩阵 (描述模型预测的不确定度,噪声w的协方差)- P t − {P_{t}}^{-} Pt−:预测当前时刻的误差协方差矩阵(估计不确定性)
- P t − 1 P_{t-1} Pt−1:上一时刻的误差协方差矩阵(估计不确定性)
更新
- 这一步利用当前时刻的测量值 z t z_t zt,对预测值进行修正,得到更优的估计。
卡尔曼增益系数
- 权重计算器,计算更相信测量值还是更详细估计值。核心是计算最优的加权系数,以最小化最终估计的误差。
- 如果你的预测非常不可信(分母中“预测的不可信程度”很大),而测量比较可信(“测量的不可信程度”很小),那么卡尔曼增益就接近于1。这意味着你会更相信测量结果。
- 反之,如果测量噪声很大(比如房间回声严重),卡尔曼增益就接近于0。这意味着你会更相信自己的模型预测。
卡尔曼增益 = 预测的不可信程度 / (预测的不可信程度 + 测量的不可信程度)
K t = P t − H T ( H P t − H T + R ) − 1 K_{t} = {P_{t}}^{-} H^{T} (H{P_{t}}^{-} H^{T} + R)^{-1} Kt=Pt−HT(HPt−HT+R)−1R:测量噪声协方差矩阵 (描述传感器测量的不确定度,噪声v的协方差)H:观测矩阵 (将系统状态x映射到预测测量值)- P t − {P_{t}}^{-} Pt−:预测当前时刻的误差协方差矩阵(估计不确定性)
- K t K_{t} Kt:当前时刻的卡尔曼增益值
状态更新 (后验状态估计)
- 根据猜到的汽车位置加上测量到的汽车位置进行加权平均,最终得到最优的估计位置。
最优估计位置 = 预测的位置 + 卡尔曼增益 × (耳朵听到的位置 - 预测的位置)(测量的位置 - 预测的位置)被称为 “新息” ,也就是测量带来的新信息。- 用卡尔曼增益对这个“新信息”进行打折后,加到原来的预测值上,就得到了融合后的、更准确的最佳估计位置。核心是用测量残差和卡尔曼增益来修正预测值。
x ^ t = x ^ t − + K t ( z k − H x ^ t − ) \hat{x}_{t} = {\hat{x}_{t}}^{-} + K_{t}(z_{k}-H{\hat{x}_{t}}^{-}) x^t=x^t−+Kt(zk−Hx^t−) H:观测矩阵 (将系统状态x映射到预测测量值)- x ^ t − {\hat{x}_{t}}^{-} x^t−:当前时刻的状态的预测值,也称先验状态估计值
- K t K_{t} Kt:当前时刻的卡尔曼增益值
- x ^ t \hat{x}_{t} x^t:当前时刻结合了测量值的后验估计值
- z t z_{t} zt:当前时刻的测量值
误差协方差更新 (后验误差协方差估计)
- 经过用测量值修正后,我们融合了两方面的信息,因此最终的“不确定程度”应该比单纯预测时要减小了!
(1 - 卡尔曼增益)这个因子保证了误差协方差会减小。更新估计的误差协方差,为下一次迭代做准备。 当前最佳估计的不可信程度 = (1 - 卡尔曼增益) × 预测的不可信程度
P t = ( I − K t H ) P t − P_{t}=(I-K_{t}H){P_{t}}^{-} Pt=(I−KtH)Pt−H:观测矩阵 (将系统状态x映射到预测测量值)I:维度与状态向量 x ^ k \hat{x}_{k} x^k 的维度相同的单位矩阵- P t − {P_{t}}^{-} Pt−: 当前时刻的先验误差协方差值
- P t P_{t} Pt: 当前时刻的后验误差协方差值
- K t K_{t} Kt:当前时刻的卡尔曼增益值
公式执行顺序
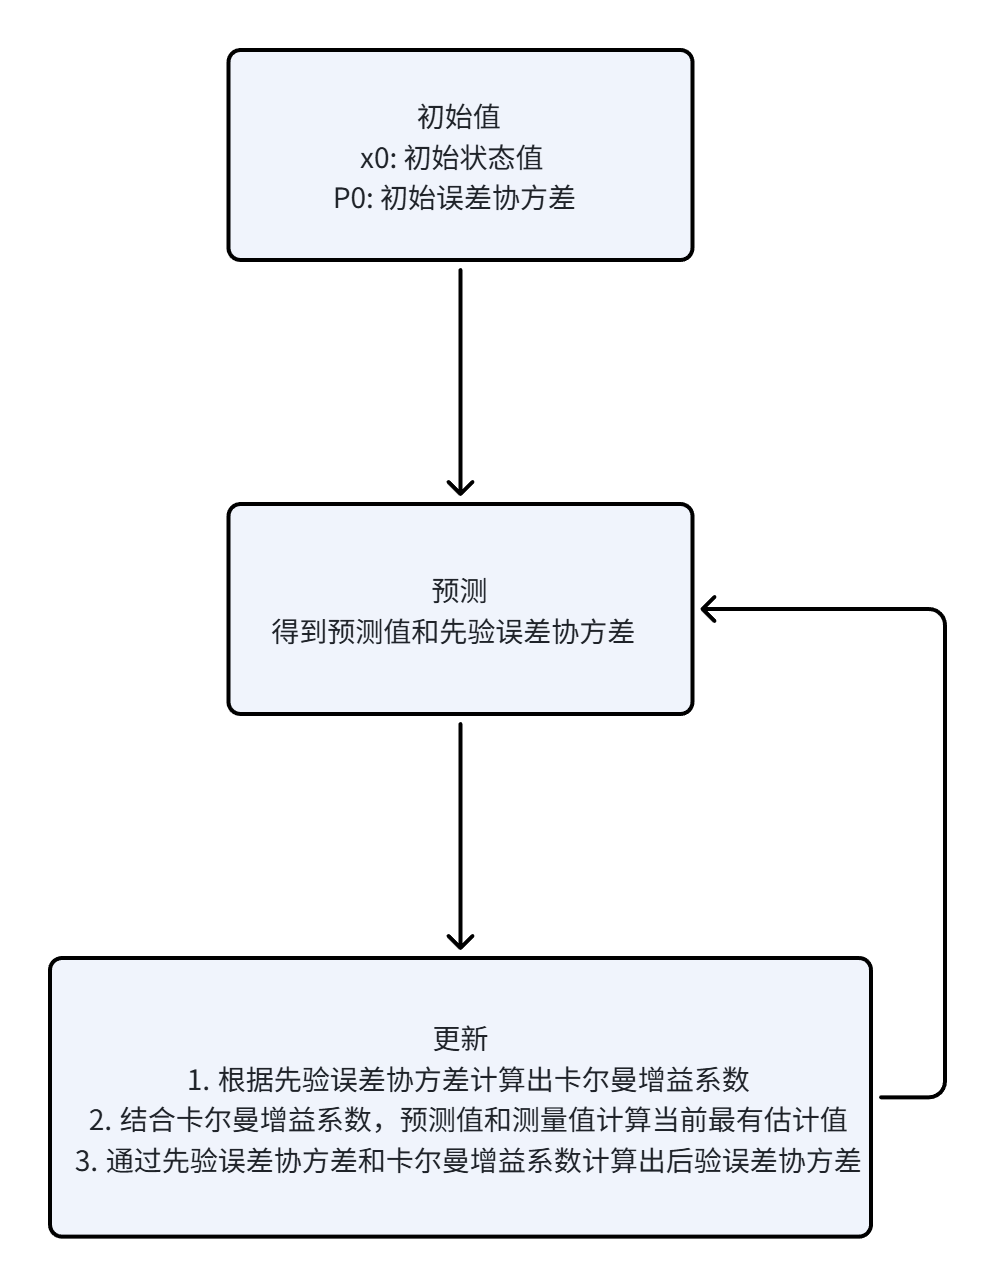
推导所需先置公式
通过矩阵运算计算协方差
-
假设我们一共有n个数据,每个数据有p个特征变量,由此可以组成如下数据矩阵:
X = [ x 11 x 12 . . . x 1 p x 21 x 22 . . . x 2 p . . . . . . . . . . . . x n 1 x n 2 . . . x n p ] X = \begin{bmatrix} x_{11}& x_{12}& ...& x_{1p}& \\ x_{21}& x_{22}& ...& x_{2p}& \\ ...& ... & ... & ... & \\ x_{n1}& x_{n2}& ...& x_{np}& \end{bmatrix} X= x11x21...xn1x12x22...xn2............x1px2p...xnp -
而第 j 个变量的均值为 x ˉ j = 1 n ∑ i = 1 n x i j \bar{x}_{j} = \frac{1}{n}\sum_{i=1}^{n}x_{ij} xˉj=n1∑i=1nxij,其中 j ∈ ( 1 , p ) j \in (1,p) j∈(1,p) , 由此可以得到均值向量:
X ˉ = [ x ˉ 1 x ˉ 2 . . . x ˉ p ] \bar{X} = \begin{bmatrix} \bar{x}_{1}& \bar{x}_{2} & ... &\bar{x}_{p} \end{bmatrix} Xˉ=[xˉ1xˉ2...xˉp] -
将每个元素进行去中心化(每个元素减去对应均值),即中心化矩阵 C 的每个元素为 c i j = x i j − x ˉ j c_{ij} = x_{ij} - \bar{x}_{j} cij=xij−xˉj。将其转换为矩阵形式。
C = [ x 11 x 12 . . . x 1 p x 21 x 22 . . . x 2 p . . . . . . . . . . . . x n 1 x n 2 . . . x n p ] − [ 1 1 . . . 1 ] [ x ˉ 1 x ˉ 2 . . . x ˉ p ] = X − I X ˉ = [ c 11 c 12 . . . c 1 p c 21 c 22 . . . c 2 p . . . . . . . . . . . . c n 1 c n 2 . . . c n p ] \begin{aligned} C &= \begin{bmatrix} x_{11}& x_{12}& ...& x_{1p}& \\ x_{21}& x_{22}& ...& x_{2p}& \\ ...& ... & ... & ... & \\ x_{n1}& x_{n2}& ...& x_{np}& \end{bmatrix} - \begin{bmatrix} 1\\ 1\\ ...\\ 1\\ \end{bmatrix} \begin{bmatrix} \bar{x}_{1}& \bar{x}_{2} & ... &\bar{x}_{p} \end{bmatrix} \\ &= X - I\bar{X} \\ &= \begin{bmatrix} c_{11}& c_{12}& ...& c_{1p}& \\ c_{21}& c_{22}& ...& c_{2p}& \\ ...& ... & ... & ... & \\ c_{n1}& c_{n2}& ...& c_{np}& \end{bmatrix} \end{aligned} C= x11x21...xn1x12x22...xn2............x1px2p...xnp − 11...1 [xˉ1xˉ2...xˉp]=X−IXˉ= c11c21...cn1c12c22...cn2............c1pc2p...cnp
- X X X : 数据矩阵
- I I I : 为 n×1 的全 1 列向量
- X ˉ \bar{X} Xˉ : 长度为 p 的均值向量
- 我们再来看看协方差的定义,对于两个随机变量 a 和 b,根据协方差定义
C
o
v
(
X
,
Y
)
=
E
[
(
X
−
E
[
x
]
)
(
Y
−
E
(
Y
)
)
]
Cov(X,Y)=E[(X-E[x])(Y-E(Y))]
Cov(X,Y)=E[(X−E[x])(Y−E(Y))]我们可以推导出如下公式:
C o v ( a , b ) = E [ ( a − E [ a ] ) ( b − E ( b ) ) ] = 1 n ∑ i = 1 n ( x i a − x ˉ a ) ( x i b − x ˉ b ) = 1 n ∑ i = 1 n c i a c i b = E [ c c T ] = 1 n C T C \begin{aligned} Cov(a,b) &= E[(a-E[a])(b-E(b))] \\ &= \frac{1}{n}\sum_{i=1}^{n}(x_{ia}-\bar{x}_{a})(x_{ib}-\bar{x}_{b}) \\ &= \frac{1}{n}\sum_{i=1}^{n} c_{ia}c_{ib} \\ &= E[cc^{T}] \\ &= \frac{1}{n}C^{T}C \end{aligned} Cov(a,b)=E[(a−E[a])(b−E(b))]=n1i=1∑n(xia−xˉa)(xib−xˉb)=n1i=1∑nciacib=E[ccT]=n1CTC
相互独立且服从正态分布的随机变量叠加
- 此时我们需要复习概率论的内容,两个相互独立且服从正态分布的随机变量,如果分别表示为 X 1 ε N ( μ 1 , δ 1 2 ) X_{1} \varepsilon N(\mu _{1}, \delta ^{2}_{1}) X1εN(μ1,δ12)$ 和 $ X 2 ε N ( μ 2 , δ 2 2 ) X_{2} \varepsilon N(\mu _{2}, \delta ^{2}_{2}) X2εN(μ2,δ22)
- 此时将上面两个变量进行直接相加,即表示对两个变量进行融合,那么最终的分布为 X 1 + X 2 ε N ( μ 1 + μ 2 , δ 1 2 + δ 2 2 ) X_{1} + X_{2} \varepsilon N(\mu _{1} + \mu _{2}, \delta ^{2}_{1} + \delta ^{2}_{2}) X1+X2εN(μ1+μ2,δ12+δ22)
公式推导
状态预测方程(方程一)
-
假设此时是一个线性系统,且噪声为高斯分布。以匀速直线运动的小车为例,我们可以推导出如下两个公式:
-
位置变化公式 :
S t = S t − 1 + V t − 1 △ t S_{t} = S_{t-1} + V_{t-1}\bigtriangleup t St=St−1+Vt−1△t -
速度变化公式 :
V t = V t − 1 V_{t} = V_{t-1} Vt=Vt−1 -
如上两个公式用矩阵形式表示为:
x ^ t = [ S t V t ] = [ 1 △ t 0 1 ] [ S t − 1 V t − 1 ] \hat{x}_{t} = \begin{bmatrix}S_{t }\\ V_{t}\end{bmatrix} = \begin{bmatrix}1& \bigtriangleup t\\ 0&1\end{bmatrix} \begin{bmatrix}S_{t-1}\\ V_{t-1}\end{bmatrix} x^t=[StVt]=[10△t1][St−1Vt−1] -
由此,我们可以得到如果没有外力因素在,描述系统自身如何演化的状态转移矩阵 A = [ 1 △ t 0 1 ] A = \begin{bmatrix} 1& \bigtriangleup t\\ 0& 1\end{bmatrix} A=[10△t1], 并可以得到描述预测状态的矩阵
x ^ t = [ S t V t ] = A x ^ t − 1 \hat{x}_{t} = \begin{bmatrix}S_{t }\\ V_{t}\end{bmatrix} = A\hat{x}_{t-1} x^t=[StVt]=Ax^t−1
-
-
此时我们加上一个外力,使其进行匀加速运动,因此有如下两个公式:
-
位置变化公式 :
S t = S t − 1 + V t − 1 △ t + 1 2 a t − 1 △ t 2 S_{t } = S_{t-1} + V_{t-1}\bigtriangleup t + \frac{1}{2}a_{t-1}\bigtriangleup t ^{2} St=St−1+Vt−1△t+21at−1△t2 -
速度变化公式 :
V t = V t − 1 + a t − 1 △ t V_{t} = V_{t-1} + a_{t-1}\bigtriangleup t Vt=Vt−1+at−1△t -
此时我们对上述两个公式用矩阵的方式表达出来 :
x ^ t = [ S t V t ] = [ 1 △ t 0 1 ] [ S t − 1 V t − 1 ] + [ 1 2 △ t 2 △ t ] a t − 1 \hat{x}_{t} = \begin{bmatrix} S_{t}\\ V_{t} \end{bmatrix} = \begin{bmatrix} 1& \bigtriangleup t\\ 0& 1 \end{bmatrix}\begin{bmatrix} S_{t-1}\\ V_{t-1} \end{bmatrix} + \begin{bmatrix} \frac{1}{2}\bigtriangleup t ^{2}\\ \bigtriangleup t \end{bmatrix}a_{t-1} x^t=[StVt]=[10△t1][St−1Vt−1]+[21△t2△t]at−1 -
由此我们可以得到外力因素变化的控制输入矩阵 B = [ 1 2 △ t 2 △ t ] B = \begin{bmatrix} \frac{1}{2}\bigtriangleup t ^{2}\\ \bigtriangleup t \end{bmatrix} B=[21△t2△t] 和控制输入量 u t − 1 = a t − 1 u_{t-1} = a_{t-1} ut−1=at−1
-
-
最终我们可以得到匀加速直线运动小车的物理状态预测模型:
x ^ t = [ S ^ t V ^ t ] = [ 1 △ t 0 1 ] [ S ^ t − 1 V ^ t − 1 ] + [ 1 2 △ t 2 △ t ] a t − 1 = A x ^ t − 1 + B u t − 1 ( 1.0 ) \begin{aligned} \hat{x}_{t}&= \begin{bmatrix}\hat{S}_{t}\\ \hat{V}_{t}\end{bmatrix} \\ &= \begin{bmatrix} 1& \bigtriangleup t\\ 0& 1\end{bmatrix}\begin{bmatrix}\hat{S}_{t-1}\\ \hat{V}_{t-1}\end{bmatrix} +\begin{bmatrix}\frac{1}{2}\bigtriangleup t ^{2}\\ \bigtriangleup t\end{bmatrix}a_{t-1} \\ &=A\hat{x}_{t-1} + Bu_{t-1} \end{aligned} \quad (1.0) x^t=[S^tV^t]=[10△t1][S^t−1V^t−1]+[21△t2△t]at−1=Ax^t−1+But−1(1.0)
状态方程与观测方程
-
上述情况是针对理想匀加速直线运动小车的模型。但是会因为各种外部因素干扰,存在一个环境噪声。因此,我们可以知道,小车真实位置应该是还有一个误差值 ω t − 1 \omega_{t-1} ωt−1而这个误差符合高斯分布。
x t = [ S t V t ] = A x ^ t − 1 + B u t − 1 + ω t = [ 1 △ t 0 1 ] [ S ^ t − 1 V ^ t − 1 ] + [ 1 2 △ t 2 △ t ] a t − 1 + [ 1 2 △ t 2 △ t ] ω a t = A x ^ t − 1 + B u t − 1 + ω t ( 2.0 ) \begin{aligned} x_{t} &= \begin{bmatrix}S_{t}\\ V_{t}\end{bmatrix} \\ &= A\hat{x}_{t-1} + Bu_{t-1} + \omega_{t}\\ &= \begin{bmatrix} 1& \bigtriangleup t\\ 0& 1\end{bmatrix} \begin{bmatrix}\hat{S}_{t-1}\\ \hat{V}_{t-1}\end{bmatrix} +\begin{bmatrix}\frac{1}{2}\bigtriangleup t ^{2}\\ \bigtriangleup t\end{bmatrix}a_{t-1} + \begin{bmatrix} \frac{1}{2}\bigtriangleup t ^{2}\\ \bigtriangleup t \end{bmatrix}\omega_{at} \\ &= A\hat{x}_{t-1} + Bu_{t-1}+ \omega_{t} \end{aligned} \quad (2.0) xt=[StVt]=Ax^t−1+But−1+ωt=[10△t1][S^t−1V^t−1]+[21△t2△t]at−1+[21△t2△t]ωat=Ax^t−1+But−1+ωt(2.0)- ω t \omega_{t} ωt : 当前时刻的误差矩阵,符合高斯分布
- ω a t \omega_{at} ωat : 虽然我们模型是假设为匀加速直线运动,但是小车的加速度可能会发生随机变化,如路面不平,外部风速影响等待。但是该参数整体成高斯分布,数学期望为0
-
除了对小车进行预测,我们还可以通过一些仪器知道小车的位置,例如超声波测距。
- 我们知道超声波的测距的原理本质上是 S t = z m t 2 S_{t} = \frac{z_{mt}}{2} St=2zmt,其中 z m t z_{mt} zmt 表示当前时刻超声波的测量值
- 而测量工具测量都是存在其误差的,例如温度环境不同的声音速度不同,声波传播声音的测量误差等等都会导致测量值出现偏差,因此实际的测量值应该等于实际小车位置加上观测噪声 :
z m t = 2 S t + u t = [ 2 0 ] [ S t V t ] + u t = H x t + u t ( 2.1 ) z_{mt} = 2S_{t} + u_{t} = \begin{bmatrix}2 && 0\end{bmatrix}\begin{bmatrix} S_{t}\\ V_{t} \end{bmatrix} + u_{t} = Hx_{t}+ u_{t}\quad (2.1) zmt=2St+ut=[20][StVt]+ut=Hxt+ut(2.1)
数据融合(最优估计/后验估计,方程二)
-
我们假定现在有一个小车停在某个位置,此时用测距工具测量其距离,因为测距工具存在一个高斯分布的误差。所以我们可以进行多次测量,取平均值,随着测量次数增加,其测量值会逐渐逼近真实值。因此可得如下公式:
x t ^ = x m 1 + x m 2 + x m 3 + . . . + x m t t = 1 t t − 1 t − 1 ( x m 1 + x m 2 + x m 3 + . . . + x m t − 1 ) + x m k t = t − 1 t x m 1 + x m 2 + x m 3 + . . . + x m t − 1 t − 1 + x m t t = x ^ t − − 1 t x ^ t − + 1 t x ^ m t = x ^ t − + 1 t ( x ^ m t − x ^ t − ) ( 3.0 ) \begin{aligned} \hat{x_{t}}&=\frac{x_{m1}+x_{m2}+x_{m3}+...+x_{mt}}{t} \\ &=\frac{1}{t}\frac{t-1}{t-1}(x_{m1}+x_{m2}+x_{m3}+...+x_{mt-1})+\frac{x_{mk}}{t} \\ &= \frac{t-1}{t}\frac{x_{m1}+x_{m2}+x_{m3}+...+x_{mt-1}}{t-1}+\frac{x_{mt}}{t} \\ &=\hat{x}_{t}^{-}-\frac{1}{t}\hat{x}_{t}^{-}+\frac{1}{t}\hat{x}_{mt} \\ &= \hat{x}_{t}^{-} + \frac{1}{t}(\hat{x}_{mt}-\hat{x}_{t}^{-}) \end{aligned} \quad (3.0) xt^=txm1+xm2+xm3+...+xmt=t1t−1t−1(xm1+xm2+xm3+...+xmt−1)+txmk=tt−1t−1xm1+xm2+xm3+...+xmt−1+txmt=x^t−−t1x^t−+t1x^mt=x^t−+t1(x^mt−x^t−)(3.0)- 为什么 x m 1 + x m 2 + x m 3 + . . . + x m t − 1 t − 1 = x ^ t − \frac{x_{m1}+x_{m2}+x_{m3}+...+x_{mt-1}}{t-1} = \hat{x}_{t}^{-} t−1xm1+xm2+xm3+...+xmt−1=x^t− 这个很多人可能无法理解。一开始我也是不太明白,后面突然想到,因为我们知道小车位置是停止不动的,那么我们就假设当前位置就是之前测量的值求平均即为当前的位置,这个也称之为先验估计值。
- 这里需要注意,测量值并不准确,这里是测量后的估计值,所以要写成 x ^ m t \hat{x}_{mt} x^mt
-
根据上述公式推导,我们可以知道,
当前时刻的估计值 = 上一时刻估计值 + (当前时刻测量值 - 上一时刻估计值) / 测量次数。 -
而 (3.0) 式子公式中的 1 t \frac{1}{t} t1 我们可以替换成 G t G_{t} Gt值,即表示当前时刻是更相信测量值还是更相信估计值,此时公式为 x t ^ = x ^ t − + G t ( x ^ m t − x ^ t − ) ( 3.1 ) \hat{x_{t}}=\hat{x}_{t}^{-} + G_{t}(\hat{x}_{mt}-\hat{x}_{t}^{-})\quad (3.1) xt^=x^t−+Gt(x^mt−x^t−)(3.1)
-
如果我们当前时刻更加相信测量值,那么让 G t = 1 G_{t} = 1 Gt=1,那么 x t ^ = x ^ m t \hat{x_{t}} = \hat{x}_{mt} xt^=x^mt
-
如果我们当前时刻更加相信估计值,那么让 G t = 0 G_{t} = 0 Gt=0,那么 x t ^ = x t − 1 ^ \hat{x_{t}} = \hat{x_{t-1}} xt^=xt−1^
-
我们需要知道 G t ϵ ( 0 , 1 ) G_{t} \epsilon (0,1) Gtϵ(0,1)
-
然后又知道观测方程(因为是估计值,所以此时不考虑噪音干扰) z m t = H x ^ m t z_{mt} = H\hat{x}_{mt} zmt=Hx^mt,将公式两边都左乘观测矩阵的逆可得 H − z m t = x ^ m t H^{-}z_{mt} = \hat{x}_{mt} H−zmt=x^mt
-
我们将 H − z m t = x ^ m t H^{-}z_{mt} = \hat{x}_{mt} H−zmt=x^mt带入 (3.1) 式子,即可得到
x t ^ = x ^ t − + G t ( x ^ m t − x ^ t − ) = x ^ t − + G t ( H − z m t − x ^ t − ) ( 3.2 ) \begin{aligned} \hat{x_{t}}&=\hat{x}_{t}^{-}+ G_{t}(\hat{x}_{mt}-\hat{x}_{t}^{-}) \\ &= \hat{x}_{t}^{-}+G_{t}(H^{-}z_{mt} - \hat{x}_{t}^{-}) \end{aligned} \quad (3.2) xt^=x^t−+Gt(x^mt−x^t−)=x^t−+Gt(H−zmt−x^t−)(3.2) -
之后再令 G t = K t H G_{t}=K_{t}H Gt=KtH带入 (3.2) 式子,即可得到
x t ^ = x ^ t − + G t ( H − z m t − x ^ t − ) = x ^ t − + K t ( z m t − H x ^ t − ) ( 3.3 ) \begin{aligned} \hat{x_{t}} &= \hat{x}_{t}^{-}+G_{t}(H^{-}z_{mt} - \hat{x}_{t}^{-}) \\ &= \hat{x}_{t}^{-}+K_{t}(z_{mt} - H\hat{x}_{t}^{-}) \end{aligned} \quad (3.3) xt^=x^t−+Gt(H−zmt−x^t−)=x^t−+Kt(zmt−Hx^t−)(3.3) -
上述公式就是大多数课本中的卡尔曼滤波公式,其中 K t K_{t} Kt为卡尔曼增益,其范围 K t ϵ ( 0 , H − ) K_{t} \epsilon (0,H^{-}) Ktϵ(0,H−)
-
卡尔曼增益计算(方程三)
-
现在我们有了卡尔曼的状态估计方程,此时就需要知道这个卡尔曼增益系数为多少才能让估计值会逐步向真实值收敛。
- 我们就假定真实值为 x t x_{t} xt,此时的估计误差为 e t = x t − x t ^ = [ e s t e v t ] ( 4.0 ) e_{t} = x_{t} - \hat{x_{t}} = \begin{bmatrix}e_{st} \\e_{vt}\end{bmatrix} \quad (4.0) et=xt−xt^=[estevt](4.0)。
- e s t e_{st} est: 位置误差,例如小车会因为路面湿滑导致漂移,期望值为0,标准差为 δ 1 \delta _{1} δ1
- e v t e_{vt} evt: 速度误差,例如小车会因为摩擦力导致速度变化,期望值为0,标准差为 δ 2 \delta _{2} δ2
-
我们现在知道融合估计值和测量值后的值为正态分布,那么我们就需要想办法让融合后的方差最小,那么就会越靠近真实值。我们将 (3.3) 与 (2.1) 式带入 (4.0) 式中可得如下内容
e t = x t − x t ^ = x t − [ x ^ t − + K t ( z m t − H x ^ t − ) ] = x t − x ^ t − − K t z m t + K t H x ^ t − = ( x t − x ^ t − ) − K t ( H x t + u t ) + K t H x ^ t − = ( x t − x ^ t − ) − K t H ( x t − x ^ t − ) − K t u t = ( I − K t H ) ( x t − x ^ t − ) − K t u t = ( I − K t H ) e t − − K t u t ( 4.1 ) \begin{aligned} e_{t} &= x_{t} - \hat{x_{t}} \\ &= x_{t} - [\hat{x}_{t}^{-}+K_{t}(z_{mt} - H\hat{x}_{t}^{-})] \\ &= x_{t} - \hat{x}_{t}^{-} - K_{t}z_{mt} + K_{t}H\hat{x}_{t}^{-}\\ &= (x_{t} - \hat{x}_{t}^{-}) - K_{t}(Hx_{t}+ u_{t}) + K_{t}H\hat{x}_{t}^{-}\\ &= (x_{t} - \hat{x}_{t}^{-}) - K_{t}H(x_{t} -\hat{x}_{t}^{-}) - K_{t}u_{t}\\ &= (I - K_{t}H)(x_{t} - \hat{x}_{t}^{-}) - K_{t}u_{t}\\ &= (I - K_{t}H)e_{t}^{-} - K_{t}u_{t} \end{aligned} \quad (4.1) et=xt−xt^=xt−[x^t−+Kt(zmt−Hx^t−)]=xt−x^t−−Ktzmt+KtHx^t−=(xt−x^t−)−Kt(Hxt+ut)+KtHx^t−=(xt−x^t−)−KtH(xt−x^t−)−Ktut=(I−KtH)(xt−x^t−)−Ktut=(I−KtH)et−−Ktut(4.1)- 这里用 (2.1) 式是因为是用的真实值带入, z m t = H x ^ m t = H x t + u t z_{mt} = H\hat{x}_{mt}=Hx_{t}+ u_{t} zmt=Hx^mt=Hxt+ut
-
然后我们知道协方差矩阵为去中心化矩阵乘以去中心化矩阵的转置的期望 。然而,由于过程噪声和测量噪声的数学期望均为0。因此有如下推导
C o v ( a , b ) = E [ ( e i a − E [ a ] ) ( e i b − E [ b ] ) ] = E [ e i a e i b ] = E [ e e T ] = [ δ 1 2 δ 1 δ 2 δ 2 δ 1 δ 2 2 ] ( 4.2 ) \begin{aligned} Cov(a,b)&= E[(e_{ia}-E[a])(e_{ib}-E[b])] \\ &= E[e_{ia}e_{ib}] &\\ &= E[ee^{T}]\\ &= \begin{bmatrix} \delta ^{2}_{1} & \delta _{1} \delta _{2}\\ \delta _{2} \delta _{1} & \delta ^{2}_{2} \end{bmatrix} \end{aligned} \quad (4.2) Cov(a,b)=E[(eia−E[a])(eib−E[b])]=E[eiaeib]=E[eeT]=[δ12δ2δ1δ1δ2δ22](4.2) -
我们将 e t = ( I − K t H ) e t − − K t u t e_{t} =(I - K_{t}H)e_{t}^{-} - K_{t}u_{t} et=(I−KtH)et−−Ktut 带入可得到如下内容
P t = E [ e t e t T ] = E [ ( ( I − K t H ) e t − − K t u t ) ( ( I − K t H ) e t − − K t u t ) T ] = E [ ( ( I − K t H ) e t − − K t u t ) ( e t − T ( I − K t H ) T − u t T K t T ) ] = E [ ( I − K t H ) e t − e t − T ( I − K t H ) T − K t u t e t − T ( I − K t H ) T − ( I − K t H ) e t − u t T K t T + K t u t u t T K t T ] ( 4.3 ) \begin{aligned} P_{t} &= E[e_{t}e_{t}^{T}] \\ &= E[((I - K_{t}H)e_{t}^{-} - K_{t}u_{t}) ((I - K_{t}H)e_{t}^{-} - K_{t}u_{t})^{T}] \\ &= E[((I - K_{t}H)e_{t}^{-} - K_{t}u_{t}) (e_{t}^{-T}(I - K_{t}H)^{T}- u_{t}^{T}K_{t}^{T})] \\ &= E[(I - K_{t}H)e_{t}^{-}e_{t}^{-T}(I - K_{t}H)^{T} - K_{t}u_{t}e_{t}^{-T}(I - K_{t}H)^{T} -(I - K_{t}H)e_{t}^{-}u_{t}^{T}K_{t}^{T} + K_{t}u_{t}u_{t}^{T}K_{t}^{T}] \end{aligned} \quad (4.3) Pt=E[etetT]=E[((I−KtH)et−−Ktut)((I−KtH)et−−Ktut)T]=E[((I−KtH)et−−Ktut)(et−T(I−KtH)T−utTKtT)]=E[(I−KtH)et−et−T(I−KtH)T−Ktutet−T(I−KtH)T−(I−KtH)et−utTKtT+KtututTKtT](4.3) -
因为先验误差 e t − e_{t}^{-} et−是依赖于 t-1 及之前的随机变量,而观测噪声是 t 时刻所出现的。因此两者为互相独立的随机变量。因此 E [ u t e t − T ] = E [ e t − T u t ] = 0 E[u_{t}e_{t}^{-T}] = E[e_{t}^{-T}u_{t}] = 0 E[utet−T]=E[et−Tut]=0,带入(4.3)式子中即可消除掉第二和第三项式子,可得
P t = E [ ( I − K t H ) e t − e t − T ( I − K t H ) T ] + E [ K t u t u t T K t T ] ( 4.4 ) P_{t} = E[(I - K_{t}H)e_{t}^{-}e_{t}^{-T}(I - K_{t}H)^{T}] + E[K_{t}u_{t}u_{t}^{T}K_{t}^{T}]\quad (4.4) Pt=E[(I−KtH)et−et−T(I−KtH)T]+E[KtututTKtT](4.4) -
因为 I I I是一个全为1的对称矩阵( I = I T I = I^{T} I=IT), K t K_{t} Kt 和 H H H都为常量,先验误差矩阵 P t − = E ( e t − e t − T ) P_{t}^{-} = E(e_{t}^{-}e_{t}^{-T}) Pt−=E(et−et−T),观测误差矩阵 R t = E ( u t u t T ) R_{t} = E(u_{t}u_{t}^{T}) Rt=E(ututT) , 所以误差矩阵最终可写为
P t = E [ ( I − K t H ) e t − e t − T ( I − K t H ) T ] + E [ K t u t u t T K t T ] = ( I − K t H ) E [ e t − e t − T ] ( I − K t H ) T + K t E [ u t u t T ] K t T = ( I − K t H ) P t − ( I − K t H ) T + K t R t K t T = ( I − K t H ) P t − ( I T − H T K t T ) + K t R t K t T = ( P t − − K t H P t − ) ( I T − H T K t T ) + K t R t K t T = P t − − K t H P t − − P t − H T K t T + K t H P t − H T K t T + K t R t K t T ( 4.5 ) \begin{aligned} P_{t} &= E[(I - K_{t}H)e_{t}^{-}e_{t}^{-T}(I - K_{t}H)^{T}] + E[K_{t}u_{t}u_{t}^{T}K_{t}^{T}] \\ &= (I - K_{t}H)E[e_{t}^{-}e_{t}^{-T}](I - K_{t}H)^{T} + K_{t}E[u_{t}u_{t}^{T}]K_{t}^{T} \\ &= (I - K_{t}H)P_{t}^{-}(I - K_{t}H)^{T} + K_{t}R_{t}K_{t}^{T} \\ &= (I - K_{t}H)P_{t}^{-}(I^{T} - H^{T}K_{t}^{T})+ K_{t}R_{t}K_{t}^{T} \\ &= (P_{t}^{-} - K_{t}HP_{t}^{-})(I^{T} - H^{T}K_{t}^{T})+ K_{t}R_{t}K_{t}^{T}\\ &= P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + K_{t}HP_{t}^{-}H^{T}K_{t}^{T}+ K_{t}R_{t}K_{t}^{T} \end{aligned} \quad (4.5) Pt=E[(I−KtH)et−et−T(I−KtH)T]+E[KtututTKtT]=(I−KtH)E[et−et−T](I−KtH)T+KtE[ututT]KtT=(I−KtH)Pt−(I−KtH)T+KtRtKtT=(I−KtH)Pt−(IT−HTKtT)+KtRtKtT=(Pt−−KtHPt−)(IT−HTKtT)+KtRtKtT=Pt−−KtHPt−−Pt−HTKtT+KtHPt−HTKtT+KtRtKtT(4.5) -
我们的最终目标是找到一个状态估计值 x t ^ \hat{x_{t}} xt^ 总体上最接近真实值 x t x_{t} xt。对于多变量系统,误差是一个向量 e t = x t − x t ^ = [ δ 1 δ 2 ] e_{t} = x_{t} - \hat{x_{t}} = \begin{bmatrix}\delta _{1} \\\delta _{2}\end{bmatrix} et=xt−xt^=[δ1δ2],我们需要一个标量来衡量这个向量的“总体大小”。
- 因此我们选择一个最常用且数学性质良好的衡量标准是均方误差(Mean Squared Error, MSE),即误差向量各分量平方的期望值之和: M S E = E [ e 1 2 ] + E [ e 2 2 ] + . . . + E [ e n 2 ] MSE = E[e_{1}^{2}] + E[e_{2}^{2}] + ... + E[e_{n}^{2}] MSE=E[e12]+E[e22]+...+E[en2]
- 上述写法在数学中我们将其称之为迹
t
r
(
P
t
)
tr(P_{t})
tr(Pt)
- 由迹的定义可知 : t r ( A ) = t r ( A T ) tr(A)=tr(A^{T}) tr(A)=tr(AT)
- 又因为先验协方差矩阵是堆成矩阵
P
t
−
=
P
t
−
T
P_{t}^{-} =P_{t}^{-T}
Pt−=Pt−T,带入(4.5)式,因此误差矩阵的迹最终可表示为
t r ( P t ) = t r ( P t − − K t H P t − − P t − H T K t T + K t H P t − H T K t T + K t R t K t T ) = t r ( P t − ) − t r ( K t H P t − ) − t r ( ( K t H P t − ) T + t r ( K t H P t − H T K t T ) + t r ( K t R t K t T ) ) = t r ( P t − ) − 2 t r ( K t H P t − ) + t r ( K t H P t − H T K t T ) + t r ( K t R t K t T ) ) ( 4.6 ) \begin{aligned} tr(P_{t}) &= tr(P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + K_{t}HP_{t}^{-}H^{T}K_{t}^{T}+ K_{t}R_{t}K_{t}^{T}) \\ &= tr(P_{t}^{-}) - tr(K_{t}HP_{t}^{-}) - tr((K_{t}HP_{t}^{-})^{T} + tr(K_{t}HP_{t}^{-}H^{T}K_{t}^{T}) + tr(K_{t}R_{t}K_{t}^{T})) \\ &= tr(P_{t}^{-}) - 2tr(K_{t}HP_{t}^{-}) + tr(K_{t}HP_{t}^{-}H^{T}K_{t}^{T}) + tr(K_{t}R_{t}K_{t}^{T})) \end{aligned} \quad (4.6) tr(Pt)=tr(Pt−−KtHPt−−Pt−HTKtT+KtHPt−HTKtT+KtRtKtT)=tr(Pt−)−tr(KtHPt−)−tr((KtHPt−)T+tr(KtHPt−HTKtT)+tr(KtRtKtT))=tr(Pt−)−2tr(KtHPt−)+tr(KtHPt−HTKtT)+tr(KtRtKtT))(4.6)
- 同时迹的计算存在三个公式
- d t r ( A B ) d A = B T \frac{\mathrm{d} tr(AB)}{\mathrm{d} A}= B^{T} dAdtr(AB)=BT
- d t r ( A B A T ) d A = A ( B + B T ) \frac{\mathrm{d} tr(ABA^{T})}{\mathrm{d} A}= A(B+B^{T}) dAdtr(ABAT)=A(B+BT)
- 当B为对称矩阵( B = B T B=B^{T} B=BT )有 d t r ( A B A T ) d A = A ( B + B T ) = 2 A B \frac{\mathrm{d} tr(ABA^{T})}{\mathrm{d} A}= A(B+B^{T}) = 2AB dAdtr(ABAT)=A(B+BT)=2AB
-
我们既然知道可以用迹来衡量向量的误差大小,只要让误差矩阵的迹 t r ( P t ) tr(P_{t}) tr(Pt) 值为最小,那么我们测量的值就会越靠近真实值。(4.6) 式子中,观测矩阵
H是个常量,先验误差 P t − P_{t}^{-} Pt−依赖于先前状态符合正态分布的随机波动值。因此,我们当前可确定的只有卡尔曼增益系数 K t K_{t} Kt。 -
现在我们的目标就很清晰了,要求卡尔曼增益 K t K_{t} Kt 为何值时,误差矩阵的迹 t r ( P t ) tr(P_{t}) tr(Pt) 值为最小。根据大一的高数课可知,要求某个最小点,只需要对该函数求导,并判断 K t K_{t} Kt 减少一点点,其导数小于0, K t K_{t} Kt 增大一点点,其导数大于0。且有且只有一个 K t K_{t} Kt 值令函数的导数为0,那么此时的 K t K_{t} Kt 值为函数值最小点。
-
我们首先让其求导
d t r ( P t ) d K t = d t r ( P t − ) − 2 t r ( K t H P t − ) + t r ( K t H P t − H T K t T ) + t r ( K t R t K t T ) d K t = 0 − 2 ( H P t − ) T + 2 K t H P t − H T + 2 K t R t = 2 K t ( H P t − H T + R t ) − 2 ( H P t − ) T ( 4.7 ) \begin{aligned} \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}} &= \frac{\mathrm{d} tr(P_{t}^{-}) - 2tr(K_{t}HP_{t}^{-}) + tr(K_{t}HP_{t}^{-}H^{T}K_{t}^{T}) + tr(K_{t}R_{t}K_{t}^{T})}{\mathrm{d} K_{t}} \\ &= 0 - 2(HP_{t}^{-})^{T} + 2K_{t}HP_{t}^{-}H^{T} + 2K_{t}R_{t} \\ &= 2K_{t}(HP_{t}^{-}H^{T} + R_{t}) - 2(HP_{t}^{-})^{T} \end{aligned} \quad (4.7) dKtdtr(Pt)=dKtdtr(Pt−)−2tr(KtHPt−)+tr(KtHPt−HTKtT)+tr(KtRtKtT)=0−2(HPt−)T+2KtHPt−HT+2KtRt=2Kt(HPt−HT+Rt)−2(HPt−)T(4.7) -
之后令 d t r ( P t ) d K t = 0 \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}} = 0 dKtdtr(Pt)=0 可得 K t = ( H P t − ) T H P t − H T + R t = P t − H T H P t − H T + R t K_{t} = \frac{(HP_{t}^{-})^{T}}{HP_{t}^{-}H^{T} + R_{t}} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} Kt=HPt−HT+Rt(HPt−)T=HPt−HT+RtPt−HT 时, d t r ( P t ) d K t = 0 \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}} = 0 dKtdtr(Pt)=0
-
此时我们需要证明 K t = P t − H T H P t − H T + R t K_{t} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} Kt=HPt−HT+RtPt−HT 时, t r ( P t ) tr(P_{t}) tr(Pt)为最小值
-
当 K t = P t − H T H P t − H T + R t + lim x → 0 x K_{t} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} + \lim_{x \to 0}x Kt=HPt−HT+RtPt−HT+limx→0x,其中的 x 为一个无限接近0的正数,此时有如下推论
d t r ( P t ) d K t = 2 ( P t − H T H P t − H T + R t + lim x → 0 x ) ( H P t − H T + R t ) − 2 ( H P t − ) T = 2 lim x → 0 x ( H P t − H T + R t ) > 0 ( 4.8 ) \begin{aligned} \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}} &= 2(\frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} + \lim_{x \to 0}x)(HP_{t}^{-}H^{T} + R_{t}) - 2(HP_{t}^{-})^{T}\\ &= 2 \lim_{x \to 0}x(HP_{t}^{-}H^{T} + R_{t})> 0 \end{aligned} \quad (4.8) dKtdtr(Pt)=2(HPt−HT+RtPt−HT+x→0limx)(HPt−HT+Rt)−2(HPt−)T=2x→0limx(HPt−HT+Rt)>0(4.8) -
当 K t = P t − H T H P t − H T + R t − lim x → 0 x K_{t} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} - \lim_{x \to 0}x Kt=HPt−HT+RtPt−HT−limx→0x,其中的 x 为一个无限接近0的正数,此时有如下推论
d t r ( P t ) d K t = 2 ( P t − H T H P t − H T + R t − lim x → 0 x ) ( H P t − H T + R t ) − 2 ( H P t − ) T = − 2 lim x → 0 x ( H P t − H T + R t ) < 0 ( 4.8 ) \begin{aligned} \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}} &= 2(\frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} - \lim_{x \to 0}x)(HP_{t}^{-}H^{T} + R_{t}) - 2(HP_{t}^{-})^{T}\\ &= -2 \lim_{x \to 0}x(HP_{t}^{-}H^{T} + R_{t}) < 0 \end{aligned} \quad (4.8) dKtdtr(Pt)=2(HPt−HT+RtPt−HT−x→0limx)(HPt−HT+Rt)−2(HPt−)T=−2x→0limx(HPt−HT+Rt)<0(4.8) -
因为 K t ε [ 0 , P t − H T H P t − H T + R t ) K_{t} \varepsilon [0 ,\frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}}) Ktε[0,HPt−HT+RtPt−HT) 时 d t r ( P t ) d K t < 0 \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}}< 0 dKtdtr(Pt)<0,当 K t ε ( P t − H T H P t − H T + R t , H − ] K_{t} \varepsilon ( \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}},H^{-}] Ktε(HPt−HT+RtPt−HT,H−] 时 d t r ( P t ) d K t > 0 \frac{\mathrm{d} tr(P_{t})}{\mathrm{d} K_{t}}> 0 dKtdtr(Pt)>0。因此 K t = P t − H T H P t − H T + R t ( 4.9 ) K_{t} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}}\quad (4.9) Kt=HPt−HT+RtPt−HT(4.9) 时, t r ( P t ) tr(P_{t}) tr(Pt)为最小值
-
先验误差协方差矩阵(方程四)
- 上面求解卡尔曼增益过程中 H 观测矩阵 (将系统状态x映射到预测测量值) 是已知的常量,而先验误差协方差矩阵
P
t
−
=
E
(
e
t
−
e
t
−
T
)
P_{t}^{-} = E(e_{t}^{-}e_{t}^{-T})
Pt−=E(et−et−T) 目前却无法得知,由此需要进一步推导计算。
-
首先我们推导先验误差
e t − = x t − x ^ t − = A x t − 1 + B u t − 1 + ω t − 1 − A x t − 1 − − B u t − 1 = A ( x t − 1 − x t − 1 − ) + ω t − 1 = A e t − 1 + ω t − 1 ( 5.0 ) \begin{aligned} e_{t}^{-} &= x_{t} - \hat{x}_{t}^{-} \\ &= Ax_{t-1} + Bu_{t-1}+ \omega_{t-1} - Ax_{t-1}^{-} - Bu_{t-1} \\ &= A(x_{t-1} - x_{t-1}^{-}) + \omega_{t-1} \\ &= Ae_{t-1}+ \omega_{t-1} \end{aligned} \quad (5.0) et−=xt−x^t−=Axt−1+But−1+ωt−1−Axt−1−−But−1=A(xt−1−xt−1−)+ωt−1=Aet−1+ωt−1(5.0) -
再将先验误差带入先验误差协方差矩阵中可得
P t − = E ( e t − e t − T ) = E [ ( A e t − 1 + ω t − 1 ) ( A e t − 1 + ω t − 1 ) T ] = E [ ( A e t − 1 + ω t − 1 ) ( e t − 1 T A T + ω t − 1 T ) ] = E [ A e t − 1 e t − 1 T A T + ω t − 1 e t − 1 T A T + ω t − 1 e t − 1 T A T + ω t − 1 ω t − 1 T ] ( 5.1 ) \begin{aligned} P_{t}^{-} &= E(e_{t}^{-}e_{t}^{-T}) \\ &= E[(Ae_{t-1}+ \omega_{t-1})(Ae_{t-1}+ \omega_{t-1})^{T}]\\ &= E[(Ae_{t-1}+ \omega_{t-1}) (e_{t-1}^{T}A^{T} + \omega_{t-1}^{T})] \\ &= E[Ae_{t-1}e_{t-1}^{T}A^{T} + \omega_{t-1}e_{t-1}^{T}A^{T} + \omega_{t-1}e_{t-1}^{T}A^{T} + \omega_{t-1}\omega_{t-1}^{T}] \end{aligned} \quad (5.1) Pt−=E(et−et−T)=E[(Aet−1+ωt−1)(Aet−1+ωt−1)T]=E[(Aet−1+ωt−1)(et−1TAT+ωt−1T)]=E[Aet−1et−1TAT+ωt−1et−1TAT+ωt−1et−1TAT+ωt−1ωt−1T](5.1) -
又因为误差 e t − 1 e_{t-1} et−1是依赖于 t-1 之前的随机变量,而过程噪声 ω t − 1 \omega_{t-1} ωt−1 是 t-1 时刻所出现的。因此两者为互相独立的随机变量,即 E [ ω t − 1 e t − 1 − T ] = E [ e t − 1 − T ω t − 1 ] = 0 E[\omega_{t-1}e_{t-1}^{-T}] = E[e_{t-1}^{-T}\omega_{t-1}] = 0 E[ωt−1et−1−T]=E[et−1−Tωt−1]=0,带入(5.1)式子中即可消除掉第二和第三项式子,可得
P t − = E [ A e t − 1 e t − 1 T A T + ω t − 1 ω t − 1 T ] = A E [ e t − 1 e t − 1 T ] A T + E [ ω t − 1 ω t − 1 T ] = A P t − 1 A T + Q ( 5.2 ) \begin{aligned} P_{t}^{-} &= E[Ae_{t-1}e_{t-1}^{T}A^{T} + \omega_{t-1}\omega_{t-1}^{T}] \\ &=AE[e_{t-1}e_{t-1}^{T}]A^{T} + E[ \omega_{t-1}\omega_{t-1}^{T}] \\ &=AP_{t-1}A^{T} + Q \end{aligned} \quad (5.2) Pt−=E[Aet−1et−1TAT+ωt−1ωt−1T]=AE[et−1et−1T]AT+E[ωt−1ωt−1T]=APt−1AT+Q(5.2) -
因此我们知道先验误差协方差矩阵 P t − P_{t}^{-} Pt− 依赖于 t-1 时刻的估计误差 P t − 1 P_{t-1} Pt−1,A 状态转移矩阵 (描述系统如何从k-1状态演化到k状态) 为常量,误差矩阵 Q Q Q 是一个随机值
-
后验误差协方差矩阵(方程五)
-
在求解卡尔曼增益系数时,我们有式 (4.5)
P t = P t − − K t H P t − − P t − H T K t T + K t H P t − H T K t T + K t R t K t T P_{t} = P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + K_{t}HP_{t}^{-}H^{T}K_{t}^{T}+ K_{t}R_{t}K_{t}^{T} Pt=Pt−−KtHPt−−Pt−HTKtT+KtHPt−HTKtT+KtRtKtT -
我们将计算出来的卡尔曼增益 K t = P t − H T H P t − H T + R t K_{t} = \frac{P_{t}^{-}H^{T}}{HP_{t}^{-}H^{T} + R_{t}} Kt=HPt−HT+RtPt−HT 带入,可得
P t = P t − − K t H P t − − P t − H T K t T + K t H P t − H T K t T + K t R t K t T = P t − − K t H P t − − P t − H T K t T + K t ( H P t − H T K t T + R t ) K t T = P t − − K t H P t − − P t − H T K t T + P t − H T K t T = P t − − K t H P t − = ( I − K t H ) P t − ( 6.0 ) \begin{aligned} P_{t} &= P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + K_{t}HP_{t}^{-}H^{T}K_{t}^{T}+ K_{t}R_{t}K_{t}^{T}\\ &= P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + K_{t}(HP_{t}^{-}H^{T}K_{t}^{T} + R_{t})K_{t}^{T}\\ &= P_{t}^{-} - K_{t}HP_{t}^{-} - P_{t}^{-}H^{T}K_{t}^{T} + P_{t}^{-}H^{T}K_{t}^{T}\\ &= P_{t}^{-} - K_{t}HP_{t}^{-} = (I - K_{t}H)P_{t}^{-} \end{aligned} \quad (6.0) Pt=Pt−−KtHPt−−Pt−HTKtT+KtHPt−HTKtT+KtRtKtT=Pt−−KtHPt−−Pt−HTKtT+Kt(HPt−HTKtT+Rt)KtT=Pt−−KtHPt−−Pt−HTKtT+Pt−HTKtT=Pt−−KtHPt−=(I−KtH)Pt−(6.0)
参考

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献5条内容

所有评论(0)