【武大遥感空信】空间智能计算与服务课程实习(任务一)
目录
1. 目的
掌握运用空间智能算法解决实际问题的能力,能够自主的处理原始数据,针对现实的具体问题设计合适的智能算法并达成目标。理解 GIS 服务运行原理,掌握运用开源平台工具进行空间信息处理服务创建、发布及访问的基本方法及流程,具备发布真实数据的能力。
2. 内容
碳达峰,碳中和是我国的重大战略。我国温室气体监测网络的建设相对落后,为此生态环境部在 2021 年出台了《碳监测评估试点工作方案》指导地方和行业建设温室气体监测网络。目前,站点的选址依靠定性分析和个人经验。本实验要求自行选择所学的空间智能优化算法用于温室气体监测站点的选址。
温室气体监测站的效力主要由当地风场和排放源的空间分布决定,某个站点观测到的浓度信息可以用下式进行描述:
式中y∗是站点观测到的因排放引起的浓度增强,该值越大说明站点对观测区域排放的监测能力越强。x∗是一个 m×n 维度的通量场,用于描述每个位置温室气体排放的强度,H 被称为足迹矩阵,它是一个 m×n 维度的矩阵,用来描述不同地点排放对观测站浓度的贡献程度。
本实验提供了一个 0.1°分辨的甲烷通量场(Global Fuel Exploitation Inventory v2 2019 Total Fuel Exploitation)和 49 个足迹场(footprints 文件夹)。

Footprints 文件夹中的文件名包含网格的中心点坐标,由于 footprint 的计算要消耗很大的计算量,我们在 7×7 个 0.1°×0.1°的网上格上计算了足迹矩阵(如图 1 彩色部分示例)。 对于每个 0.1°×0.1°(约等于 10 km×10 km)的网格,我们进一步将其细分为 10×10 个 1 km×1 km 的子网格。我们进一步假设足迹的形态在一个大网格内保持一致,但空间位置会随着观测站点在不同的小网格有所平移。
观测站的位置可以位于任意一个小网格上。请使用智能算法找出 5 个观测站的位置(C49005 个可行解),以建立一个观测网络,确保其观测效力最高。
本实验不规定编程语言,不限制软件使用。实验报告应该至少包含以下信息:
- 优化后观测站点的位置,即 5 站点的具体坐标,要求使用 WGS84 坐标系,单位为°,精度为 0.01°。在本实验中假设经度及纬度方向 1°=100 km;
- 观测网的总体 H 矩阵形态,即实验步骤 1(3)得到的多站点 H 合并结果;
- 观测网的总体观测效力,即实验步骤 1(4)得到的结果;
- 其他相关信息,如经过插值得到的 1km 分辨甲烷通量场图,5 个站点数量下最优站点分布图。
访问 https://earth.jpl.nasa.gov/emit-mmgis/?mission=EMIT。它是 NASA 制作的一个发布甲烷浓度数据的网站。

参照 NASA 网站形式,将上述信息:
- 温室气体排放甲烷通量场
- 经智能优化计算得出的五个站点位置
- 合并五个站点 H 矩阵形态
以标准 OGC Web 服务形式进行发布,服务类型(WMS、WMTS、WFS、WCS 等)可自定。最终的发布的服务基于某种卫星地图(调用、集成网上公开的 WMS 即可)并显示于不同图层。
3. 条件
完成本项实验的基本条件如下:
- PC 机(笔记本或台式计算机),
- 空间数据处理及服务管理平台(含服务器及工具客户端),
- 程序语言开发调试工具软件——VS Code;
- 撰写实验报告的文字处理应用软件——WPS Office。
4. 参考资料
- 本实验选用的 GIS 平台软件官方操作使用指南、课程参考书及 PPT 课件。
- GeoServer 官网:https://geoserver.org/
- Standards - Open Geospatial Consortium:https://www.ogc.org/standards/
- NASA 甲烷浓度信息网站:https://earth.jpl.nasa.gov/emit-mmgis/?mission=EMIT
5. 数据描述与分析
5.1. 本实验提供数据
- 名为Global_Fuel_Exploitation_Inventory_v2_2019_Total_Fuel_Exploitation的TIFF文件,包含0.1°分辨率的甲烷通量场数据。
- footprints文件夹,其中包含49个csv文件,每个csv文件代表了以某个大方格中心为参考点的足迹矩阵,均为270行*270列。每个csv文件名称描述了其足迹矩阵对应大方格中心的地理坐标(纬度,经度)。
5.2. 数据使用思路
通过49个csv文件可以得知7*7=49个大方格的中心地理坐标,而每个大方格又可拆分为10*10=100个小方格,故我们也可以得知任意一个小方格的中心地理坐标。
所以只要给定一个小方格位置,就能读入其所属的大方格的足迹矩阵,然后转换至以该小方格位置为中心的新足迹矩阵。
同理,给定五个小方格位置,就能得到五个这样的新足迹矩阵。
有了五个足迹矩阵,就能将它们融合为一个整体的大矩阵,并且可以根据五个小方格地理坐标计算出大矩阵的空间位置信息。
再将这个大矩阵作为H矩阵,只要与x*矩阵(甲烷通量矩阵)相乘即可得到y*(监测强度)。
实验提供的TIFF文件为0.1°分辨率的甲烷通量场数据,而通过上述方式计算出的H矩阵为0.01°分辨率,两者不可直接相乘。
因此,要让两者相乘,首先需要对甲烷通量场数据TIFF图进行空间插值,得到0.01°分辨率的新通量TIFF图。
插值完成后,从TIFF数据中截取出H矩阵对应空间范围的数据形成x*矩阵,便可进行公式计算。
最后引入智能计算算法(遗传算法、粒子群算法、蚁群算法),从70*70=4900个小方格位置中选取5个位置,使计算出的y*值最大。
6. 核心算法与工具
本次实验过程中使用到的算法有:
- GDAL双线性插值算法,用于对tif文件进行空间插值,以精细化分辨率;
- 矩阵偏移与变换算法,用于求解不同小方格空间位置对应的足迹矩阵;
- 遗传算法、粒子群算法、蚁群算法,用于智能计算优化五个小方格点位的选择。
本次实验过程中使用到的工具有:
- VS Code,进行python程序编写;
- Conda,进行python环境搭建;
- GDAL,用于对tif文件进行插值与重采样;
- QGIS,用于可视化tif栅格图像;
- GeoServer,用于发布Web服务。
7. 步骤
7.1. 站点位置计算
7.1.1. TIFF数据插值
由于实验提供的Global_Fuel_Exploitation_Inventory_v2_2019_Total_Fuel_Exploitation.tif和Global_Fuel_Exploitation_Inventory_v2_2019_Total_Fuel_Exploitation.tif.aux.xml提供的数据为0.1°分辨率的甲烷通量场数据,为了能与0.01°分辨率的足迹矩阵数据进行乘法操作,我们需要对其进行空间插值,上采样得到0.01°分辨率的更精细TIF数据,从而从中裁剪出目标区域的空间信息矩阵。

我首先尝试了使用rasterio库读取tif文件,并用numpy库准备插值点和新的网格,然后用scipy库中的griddata方法进行插值,但效果不尽人意:未处理NaN数据时,会出现数据最小值越界,突变为极小负数的情况;预先剔除NaN数据后再插值,又会出现相邻栅格之间数据黏连,整个栅格图杂糅为椭圆状的情况;使用linear插值、nearest插值、cubic插值也均出现了不同的异常现象。
多次尝试后,我转而使用GDAL库进行插值,发现GDAL不仅使用简便,代码量少,而且执行效率高,插值效果十分优秀。
一般来说,由于GDAL不是python的标准库,所以不能用pip直接下载,所以在终端使用pip install GDAL或pip install gdal下载时,会出现各种各样奇怪的报错,这是很正常的。
所以我们需要手动下载gdal的安装文件,然后再用pip调用本地的安装文件进行gdal库的安装。
参考博客:https://blog.csdn.net/qq_59122359/article/details/145866729
安装的过程就不在此赘述了,按照上面的博客可以很方便地安装好。
使用GDAL库,只需26行代码,即可完成空间插值操作,详细代码见interpolation.py文件。
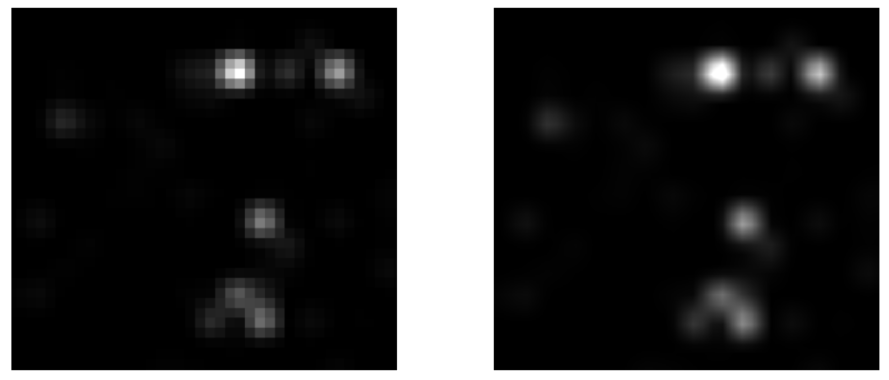
将插值前后的tif文件分别导入到QGIS进行对比:(左侧为插值前甲烷通量场tif图,右侧为插值后甲烷通量场tif图)

这样看并不明显,但是放大后可观察到,插值后的栅格图明显精度更高:
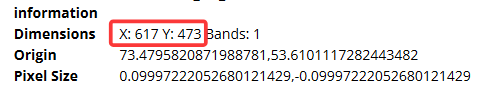
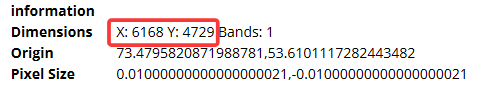
再检查两个tif文件的元数据,插值后的tif图尺寸的确是原tif图的十倍:
7.1.2. 设计y*计算函数
7.1.2.1. 思路解析
按照题目描述,某一片方形区域被均匀划分为了7*7=49个大方格,每个大方格区域又被均匀划分为10*10=100个小方格。
每个大方格都有一个对应的足迹矩阵,且矩阵中心与大方格中心重合,一共提供了49个足迹矩阵的csv文件。我们需要选择任意小方格为观测站点,通过小方格所属的大方格的足迹矩阵,计算出这个以这个小方格为中心的新足迹矩阵。
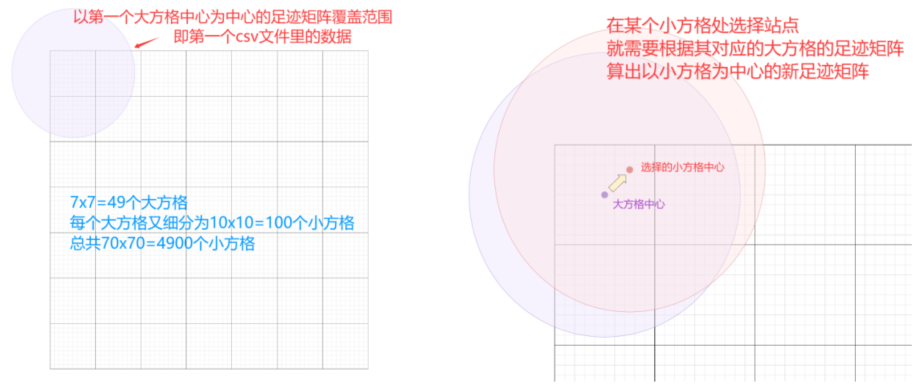
选择五个这样的观测站点,即选择了五个小方格,就能计算出五个新足迹矩阵,然后再将它们合并为一整个大足迹矩阵。
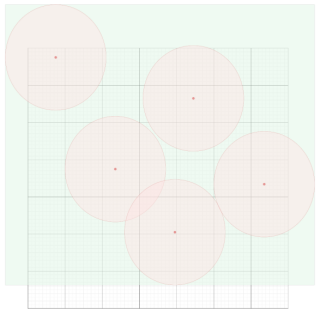
最后将这个大足迹矩阵和前面得到的tif图按地理坐标重叠放置,可以得到它们的重叠区域。

将大足迹矩阵作为H,将重叠区域的甲烷通量数据作为x*,按照题目给出的公式:
由于题目中说到在本实验中不考虑观测误差ε,所以由此可以计算出y*的值。
7.1.2.2. 代码实现
计算y*的过程被封装为函数calc_fitness,便于在后续智能优化计算过程中调用,作为计算适应度值的方法。计算过程如下:
- 由于每个方格在空间上均匀排布,所以可认为所有小方格构成了70*70的二维列表,任意小方格的位置可以用排序坐标表示,如第二行第八列的小方格坐标为(2,8)。函数输入值为包含五个小方格排序坐标的数组,如[(2,5),(13,45),(22,36),(18,62),(41,7)]。
- 相应的,所有大方格构成了7*7的二维列表,每个大方格有其地理坐标,但也可用排序坐标表示。对于每个小方格,使用get_block_center函数获取其对应大方格排序坐标。实现方法为对小方格的排序坐标值除以10取商。
- 对于目标大方格,使用get_block_geo函数获取其地理坐标。实现方法为按照大方格排序坐标查找预先设定的二维数组,其值即为对应地理坐标。
- 随后使用trim_footprint函数,依照大方格地理坐标整理出格式化的字符串,从footprints目录中读取对应足迹矩阵文件,然后计算大方格与小方格之间的偏移量,并创建新的足迹矩阵。
- 将上一步得到的小方格足迹矩阵及其中心地理坐标一同存入足迹矩阵数组。
- 五个小方格都经过上述处理后,将得到的五个足迹矩阵通过merge_footprint函数融合为一个整体的大矩阵merged_H。
- 读入插值过的甲烷通量场tif文件,并提取出merge_H对应的子区域x*。
- 使用calculate_y_star函数,根据题目提供的公式计算y*值。
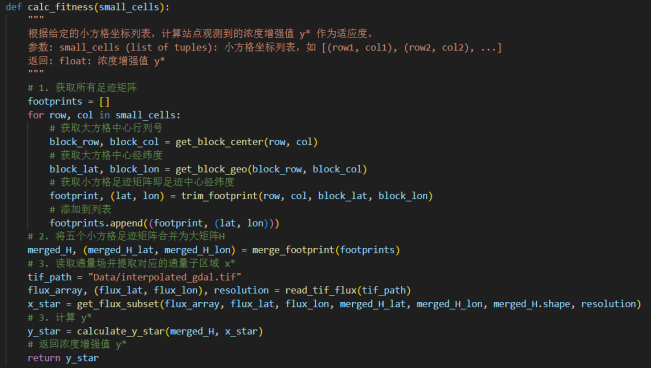
为了降低代码各部分之间的耦合性,提高处理效率,我将上述过程封装为Processor类,可在后续智能优化算法中调用,快捷计算y*值、保存最优解相关数据、输出和保存运行数据。
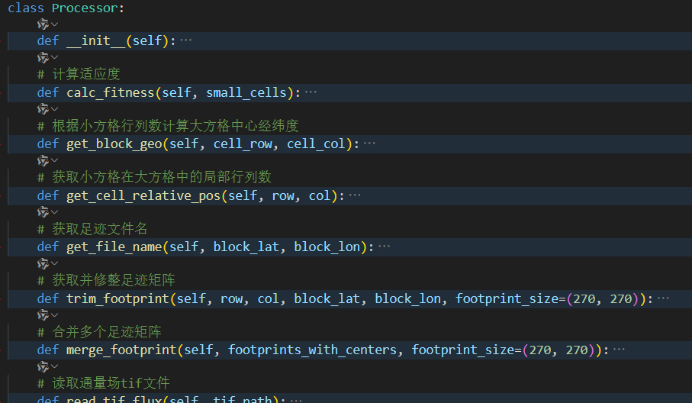
详细代码见find.py文件。
7.1.3. 智能优化计算
为了对比不同算法对此问题的适用性,我分别使用了遗传算法、粒子群算法和蚁群算法进行实验。为了更好地理解算法优化迭代过程,此处并没有直接调用开源库,而是详细按照课程中提到的各算法运行原理,手动完成全部操作。对于每个智能算法,都单独封装成了类,以进一步降低程序各部分之间的耦合性,提高可读性和操作便捷程度。
可在main函数中手动选择使用的算法类型,运行对应的智能优化算法,详细代码见find.py文件。
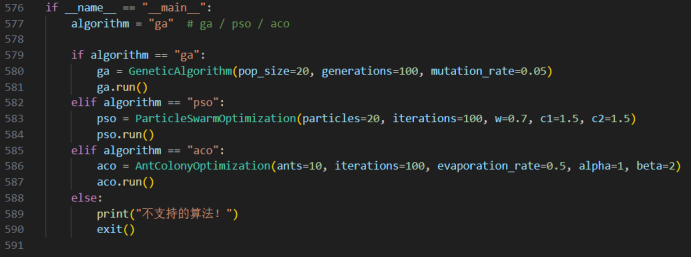
具体设计与实验过程如下:
7.1.3.1. 遗传算法
蚁群算法优化计算过程如下:
- 初始化种群:使用init_individual_binary函数初始化生成个体,个体数量为pop_size;
- 适应度评估:对每个个体使用evaluate_fitness函数计算适应度值;
- 更新与选择:记录当前代最优个体和适应度,并保留适应度高的前一半个体;
- 交叉与变异:将选中个体随机配对,通过crossover和mutate函数生成新一代种群;
- 迭代计算:迭代过程中重复执行2~4步,直至达到最大迭代次数。
- 返回结果与可视化输出:返回最终找到的最佳个体及其适应度值,并绘制每代最佳适应度变化曲线。
7.1.3.2. 粒子群算法
粒子群算法优化计算过程如下:
- 初始化粒子群;
- 迭代更新每个粒子的速度和位置;
- 若粒子适应度由于全局最优,则更新全局最佳位置;
- 每轮迭代记录当前最优适应度并输出;
- 最终返回全局最优位置及其适应度。
7.1.3.3. 蚁群算法
蚁群算法优化计算过程如下:
- 每轮迭代生成多个蚂蚁的解:每个蚂蚁选择五个未访问的单元格作为解;
- 计算解的适应度:使用缓存计算适应度值;
- 信息素更新:先蒸发一部分,再根据解的质量增强路径上的信息素;
- 记录最优解:跟踪每代中最优解并保存历史;
- 输出与返回:打印迭代信息,最终返回最优解和适应度。
7.1.4. 输出迭代图像、迭代日志与地理信息数据
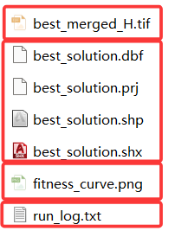
智能算法优化完毕后,会输出迭代图像、程序运行日志、最优解观测站点地理空间坐标点对应的shapefile文件、最优解对应融合足迹矩阵的GeoTIFF图像。
迭代图像和运行日志用于评估算法运行结果,详细对比和分析见《结果及分析》部分;
Shapefile文件和GeoTIFF文件用于在GeoServer发布标准地理信息服务,详细发布过程见《站点位置发布》部分。
7.2. 站点位置发布
7.2.1. 安装GeoServer、启动服务并登录
在完成最佳观测站点搜索后,我们还需要将甲烷通量场数据、融合后的足迹矩阵、最佳观测站点地理空间坐标点的数据发布为标准Web Service服务。这一环节要用到一个地理空间数据分享工具GeoServer,简单来说有点像PostgreSQL之类的数据库,将本地的数据发布到上面之后,就可以在QGIS里建立GeoServer连接,连接成功便能获取来自GeoServer的服务信息。
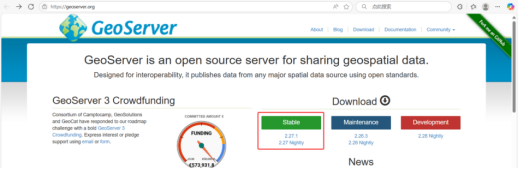
首先上GeoServer官网,下载Stable版本。
下载好后,打开安装包,一直点击下一步即可。过程中会让你选择java运行环境,要提前配置好jdk17的环境。选择端口号时,默认为8080,为避免与本地其他服务冲突,可修改为8100。
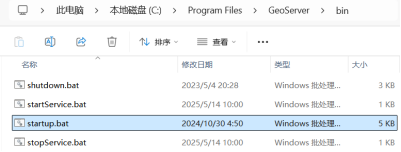
安装完成后,找到GeoServer安装目录,打开bin文件夹,双击运行startup.bat文件,启动GeoServer服务。
打开浏览器,输入http://localhost:8100/geoserver/web/访问GeoServer服务后台。
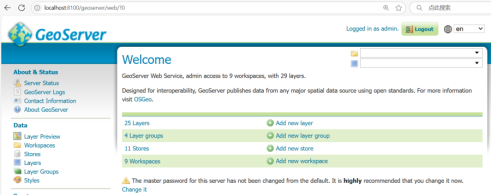
若未登录,点击右上角的Login,输入安装过程中设置的账号和密码(默认账号为admin,默认密码为geoserver)即可成功登录。
为了后面更好地上传数据和发布服务,可以将要发布的数据整理到一个统一位置,如在C盘下创建SICISP目录,将插值后的甲烷通量场tif图、最优解点位shapefile、最优解融合足迹矩阵tif图放进去。
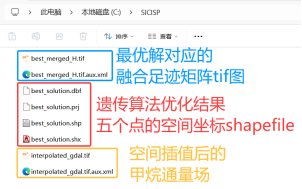
7.2.2. 发布甲烷通量场图层数据
在左侧导航栏选择Data→Workspaces,点击Add new workspace新建一个工作空间。
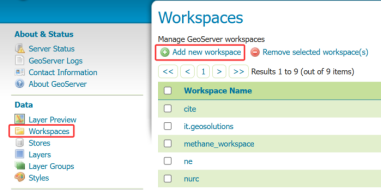
新空间命名为SICISP,URI设置为http://localhost:8100/sicisp。
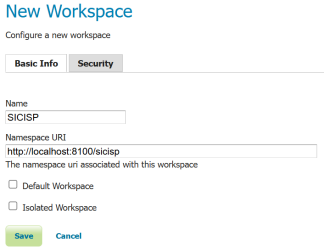
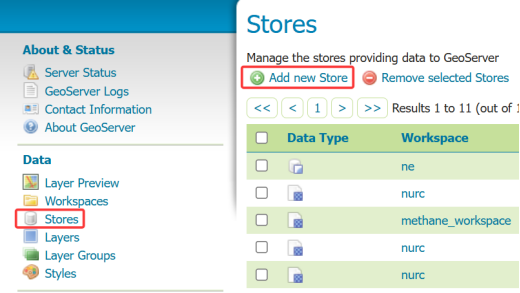
然后在左侧导航栏选择Data→Stores,点击Add new Store新建一个存储空间。
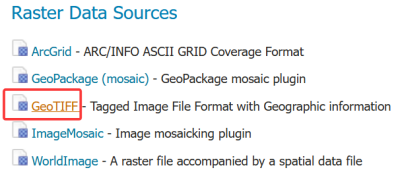
接下来为存储空间选择数据源类型。存储空间是专门用来存储某一类型数据的,此处我们要先发布甲烷通量场数据,所以先选择GeoTIFF类型的数据源。
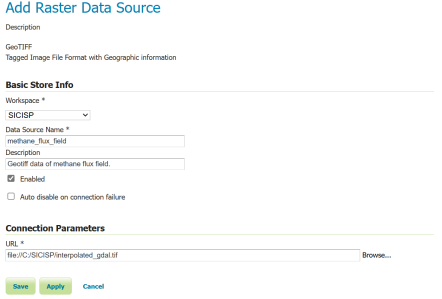
配置存储空间的名称为methane_flux_field,随便撰写一下描述信息,选择上级工作空间为SICISP,文件URL选择本地经过插值后得到的0.01°分辨率甲烷通量场GeoTIFF图像interpolated_gdal.tif。
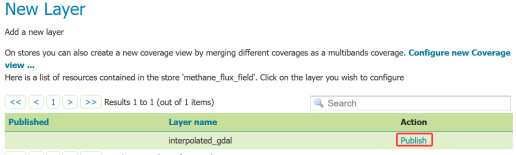
完成创建后会自动跳转到New Layer页面,此时在列表中可以看到存储仓库中还未发布图层的数据信息,即刚刚上传的interpolated_gdal文件,点击Publish即可进入发布阶段。
编辑好图层的基本信息,即可发布。
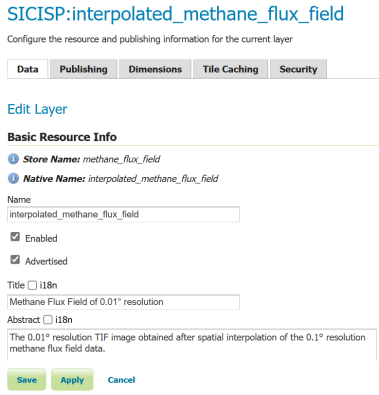
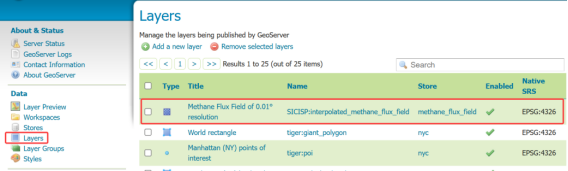
发布后即可在Data→Layers里查看到这个图层了。
7.2.3. 发布最优观测点位图层数据
此步骤我们可以直接使用之前创建好的工作空间,所以就不用再创建工作空间了,直接Data→Stores,新建存储空间,存储类型选择Shapefile。
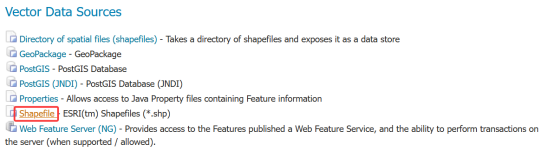
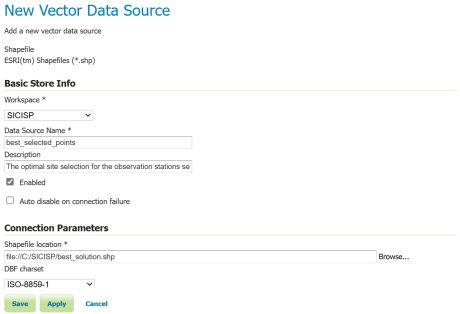
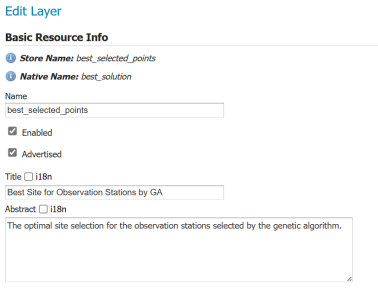
上级工作空间选择SICISP,存储空间名称为best_selected_points,简单填写数据描述,如“The optimal site selection for the observation stations selected by the genetic algorithm.”,文件URL选择遗传算法优化计算后输出的shp文件。
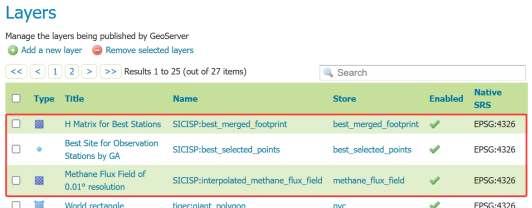
创建好存储空间后,依然是点击Publish进行图层发布,设置图层名为best_selected_points,图层标题为Best Site for Observation Stations by GA。
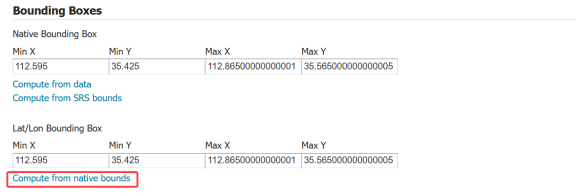
然后往下滑,找到Bounding Boxes,若为空,则选择Compute from native bounds。
随后点击Save,即可成功发布最佳观测点位图层。
7.2.4. 发布融合足迹矩阵图层数据
由于融合足迹矩阵也是tif数据,所以发布流程和前面甲烷通量场数据一样,只需修改部分信息即可。
新建存储空间,上级工作空间选为SICISP,存储空间名称为best_merged_footprint,文件链接为本地最佳融合足迹矩阵tif文件。
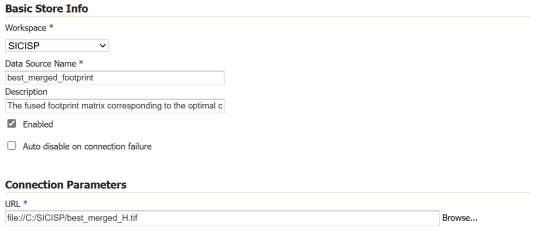
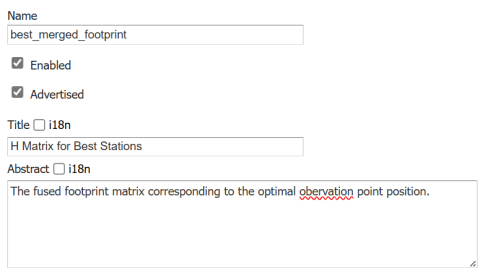
随后进行图层发布,图层名称设为best_merged_footprint,图层标题设为H Matrix for Best Stations。
至此,便可在Layers中查看到我们刚刚发布的三个图层了。
7.2.5. 使用QGIS订阅服务以获取图层数据
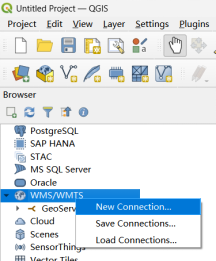
启动QGIS,在左侧数据源窗口中找到WMS/WMTS,右键,选择创建新连接。
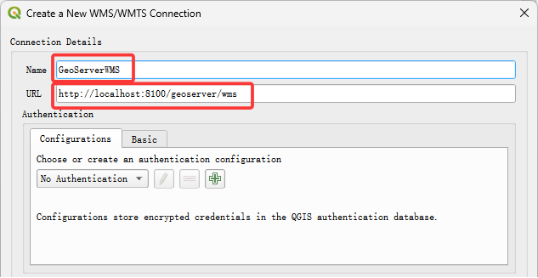
为连接取一个名字,然后输入GeoServer的WMS服务链接,点击确定,即可订阅GeoServer的WMS服务。
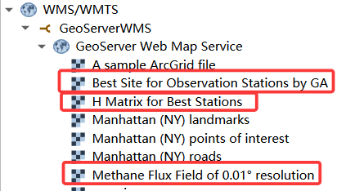
订阅后便可查看到其WMS服务提供的所有图层数据,其中包含我们刚刚发布的三个图层。
将它们加载到工作区,并适当调整样式后,可以直观地看见其空间关系。最底层中国地图状的是甲烷通量场数据图层,其中的深色方形区域为融合足迹矩阵数据图层,小红点为最佳点位数据图层。

8. 结果及分析
实验数据与代码已上传至GitHub仓库:AaronChou313/AIsearcher_SICISP: A project using intelligent algorithms to find the optimal location for observation stations.
遗传算法空间优化结果如下。分别进行了两次实验,种群大小均为20,变异比率均为0.05,第一次实验迭代了100次,第二次实验迭代了300次,可以看出最优解的适应度值没有太大变化,基本落在2000~2100之间,一方面是种群规模限制,种群大小均为20,规模较小,导致种群多样性不足,容易陷入局部最优,难以进一步突破。另一方面是变异率影响有限,变异率均为0.05,较低的变异率使得种群的基因变化较慢,在100代和300代的迭代过程中,难以通过变异产生足够优秀的基因组合来显著提升适应度值。甚至第二次实验比第一次效果还略差一些,推测是由于智能优化算法本身存在一定的随机性,基因交叉变异的过程中偶然得到的最优解也存在差异。
| 实验次数 | 迭代过程适应度变化图 | 最优解信息 | 参数设置 |
| 第一次 | 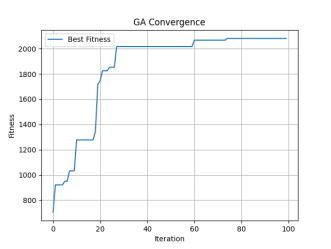 | 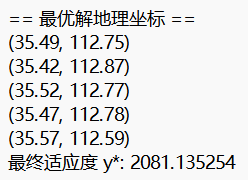 | 种群大小pop_size: 20 迭代次数generations: 100 变异比率mutation_rate: 0.05 |
| 第二次 | 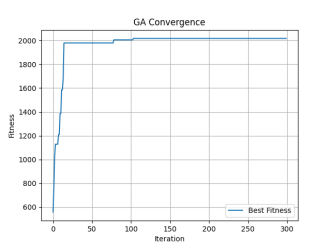 | 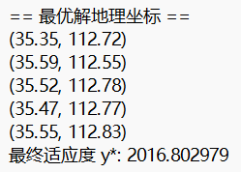 | 种群大小pop_size: 20 迭代次数generations: 300 变异比率mutation_rate: 0.05 |
粒子群算法空间优化结果如下。分别进行了三次实验,前两次实验参数相同,如表格中所示。重复试验原因是第一次实验后,发现结果相较于遗传算法得到的值差距过大,于是重复实验,得到最优适应度为2200左右,推测依然是因为智能优化算法的随机性,导致第一次实验时偶然收敛过快,陷入局部最优解。第三次实验提高了粒子数量与迭代次数,并适当增大了个体学习因子和全局学习因子,实验结果与第二次实验相近。
但各参数对实验的单独影响还有待多次实验验证,由于本次实习时间较为紧迫,且智能算法运行时间较长(一次实验约30分钟以上),故留作后续验证。
| 实验次数 | 迭代过程适应度变化图 | 最优解信息 | 参数设置 |
| 第一次 | 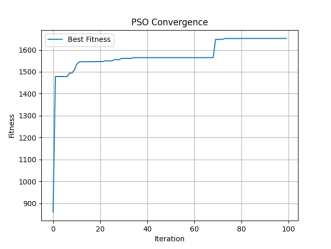 | 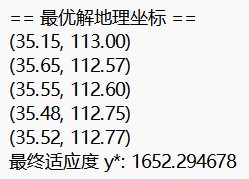 | 粒子数量particles: 20 迭代次数iterations: 100 惯性因子w: 0.7 个体学习因子c1: 1.5 全局学习因子c2: 1.5 |
| 第二次 | 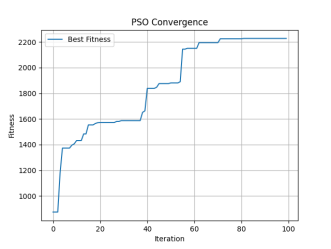 | 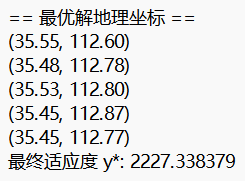 | 粒子数量particles: 20 迭代次数iterations: 100 惯性因子w: 0.7 个体学习因子c1: 1.5 全局学习因子c2: 1.5 |
| 第三次 | 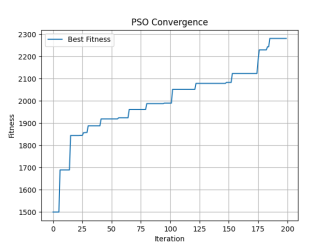 | 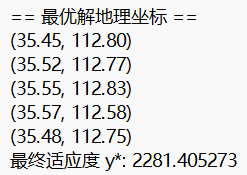 | 粒子数量particles: 40 迭代次数iterations: 200 惯性因子w: 0.7 个体学习因子c1: 2 全局学习因子c2: 2 |
蚁群算法空间优化结果如下。可以看出蚁群算法相较于前两种算法,最优解适应度较差。结果观察:三次实验的适应度值也存在较大差异,分别为805.568115、1526.513916和1479.099121。
分析原因可能来自参数的影响和算法对该问题的局限性。前两次实验中,蚂蚁数量、信息素蒸发率、信息素启发因子和自启发因子均相同,但第二次实验的适应度值比第一次高很多,可能是由于蚁群算法在第二次实验中更好地利用了信息素的引导作用,或者初始信息素分布等因素的差异使得第二次实验的蚂蚁能够更有效地搜索到更好的解。第三次实验中,迭代次数增加到200,但适应度值反而下降,可能是由于在该参数设置下,信息素的积累和挥发达到了一种平衡,使得蚂蚁在后续的迭代中无法找到更优的解,甚至可能陷入局部最优。
| 实验次数 | 迭代过程适应度变化图 | 最优解信息 | 参数设置 |
| 第一次 | 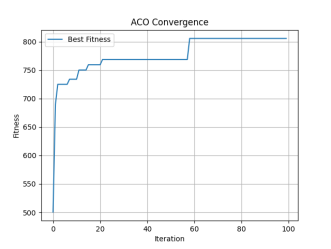 | 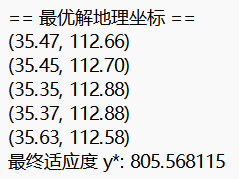 | 蚂蚁数量ants: 10 迭代次数iterations: 100 信息素蒸发率evaporation_rate: 0.5 信息素启发因子alpha: 1 自启发因子beta: 2 |
| 第二次 | 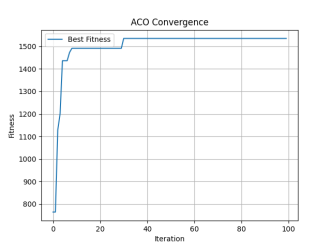 | 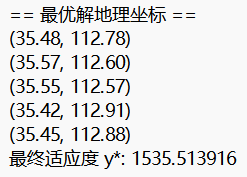 | 蚂蚁数量ants: 10 迭代次数iterations: 100 信息素蒸发率evaporation_rate: 0.5 信息素启发因子alpha: 1 自启发因子beta: 2 |
| 第三次 | 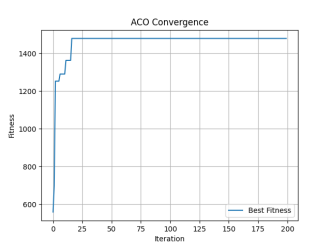 | 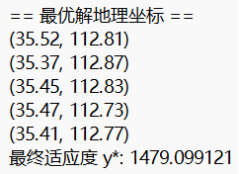 | 蚂蚁数量ants: 10 迭代次数iterations: 200 信息素蒸发率evaporation_rate: 0.5 信息素启发因子alpha: 1 自启发因子beta: 2 |
从三次实验的最高适应度值来看,粒子群算法表现最好,尤其是在第三次实验中,得到了最高的适应度值2281.405273,这表明在合适的参数设置下,粒子群算法对该问题的适用性更高,能够有效地提高解的质量,搜索到更优的解;蚁群算法在第二次实验中得到了较高的适应度值1526.513916,但在第一次和第三次实验中的表现相对较差,说明其对参数的敏感度较高,还需在参数设置上进行仔细调整,才能获得较好的结果;遗传算法的适应度值相对较低,且随着迭代次数的增加,适应度值并未显著提高,这可能是由于种群规模小、变异率低等因素限制了其搜索能力,难以突破局部最优,找到更优的解。
粒子群算法中,增加粒子数量和迭代次数,并调整学习因子,可以显著提高算法的性能,这表明合适的参数调整能够使算法更好地搜索解空间。遗传算法和蚁群算法中,虽然种群规模和迭代次数也有一定影响,但在本实验中并未带来显著的改进。粒子群算法的学习因子和蚁群算法的信息素参数对算法的搜索行为和收敛性有重要影响。合适的参数设置能够提高算法的性能,不合适的参数可能导致算法陷入局部最优或收敛速度变慢。
9. 体会心得
通过本次实验,我深刻体会到了空间智能算法在解决实际问题中的强大魅力。在面对海量的站点布局可能性时,遗传算法、粒子群算法和蚁群算法等智能算法展现出了独特的探索能力。它们能够在复杂的空间数据中快速筛选出最优的站点组合,极大地提高了决策的效率和精准度。从数据预处理到模型构建,再到最终的算法优化与结果验证,整个过程不仅加深了我对空间智能算法理论知识的理解,更让我学会了如何将这些算法灵活应用于实际的地理空间问题中。同时,我意识到在实际操作中,不同算法各有优势与局限,需要根据具体问题的特点进行选择和调整。此外,实验中对数据的细致处理以及对结果的严谨分析,也让我认识到在地理空间领域,数据的质量和准确性对最终决策起着至关重要的作用。这次实验不仅是一次技术的实践,更是一次思维的锻炼,让我在面对复杂问题时,能够更加从容地运用所学知识去探索解决方案,为今后在空间智能计算与服务领域的深入研究奠定了坚实的基础。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)