为什么 Transformer 注意力机制中要除以 √d?一文彻底搞懂!
Transformer 模型的成功离不开核心的注意力机制(Attention)。在阅读 Transformer 的论文或源码时,你可能会注意到这样一行公式:
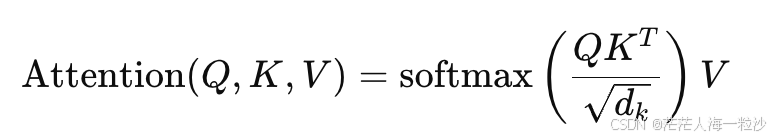
看上去只是简单地多了一个除以 ,但这个细节恰恰是训练稳定性和性能表现的关键。本文将带你深入理解:为什么要除以
,不除会发生什么,以及它和 softmax 有什么关系。
🧠 一、注意力机制的基本原理
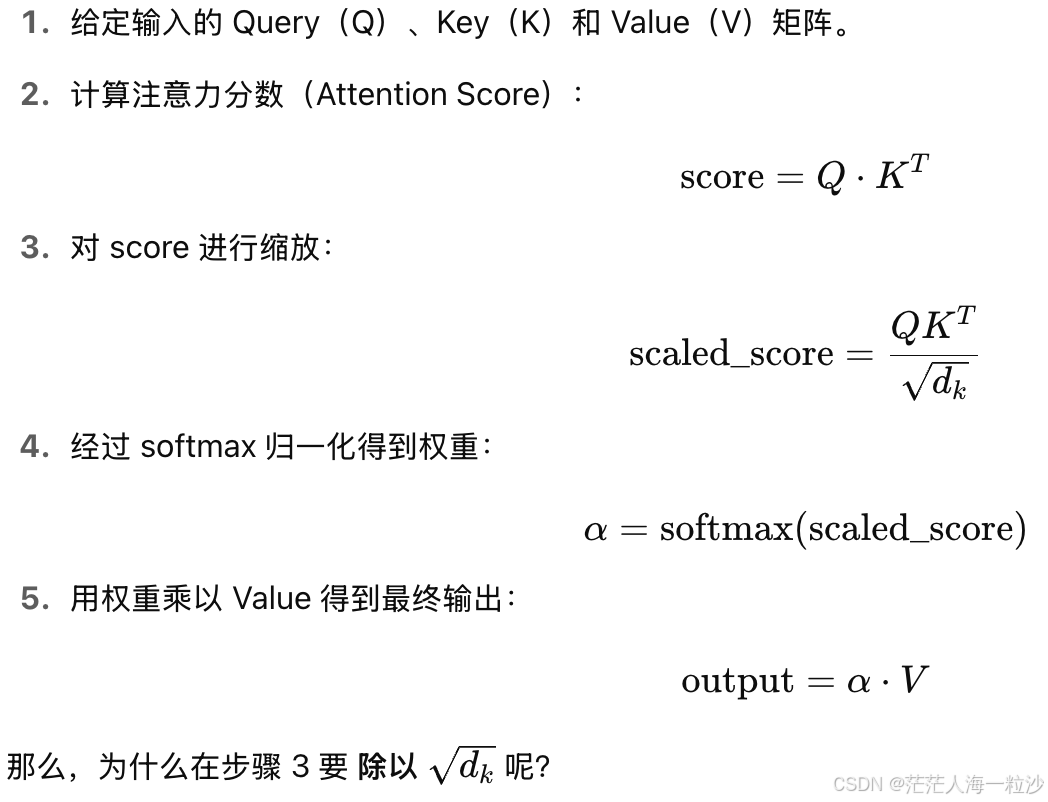
Transformer 中使用的是 Scaled Dot-Product Attention(缩放点积注意力)。其计算过程如下:
二、不除以 √d 会发生什么?
让我们考虑如下情况:
-
假设 Q 和 K 是维度为
的向量。
-
每个维度的值是独立且标准正态分布(均值为 0,方差为 1)。
则:
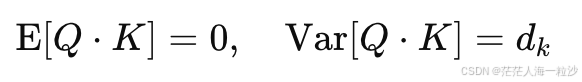
也就是说,点积的方差会随着维度 的增加而线性增长。
导致的问题:softmax 饱和!
当 Q⋅K 的值变得很大时,softmax 的输出会变得极度偏置。例如:
未缩放前的 score: [10, 20, 30]
softmax 输出: [0.000, 0.000, 1.000]
这意味着模型会把注意力几乎完全集中到某个位置,导致:
-
梯度几乎为零(梯度消失)
-
模型训练变慢,甚至不收敛
-
对 token 的区分度变得极端,不利于建模上下文关系
三、除以 √d 的作用
为了抑制点积过大导致的 softmax 饱和问题,我们将注意力得分除以 ,使其保持在一个较小的数值范围内。
归一化后:
如果原始方差为 ,除以
后:
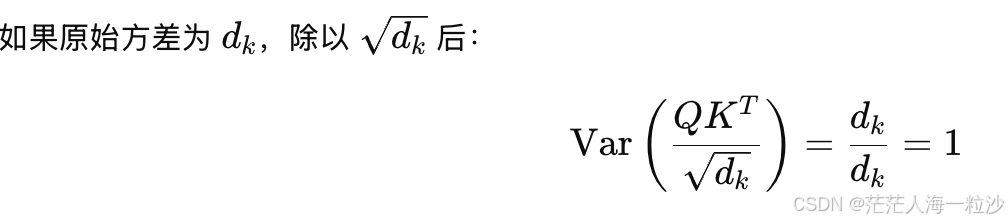
这样就使 softmax 的输入值 具有稳定的尺度,不容易饱和,梯度也更健康,模型更容易训练。
四、举个例子更直观
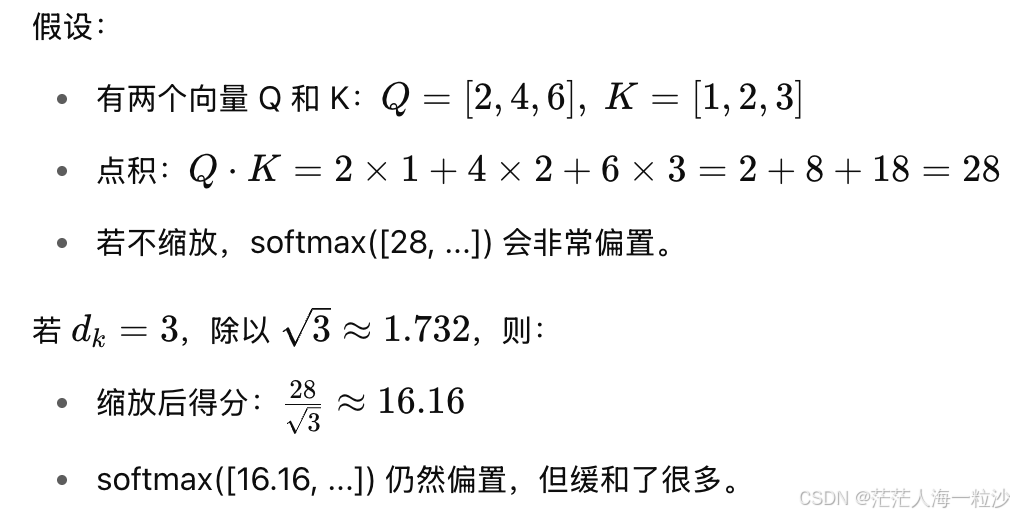
随着 d_k 增大,这种缩放变得更加重要。
五、为什么是 √d,不是 d?
我们希望控制的是“方差”,而不是值的期望。因为点积的方差是 ,我们想让它保持为 1,就需要除以
。
这是和深度学习中许多初始化策略(如 Xavier 初始化)相同的思路:
“使用
缩放权重,以控制前向传播时的方差稳定。”
✅ 六、总结一句话
在 Transformer 中,注意力分数除以
是为了控制 softmax 的数值范围,避免过大或过小导致梯度不稳定,从而提升模型训练的稳定性和效率。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献9条内容

所有评论(0)