Keras下BERT微调实战案例

简介:BERT是自然语言处理领域的预训练模型,Keras作为TensorFlow的高级API使得深度学习模型构建更加简单。本文章提供在Keras框架下微调BERT模型的具体步骤,包括安装依赖、加载预训练模型、创建模型、数据预处理、数据集准备、编译模型、训练模型以及评估与推理,旨在帮助用户更好地适应特定的NLP任务。
1. BERT模型简介
在自然语言处理(NLP)的舞台上,BERT模型的出现无疑是一场革命性的创新。其全名为双向编码器表示法(Bidirectional Encoder Representations from Transformers),是深度双向Transformer构建的预训练语言模型。BERT不仅在诸如文本分类、问答系统等多个NLP任务中取得了前所未有的成果,更是为NLP领域的发展带来了深远影响。
BERT模型的优越性主要体现在其深度双向训练机制,能够更好地捕捉语境信息,生成更富有含义的词向量表示。相比其他单向语言模型,BERT通过对整个句子进行编码,能够更准确地理解和表达语言的复杂性。这种双向训练方式,有效提升了模型在各种NLP任务中的性能。
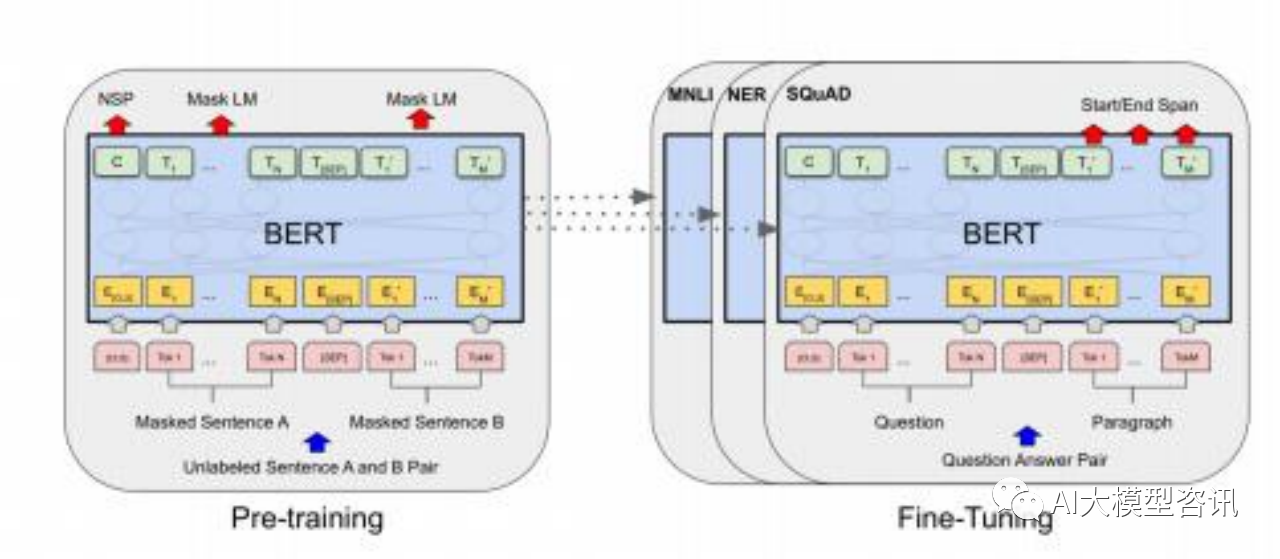
此外,BERT模型的另一个亮点在于其预训练与微调的两阶段模式。预训练阶段,BERT通过大规模语料库的学习,获取丰富的语言知识;微调阶段,则是在特定任务上对BERT进行进一步训练,使其更好地适应特定领域的需求。这一模式不仅简化了模型训练流程,也极大地提高了NLP任务的灵活性和准确性。
2. Keras与BERT的结合使用
2.1 Keras的简介
2.1.1 Keras的发展历程
Keras是由François Chollet于2015年创建的一个开源的高级神经网络API,用Python编写,能够运行在TensorFlow、CNTK或Theano之上。它的设计理念是用户友好、模块化以及易扩展。Keras最初是为了方便快速实验而设计的,并且它能够在CPU和GPU上无缝运行。
Keras发展历程中的关键里程碑包括:
- 2015年3月:Keras发布第一个正式版本。
- 2017年3月:Keras被整合为TensorFlow的一部分,成为TensorFlow的高级API。
- 2018年9月:Keras发布2.0版本,引入了更多与TensorFlow集成的特性。
2.1.2 Keras的特点和优势
Keras有几个显著的特点和优势:
- 易用性 :Keras提供高层次的抽象,简化模型构建过程,用户可以很快上手。
- 模块化 :Keras由一系列独立、可复用的模块构成,如层、损失函数和优化器等。
- 易扩展性 :用户可以轻松自定义新的模型、层或损失函数,易于社区贡献。
- 兼容性 :支持多种后端,如TensorFlow、Microsoft Cognitive Toolkit、R、Theano。
Keras的优势使其成为众多深度学习初学者和研究人员的首选框架,尤其是对于那些希望快速搭建原型的项目。
2.2 Keras和TensorFlow的关系
2.2.1 TensorFlow的基本概念
TensorFlow是由Google Brain团队开发的开源机器学习库,它用于进行数值计算,尤其擅长于机器学习和深度学习领域的应用。TensorFlow的核心是它的数据流图(data flow graphs),图中的节点表示数学运算,边表示在这些节点间传递的多维数据数组,称为张量(tensor)。
TensorFlow的特点包括:
- 高度的灵活性 :TensorFlow允许开发者在多种设备上部署模型,包括PC、移动设备和服务器。
- 跨平台 :TensorFlow支持多个操作系统和编程语言。
- 高性能 :通过优化底层硬件,TensorFlow可以提供高性能计算。
2.2.2 Keras在TensorFlow中的应用
Keras被设计为TensorFlow的一个高级封装层,它简化了TensorFlow的API,使得构建和训练深度学习模型变得更加直观。在TensorFlow 2.x版本中,Keras成为了默认的深度学习API。
在TensorFlow中使用Keras有以下优点:
- 快速原型开发 :利用Keras的简洁API,用户可以更快地进行模型的原型设计。
- 灵活的底层接入 :对于需要更底层控制的用户,Keras允许在需要时直接使用TensorFlow的API。
- 一致的API :Keras和TensorFlow的整合为用户提供了统一的工作流程和API。
2.3 Keras与BERT的结合使用方法
2.3.1 Keras-BERT的安装和配置
为了在Keras中使用BERT,我们首先需要安装Keras-BERT库。可以通过pip进行安装:
pip install keras-bert
安装完成后,需要配置BERT模型,包括模型权重和配置文件。BERT模型通常以预训练模型的形式提供,我们可以从Google或Hugging Face等来源下载。
2.3.2 Keras-BERT的模型结构和参数设置
使用Keras构建BERT模型,首先需要加载预训练的BERT模型和对应的配置。接着,可以按照我们的需求对模型结构进行微调,比如添加分类层、序列标注层等。
以下是一个简单的例子,展示了如何在Keras中使用预训练的BERT模型:
from keras_bert import load_trained_model_from_checkpoint, Tokenizer
import numpy as np

# 加载预训练模型和分词器
bert_model_path = 'path/to/bert/model'  # BERT模型文件路径
config_path = bert_model_path + '.json'  # BERT配置文件路径
checkpoint_path = bert_model_path + '.ckpt'  # BERT权重文件路径
model = load_trained_model_from_checkpoint(config_path, checkpoint_path, training=True)

# 定义输出维度
output_dim = model.output_shape[-1]

# 添加全连接层或其他层
model = Dense(output_dim, activation='softmax')(model)

# 编译模型
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])

# 预处理输入数据
tokenizer = Tokenizer(model)
text = "Here is a sentence to encode"
encoded_inputs = tokenizer.encode(text)

# 将编码后的数据转换为模型输入
input_ids = np.expand_dims(encoded_inputs, axis=0)

# 使用模型进行预测
model.predict(input_ids)
在上述代码中,我们首先通过 load_trained_model_from_checkpoint 函数加载了预训练的BERT模型,并在模型结构的末端添加了一个全连接层。然后对模型进行编译,并准备了一个输入样本来进行预测。
要注意的是,为了使上述代码能够正常工作,我们需要提前下载对应的BERT模型文件,包括配置文件 .json 、预训练权重文件 .ckpt 和词汇表文件。
在实际应用中,通常我们会对BERT进行微调,以适应特定的任务,这将在后续章节中详细讨论。
3. 微调BERT模型的概念和优势
微调模型是一种通过在特定数据集上进一步训练预训练模型,以提升模型在特定任务上的性能的方法。在本章中,我们将深入探讨微调BERT模型的基本概念,以及与传统预训练模型相比,微调所具有的优势。
3.1 微调模型的基本概念
3.1.1 微调模型的定义和原理
微调模型通常指的是在预训练模型的基础上进行的额外训练。预训练模型在大规模语料库上学习到通用的语言特征,而微调则是在特定任务的数据集上进行,目的是让模型学会识别特定任务中的细微差异。
BERT模型作为预训练模型的代表,提供了丰富的语义信息,但在面对特定NLP任务时,仍然需要进行微调。微调BERT模型的原理是通过少量任务相关的数据,调整模型权重,使之更好地适应新任务。
3.1.2 微调模型与传统预训练模型的比较
传统的预训练模型使用大规模数据进行训练,然后在各个具体任务上进行微调。与之相比,微调BERT模型的优势在于其双向训练策略,能够捕捉更加丰富的上下文信息。
此外,微调BERT模型时通常只需要较少的训练数据和较短的训练时间,因为预训练的BERT已经具备了很好的语言理解能力。相比之下,没有微调的传统预训练模型在特定任务上的表现往往会逊色。
3.2 微调BERT模型的优势
3.2.1 提升模型在特定任务上的性能
微调BERT模型最直观的优势就是能够在特定任务上取得更好的性能。由于BERT模型在预训练阶段学习到了丰富的语言表示,因此在特定任务的数据集上进行微调时,模型能够更快地学习到任务相关的特征。
这一点在各种NLP任务中得到了验证,包括但不限于文本分类、命名实体识别、情感分析等。微调后的BERT模型能够在这些任务上达到甚至超越之前最先进的性能。
3.2.2 简化模型训练过程和参数调整
微调BERT模型可以有效减少需要调整的参数数量。在没有微调的情况下,可能需要从头开始训练一个复杂的模型,并调整数百万个参数,这不仅耗时而且容易导致过拟合。
通过在特定任务上微调预训练的BERT模型,我们仅需调整一部分层的参数,大大简化了训练过程。而且,由于预训练模型的权重已经很接近最优解,这使得微调过程更加稳定,减少了对大规模数据集和复杂优化策略的依赖。
案例研究
微调BERT模型在特定任务上的应用实例
以文本分类为例,微调BERT模型时,我们首先在通用的文本分类数据集上进行预训练,然后在特定的文本分类任务(如情感分析)上进行微调。
在此过程中,我们可以采用小批量训练策略,逐步调整学习率,从而在保持模型泛化能力的同时,实现对特定任务数据的拟合。
优化微调策略
微调BERT模型时,有几个关键点需要注意:
- 学习率的选取:一般选取较小的学习率进行微调,以避免破坏预训练模型的权重。
- 微调的层数:在某些情况下,我们可能只需要微调BERT的顶层,而在其他情况下,可能需要微调更多的层来获得更好的性能。
- 正则化方法:为了避免过拟合,可以使用Dropout、Early Stopping等正则化技术。
小结
在本章节中,我们探讨了微调BERT模型的基本概念,包括其与传统预训练模型的比较以及其显著的优势。微调为BERT模型在特定NLP任务中提供了高效的性能提升路径,并简化了模型训练过程,降低了参数调整的复杂度。通过案例研究,我们进一步展示了微调BERT模型在实际应用中的优势和优化策略。微调策略的正确选择,将对模型性能产生重要影响,这对于NLP领域的研究和应用具有重要的指导意义。
4. BERT微调的详细步骤
在自然语言处理(NLP)任务中,对BERT模型进行微调是一个关键步骤,可以显著提升模型在特定任务上的表现。本章节将详细介绍BERT微调的步骤,包括数据准备和预处理、模型配置和初始化、以及训练过程和监控。
4.1 数据准备和预处理
4.1.1 数据集的选择和准备
在开始微调BERT模型之前,首先需要选择合适的数据集。数据集的质量直接影响微调的效果,因此,选择与目标任务紧密相关的数据集至关重要。可以通过公开的数据集或者自行构建的数据集来进行微调。例如,对于情感分析任务,可以使用IMDB电影评论数据集;对于问答任务,可以使用SQuAD数据集。
# 示例代码:数据集加载
import pandas as pd

# 假设我们有一个CSV格式的数据集
dataset_path = 'your_dataset.csv'

# 使用pandas读取数据集
df = pd.read_csv(dataset_path)

# 显示数据集的前几行以进行检查
print(df.head())
4.1.2 数据预处理和清洗方法
数据预处理包括文本清洗、分词、标记化(Tokenization)、添加特殊标记(如[CLS]和[SEP])、以及将文本转换为模型所需的输入格式。清洗过程中要确保去除无关字符,比如HTML标签、特殊符号等,以提高数据质量。
from transformers import BertTokenizer

# 初始化一个BERT分词器
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')

# 示例文本
text = "Here is some text to encode"

# 编码文本,并将输入格式化为BERT模型所需的形式
encoded_input = tokenizer(text, return_tensors='pt')
print(encoded_input)
4.2 模型配置和初始化
4.2.1 BERT模型的加载和配置
加载预训练的BERT模型是一个简单的步骤,使用transformers库中的 BertModel 类可以轻松加载模型。根据具体任务,可以通过添加额外的层(例如分类层)来配置模型以适应特定的NLP任务。
from transformers import BertModel, BertConfig

# 模型配置
config = BertConfig.from_pretrained('bert-base-uncased')
config.output_hidden_states = True  # 用于获取所有隐藏层的状态

# 加载预训练模型
model = BertModel.from_pretrained('bert-base-uncased', config=config)
4.2.2 微调参数的设定和优化
在微调阶段,需要根据具体任务设置正确的损失函数、优化器,以及定义学习率和其他超参数。对于分类任务,损失函数通常是交叉熵损失。优化器可以选择如AdamW这样的适合深度学习的优化器。学习率调度器(如 get_linear_schedule_with_warmup )可用于调整学习率。
import torch
from transformers import AdamW, get_linear_schedule_with_warmup

# 将模型设置为训练模式
model.train()

# 选择优化器和学习率调度器
optimizer = AdamW(model.parameters(), lr=2e-5)
scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=500, num_training_steps=-1)

# 假设有一个损失函数
loss_fn = torch.nn.CrossEntropyLoss()

# 优化器和调度器的使用示例
for epoch in range(num_epochs):
    for batch in dataloader:
        # 前向传播
        outputs = model(**batch)
        # 计算损失
        loss = loss_fn(outputs.logits, batch['labels'])
        # 反向传播和优化
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        scheduler.step()
4.3 训练过程和监控
4.3.1 训练过程的设置和执行
训练BERT模型需要配置训练循环,包括如何分批加载数据、如何定义训练阶段的迭代次数、以及如何在每个epoch后保存模型的最佳状态。
# 示例代码:定义训练循环
num_epochs = 3  # 假设我们训练3个epoch

for epoch in range(num_epochs):
    model.train()
    total_loss = 0
    # 在每个epoch中迭代数据集
    for batch in train_dataloader:
        # 通过模型进行前向传播
        outputs = model(**batch)
        # 计算损失
        loss = outputs.loss
        # 反向传播和优化
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        # 累加损失
        total_loss += loss.item()
    # 计算并打印平均损失
    avg_train_loss = total_loss / len(train_dataloader)
    print(f"Epoch {epoch}, Average training loss: {avg_train_loss}")
4.3.2 训练过程的监控和调整
在训练过程中,使用验证集来监控模型性能,从而防止过拟合,并在必要时进行调整。此外,可以使用TensorBoard等工具进行可视化,以更直观地理解模型的训练过程和性能。
from torch.utils.tensorboard import SummaryWriter

# 实例化SummaryWriter
writer = SummaryWriter()

# 训练循环中的某个点,写入数据到TensorBoard
for epoch in range(num_epochs):
    for step, batch in enumerate(train_dataloader):
        # 模型训练步骤(略)
        # 在特定间隔写入数据到TensorBoard
        if step % 100 == 0:
            writer.add_scalar('training loss', loss.item(), step)
    # 在epoch结束时评估模型在验证集上的表现
    # ...
    # 根据验证结果调整学习率等
    # ...

# 关闭SummaryWriter
writer.close()
以上是BERT微调的详细步骤,包括数据准备和预处理、模型配置和初始化、训练过程和监控。这些步骤是实现微调BERT模型的关键,并且每一步都需要精心设计和执行。通过这些步骤,可以将BERT模型训练成为在特定NLP任务上性能优异的模型。
5. 数据预处理和Tokenization
5.1 数据预处理的重要性
5.1.1 数据质量对模型的影响
数据预处理是机器学习和自然语言处理中至关重要的一步。在处理NLP任务时,原始数据通常包含噪音、不一致性或不完整性,这些问题都可能对模型的最终表现产生负面影响。良好的数据预处理能够提高模型的准确性,减少过拟合的风险,并提升模型在未见示例上的泛化能力。
数据的质量直接影响模型学习的效率和效果。高质量的数据集能够帮助模型学习到更加准确的特征和规律,而低质量的数据则可能导致模型产生偏见或学习到错误的模式。因此,在开始构建模型之前,必须确保数据的质量通过预处理得到了提升。
5.1.2 数据预处理的常见方法
数据预处理一般包括以下几个步骤:
- 清洗:去除数据中的噪音和不完整记录,比如去除空值、异常值或纠正错误。
- 标准化/归一化:将数据格式调整为统一的标准,或缩放至一定的范围,如0到1之间,以便于模型处理。
- 分词:将文本数据分解为词或标记,用于后续的特征提取。
- 词干提取和词形还原:将词汇化简为基本形式,减少数据的多样性并帮助模型更好地理解词义。
- 编码:将文本数据转化为数值表示,如独热编码或词嵌入。
5.2 Tokenization的基本原理
5.2.1 Tokenization在BERT中的应用
在BERT模型中,Tokenization是将原始文本转换为模型可理解的格式的关键步骤。BERT使用的是WordPiece tokenization算法,它首先将文本分割成单词,然后进一步将单词分割成更小的子词单元(subwords)。这样做有助于模型更好地理解语言,尤其是处理未知词汇。
Tokenization过程通常包括以下几个步骤:
- 分词:将文本拆分为单词、标点符号等。
- 转换为小写:统一文本的大小写。
- 移除空白符:去除文本中的前后空格。
- 分割标点:从单词中分离标点符号。
- 应用WordPiece算法:将单词进一步拆分成子词单元。
5.2.2 Tokenizer的配置和使用
BERT的Tokenizer是一个非常灵活的工具,它可以配置为适应不同的语言和词汇表。在Keras中,我们可以使用 transformers 库来加载预训练的BERT模型和其对应的Tokenizer。
以下是使用Tokenizer的示例代码:
from transformers import BertTokenizer

# 加载预训练的Tokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')

# 对文本进行编码
encoded_input = tokenizer("Here is some text to encode", return_tensors='pt')

# 获取token ids
input_ids = encoded_input['input_ids']
这段代码加载了 bert-base-uncased 的Tokenizer,并对给定的文本进行了编码。编码的结果是输入模型所需的格式。 input_ids 包含了文本转换成子词单元后的整数序列,模型将使用这个序列作为输入。
接下来是BERT模型的预训练和微调,可以参考后续章节来进一步了解如何在不同的NLP任务中应用BERT模型进行训练和优化。
6. 模型训练、评估与推理
在NLP领域中,模型的训练、评估和推理是三个至关重要的步骤。它们不仅决定了模型是否能够有效地学习到数据中的特征,也影响着最终的性能表现。本章将详细介绍BERT模型在这三个环节中的具体实践。
6.1 模型训练策略
6.1.1 训练过程中的损失函数和优化器
在训练BERT模型时,损失函数和优化器是两个关键的超参数。损失函数衡量的是模型的预测值与真实值之间的差异,BERT通常使用的损失函数是交叉熵损失(Cross Entropy Loss),它是分类任务中的常用损失函数。
优化器负责更新模型权重以最小化损失函数。BERT通常采用Adam优化器,这是一个自适应学习率的优化算法。Adam通过计算梯度的一阶矩估计和二阶矩估计来调整每个参数的学习率。
BERT模型训练代码示例:
import tensorflow as tf
from transformers import TFBertForSequenceClassification

# 定义模型结构
model = TFBertForSequenceClassification.from_pretrained('bert-base-uncased', num_labels=2)

# 定义优化器和损失函数
optimizer = tf.keras.optimizers.Adam(learning_rate=5e-5)
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)

# 编译模型
model.compile(optimizer=optimizer, loss=loss)
在上述代码中,我们首先从transformers库中加载预训练的BERT模型,并指定分类任务的标签数量。然后定义了优化器和损失函数,并对模型进行了编译。
6.1.2 超参数的调整和验证
超参数的选择对模型性能有着决定性的影响。除了学习率和优化器之外,还包括批次大小(batch size)、训练周期(epochs)以及正则化参数等。在BERT模型微调过程中,需要对这些超参数进行细致的调整。
一种常见的做法是通过交叉验证来找到最佳的超参数组合。可以通过网格搜索(Grid Search)或随机搜索(Random Search)等方法来进行超参数优化。一些超参数调整的示例代码如下:
from sklearn.model_selection import GridSearchCV

# 定义超参数网格
param_grid = {
    'batch_size': [16, 32, 64],
    'epochs': [2, 3, 4],
    'learning_rate': [1e-4, 3e-5, 5e-5]
}

# 进行网格搜索
grid_search = GridSearchCV(estimator=model, param_grid=param_grid, n_jobs=-1, cv=3)
grid_search.fit(train_data, train_labels)

# 输出最佳超参数
print(grid_search.best_params_)
在以上代码中,我们使用 GridSearchCV 对模型的三个超参数进行了网格搜索,以找到最佳的超参数组合。
6.2 模型评估指标和方法
6.2.1 准确率、召回率等评估指标
模型的评估指标包括准确率(Accuracy)、精确率(Precision)、召回率(Recall)和F1分数(F1 Score)。这些指标可以帮助我们了解模型在分类任务中的性能表现。
准确率是模型正确预测样本占总样本的比例。精确率是模型正确预测为正的样本占模型预测为正的所有样本的比例。召回率是模型正确预测为正的样本占实际为正的所有样本的比例。F1分数是精确率和召回率的调和平均值,是对模型性能的一个综合评价。
这些指标可以通过混淆矩阵(Confusion Matrix)来计算,示例代码如下:
from sklearn.metrics import classification_report, confusion_matrix

# 模型预测结果
predictions = model.predict(test_data)

# 计算混淆矩阵和评估报告
cm = confusion_matrix(test_labels, np.argmax(predictions, axis=1))
report = classification_report(test_labels, np.argmax(predictions, axis=1))

print("Confusion Matrix:\n", cm)
print("Classification Report:\n", report)
在上述代码中,我们使用了 confusion_matrix 和 classification_report 函数来计算模型的混淆矩阵和评估报告。
6.2.2 模型评估的工具和平台
对于模型的评估,可以使用各种工具和平台,如TensorBoard、MLflow和Weights & Biases等。这些工具不仅帮助记录和可视化模型训练过程中的性能指标,也支持模型的版本管理、参数跟踪以及实验比较。
TensorBoard是TensorFlow内置的可视化工具,它能够展示损失和准确率的变化,以及权重和偏置等参数的分布情况。示例代码如下:
# 配置TensorBoard日志
log_dir = "logs/fit/" + datetime.datetime.now().strftime("%Y%m%d-%H%M%S")
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir=log_dir, histogram_freq=1)

# 训练模型并传入TensorBoard回调
model.fit(train_data, train_labels, epochs=3, callbacks=[tensorboard_callback])

# 启动TensorBoard
%load_ext tensorboard
%tensorboard --logdir logs/fit
在以上代码中,我们设置了TensorBoard的日志目录,并在模型训练时传入了一个TensorBoard的回调函数。训练完成后,可以通过TensorBoard插件在Jupyter Notebook中直观地观察模型训练过程中的各种性能指标。
6.3 模型推理和应用
6.3.1 模型推理过程的优化
模型推理是指使用训练好的模型对新数据进行预测的过程。在实际应用中,模型推理的效率直接影响到用户体验和系统的响应时间。因此,推理优化是一个不可忽视的环节。
推理优化可以从以下几个方面进行:
- 简化模型结构:在不影响准确率的前提下,移除模型中的冗余部分,简化模型结构。
- 使用量化:量化是指将模型中的浮点数权重转换为低精度的表示,这可以大幅减少模型的存储和计算需求,从而加快推理速度。
- 优化部署环境:选择适合的硬件和软件环境来部署模型,比如使用GPU或TPU来加速推理过程。
6.3.2 将模型部署到生产环境
部署BERT模型到生产环境需要考虑模型的加载、内存管理、多线程推理等实际问题。一些流行的部署工具包括TensorFlow Serving、ONNX Runtime和TorchServe等。
以TensorFlow Serving为例,它是一个灵活、高性能的模型服务器,支持TensorFlow模型的RESTful和gRPC API接口。部署过程通常涉及以下步骤:
- 将训练好的模型导出为TensorFlow Serving支持的格式。
- 配置TensorFlow Serving的模型服务器,指定模型名称和路径。
- 启动TensorFlow Serving服务器,并设置相应的监听端口。
- 使用客户端向TensorFlow Serving发送推理请求。
代码示例:
# 导出模型为SavedModel格式
export_dir = 'path/to/exported_model'
model.save(export_dir, save_format='tf')

# 使用TensorFlow Serving部署模型
# 假设有一个TensorFlow Serving的Docker镜像运行在本地服务器的8501端口
!saved_model_cli show --dir {export_dir} --all
在上述代码中,我们首先将模型导出为SavedModel格式,然后使用 saved_model_cli 来展示模型的详细信息,这是部署前的准备工作。部署的具体步骤会涉及到服务端的配置,这里未具体展开。
在模型部署到生产环境后,可能还需要进行性能监控、实时数据分析和动态资源调整等后续操作,以确保模型的稳定性和高效运行。
7. 微调BERT在NLP任务中的应用
BERT模型的微调是一种强大的技术,它允许研究者和开发者将预训练的BERT模型应用于各种NLP任务,通过调整模型参数来适应特定的数据集和任务需求。在这一章中,我们将深入了解BERT如何在特定的NLP任务中得到应用,并探索其带来的改进和效果。
7.1BERT在文本分类任务中的应用
7.1.1 文本分类任务的概述
文本分类是NLP领域中一项基础任务,其目标是将一段文本分配到一个或多个预定义的类别中。例如,在情感分析任务中,文本需要被分类为正面或负面情绪。BERT通过理解文本的上下文信息,为文本分类任务提供了更为丰富的特征表示。
7.1.2 BERT在文本分类任务中的效果和改进
使用BERT进行微调,可以在文本分类任务中获得显著的效果提升。一个典型的例子是在IMDb电影评论数据集上的情感分析任务。在预处理步骤中,我们首先使用BERT的Tokenizer对文本进行分词和编码,然后将得到的Token ID填充到固定长度,并加上分类任务所需的标签。微调时,BERT的最后几层会被替换成一个简单的分类层,并使用分类任务的数据集进行训练。实践中,微调后的BERT模型在多个基准数据集上创造了新的最佳表现。
7.2BERT在序列标注任务中的应用
7.2.1 序列标注任务的介绍
序列标注任务是另一个广泛研究的NLP问题,它要求对输入文本序列中的每个元素进行标记,如词性标注(POS tagging)或命名实体识别(NER)。BERT通过微调,可以捕捉序列中的复杂特征,使得模型在序列标注任务中达到新的高度。
7.2.2 BERT在序列标注任务中的优势
BERT的一个关键优势是它的双向上下文理解能力,这使得它在序列标注任务中能够超越传统的单向模型。在NER任务中,BERT通过微调可以识别和分类文档中的实体,从而在CoNLL 2003英文数据集上实现比之前模型更高的F1分数。在微调过程中,数据需要以特殊的格式进行标记,BERT模型能够理解这种格式,并输出正确的标签序列。
7.3BERT在问答系统中的应用
7.3.1 问答系统的构成和发展
问答系统旨在理解自然语言问题,并给出准确的答案。从基于规则的系统到基于检索的系统,再到现在的基于深度学习的系统,问答技术已经取得了显著的发展。BERT模型为问答系统提供了先进的上下文理解能力,允许系统更准确地定位问题中的关键信息。
7.3.2 BERT在问答系统中的实践案例
BERT在问答系统中的一个典型实践案例是SQuAD(Stanford Question Answering Dataset)。在该任务中,模型需要从给定的段落中找到问题的答案。BERT模型可以首先理解整个段落,然后理解问题,并基于理解的上下文定位答案。通过在SQuAD数据集上进行微调,BERT能够达到前所未有的准确率,超越了以往所有模型。通过微调,BERT不仅能够提供答案的位置,还能够提供更丰富的信息,如答案的置信度。
以上所述只是BERT模型在NLP任务中应用的一部分。通过微调,BERT的适应性得到了极大扩展,它能够在不同的任务中展示强大的性能。这使得BERT成为NLP领域中的一个关键工具,为各种语言理解任务提供了新的可能。
简介:BERT是自然语言处理领域的预训练模型,Keras作为TensorFlow的高级API使得深度学习模型构建更加简单。本文章提供在Keras框架下微调BERT模型的具体步骤,包括安装依赖、加载预训练模型、创建模型、数据预处理、数据集准备、编译模型、训练模型以及评估与推理,旨在帮助用户更好地适应特定的NLP任务。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献11条内容

所有评论(0)