理解 Python 中时间序列分析的状态空间模型
时间序列数据(通常)比较杂乱。当你观察图表时,你明白在抖动的线条下方隐藏着某种模式。但这很难被发现。
状态空间模型通过将隐藏结构与观测到的噪声分离,有助于提取这种模式。你同时对信号和噪声进行建模。一个方程追踪底层过程的变化。另一个方程解释该过程如何产生你实际测量的结果。
可以将其视为一个包含两层的系统:状态层描述平滑的、未观察到的过程——真实的趋势。观察层描述您在数据中看到的该趋势的噪声版本。
该模型通过观察数据随时间的变化来估计隐藏层。每次新的观察都会推动对真实状态的估计。这就像从音频信号中滤除噪声一样。你不仅仅是平滑数据,还要模拟真实信号如何变化,以及哪些类型的噪声会使其失真。
从数学上讲,这是一对方程式:
State:        xₜ = xₜ₋₁ + wₜ
Observation:  yₜ = xₜ + vₜ
这里xₜ是时间的潜在状态t,wₜ是过程噪声,yₜ是观测值,vₜ是观测噪声。
隐藏状态会使用卡尔曼滤波器随时间更新。这能让你对底层实际发生的情况进行持续估计。它是递归的,每一步都使用上一步的数据。这使得它非常适合实时监控、预测和检测变化。
你并非用单一模型拟合整个数据集。你只是在估算一个变化的状态,一次估算一个时间点。当数据反映缓慢变化的力量、突然的变化或季节性变化时,这一点尤其有用。模型不是猜测趋势,而是学习它。
您可以通过多种方式扩展此结构。您可以让状态遵循线性趋势,而不仅仅是某个水平。您可以添加季节性成分、周期性效应,甚至回归量。您可以一次对多个序列进行建模。您可以使用该模型进行预测、信号提取或变化检测。
状态空间模型的独特之处在于,它们不仅仅是平滑数据,而是对数据生成过程进行建模。这不仅能提供趋势线,还能对趋势如何以及为何如此变化提供正式的解释。
让我们用一个历史例子来说明这一点。英国从1837年到1983年,每季度都会详细记录出生、死亡和结婚的情况。这相当于近150年的人口统计数据。这些原始数据参差不齐,且存在噪音。但在这些噪音的背后,隐藏着长期的因素——工业化、战争、和平、萧条、复苏。
我们将使用状态空间模型来提取这些隐藏的因素。我们将从出生序列入手,估算潜在趋势,并解读该模型揭示的英国人随时间变化的生活状况。
真实案例:英国的生育率
英国从 1837 年到 1983 年开始保存出生记录。这让我们能够长期了解战争、经济衰退和社会变革时期的生育情况。
我们使用状态空间模型来分离平滑趋势。如下所示:
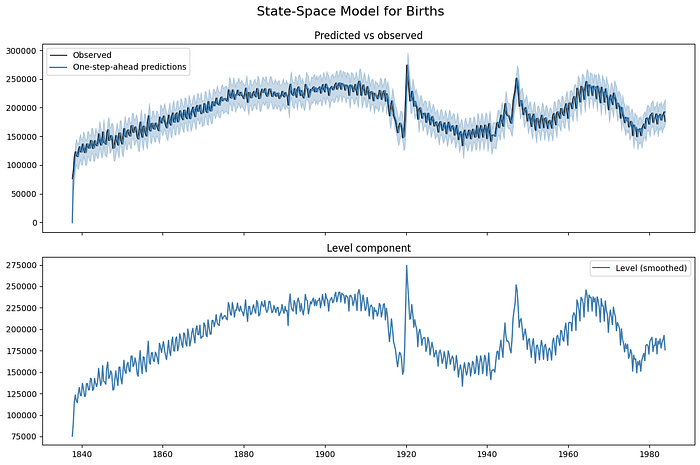
顶部面板显示了模型跟踪观测值的准确程度。底部面板显示了潜在趋势。您可以清楚地看到巨大的变化:
- 19 世纪的崛起
- 第一次世界大战期间的崩溃
- 1945年以后的战后繁荣
- 20世纪70年代的衰落
这才是真正的价值。我们不只是在拟合一条线。我们正在估算波动性之下的生育率可能是什么样子。
该模型的表现如何?
我们使用三个标准误差指标检查了预测值与实际值。
MAE   = 9,177
RMSE  = 11,608
MAPE  = 5.02%
平均而言,该模型每季度的出生人数误差约为9000例。误差率低于6%。而且,这还涵盖了近150年的数据,包括结构性冲击。
为什么这很重要
历史数据很混乱。商业数据、能源数据、气候数据——任何随时间推移测量的数据都是如此。
问题不仅仅是噪音,问题在于解读。你不想知道发生了什么,你想知道什么可能发生了变化,你想看到无法直接观察到的模式。
这就是状态空间模型的用途。
他们估计下面到底发生了什么。
它们使用起来也不难。UnobservedComponents类会statsmodels处理大部分设置。你可以定义趋势,根据需要添加季节性或周期性,然后让模型完成工作。
这是少数既能洞察历史,又能预测涡轮机传感器漂移的工具之一。
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
from statsmodels.tsa.statespace.structural import UnobservedComponents
from sklearn.metrics import mean_absolute_error, mean_squared_error, mean_absolute_percentage_error

def run_ucm(df, series_name, title):
    series = df[series_name].dropna()

    model = UnobservedComponents(series, level='local level')
    results = model.fit(disp=False)

    # One-step-ahead predictions
    pred = results.get_prediction()
    mean = pred.predicted_mean
    ci = pred.conf_int()

    fig, axes = plt.subplots(2, 1, figsize=(12, 8), sharex=True)
    fig.suptitle(f'State-Space Model for {title}', fontsize=16)

    # Plot observed vs predicted
    axes[0].plot(series.index, series, label='Observed', color='black', linewidth=1)
    axes[0].plot(mean.index, mean, label='One-step-ahead predictions', color='steelblue')
    axes[0].fill_between(mean.index, ci.iloc[:, 0], ci.iloc[:, 1], color='steelblue', alpha=0.3)
    axes[0].legend()
    axes[0].set_title('Predicted vs observed')

    # Extract smoothed level from results.smoothed_state
    smoothed_level = results.smoothed_state[0]  # Index 0 is level component
    smoothed_index = series.index

    # Smoothed level confidence intervals
    level_var = results.smoothed_state_cov[0, 0, :]  # variance of level
    level_std = np.sqrt(level_var)
    lower = smoothed_level - 1.96 * level_std
    upper = smoothed_level + 1.96 * level_std

    axes[1].plot(smoothed_index, smoothed_level, label='Level (smoothed)', color='steelblue')
    axes[1].fill_between(smoothed_index, lower, upper, color='steelblue', alpha=0.3)
    axes[1].set_title('Level component')
    axes[1].legend()

    plt.tight_layout()
    plt.subplots_adjust(top=0.90)
    plt.savefig(f'statespace_{series_name.lower()}.png')
    plt.show()

    # Error metrics
    observed = series.loc[mean.index].dropna()
    predicted = mean.loc[observed.index].dropna()
    observed, predicted = observed.align(predicted, join='inner')

    mae = mean_absolute_error(observed, predicted)
    rmse = np.sqrt(mean_squared_error(observed, predicted))
    mape = mean_absolute_percentage_error(observed, predicted)

    print(f"\nError Metrics for {title}:")
    print(f"  MAE  = {mae:,.0f}")
    print(f"  RMSE = {rmse:,.0f}")
    print(f"  MAPE = {mape:.2%}")


url = "https://raw.githubusercontent.com/kylejones200/time_series/refs/heads/main/Uk%20vital%20statistics%20data%20cleaned_data.csv"
df = pd.read_csv(url)

run_ucm(df, 'Births', 'Births')

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)