3分钟带你手搓 Transformer 注意力机制——原理+数值全过程详解
前言
Transformer 架构自 2017 年提出以来,已经横扫了 NLP 和 CV 领域。而它的灵魂核心,就是 Scaled Dot-Product Attention(缩放点积注意力机制)。
很多同学背得下公式,却不知道具体数据是怎么流转的。本文将通过一个通俗易懂的“查字典”比喻,结合全过程数值手算,带你彻底搞懂注意力机制的底层运算逻辑。
一、 核心概念:Q、K、V 是什么?
在注意力机制中,有三个核心向量:Query (Q)、Key (K)、Value (V)。这三个概念来源于信息检索系统。
我们可以把注意力机制想象成**“查字典”**的过程:
-
Query (查询):你手里拿着的查询条件。比如你想查“fruit (水果)”。
-
Key (键):字典里的索引标签。比如字典里有“apple (苹果)”、“banana (香蕉)”、“chair (椅子)”。
-
Value (值):标签对应的具体内容(语义信息)。
注意力的本质就是: 拿着你手里的 Q (fruit),去和每一个 K 进行匹配。
-
如果 Q 和某个 K 很像(比如 apple),那我们就多关注它的 V 一点(权重高)。
-
如果 Q 和某个 K 不像(比如 chair),那我们就少关注甚至忽略它的 V(权重低)。
-
最后,把所有关注到的 V 加权融合,就得到了最终的输出。
二、 核心公式
Transformer 中标准的注意力计算公式如下:
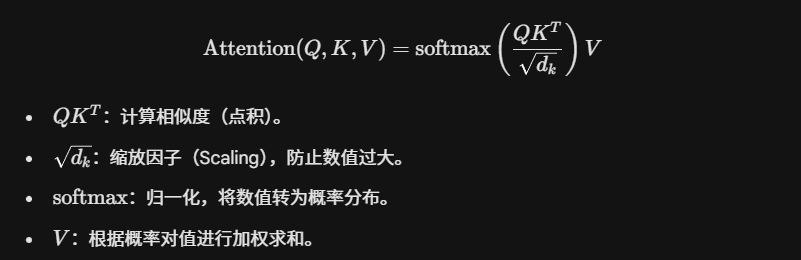
三、 全过程数值演练(Hand Calculation)
为了让大家看清楚每一步发生了什么,我们假设向量维度
3.1 数据准备
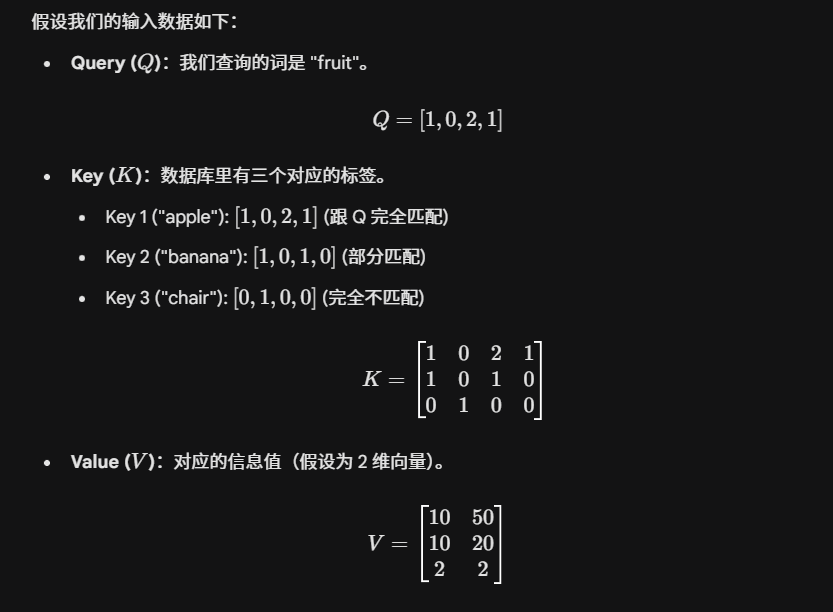
3.2 计算相似度 

3.3 缩放(Scaling)
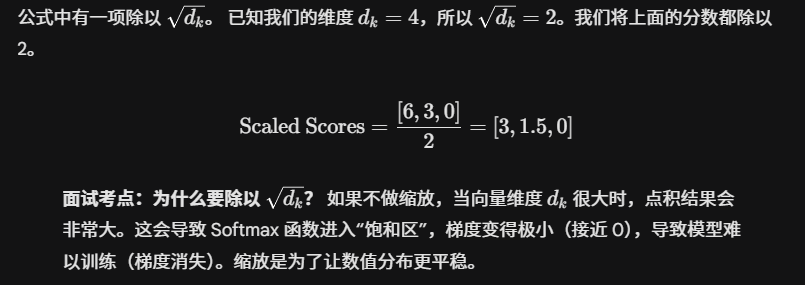
3.4 归一化 (Softmax)

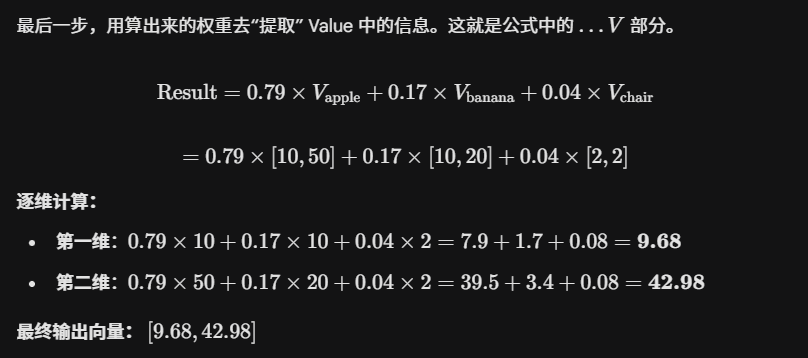
3.5 加权求和(Weight Sum)
四、总结
通过上述计算,我们得到了一个新向量 [9.68, 42.98]。回头看原始的 Value:
-
Apple 的 Value 是 [10, 50]
-
输出结果非常接近 Apple,但也混入了一点 Banana 的特征。
这完美展示了注意力机制的效果:当我们在处理 "fruit" 这个词时,模型自动把目光聚焦在了 "apple"(权重 0.79)上,稍微看了一眼 "banana"(权重 0.17),而几乎忽略了 "chair"(权重 0.04)。
这就是 Transformer 能够精准捕捉上下文语义的秘密!、
PS:(6行代码实现注意力机制)
一个Python函数实现注意力机制:
# 注意力机制计算函数
def calculate_attention(query_matrix, key_matrix, value_matrix, dropout_layer=None):
    """
    实现Transformer的注意力机制计算
    参数:
        query_matrix: 查询矩阵 (形状: [批量大小, 头数, 序列长度, 特征维度])
        key_matrix: 键矩阵 (形状与query_matrix一致)
        value_matrix: 值矩阵 (形状与query_matrix一致)
        dropout_layer: 可选的dropout层,用于防止过拟合
    返回:
        注意力计算后的输出矩阵 + 注意力权重矩阵
    """
    # 获取每个token的特征维度(query/key/value的特征维度相同)
    feature_dim = query_matrix.size(-1)

    # 1. 计算query与key的相似度(内积),并除以特征维度的平方根做缩放
    # (防止特征维度太大时,softmax结果过于极端)
    similarity_scores = torch.matmul(
        query_matrix,
        key_matrix.transpose(-2, -1)  # 将key的"特征维度"和"序列长度"维度交换(转置)
    ) / math.sqrt(feature_dim)

    # 2. 对相似度得分做softmax,得到注意力权重(每一行和为1)
    attention_weights = similarity_scores.softmax(dim=-1)

    # 3. 用注意力权重对value矩阵做加权求和,得到最终输出
    attention_output = torch.matmul(attention_weights, value_matrix)

    # 返回注意力输出 + 注意力权重(权重可用于可视化注意力分布)
    return attention_output, attention_weights

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献3条内容

所有评论(0)