散斑双目相机深度图滤波---个人学习篇
文章目录
📌 核心要点速查表
| 问题类型 | 推荐算法 | 核心参数 | 优先级 |
|---|---|---|---|
| 实时性能低 | 智能降采样 | 2×2 非零均值下采样 | ⭐⭐⭐ |
| 孤立噪点/飞点 | 连通域去噪 | minArea=50~100 | ⭐⭐⭐⭐⭐ |
| 边缘粗糙/重影 | 域变换滤波(视差域) | Alpha=0.6, Delta=8 | ⭐⭐⭐⭐⭐ |
| 弱纹理误匹配 | 联合双边滤波 / 引导滤波 | 结合 RGB 图指导 | ⭐⭐⭐⭐ |
| 深度图空洞 | 左邻域填充(遮挡填充) | radius=10 | ⭐⭐⭐⭐ |
| 视频时序抖动 | 自适应时域滤波 | Alpha=0.3~0.8 | ⭐⭐⭐ |
| 边缘深度不准 | 引导滤波 + 左右一致性检查 | eps=1e-4, radius=8 | ⭐⭐⭐⭐ |
1. 散斑双目深度相机原理概述
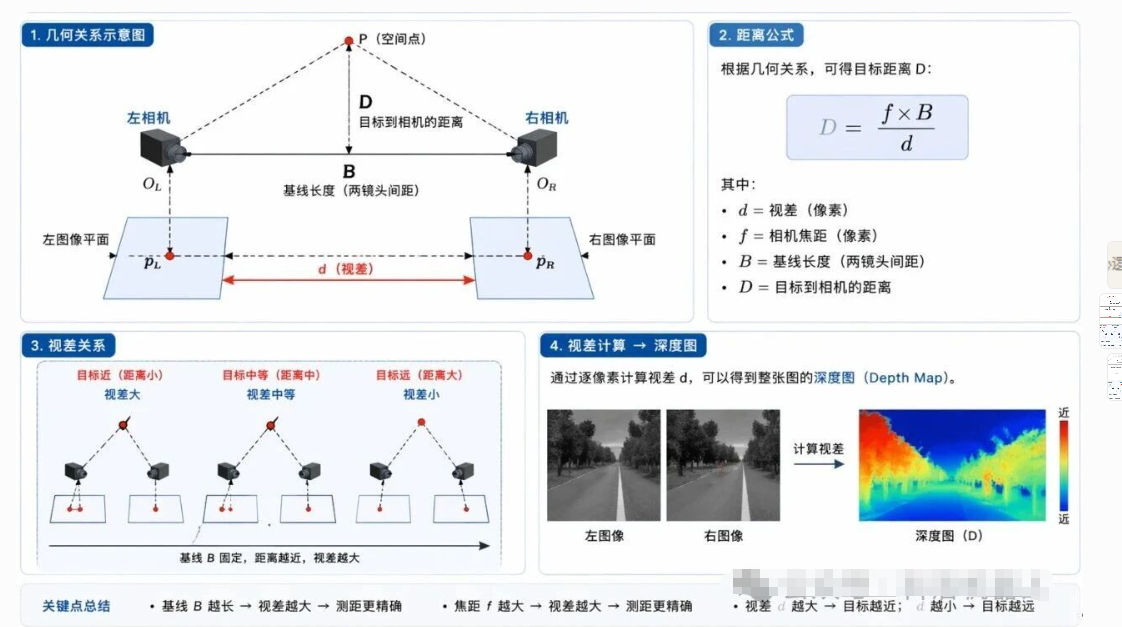
散斑双目深度相机是一种主动式光学3D 成像技术,其工作原理:
- 散斑投射:红外激光投射器向目标场景投射一组随机但固定的红外激光散斑图案
- 双目采集:左右两个红外摄像头同步采集带有散斑的图像
- 立体匹配:通过计算左右图像中散斑的视差(Disparity),利用三角测量法恢复深度信息
- 深度计算:
Z = f ⋅ B d Z = \frac{f \cdot B}{d} Z=df⋅B
其中 f f f 为焦距, B B B 为基线距离, d d d 为视差
与纯被动双目相比,散斑提供了丰富的纹理信息,使得在低纹理区域(如白墙、地板)也能进行有效匹配。
1.1 典型硬件平台
| 平台 | 分辨率 | 帧率 | 深度范围 | 特点 |
|---|---|---|---|---|
| Intel RealSense D435i | 1280×720 | 90fps | 0.2~10m | 内置 IMU,内置后处理滤波 |
| Intel RealSense D455 | 1280×720 | 90mm | 0.6~6m | 更大基线,远距精度更好 |
| Orbbec Astra Pro Plus | 1280×800 | 30fps | 0.4~5m | USB-C,支持 OpenNI |
| Orbbec Femto Mega | 1280×800 | 30fps | 0.25~5m | 内置 GPU 加速 |
2.深度图噪声来源分析
散斑双目深度图的噪声主要有以下来源:
| 噪声类型 | 成因 | 表现 | 影响程度 |
|---|---|---|---|
| 匹配错误 | 散斑纹理重复/遮挡导致误匹配 | 深度值跳变、孤立噪点 | ★★★★★ |
| 遮挡噪声 | 左右摄像头视角差异,部分区域仅单侧可见 | 物体边缘出现"飞点" | ★★★★ |
| 边缘扩散 | 物体边缘处散斑跨越前景/背景 | 边缘深度值不准确 | ★★★★ |
| 低信噪比 | 远距离或高散射表面,散斑信号弱 | 深度缺失、空洞 | ★★★ |
| 量化噪声 | 视差离散化(整像素或半像素精度) | 深度图呈阶梯状 | ★★ |
| 多路径反射 | 散斑在凹角处多次反射 | 局部深度值偏大 | ★★ |
| 运动模糊 | 采集时物体或相机运动 | 运动区域深度失真 | ★★★ |
| 温度漂移 | 相机温度变化导致标定参数偏移 | 全局深度偏移 | ★★ |
2.1 噪声的空间分布特征
散斑双目深度图的噪声不是均匀分布的,具有明显的空间特征:
- 近处(<1m):噪声较低,但遮挡区域多,飞点集中于物体边缘
- 中距离(1~3m):噪声适中,是最佳工作区间
- 远处(>3m):散斑信号衰减,匹配精度急剧下降,空洞大面积出现
- 边缘区域:深度不连续处噪声最高,是所有滤波器重点关注的区域
3. 深度噪声的距离特性与视差域滤波原理
3.1 为什么要在视差域滤波?
这是深度图滤波中最核心但最容易被忽略的概念。
深度 Z Z Z 和视差 d d d 的关系为 Z = f B d Z = \frac{fB}{d} Z=dfB,这意味着:
- 视差 d d d 的误差 σ d \sigma_d σd 是恒定的(取决于匹配算法精度)
- 深度 Z Z Z 的误差 σ Z = f B d 2 σ d = Z 2 f B σ d \sigma_Z = \frac{fB}{d^2} \sigma_d = \frac{Z^2}{fB} \sigma_d σZ=d2fBσd=fBZ2σd
关键结论:深度噪声随距离二次方增长!
| 距离 | 视差噪声(恒定) | 深度噪声 |
|---|---|---|
| 1m | ~0.1 像素 | ~1mm |
| 2m | ~0.1 像素 | ~4mm |
| 5m | ~0.1 像素 | ~25mm |
实际意义:
- 在深度空间做滤波时,近处和远处的噪声水平差异巨大,固定的滤波参数无法兼顾
- 在视差空间做滤波时,噪声水平恒定,一套参数即可覆盖所有距离
- 最佳实践:深度 → 视差 → 滤波 → 深度
// 深度 ↔ 视差 转换
cv::Mat depthToDisparity(const cv::Mat& depth, double fx, double baseline) {
    cv::Mat disp;
    cv::divide(fx * baseline, depth, disp);
    return disp;
}

cv::Mat disparityToDepth(const cv::Mat& disp, double fx, double baseline) {
    cv::Mat depth;
    cv::divide(fx * baseline, disp, depth);
    return depth;
}
3.2 视差域 vs 深度域滤波对比
| 特性 | 视差域滤波 | 深度域滤波 |
|---|---|---|
| 噪声一致性 | ✅ 恒定 | ❌ 随距离二次方增长 |
| 参数泛化性 | ✅ 一套参数通用于所有距离 | ❌ 需要按距离分区调参 |
| 保边效果 | ✅ 边缘处视差跳变一致 | ❌ 近处边缘跳变大,远处跳变小 |
| 实现复杂度 | 需要深度↔视差转换 | 直接操作 |
| 推荐程度 | ⭐⭐⭐⭐⭐(强烈推荐) | ⭐⭐(简单场景可用) |
4. 视差图预处理滤波
4.1 SGBM 视差计算与参数调优
OpenCV 的 StereoSGBM 是散斑双目最常用的视差计算算法。关键参数调优直接影响深度图质量。
#include <opencv2/opencv.hpp>
#include <opencv2/calib3d.hpp>
#include <opencv2/ximgproc.hpp>

cv::Ptr<cv::StereoSGBM> createSGBM(int minDisp, int numDisp, int blockSize) {
    cv::Ptr<cv::StereoSGBM> sgbm = cv::StereoSGBM::create(
        minDisp,                // minDisparity: 最小视差,通常为0
        numDisp,                // numDisparities: 视差范围,必须是16的倍数
        blockSize               // blockSize: 匹配块大小,奇数3~11
    );

    sgbm->setPreFilterCap(63);           // 预处理截断值
    sgbm->setBlockSize(blockSize);        // 匹配块大小
    sgbm->setP1(8 * 3 * blockSize * blockSize);   // 惩罚项P1(视差平滑)
    sgbm->setP2(32 * 3 * blockSize * blockSize);  // 惩罚项P2(视差跳变惩罚)
    sgbm->setMinDisparity(minDisp);
    sgbm->setNumDisparities(numDisp);
    sgbm->setUniquenessRatio(10);         // 唯一性比率:最佳匹配必须明显优于次佳
    sgbm->setSpeckleWindowSize(100);      // 散斑窗口大小
    sgbm->setSpeckleRange(32);            // 散斑视差范围
    sgbm->setDisp12MaxDiff(1);            // 左右一致性最大差异
    sgbm->setMode(cv::StereoSGBM::MODE_SGBM);

    return sgbm;
}

// 使用示例
void computeDisparity(const cv::Mat& leftImg, const cv::Mat& rightImg,
                      cv::Mat& dispMap) {
    auto sgbm = createSGBM(0, 128, 5);
    cv::Mat disp16;
    sgbm->compute(leftImg, rightImg, disp16);

    // 转换为浮点视差图(单位:像素)
    disp16.convertTo(dispMap, CV_32F, 1.0 / 16.0);
}
参数调优要点:
| 参数 | 含义 | 调优建议 |
|---|---|---|
numDisparities | 视差搜索范围 | 根据场景最大深度反算: d m a x = f ⋅ B Z m i n d_{max} = \frac{f \cdot B}{Z_{min}} dmax=Zminf⋅B,必须是 16 的倍数 |
blockSize | 匹配块大小 | 散斑纹理较粗时用较大值(59),较细时用较小值(35) |
P1 | 小视差变化惩罚 | 控制平滑性,建议 8×C×blockSize² |
P2 | 大视差变化惩罚 | P2/P1 比值越大越平滑,建议 32×C×blockSize² |
uniquenessRatio | 唯一性比率 | 越大越严格(减少误匹配但增加空洞),建议 10~15 |
speckleWindowSize | 散斑滤波窗口 | 内置散斑滤波,建议 50~200 |
speckleRange | 散斑视差范围 | 同一连通域内最大视差差异,建议 16~32 |
disp12MaxDiff | 左右一致性阈值 | 0 表示禁用,1~2 为常用值 |
SGM 惩罚项 P1/P2 深入理解:
SGM 的核心是沿多条路径做动态规划,惩罚项决定了视差平滑性:
- P1:相邻像素视差差为1时的惩罚,控制局部平滑
- P2:相邻像素视差差>1时的惩罚,控制大跳变的抑制
- 自适应 P2:根据引导图的梯度自适应调整P2,在边缘处降低P2以保留深度不连续性
// 自适应P2示例:在边缘处降低P2
cv::Mat gray;
cv::cvtColor(leftImg, gray, cv::COLOR_BGR2GRAY);
cv::Mat gradX, gradY, gradMag;
cv::Sobel(gray, gradX, CV_32F, 1, 0, 3);
cv::Sobel(gray, gradY, CV_32F, 0, 1, 3);
cv::magnitude(gradX, gradY, gradMag);

// 梯度大的地方P2降低(边缘保留)
// 梯度小的地方P2增大(平滑区域更强平滑)
4.2 智能降采样(性能优化首选)
在处理高分辨率深度图(如1280×720)时,直接滤波计算量极大。Intel 官方建议:在处理前先进行智能降采样,不仅能将后续处理速度提升4倍,还能起到预去噪和基础填洞的作用。
Python例子
import cv2
import numpy as np

def smart_subsample(depth_map, factor=2):
    """智能降采样:使用非零均值(Non-zero Mean)计算块内平均值"""
    if factor == 1:
        return depth_map

    h, w = depth_map.shape
    new_h, new_w = h // factor, w // factor

    reshaped = depth_map[:new_h*factor, :new_w*factor].reshape(new_h, factor, new_w, factor)

    with np.errstate(divide='ignore', invalid='ignore'):
        result = np.true_divide(reshaped.sum(axis=(1,3)), (reshaped > 0).sum(axis=(1,3)))
        result = np.nan_to_num(result, nan=0.0)

    return result.astype(np.float32)
C++例子
// C++ 版本:智能降采样
cv::Mat smartSubsample(const cv::Mat& depth, int factor = 2) {
    if (factor == 1) return depth.clone();

    int newRows = depth.rows / factor;
    int newCols = depth.cols / factor;
    cv::Mat result = cv::Mat::zeros(newRows, newCols, CV_32F);

    for (int y = 0; y < newRows; y++) {
        for (int x = 0; x < newCols; x++) {
            float sum = 0;
            int count = 0;
            for (int dy = 0; dy < factor; dy++) {
                for (int dx = 0; dx < factor; dx++) {
                    float val = depth.at<float>(y * factor + dy, x * factor + dx);
                    if (val > 0) {
                        sum += val;
                        count++;
                    }
                }
            }
            if (count > 0) result.at<float>(y, x) = sum / count;
        }
    }
    return result;
}
4.3 视差图置信度过滤
根据匹配代价或唯一性比率生成置信度图,过滤低置信度像素。
/**
 * 计算视差置信度图
 * 方法:比较最佳匹配与次佳匹配的代价差异
 */
cv::Mat computeConfidenceMap(const cv::Mat& costVolume,
                             const cv::Mat& dispMap,
                             int numDisparities) {
    int rows = dispMap.rows, cols = dispMap.cols;
    cv::Mat confidence = cv::Mat::zeros(rows, cols, CV_32F);

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            float d = dispMap.at<float>(y, x);
            if (d <= 0) continue;

            int bestIdx = static_cast<int>(d);
            if (bestIdx < 0 || bestIdx >= numDisparities) continue;

            // 找次佳匹配代价
            float bestCost = costVolume.at<float>(y, x * numDisparities + bestIdx);
            float secondBestCost = FLT_MAX;
            for (int i = 0; i < numDisparities; i++) {
                if (abs(i - bestIdx) <= 1) continue;  // 跳过邻近
                float cost = costVolume.at<float>(y, x * numDisparities + i);
                if (cost < secondBestCost) secondBestCost = cost;
            }

            // 置信度 = (次佳 - 最佳) / 次佳,越大越可靠
            if (secondBestCost > 1e-6) {
                confidence.at<float>(y, x) = (secondBestCost - bestCost) / secondBestCost;
            }
        }
    }
    return confidence;
}

/**
 * 根据置信度阈值过滤视差图
 */
void filterByConfidence(cv::Mat& dispMap, const cv::Mat& confidence,
                        float threshold = 0.15f) {
    for (int y = 0; y < dispMap.rows; y++) {
        for (int x = 0; x < dispMap.cols; x++) {
            if (confidence.at<float>(y, x) < threshold) {
                dispMap.at<float>(y, x) = 0;  // 标记为无效
            }
        }
    }
}
4.4 亚像素视差精化
通过抛物线拟合将整像素视差精化到亚像素级别,减少量化噪声。
/**
 * 亚像素视差精化:对每个像素在最佳视差位置附近做抛物线拟合
 */
void refineSubpixelDisparity(const cv::Mat& costVolume, cv::Mat& dispMap,
                              int numDisparities) {
    int rows = dispMap.rows, cols = dispMap.cols;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            int d = static_cast<int>(dispMap.at<float>(y, x));
            if (d <= 0 || d >= numDisparities - 1) continue;

            // 取 d-1, d, d+1 三个点的代价
            float c_prev = costVolume.at<float>(y, x * numDisparities + d - 1);
            float c_curr = costVolume.at<float>(y, x * numDisparities + d);
            float c_next = costVolume.at<float>(y, x * numDisparities + d + 1);

            // 抛物线拟合: 顶点偏移 = 0.5 * (c_prev - c_next) / (c_prev - 2*c_curr + c_next)
            float denom = c_prev - 2.0f * c_curr + c_next;
            if (fabs(denom) > 1e-6f) {
                float offset = 0.5f * (c_prev - c_next) / denom;
                dispMap.at<float>(y, x) = d + offset;
            }
        }
    }
}
5. 空域滤波算法
5.1 中值滤波
对深度图中的椒盐噪声(随机跳变点)效果极好,且不会模糊边缘。
/**
 * 自适应中值滤波
 * 根据局部噪声程度自动调整滤波窗口大小
 */
cv::Mat adaptiveMedianFilter(const cv::Mat& depthMap, int maxKernelSize = 7) {
    cv::Mat result = depthMap.clone();
    int rows = depthMap.rows, cols = depthMap.cols;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            float centerVal = depthMap.at<float>(y, x);
            if (centerVal <= 0) continue;  // 跳过空洞

            bool filtered = false;
            for (int ksize = 3; ksize <= maxKernelSize; ksize += 2) {
                int half = ksize / 2;
                std::vector<float> neighbors;

                // 收集邻域有效深度值
                for (int dy = -half; dy <= half; dy++) {
                    for (int dx = -half; dx <= half; dx++) {
                        int ny = y + dy, nx = x + dx;
                        if (ny >= 0 && ny < rows && nx >= 0 && nx < cols) {
                            float val = depthMap.at<float>(ny, nx);
                            if (val > 0) neighbors.push_back(val);
                        }
                    }
                }

                if (neighbors.size() < 3) continue;

                std::sort(neighbors.begin(), neighbors.end());
                float zmin = neighbors.front();
                float zmax = neighbors.back();
                float zmed = neighbors[neighbors.size() / 2];

                // Level A: 中值在有效范围内
                if (zmed > zmin && zmed < zmax) {
                    // Level B: 中心值是否为噪声
                    if (centerVal > zmin && centerVal < zmax) {
                        result.at<float>(y, x) = centerVal;  // 保留原值
                    } else {
                        result.at<float>(y, x) = zmed;  // 用中值替换
                    }
                    filtered = true;
                    break;
                }
            }

            // 如果所有窗口都无法处理,用最大窗口的中值
            if (!filtered) {
                int half = maxKernelSize / 2;
                std::vector<float> neighbors;
                for (int dy = -half; dy <= half; dy++) {
                    for (int dx = -half; dx <= half; dx++) {
                        int ny = y + dy, nx = x + dx;
                        if (ny >= 0 && ny < rows && nx >= 0 && nx < cols) {
                            float val = depthMap.at<float>(ny, nx);
                            if (val > 0) neighbors.push_back(val);
                        }
                    }
                }
                if (!neighbors.empty()) {
                    std::sort(neighbors.begin(), neighbors.end());
                    result.at<float>(y, x) = neighbors[neighbors.size() / 2];
                }
            }
        }
    }
    return result;
}

// 快速版本:使用OpenCV内置中值滤波(需先转换为16位)
cv::Mat fastMedianFilter(const cv::Mat& depthMap, int ksize = 5) {
    cv::Mat depth16;
    depthMap.convertTo(depth16, CV_16U, 1000);  // 转为毫米
    cv::Mat filtered;
    cv::medianBlur(depth16, filtered, ksize);
    cv::Mat result;
    filtered.convertTo(result, CV_32F, 1.0 / 1000.0);
    return result;
}
5.2 双边滤波
同时考虑空间距离和深度值差异,在平滑噪声的同时保留深度边缘。
/**
 * 深度图双边滤波
 * @param depthMap    输入深度图 (CV_32F)
 * @param sigmaSpace  空间域高斯核标准差
 * @param sigmaDepth  深度值域高斯核标准差
 * @param kernelSize  滤波窗口大小
 */
cv::Mat depthBilateralFilter(const cv::Mat& depthMap,
                             double sigmaSpace = 15.0,
                             double sigmaDepth = 0.1,
                             int kernelSize = 9) {
    int rows = depthMap.rows, cols = depthMap.cols;
    cv::Mat result = cv::Mat::zeros(rows, cols, CV_32F);
    int half = kernelSize / 2;

    // 预计算空间域高斯权重
    cv::Mat spatialWeight(kernelSize, kernelSize, CV_32F);
    for (int dy = -half; dy <= half; dy++) {
        for (int dx = -half; dx <= half; dx++) {
            float dist2 = (float)(dx * dx + dy * dy);
            spatialWeight.at<float>(dy + half, dx + half) =
                exp(-dist2 / (2.0f * sigmaSpace * sigmaSpace));
        }
    }

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            float centerVal = depthMap.at<float>(y, x);
            if (centerVal <= 0) {
                result.at<float>(y, x) = 0;
                continue;
            }

            float sumWeight = 0;
            float sumValue = 0;

            for (int dy = -half; dy <= half; dy++) {
                for (int dx = -half; dx <= half; dx++) {
                    int ny = y + dy, nx = x + dx;
                    if (ny < 0 || ny >= rows || nx < 0 || nx >= cols) continue;

                    float neighborVal = depthMap.at<float>(ny, nx);
                    if (neighborVal <= 0) continue;

                    // 空间权重
                    float ws = spatialWeight.at<float>(dy + half, dx + half);
                    // 深度值域权重
                    float diff = centerVal - neighborVal;
                    float wr = exp(-(diff * diff) / (2.0f * sigmaDepth * sigmaDepth));

                    float w = ws * wr;
                    sumWeight += w;
                    sumValue += w * neighborVal;
                }
            }

            if (sumWeight > 1e-6f) {
                result.at<float>(y, x) = sumValue / sumWeight;
            } else {
                result.at<float>(y, x) = centerVal;
            }
        }
    }
    return result;
}
5.3 联合双边滤波(JBF)
利用RGB 图像的边缘信息指导深度图滤波,是散斑双目最常用的保边滤波方法之一。
/**
 * 联合双边滤波:以RGB图为引导
 * @param depthMap  输入深度图 (CV_32F)
 * @param guideImg  引导图像 (RGB, CV_8UC3)
 * @param sigmaSpace 空间域标准差
 * @param sigmaColor 颜色域标准差
 */
cv::Mat jointBilateralFilter(const cv::Mat& depthMap, const cv::Mat& guideImg,
                             double sigmaSpace = 15.0, double sigmaColor = 25.0) {
    int rows = depthMap.rows, cols = depthMap.cols;
    cv::Mat result = cv::Mat::zeros(rows, cols, CV_32F);
    int kernelSize = static_cast<int>(std::ceil(sigmaSpace * 3)) * 2 + 1;
    int half = kernelSize / 2;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            float centerDepth = depthMap.at<float>(y, x);
            if (centerDepth <= 0) continue;

            cv::Vec3b centerColor = guideImg.at<cv::Vec3b>(y, x);
            float sumWeight = 0, sumValue = 0;

            for (int dy = -half; dy <= half; dy++) {
                for (int dx = -half; dx <= half; dx++) {
                    int ny = y + dy, nx = x + dx;
                    if (ny < 0 || ny >= rows || nx < 0 || nx >= cols) continue;

                    float neighborDepth = depthMap.at<float>(ny, nx);
                    if (neighborDepth <= 0) continue;

                    cv::Vec3b neighborColor = guideImg.at<cv::Vec3b>(ny, nx);

                    // 空间权重
                    float ws = exp(-(dx * dx + dy * dy) / (2.0f * sigmaSpace * sigmaSpace));
                    // 颜色权重(RGB欧氏距离)
                    float colorDiff2 = 0;
                    for (int c = 0; c < 3; c++) {
                        float d = (float)(centerColor[c] - neighborColor[c]);
                        colorDiff2 += d * d;
                    }
                    float wc = exp(-colorDiff2 / (2.0f * sigmaColor * sigmaColor * 3));

                    float w = ws * wc;
                    sumWeight += w;
                    sumValue += w * neighborDepth;
                }
            }

            result.at<float>(y, x) = (sumWeight > 1e-6f) ? (sumValue / sumWeight) : centerDepth;
        }
    }
    return result;
}
5.4 引导滤波(Guided Filter)
引导滤波是联合双边滤波的高效替代方案,由何恺明(Kaiming He)等人在 ECCV 2010 提出。相比联合双边滤波,它具有线性时间复杂度且不会出现梯度反转伪影。
/**
 * 使用OpenCV ximgproc的引导滤波(推荐,速度快)
 * @param depthMap  输入深度图 (CV_32F)
 * @param guideImg  引导图像 (RGB或Gray)
 * @param radius    滤波窗口半径
 * @param eps       正则化参数(越小保边性越强)
 */
cv::Mat guidedFilterDepth(const cv::Mat& depthMap, const cv::Mat& guideImg,
                          int radius = 8, double eps = 1e-4) {
    cv::Mat guideGray;
    if (guideImg.channels() == 3) {
        cv::cvtColor(guideImg, guideGray, cv::COLOR_BGR2GRAY);
    } else {
        guideGray = guideImg;
    }
    guideGray.convertTo(guideGray, CV_32F, 1.0 / 255.0);

    cv::Mat depth32F;
    depthMap.convertTo(depth32F, CV_32F);

    cv::Mat result = cv::ximgproc::guidedFilter(guideGray, depth32F, radius, eps);
    return result;
}
引导滤波核心原理:
假设输出图 q q q 是引导图 I I I 的局部线性变换:
q i = a k I i + b k , ∀ i ∈ ω k q_i = a_k I_i + b_k, \quad \forall i \in \omega_k qi=akIi+bk,∀i∈ωk
其中 ω k \omega_k ωk 是以像素 k k k 为中心的窗口。通过最小化输出与输入的差异求解 a k , b k a_k, b_k ak,bk:
a k = 1 ∣ ω ∣ ∑ i ∈ ω k I i p i − μ k p ˉ k σ k 2 + ϵ a_k = \frac{\frac{1}{|\omega|}\sum_{i \in \omega_k} I_i p_i - \mu_k \bar{p}_k}{\sigma_k^2 + \epsilon} ak=σk2+ϵ∣ω∣1∑i∈ωkIipi−μkpˉk
b k = p ˉ k − a k μ k b_k = \bar{p}_k - a_k \mu_k bk=pˉk−akμk
eps 参数调优指南:
| eps 值 | 保边性 | 平滑性 | 适用场景 |
|---|---|---|---|
| 1e-6 | 极强 | 弱 | 边缘非常锐利的场景 |
| 1e-4 | 强 | 中等 | 推荐默认值 |
| 1e-2 | 中等 | 强 | 噪声较大,需要更强平滑 |
| 1.0 | 弱 | 极强 | 几乎等价于均值滤波 |
5.5 域变换边缘保持滤波(RealSense官方推荐)
散斑双目的噪声随距离呈二次方增长。因此,在视差空间进行滤波比在深度空间更有效。RealSense D400 系列官方采用了一种快速域变换递归滤波器(Domain Transform Recursive Filter)。
/**
 * 视差域边缘保持滤波(Domain-Transform Filter)
 * 原理:沿水平和垂直方向递归平滑,边缘处停止传播
 * 优点:O(N)复杂度,适合实时处理
 *
 * @param disp_map 输入视差图 (CV_32F)
 * @param alpha 平滑程度 (0.1~0.8,越大越平滑)
 * @param delta 边缘阈值(视差单位,通常设为 8.0)
 */
cv::Mat domainTransformFilter(const cv::Mat& disp_map, float alpha = 0.6f, float delta = 8.0f) {
    cv::Mat result = disp_map.clone();
    int rows = disp_map.rows, cols = disp_map.cols;

    // 水平方向递归(从左到右 & 从右到左)
    for (int y = 0; y < rows; y++) {
        // 从左到右
        for (int x = 1; x < cols; x++) {
            float curr = disp_map.at<float>(y, x);
            float prev = result.at<float>(y, x-1);

            if (curr > 0 && prev > 0 && fabs(curr - prev) < delta) {
                result.at<float>(y, x) = alpha * curr + (1-alpha) * prev;
            }
        }

        // 从右到左
        for (int x = cols-2; x >= 0; x--) {
            float curr = result.at<float>(y, x);
            float prev = result.at<float>(y, x+1);

            if (curr > 0 && prev > 0 && fabs(curr - prev) < delta) {
                result.at<float>(y, x) = alpha * curr + (1-alpha) * prev;
            }
        }
    }

    // 垂直方向递归(从上到下 & 从下到上)
    for (int x = 0; x < cols; x++) {
        // 从上到下
        for (int y = 1; y < rows; y++) {
            float curr = result.at<float>(y, x);
            float prev = result.at<float>(y-1, x);

            if (curr > 0 && prev > 0 && fabs(curr - prev) < delta) {
                result.at<float>(y, x) = alpha * curr + (1-alpha) * prev;
            }
        }

        // 从下到上
        for (int y = rows-2; y >= 0; y--) {
            float curr = result.at<float>(y, x);
            float prev = result.at<float>(y+1, x);

            if (curr > 0 && prev > 0 && fabs(curr - prev) < delta) {
                result.at<float>(y, x) = alpha * curr + (1-alpha) * prev;
            }
        }
    }

    return result;
}
域变换滤波参数调优:
| 参数 | 推荐范围 | 说明 |
|---|---|---|
alpha | 0.3~0.8 | 越大越平滑。实时场景建议 0.4~0.6 |
delta | 5~15 | 边缘阈值,视差单位。散斑场景建议 8 |
多遍迭代:对同一张视差图运行 2~3 遍域变换滤波,可以在不增加窗口大小的情况下获得更好的平滑效果,同时保持边缘锐度。
// 多遍迭代示例
cv::Mat filtered = disparity.clone();
for (int i = 0; i < 3; i++) {
    filtered = domainTransformFilter(filtered, 0.5f, 8.0f);
}
5.6 WLS加权最小二乘滤波
WLS(Weighted Least Squares)滤波器在保持边缘的同时实现更好的平滑效果。
/**
 * WLS 滤波(使用OpenCV ximgproc实现)
 * 以RGB图为引导,对深度图进行保边平滑
 */
cv::Mat wlsFilterDepth(const cv::Mat& depthMap, const cv::Mat& guideImg,
                       double lambda = 1000.0, double sigma_color = 1.0) {
    cv::Mat guideGray;
    if (guideImg.channels() == 3) {
        cv::cvtColor(guideImg, guideGray, cv::COLOR_BGR2GRAY);
    } else {
        guideGray = guideImg;
    }
    guideGray.convertTo(guideGray, CV_8U);

    cv::Mat depth8U;
    cv::normalize(depthMap, depth8U, 0, 255, cv::NORM_MINMAX, CV_8U);

    cv::Ptr<cv::ximgproc::DTFilter> dtf =
        cv::ximgproc::createDTFilter(guideGray, sigma_color, cv::ximgproc::DTF_RF);

    cv::Mat filtered8U;
    dtf->filter(depth8U, filtered8U, cv::ximgproc::DTF_NC);

    cv::Mat result;
    filtered8U.convertTo(result, CV_32F, 1.0 / 255.0);
    // 恢复原始深度范围
    double minVal, maxVal;
    cv::minMaxLoc(depthMap, &minVal, &maxVal);
    result = result * (maxVal - minVal) + minVal;
    return result;
}
5.7 WLS左右一致性检查+滤波
这是 RealSense D4xx 系列常用的后处理方法。
/**
 * 左右一致性检查 + WLS滤波
 * 1. 分别计算左右视差图
 * 2. 检查左右视差一致性
 * 3. 对不一致区域进行滤波填充
 */
void leftRightConsistencyCheck(cv::Mat& dispLeft, const cv::Mat& dispRight,
                               float threshold = 1.0f) {
    int rows = dispLeft.rows, cols = dispLeft.cols;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            float dL = dispLeft.at<float>(y, x);
            if (dL <= 0) continue;

            // 用左视差找右图对应点
            int xRight = x - static_cast<int>(round(dL));
            if (xRight < 0 || xRight >= cols) {
                dispLeft.at<float>(y, x) = 0;  // 超出范围,标记无效
                continue;
            }

            float dR = dispRight.at<float>(y, xRight);
            if (dR <= 0 || fabs(dL - dR) > threshold) {
                dispLeft.at<float>(y, x) = 0;  // 左右不一致,标记无效
            }
        }
    }
}

/**
 * 完整的 WLS 左右一致性检查流程
 */
cv::Mat wlsFilterWithLRC(const cv::Mat& leftImg, const cv::Mat& rightImg,
                         const cv::Mat& dispLeft, const cv::Mat& dispRight,
                         double lambda = 8000, double sigma = 1.5) {
    // 1. 左右一致性检查
    cv::Mat dispFiltered = dispLeft.clone();
    leftRightConsistencyCheck(dispFiltered, dispRight, 1.0f);

    // 2. 创建WLS滤波器
    cv::Mat leftGray;
    cv::cvtColor(leftImg, leftGray, cv::COLOR_BGR2GRAY);

    cv::Ptr<cv::ximgproc::DisparityWLSFilter> wlsFilter =
        cv::ximgproc::createDisparityWLSFilterGeneric(false);
    wlsFilter->setLambda(lambda);
    wlsFilter->setSigmaColor(sigma);

    // 3. 滤波
    cv::Mat filteredDisp;
    wlsFilter->filter(dispFiltered, leftImg, filteredDisp);

    return filteredDisp;
}
6. 形态学与连通域滤波
6.1 形态学开闭运算去噪
/**
 * 形态学去噪:先开运算去除亮噪点,再闭运算填充暗噪点
 */
cv::Mat morphologicalDenoise(const cv::Mat& depthMap,
                             int openKernelSize = 3,
                             int closeKernelSize = 5) {
    cv::Mat binary;
    // 将有效深度设为255,空洞设为0
    cv::threshold(depthMap, binary, 0, 255, cv::THRESH_BINARY);
    binary.convertTo(binary, CV_8U);

    // 开运算:去除小的亮噪点(孤立有效点)
    cv::Mat kernelOpen = cv::getStructuringElement(
        cv::MORPH_ELLIPSE, cv::Size(openKernelSize, openKernelSize));
    cv::Mat opened;
    cv::morphologyEx(binary, opened, cv::MORPH_OPEN, kernelOpen);

    // 闭运算:填充小的暗噪点(小空洞)
    cv::Mat kernelClose = cv::getStructuringElement(
        cv::MORPH_ELLIPSE, cv::Size(closeKernelSize, closeKernelSize));
    cv::Mat closed;
    cv::morphologyEx(opened, closed, cv::MORPH_CLOSE, kernelClose);

    // 用处理后的mask过滤深度图
    cv::Mat result = depthMap.clone();
    for (int y = 0; y < result.rows; y++) {
        for (int x = 0; x < result.cols; x++) {
            if (closed.at<uchar>(y, x) == 0) {
                result.at<float>(y, x) = 0;
            }
        }
    }
    return result;
}
6.2 连通域面积去噪
/**
 * 连通域面积去噪:去除面积小于阈值的孤立区域
 * @param depthMap   输入深度图 (CV_32F)
 * @param minArea    最小连通域面积(像素数)
 */
cv::Mat connectedComponentFilter(const cv::Mat& depthMap, int minArea = 100) {
    cv::Mat binary;
    cv::threshold(depthMap, binary, 0, 255, cv::THRESH_BINARY);
    binary.convertTo(binary, CV_8U);

    // 连通域标记
    cv::Mat labels, stats, centroids;
    int numLabels = cv::connectedComponentsWithStats(
        binary, labels, stats, centroids, 8, CV_32S);

    // 找出面积过小的连通域
    std::vector<bool> keepLabel(numLabels, false);
    for (int i = 1; i < numLabels; i++) {  // 跳过背景(0)
        int area = stats.at<int>(i, cv::CC_STAT_AREA);
        if (area >= minArea) {
            keepLabel[i] = true;
        }
    }

    // 过滤深度图
    cv::Mat result = depthMap.clone();
    for (int y = 0; y < result.rows; y++) {
        for (int x = 0; x < result.cols; x++) {
            int label = labels.at<int>(y, x);
            if (label == 0 || !keepLabel[label]) {
                result.at<float>(y, x) = 0;
            }
        }
    }
    return result;
}
7. 边缘去噪
7.1 Sobel 边缘检测去噪
/**
 * Sobel边缘去噪:检测深度图边缘,将边缘附近噪点置零
 * @param depthMap   输入深度图
 * @param threshold  边缘梯度阈值
 * @param expandSize 边缘扩展像素数(边缘周围也去除)
 */
cv::Mat sobelEdgeDenoise(const cv::Mat& depthMap,
                         float threshold = 50.0f, int expandSize = 2) {
    // 计算梯度
    cv::Mat gradX, gradY;
    cv::Sobel(depthMap, gradX, CV_32F, 1, 0, 3);
    cv::Sobel(depthMap, gradY, CV_32F, 0, 1, 3);

    // 梯度幅值
    cv::Mat gradMag;
    cv::magnitude(gradX, gradY, gradMag);

    // 二值化:边缘区域
    cv::Mat edgeMask;
    cv::threshold(gradMag, edgeMask, threshold, 255, cv::THRESH_BINARY);
    edgeMask.convertTo(edgeMask, CV_8U);

    // 膨胀边缘区域
    if (expandSize > 0) {
        cv::Mat kernel = cv::getStructuringElement(
            cv::MORPH_ELLIPSE, cv::Size(expandSize * 2 + 1, expandSize * 2 + 1));
        cv::dilate(edgeMask, edgeMask, kernel);
    }

    // 去除边缘区域深度值
    cv::Mat result = depthMap.clone();
    for (int y = 0; y < result.rows; y++) {
        for (int x = 0; x < result.cols; x++) {
            if (edgeMask.at<uchar>(y, x) > 0) {
                result.at<float>(y, x) = 0;
            }
        }
    }
    return result;
}
7.2 Canny 边缘检测去噪
/**
 * Canny边缘去噪:使用Canny检测深度图边缘
 */
cv::Mat cannyEdgeDenoise(const cv::Mat& depthMap,
                         double lowThreshold = 50, double highThreshold = 150,
                         int expandSize = 2) {
    cv::Mat depth8U;
    cv::normalize(depthMap, depth8U, 0, 255, cv::NORM_MINMAX, CV_8U);

    cv::Mat edges;
    cv::Canny(depth8U, edges, lowThreshold, highThreshold);

    // 膨胀边缘
    if (expandSize > 0) {
        cv::Mat kernel = cv::getStructuringElement(
            cv::MORPH_ELLIPSE, cv::Size(expandSize * 2 + 1, expandSize * 2 + 1));
        cv::dilate(edges, edges, kernel);
    }

    cv::Mat result = depthMap.clone();
    for (int y = 0; y < result.rows; y++) {
        for (int x = 0; x < result.cols; x++) {
            if (edges.at<uchar>(y, x) > 0) {
                result.at<float>(y, x) = 0;
            }
        }
    }
    return result;
}
8. 深度图空洞填充
8.1 左邻域填充(针对双目遮挡)
由于双目视觉的遮挡特性,物体左侧边缘通常会产生"阴影"空洞(左相机看到的区域右相机看不到)。利用左侧背景像素填充右侧前景边缘的空洞是最物理的填充方式。
/**
 * 左邻域填充:专门针对双目遮挡产生的空洞
 * 原理:遮挡空洞通常出现在物体左侧边缘,用左侧最近的有效值填充
 * @param depth_map 输入深度图
 * @param radius    向左搜索的最大像素数
 */
cv::Mat leftNeighborHoleFilling(const cv::Mat& depth_map, int radius = 10) {
    cv::Mat result = depth_map.clone();
    int rows = depth_map.rows, cols = depth_map.cols;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            if (result.at<float>(y, x) > 0) continue;

            int start_x = std::max(0, x - radius);
            float fill_val = 0;

            for (int nx = x; nx >= start_x; nx--) {
                float val = depth_map.at<float>(y, nx);
                if (val > 0) {
                    fill_val = val;
                    break;
                }
            }

            if (fill_val > 0) result.at<float>(y, x) = fill_val;
        }
    }

    return result;
}
8.2 邻域扩散填洞
/**
 * 邻域扩散填洞:从空洞边缘向内逐步传播有效深度值
 * @param depthMap  输入深度图(含空洞)
 * @param maxIter   最大迭代次数
 */
cv::Mat holeFillingByDiffusion(const cv::Mat& depthMap, int maxIter = 50) {
    cv::Mat result = depthMap.clone();
    int rows = result.rows, cols = result.cols;

    for (int iter = 0; iter < maxIter; iter++) {
        bool changed = false;
        cv::Mat temp = result.clone();

        for (int y = 1; y < rows - 1; y++) {
            for (int x = 1; x < cols - 1; x++) {
                if (result.at<float>(y, x) > 0) continue;  // 已有值

                // 收集8邻域有效值
                float sum = 0;
                int count = 0;
                for (int dy = -1; dy <= 1; dy++) {
                    for (int dx = -1; dx <= 1; dx++) {
                        if (dy == 0 && dx == 0) continue;
                        float val = result.at<float>(y + dy, x + dx);
                        if (val > 0) {
                            sum += val;
                            count++;
                        }
                    }
                }

                if (count >= 3) {  // 至少3个有效邻居才填充
                    temp.at<float>(y, x) = sum / count;
                    changed = true;
                }
            }
        }

        result = temp;
        if (!changed) break;  // 无变化,提前终止
    }
    return result;
}
8.3 加权中值填洞
/**
 * 加权中值填洞:用邻域有效深度值的加权中值填充空洞
 */
cv::Mat holeFillingByWeightedMedian(const cv::Mat& depthMap, int windowSize = 7) {
    cv::Mat result = depthMap.clone();
    int rows = result.rows, cols = result.cols;
    int half = windowSize / 2;

    for (int y = 0; y < rows; y++) {
        for (int x = 0; x < cols; x++) {
            if (result.at<float>(y, x) > 0) continue;  // 已有值

            std::vector<std::pair<float, float>> weighted;  // (值, 权重)

            for (int dy = -half; dy <= half; dy++) {
                for (int dx = -half; dx <= half; dx++) {
                    int ny = y + dy, nx = x + dx;
                    if (ny < 0 || ny >= rows || nx < 0 || nx >= cols) continue;

                    float val = depthMap.at<float>(ny, nx);
                    if (val <= 0) continue;

                    // 权重与距离成反比
                    float dist = sqrtf(float(dx * dx + dy * dy));
                    float weight = 1.0f / (dist + 1.0f);
                    weighted.push_back({val, weight});
                }
            }

            if (weighted.empty()) continue;

            // 按深度值排序
            std::sort(weighted.begin(), weighted.end());

            // 找加权中值
            float totalWeight = 0;
            for (auto& p : weighted) totalWeight += p.second;

            float cumWeight = 0;
            for (auto& p : weighted) {
                cumWeight += p.second;
                if (cumWeight >= totalWeight / 2.0f) {
                    result.at<float>(y, x) = p.first;
                    break;
                }
            }
        }
    }
    return result;
}
8.4 形态学填洞
/**
 * 形态学填洞:用膨胀-腐蚀操作填充小空洞
 */
cv::Mat holeFillingByMorphology(const cv::Mat& depthMap,
                                int dilateSize = 5, int erodeSize = 3) {
    cv::Mat binary;
    cv::threshold(depthMap, binary, 0, 255, cv::THRESH_BINARY);
    binary.convertTo(binary, CV_8U);

    // 膨胀:将有效区域扩展到空洞
    cv::Mat kernel1 = cv::getStructuringElement(
        cv::MORPH_ELLIPSE, cv::Size(dilateSize, dilateSize));
    cv::Mat dilated;
    cv::dilate(binary, dilated, kernel1);

    // 腐蚀:恢复大致形状
    cv::Mat kernel2 = cv::getStructuringElement(
        cv::MORPH_ELLIPSE, cv::Size(erodeSize, erodeSize));
    cv::Mat eroded;
    cv::erode(dilated, eroded, kernel2);

    // 用膨胀后的mask指导填洞(用原图有效值扩散)
    cv::Mat result = depthMap.clone();

    // 先用形态学结果标记需要填充的区域
    cv::Mat fillMask;
    cv::bitwise_and(eroded, ~binary, fillMask);  // 膨胀后新增的区域

    // 对需要填充的区域,用邻域均值填充
    cv::Mat dilatedDepth;
    cv::dilate(depthMap, dilatedDepth, kernel1);

    for (int y = 0; y < result.rows; y++) {
        for (int x = 0; x < result.cols; x++) {
            if (fillMask.at<uchar>(y, x) > 0 && result.at<float>(y, x) <= 0) {
                result.at<float>(y, x) = dilatedDepth.at<float>(y, x);
            }
        }
    }
    return result;
}
9. 时域滤波
9.1 指数移动平均(EMA)
/**
 * 指数移动平均时域滤波
 * 需要维护前一帧的滤波结果
 */
class TemporalEMAFilter {
public:
    TemporalEMAFilter(float alpha = 0.3f) : alpha_(alpha), initialized_(false) {}

    cv::Mat filter(const cv::Mat& currentDepth) {
        if (!initialized_) {
            prevFiltered_ = currentDepth.clone();
            initialized_ = true;
            return currentDepth.clone();
        }

        cv::Mat result = prevFiltered_.clone();

        for (int y = 0; y < currentDepth.rows; y++) {
            for (int x = 0; x < currentDepth.cols; x++) {
                float curr = currentDepth.at<float>(y, x);
                float prev = prevFiltered_.at<float>(y, x);

                if (curr > 0 && prev > 0) {
                    result.at<float>(y, x) = alpha_ * curr + (1.0f - alpha_) * prev;
                } else if (curr > 0) {
                    // 当前帧空洞,保持前帧值(衰减)
                    result.at<float>(y, x) = curr;
                } else if (prev > 0) {
                    // 前帧空洞,直接用当前值
                    result.at<float>(y, x) = prev * 0.9f;  // 缓慢衰减
                }
            }
        }

        prevFiltered_ = result.clone();
        return result;
    }

    void reset() { initialized_ = false; prevFiltered_.release(); }

private:
    float alpha_;
    cv::Mat prevFiltered_;
    bool initialized_;
};
9.2 自适应时域滤波
/**
 * 自适应时域滤波:根据场景运动程度自动调整alpha
 * 运动剧烈时alpha增大(减少前帧影响),静止时alpha减小
 */
class AdaptiveTemporalFilter {
public:
    AdaptiveTemporalFilter(float alphaMin = 0.1f, float alphaMax = 0.8f,
                           float motionThreshold = 0.05f)
        : alphaMin_(alphaMin), alphaMax_(alphaMax),
          motionThreshold_(motionThreshold), initialized_(false) {}

    cv::Mat filter(const cv::Mat& currentDepth) {
        if (!initialized_) {
            prevDepth_ = currentDepth.clone();
            prevFiltered_ = currentDepth.clone();
            initialized_ = true;
            return currentDepth.clone();
        }

        cv::Mat result = prevFiltered_.clone();

        // 计算运动程度(相邻帧深度差异的统计量)
        float motionLevel = computeMotionLevel(currentDepth, prevDepth_);

        // 根据运动程度自适应调整alpha
        float alpha = alphaMin_ + (alphaMax_ - alphaMin_) *
                      std::min(1.0f, motionLevel / motionThreshold_);

        for (int y = 0; y < currentDepth.rows; y++) {
            for (int x = 0; x < currentDepth.cols; x++) {
                float curr = currentDepth.at<float>(y, x);
                float prev = prevFiltered_.at<float>(y, x);

                if (curr > 0 && prev > 0) {
                    // 逐像素自适应:边缘处alpha增大
                    float localAlpha = computeLocalAlpha(currentDepth, x, y, alpha);
                    result.at<float>(y, x) = localAlpha * curr + (1.0f - localAlpha) * prev;
                } else if (curr > 0) {
                    result.at<float>(y, x) = curr;
                }
            }
        }

        prevDepth_ = currentDepth.clone();
        prevFiltered_ = result.clone();
        return result;
    }

private:
    float alphaMin_, alphaMax_, motionThreshold_;
    cv::Mat prevDepth_, prevFiltered_;
    bool initialized_;

    float computeMotionLevel(const cv::Mat& curr, const cv::Mat& prev) {
        float sumDiff = 0;
        int count = 0;
        for (int y = 0; y < curr.rows; y += 4) {  // 采样计算
            for (int x = 0; x < curr.cols; x += 4) {
                float c = curr.at<float>(y, x);
                float p = prev.at<float>(y, x);
                if (c > 0 && p > 0) {
                    sumDiff += fabs(c - p);
                    count++;
                }
            }
        }
        return (count > 0) ? (sumDiff / count) : 0;
    }

    float computeLocalAlpha(const cv::Mat& depth, int x, int y, float baseAlpha) {
        // 在边缘处增大alpha,保留边缘
        float center = depth.at<float>(y, x);
        if (center <= 0) return baseAlpha;

        float maxGrad = 0;
        for (int dy = -1; dy <= 1; dy++) {
            for (int dx = -1; dx <= 1; dx++) {
                int ny = y + dy, nx = x + dx;
                if (ny >= 0 && ny < depth.rows && nx >= 0 && nx < depth.cols) {
                    float neighbor = depth.at<float>(ny, nx);
                    if (neighbor > 0) {
                        maxGrad = std::max(maxGrad, fabs(center - neighbor));
                    }
                }
            }
        }

        // 梯度越大,alpha越大(更信任当前帧)
        float gradFactor = std::min(1.0f, maxGrad / 0.1f);
        return baseAlpha + (alphaMax_ - baseAlpha) * gradFactor * 0.5f;
    }
};
10.完整处理流水线
10.1 推荐流水线(视差域滤波版)
结合Intel官方建议与工业界应用经验,推荐以下最优处理顺序。特别注意:务必先将深度图转为视差图进行滤波,后再转回深度图,以保持噪声水平恒定。
/**
 * 散斑双目深度图完整滤波流水线(推荐)
 * @param depth_raw 原始深度图(单位:米,CV_32F)
 * @param rgb_guide RGB引导图(CV_8UC3,可选)
 * @param fx 焦距(像素)
 * @param baseline 基线(米)
 */
cv::Mat speckleDepthFilterPipeline(const cv::Mat& depth_raw,
                                    const cv::Mat& rgb_guide,
                                    double fx,
                                    double baseline) {
    // Step 0: 深度 -> 视差(视差 = fx * baseline / depth)
    cv::Mat disparity;
    cv::divide(fx * baseline, depth_raw, disparity);

    // Step 1: 智能降采样(可选,提升速度)
    // cv::Mat small_disp = smartSubsample(disparity, 2);

    // Step 2: 连通域去噪(剔除小飞点)
    disparity = connectedComponentFilter(disparity, 50);

    // Step 3: 域变换边缘保持滤波(视差域,核心步骤)
    disparity = domainTransformFilter(disparity, 0.6f, 8.0f);

    // Step 4: 联合滤波(如有高质量RGB且边缘不对齐严重)
    if (!rgb_guide.empty()) {
        disparity = guidedFilterDepth(disparity, rgb_guide, 8, 0.01);
    }

    // Step 5: 左邻域填充(专门针对遮挡空洞)
    disparity = leftNeighborHoleFilling(disparity, 10);

    // Step 6: 加权中值填洞(填充残余小空洞)
    disparity = holeFillingByWeightedMedian(disparity, 5);

    // Step 7: 视差 -> 深度
    cv::Mat final_depth;
    cv::divide(fx * baseline, disparity, final_depth);

    return final_depth;
}
10.2 简化流水线(深度域滤波版)
当无法获取相机内参时,可在深度域直接滤波:
/**
 * 散斑双目深度图滤波流水线(简化版,深度域)
 */
cv::Mat speckleDepthFilterPipelineSimple(const cv::Mat& depthMap,
                                          const cv::Mat& rgbGuide = cv::Mat()) {
    cv::Mat result = depthMap.clone();

    // Step 1: 连通域面积去噪(去除小面积孤立区域)
    result = connectedComponentFilter(result, 100);

    // Step 2: 中值滤波(去除椒盐噪声)
    result = fastMedianFilter(result, 5);

    // Step 3: Sobel边缘去噪
    result = sobelEdgeDenoise(result, 50.0f, 2);

    // Step 4: 保边平滑滤波
    if (!rgbGuide.empty()) {
        // 有RGB引导图:使用引导滤波
        result = guidedFilterDepth(result, rgbGuide, 8, 1e-4);
    } else {
        // 无RGB引导:使用双边滤波
        result = depthBilateralFilter(result, 15.0, 0.1, 9);
    }

    // Step 5: 空洞填充
    result = holeFillingByWeightedMedian(result, 7);

    // Step 6: 形态学平滑(可选)
    result = morphologicalDenoise(result, 3, 5);

    return result;
}
11.算法对比总结
| 算法 | 保边性 | 速度 | 适用场景 | 是否需要RGB | 推荐度 |
|---|---|---|---|---|---|
| 中值滤波 | ★★★ | ★★★★★ | 椒盐噪声 | 否 | ⭐⭐⭐⭐ |
| 双边滤波 | ★★★ | ★★★ | 通用去噪 | 否 | ⭐⭐⭐ |
| 联合双边滤波 | ★★★★ | ★★ | 边缘对齐 | 是 | ⭐⭐⭐⭐ |
| 引导滤波 | ★★★★ | ★★★★ | 边缘对齐(推荐) | 是 | ⭐⭐⭐⭐⭐ |
| 域变换滤波 | ★★★★★ | ★★★★ | 实时保边平滑(推荐) | 否 | ⭐⭐⭐⭐⭐ |
| WLS 滤波 | ★★★★★ | ★★ | 高质量平滑 | 是 | ⭐⭐⭐⭐ |
| 形态学去噪 | ★★ | ★★★★★ | 孤立噪点 | 否 | ⭐⭐⭐ |
| 连通域去噪 | ★★★ | ★★★★ | 小区域噪声(飞点) | 否 | ⭐⭐⭐⭐⭐ |
| Sobel 边缘去噪 | ★★★ | ★★★★ | 边缘噪点 | 否 | ⭐⭐⭐ |
| 左邻域填充 | ★★★★ | ★★★★ | 遮挡空洞(双目特有) | 否 | ⭐⭐⭐⭐ |
| 时域 EMA | ★★★ | ★★★★★ | 帧间抖动 | 否 | ⭐⭐⭐⭐ |
| 自适应时域 | ★★★★ | ★★★ | 运动场景 | 否 | ⭐⭐⭐⭐ |
12.工程实践建议与常见陷阱
12.1 常见陷阱
| 陷阱 | 说明 | 解决方案 |
|---|---|---|
| 在深度域做保边滤波 | 深度噪声随距离二次方增长,固定参数无法兼顾远近 | 转换到视差域滤波后再转回深度 |
| 滤波顺序错误 | 先做平滑再做去噪,会把飞点扩散到周围 | 先做连通域去噪,再做平滑滤波 |
| 过度滤波 | 深度图变得过于平滑,丢失细节 | 控制滤波迭代次数和参数强度 |
| 忽略空洞填充 | 深度缺失区域影响后续应用(如点云、3D重建) | 在滤波流程末尾加入填洞步骤 |
| 时域滤波alpha过大 | 运动物体出现严重拖影 | 使用自适应时域滤波,根据运动程度动态调整 |
| 引导滤波eps过小 | 引导图噪声传播到深度图 | eps 建议 1e-4,噪声大时增大到 1e-2 |
12.2 参数调优工作流
- 从视差域开始:先确认相机内参(fx, fy, cx, cy)和基线,将深度转为视差
- 连通域去噪先行:
minArea=50~100,去除明显的飞点 - 域变换滤波调参:先用
alpha=0.5, delta=8,观察效果后微调 - 有 RGB 时加引导滤波:
radius=8, eps=1e-4 - 填洞:左邻域填充
radius=10+ 加权中值windowSize=5 - 时域滤波:EMA
alpha=0.3~0.5,或自适应时域滤波 - 最终转回深度域
12.3 性能优化建议
| 优化手段 | 效果 | 适用场景 |
|---|---|---|
| 智能降采样 | 处理速度提升 4× | 高分辨率深度图(1280×720) |
| 域变换滤波替代双边滤波 | 速度提升 10×+ | 实时场景 |
| 积分图加速连通域 | O(N) 复杂度 | 大面积深度图 |
| SIMD/NEON 优化 | 2~4× 加速 | 嵌入式平台 |
| GPU 加速(CUDA) | 10~100× 加速 | 高性能计算平台 |
13. 进阶:基于深度学习的深度补全与滤波
近年来,深度学习方法在深度图补全(Depth Completion)和去噪方面取得了显著进展,尤其是 2022~2026 年间涌现了大量高质量工作。本章按技术路线分类梳理近4年内的成熟方法,并提供开源代码链接。
13.1 技术路线总览
深度学习深度补全/滤波
├── 1. RGB 引导的稀疏→稠密补全(最成熟)
│   ├── 编码器-解码器架构
│   ├── CNN + Transformer混合架构
│   └── 传播网络(Propagation Network)
├── 2. 单目深度估计基础模型(Foundation Model)
│   ├── Depth Anything V1/V2
│   ├── MiDaS / DPT
│   ├── Apple Depth Pro
│   └── LingBot-Depth(蚂蚁灵波)
├── 3. 深度图超分辨率
│   └── 从低分辨率深度图生成高分辨率
└── 4. 深度图去噪/增强
    └── 针对已有稠密深度图的噪声去除
13.2 RGB引导的稀疏→稠密深度补全
这是最成熟、应用最广的技术路线,核心思想是利用RGB图像的语义和边缘信息,将稀疏深度(来自 LiDAR或结构光)补全为稠密深度图。
13.2.1 经典方法(2019~2021)
| 方法 | 会议 | 核心思想 | KITTI RMSE | 代码 |
|---|---|---|---|---|
| NLSPN | ECCV 2020 | 非局部空间传播网络,利用非局部相似性引导深度传播 | 79.12 | GitHub |
| ACMNet | CVPR 2020 | 自适应上下文调制,多尺度特征融合 | - | GitHub |
| PENet | ICRA 2021 | 精确高效图像引导深度补全,双阶段架构(ENet→PENet) | 82.01 | GitHub |
| GuideNet | TPAMI 2020 | 多尺度引导级联沙漏网络 | - | GitHub |
| DeepCompletion | CVPR 2019 | 编码器-解码器,稀疏深度+RGB 融合 | - | GitHub |
13.2.2 前沿方法(2022~2025)
| 方法 | 会议/期刊 | 核心创新 | 亮点 | 代码 |
|---|---|---|---|---|
| CompletionFormer | CVPR 2023 | CNN + Vision Transformer 混合架构 | 首次将 ViT 引入深度补全,KITTI 排行榜前列 | GitHub |
| DeCoTR | CVPR 2024 | 2D 和 3D 注意力增强深度补全 | 结合2D图像注意力和3D空间注意力,零样本泛化能力强 | 论文 |
| SDformer | arXiv 2024 | 高效端到端 Transformer 深度补全 | 轻量级 Transformer,适合实时部署 | 论文 |
| RigNet++ | arXiv 2023 | 语义辅助重复图像引导网络 | 利用语义分割辅助深度补全,跨场景泛化好 | 论文 |
| CostDCNet | ECCV 2022 | 基于代价体积的单 RGB-D 深度补全 | 将立体匹配的代价体积思想引入深度补全 | GitHub |
| MONDI | ECCV 2022 | 监控蒸馏正向一致性深度补全 | 知识蒸馏+自监督,KITTI/VOID 双榜单 SOTA | GitHub |
| SparseDC | arXiv 2023 | 稀疏非均匀输入深度补全 | 处理不规则稀疏输入,更贴近实际传感器特性 | 论文 |
| KBNet | ICCV 2021 | 校准反投影网络 | 无监督深度补全 SOTA,VOID 排行榜第一 | GitHub |
13.2.3 KITTI深度补全排行榜(2024 最新)
| 排名 | 方法 | MAE (mm) | RMSE (mm) | iMAE | iRMSE |
|---|---|---|---|---|---|
| 1 | CostDCNet | 25.84 | 76.28 | 12.19 | 32.13 |
| 2 | NLSPN | 26.74 | 79.12 | 12.70 | 33.88 |
| 3 | MONDI | 29.67 | 79.78 | 14.84 | 37.88 |
| 4 | PENet | 34.61 | 82.01 | 18.89 | 40.36 |
📊完整排行榜见:https://github.com/tmanh/state-of-depth-completion
13.3 单目深度估计基础模型(Foundation Model)
2023~2025 年,单目深度估计领域出现了多个基础模型(Foundation Model),它们在海量数据上预训练,具有强大的零样本泛化能力。这些模型可以直接用于散斑深度图的增强和补全。
13.3.1 Depth Anything V2(字节跳动,NeurIPS2024)
目前最流行的单目深度估计基础模型。
-
核心创新:
- 使用 6200 万张高质量图像训练(通过自动标注引擎生成)
- Teacher-Student 知识蒸馏框架
- DINOv2 ViT 作为 backbone,特征表达能力极强
- 支持多种模型尺寸:Small / Base / Large / Giant
-
性能:在 NYU、KITTI 等多个基准上达到 SOTA
-
速度:Large 模型在 GPU 上可达 30+ FPS
-
应用场景:可作为散斑深度图的先验引导,结合传统滤波方法使用
13.3.2 LingBot-Depth(蚂蚁灵波科技,2026)
专为消费级深度相机设计的深度补全大模型,针对散斑双目场景优化。
- 核心创新:
- 掩码深度建模(Masked Depth Modeling):随机遮挡部分深度输入,训练模型从 RGB 上下文中恢复,特别擅长处理玻璃、镜面等强反光表面的深度缺失
- 基于奥比中光 Gemini 相机原始数据训练,与散斑双目相机高度适配
- 结合 RGB 图像视觉上下文进行深度推理
- 性能:
- 室内场景相对误差比主流模型降低超 70%
- 稀疏场景下表现优异
- 开源数据集:LingBot-Depth-Dataset(300 万对高质量 RGB-D 样本,社区最大规模真实场景 RGB-D 数据集)
🔗 资源链接
- 官方公告:LingBot-Depth 官方公告
- 数据集开源:LingBot-Depth 数据集开源
- GitHub:蚂蚁灵波科技 GitHub 组织(注:具体仓库地址后续确认)
⚠️ 注意:LingBot-Depth 的 GitHub 仓库地址可能需要进一步确认。建议访问蚂蚁灵波科技的官方 GitHub 页面获取最新链接。
13.3.3 Apple Depth Pro(Apple,2024)
苹果发布的零样本度量单目深度估计基础模型。
- 核心创新:
- 零样本度量深度估计(无需相机内参即可输出绝对深度)
- 速度极快:<1 秒处理一张高分辨率图像
- 边缘锐度极高,适合精细物体分割
- 适用场景:可作为散斑深度图的参考深度,用于异常区域检测和补全引导
🔗 资源链接
13.3.4 MiDaS / DPT(Intel,2020~2023)
最早的单目深度估计基础模型之一,广泛用于学术研究。
- MiDaS v3.1(2023):支持 BEiT、SwinV2 等多种 backbone
- DPT(Dense Prediction Transformer):将 Vision Transformer 引入密集预测任务
- 特点:模型轻量,支持移动端部署
🔗 资源链接
- MiDaS(第三方):daitranskku/MiDaS
- DPT:intel-isl/DPT
- MiDaS(官方):isl-org/MiDaS
13.3.5 Marigold(ETH Zurich,2024)
基于 Stable Diffusion 的深度估计基础模型,利用扩散模型的先验知识。
- 核心创新:将预训练的 Stable Diffusion 微调为深度估计器
- 优势:在零样本场景下表现惊人,无需大规模训练数据
- 局限:推理速度较慢(需要多步去噪)
🔗 资源链接
- 论文:Marigold 论文
- 代码:Marigold 代码
13.4 深度图超分辨率与去噪
13.4.1结构光深度图超分辨率
Supersampling of Data from Structured-light Scanner with Deep Learning(arXiv 2023)
-
专门针对结构光扫描仪的深度超分辨率
-
使用深度学习将低分辨率深度图上采样到高分辨率
-
保持边缘锐度和细节
13.4.2 RGB 引导的深度图去噪
Joint Image Filtering with Deep Learning(多篇工作)
-
利用RGB图像的边缘和纹理信息引导深度图去噪
-
核心思想与传统联合双边滤波一致,但使用神经网络学习权重
-
代表方法:Fast Guided Filter (FGF)、Deep Joint Image Filtering
-
Deep Joint Image Filtering:https://github.com/Y Zheng/DeepJointFilter(请确认用户/仓库名是否正确)
13.5 传统方法vs深度学习方法
| 维度 | 传统滤波方法 | 深度学习方法 | 混合方案 |
|---|---|---|---|
| 实时性 | ✅ 优秀(<5ms) | ❌ 较慢(>30ms,需 GPU) | ⚡ 前端实时+后端增强 |
| 泛化性 | ✅ 不依赖训练数据 | ⚠️ 依赖训练域(基础模型除外) | ✅ 基础模型零样本泛化 |
| 精度 | ★★★ | ★★★★★ | ★★★★★ |
| 可解释性 | ✅ 高 | ❌ 低 | ⚠️ 中等 |
| 部署难度 | ✅ 低 | ❌ 需要 GPU、模型优化 | ⚠️ 需要前后端协调 |
| 适用场景 | 嵌入式、实时系统 | 离线处理、高精度需求 | 工业级全场景 |
13.6 混合方案(推荐)
实际工程中,推荐采用传统滤波 + 深度学习的混合方案:
┌─────────────────────────────────────────────────────────┐
│                    完整处理流水线                          │
├─────────────────────────────────────────────────────────┤
│                                                         │
│  原始深度图 ──→ [传统滤波前端] ──→ 实时输出               │
│       │          ├ 连通域去噪                             │
│       │          ├ 域变换滤波                             │
│       │          ├ 左邻域填洞                             │
│       │          └ 时域EMA                               │
│       │                                                │
│       └──→ [深度学习后端] ──→ 高质量输出                  │
│              ├ LingBot-Depth (散斑专用)                   │
│              ├ Depth Anything V2 (通用)                   │
│              └ 深度补全网络 (NLSPN/CompletionFormer)       │
│                                                         │
│  [置信度融合] ──→ 最终深度图                              │
│       ├ 深度学习输出置信度                                 │
│       ├ 传统滤波置信度                                    │
│       └ 自适应加权融合                                    │
│                                                         │
└─────────────────────────────────────────────────────────┘
具体实施建议:
- 实时前端:传统滤波流水线(域变换 + 连通域去噪 + 填洞),保证 <5ms 延迟
- 离线后端:使用 LingBot-Depth 或 Depth Anything V2 对关键帧进行精细补全
- 置信度融合:深度学习模型通常输出置信度图,可用于指导时域滤波权重
- 边缘对齐:使用Depth Anything V2 的边缘信息,通过引导滤波优化深度图边缘
13.7 快速上手指南
Step 1:安装 Depth Anything V2
# 克隆仓库
git clone https://github.com/DepthAnything/Depth-Anything-V2.git
cd Depth-Anything-V2

# 安装依赖
pip install torch torchvision opencv-python

# 下载模型权重(选择 Large 或 Giant 版本)
# 从 HuggingFace 下载:https://huggingface.co/depth-anything
Step 2:使用 Depth Anything V2 生成引导深度
import torch
import cv2
import numpy as np
from depth_anything_v2.dpt import DepthAnythingV2

# 加载模型
model = DepthAnythingV2(encoder='vitl', features=256, out_channels=[256, 512, 1024, 1024])
model.load_state_dict(torch.load('depth_anything_v2_vitl.pth'))
model.eval().cuda()

# 读取 RGB 图像
rgb = cv2.imread('input.jpg')

# 生成单目深度(归一化)
depth_pred = model.infer_image(rgb)  # 输出 HxW numpy array

# 归一化到 [0, 1]
depth_norm = (depth_pred - depth_pred.min()) / (depth_pred.max() - depth_pred.min())

# 作为引导图,与散斑深度图融合
# 可用于:引导滤波、置信度加权、空洞区域填充等
Step 3:与传统滤波流水线集成
def hybrid_depth_pipeline(depth_raw, rgb_image, fx, baseline):
    """混合深度处理流水线"""

    # ===== 传统前端(实时) =====
    # 深度 -> 视差
    disp = fx * baseline / (depth_raw + 1e-6)

    # 连通域去噪
    disp_filtered = connected_component_filter(disp, min_area=50)

    # 域变换滤波
    disp_filtered = domain_transform_filter(disp_filtered, alpha=0.6, delta=8.0)

    # 左邻域填洞
    disp_filtered = left_neighbor_filling(disp_filtered, radius=10)

    # 视差 -> 深度
    depth_frontend = fx * baseline / (disp_filtered + 1e-6)

    # ===== 深度学习后端(离线/异步) =====
    # 使用 Depth Anything V2 生成参考深度
    depth_ref = depth_anything_v2_infer(rgb_image)  # 归一化深度

    # 计算置信度:传统滤波结果与深度学习结果的一致性
    confidence = compute_consistency(depth_frontend, depth_ref)

    # 在空洞区域使用深度学习结果填充
    mask_holes = (depth_frontend <= 0)
    depth_frontend[mask_holes] = depth_ref[mask_holes] * depth_scale

    return depth_frontend
13.8 学习资源汇总
核心论文(按推荐优先级排序)
| 优先级 | 论文 | 会议/期刊 | 主题 | 链接 |
|---|---|---|---|---|
| ⭐⭐⭐⭐⭐ | Depth Anything V2 | NeurIPS 2024 | 单目深度基础模型 | arXiv |
| ⭐⭐⭐⭐⭐ | LingBot-Depth | 开源 2026 | 散斑深度补全(掩码深度建模) | 官方 |
| ⭐⭐⭐⭐⭐ | CompletionFormer | CVPR 2023 | CNN+Transformer 深度补全 | arXiv |
| ⭐⭐⭐⭐ | NLSPN | ECCV 2020 | 非局部空间传播 | arXiv |
| ⭐⭐⭐⭐ | PENet | ICRA 2021 | 精确高效图像引导补全 | arXiv |
| ⭐⭐⭐⭐ | MONDI | ECCV 2022 | 监控蒸馏正向一致性 | arXiv |
| ⭐⭐⭐⭐ | DeCoTR | CVPR 2024 | 2D+3D 注意力深度补全 | arXiv |
| ⭐⭐⭐ | SDformer | arXiv 2024 | 高效 Transformer 深度补全 | arXiv |
| ⭐⭐⭐ | Apple Depth Pro | 2024 | 零样本度量深度估计 | Apple |
| ⭐⭐⭐ | Marigold | 2024 | 扩散模型深度估计 | arXiv |
| ⭐⭐⭐ | RigNet++ | arXiv 2023 | 语义辅助深度补全 | arXiv |
| ⭐⭐⭐ | SparseDC | arXiv 2023 | 稀疏非均匀输入补全 | arXiv |
综述论文
| 论文 | 期刊 | 主题 | 链接 |
|---|---|---|---|
| “Deep Depth Completion from Extremely Sparse Data: A Survey” | TPAMI 2022 | 稀疏深度补全综述 | arXiv |
| “深度学习的 2D-3D 融合深度补全综述” | 计算机工程与应用 2023 | 2D-3D 融合补全综述 | CNKI |
| “Monocular Depth Estimation: A Thorough Review” | TPAMI 2024 | 单目深度估计全面综述 | CSDN |
开源代码仓库
| 仓库 | 描述 | 链接 |
|---|---|---|
| state-of-depth-completion | 深度补全排行榜 + 方法汇总 | GitHub |
| Depth Anything V2 | 最流行的单目深度基础模型 | GitHub |
| CompletionFormer | CVPR 2023 CNN+Transformer 深度补全 | GitHub |
| NLSPN | 非局部空间传播网络 | GitHub |
| PENet | 精确高效图像引导深度补全 | GitHub |
| KBNet | 无监督深度补全 SOTA | GitHub |
| MONDI | 监控蒸馏深度补全 | GitHub |
| CostDCNet | 代价体积深度补全 | GitHub |
| MiDaS | 单目深度估计基础模型 | GitHub |
| Apple Depth Pro | 苹果零样本深度估计 | GitHub |
| Marigold | 扩散模型深度估计 | GitHub |
| DeepCompletionRelease | 深度学习深度补全入门 | GitHub |
基准数据集
| 数据集 | 场景 | 类型 | 链接 |
|---|---|---|---|
| KITTI Depth Completion | 户外自动驾驶 | LiDAR 稀疏→稠密 | 官网 |
| VOID | 室内 VIO | 稀疏→稠密 | GitHub |
| NYU Depth V2 | 室内 | Kinect 深度 | 官网 |
| LingBot-Depth-Dataset | 室内真实场景 | 奥比中光 Gemini | 官方 |
| ScanNet | 室内 3D 重建 | RGB-D 序列 | 官网 |
14.参考资料
传统算法论文
- Scharstein & Szeliski, “A Taxonomy and Evaluation of Dense Two-Frame Stereo Correspondence Algorithms”, IJCV 2002
- Hosni et al., “Fast Cost-Volume Filtering for Visual Correspondence and Beyond”, TPAMI 2013
- He et al., “Guided Image Filtering”, ECCV 2010 / TPAMI 2013
- Gastal & Oliveira, “Domain Transform for Edge-Aware Image and Video Processing”, SIGGRAPH 2011
- Min et al., “Non-Local Spatial Propagation Network for Depth Completion”, ECCV 2020
深度学习深度补全论文(2022~2026)
- Yuan et al., “CompletionFormer: Depth Completion with Convolutions and Vision Transformers”, CVPR 2023
- “DeCoTR: Enhancing Depth Completion with 2D and 3D Attention”, CVPR 2024
- “SDformer: Efficient End-to-End Transformer for Depth Completion”, arXiv 2024
- “RigNet++: Semantic Assisted Repetitive Image Guided Network for Depth Completion”, arXiv 2023
- “CostDCNet: Cost Volume based Depth Completion for a Single RGB-D Image”, ECCV 2022
- Wong et al., “Monitored Distillation for Positive Congruent Depth Completion”, ECCV 2022
- “SparseDC: Depth Completion from Sparse and Non-uniform Inputs”, arXiv 2023
深度估计基础模型论文(2023~2026)
- Yang et al., “Depth Anything V2”, NeurIPS 2024 — arXiv
- 蚂蚁灵波科技, “LingBot-Depth: 基于掩码深度建模的空间感知模型”, 2026
- Bochkovskii et al., “Depth Pro: Sharp Monocular Metric Depth in Less Than a Second”, Apple 2024 — Apple Research
- Ranftl et al., “Vision Transformers for Dense Prediction” (DPT), ICLR 2021
- Ke et al., “Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation” (Marigold), CVPR 2024 — arXiv
综述论文
- “Deep Depth Completion from Extremely Sparse Data: A Survey”, TPAMI 2022 — arXiv
- “深度学习的 2D-3D 融合深度补全综述”, 计算机工程与应用 2023 — CNKI
官方文档与白皮书
- Intel RealSense D400 Series Depth Post-Processing White Paper
- OpenCV StereoSGBM 文档 — https://docs.opencv.org/4.x/d2/d85/classcv_1_1StereoSGBM.html
- OpenCV ximgproc 滤波器 — https://docs.opencv.org/4.x/da/d17/group__ximgproc__filters.html
- Intel RealSense SDK Post-Processing Filters — https://github.com/IntelRealSense/librealsense
开源实现
- OpenCV ximgproc (Guided Filter, WLS, Domain Transform) — https://github.com/opencv/opencv_contrib
- libSGM (GPU 加速 SGM) — https://github.com/fixstars/libSGM
- state-of-depth-completion (排行榜) — https://github.com/tmanh/state-of-depth-completion
- Depth Anything V2 — https://github.com/DepthAnything/Depth-Anything-V2
- CompletionFormer — https://github.com/chandlj/completionformer
- NLSPN — https://github.com/zzangjinsun/NLSPN_ECCV20
- PENet — https://github.com/JUGGHM/PENet_ICRA2021
- Apple Depth Pro — https://github.com/apple/ml-depth-pro
- Marigold — https://github.com/toshas/marigold
- MiDaS — https://github.com/isl-org/MiDaS
- LingBot-Depth-Dataset — https://news.qq.com/rain/a/20260331A02URQ00

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)