CVPR 2025丨仿生设计+强化学习结合,机器人听懂你的指令
关注gongzhonghao【CVPR顶会精选】
分享一个CVPR很香的研究方向:机器人。众所周知,机器人在真实场景中要实现稳健自主,既要有精确的环境感知,又要有高效的运动决策,这两者的协同一直是难点。再加上动态场景的不确定性、跨任务泛化的挑战、算力和延迟的限制……当下对“感知驱动的运动规划”研究热度持续攀升也就不奇怪了。
显然,这方向的创新大多围绕以下痛点展开,比如端到端感知-控制融合、轻量化视觉模型在运动中的落地、基于任务的规划策略优化、多模态传感器信息融合与自适应控制等。如果想在CVPR上发机器人相关论文,建议从这些切入点深挖。今天小图给大家精选3篇CVPR有关机器人方向的论文,请注意查收!
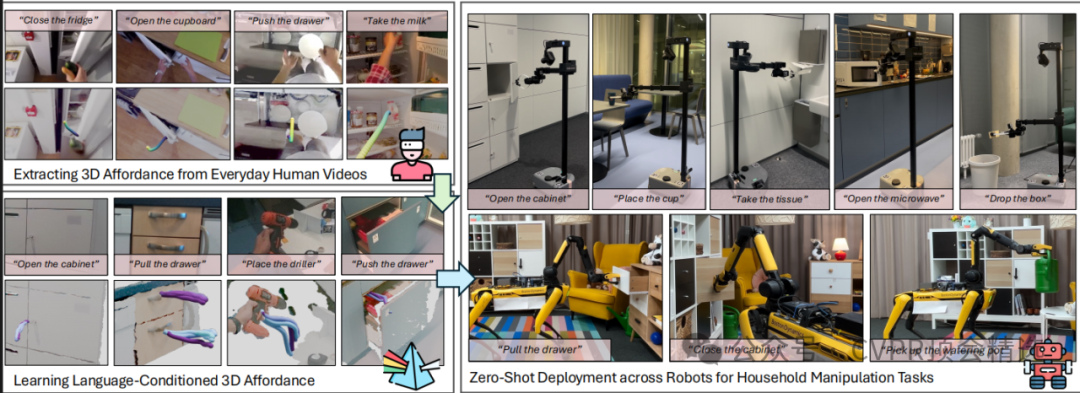
论文一:DVidBot: Learning Generalizable 3D Actions from In-the-Wild 2D Human Videos for Zero-Shot Robotic Manipulation
方法:
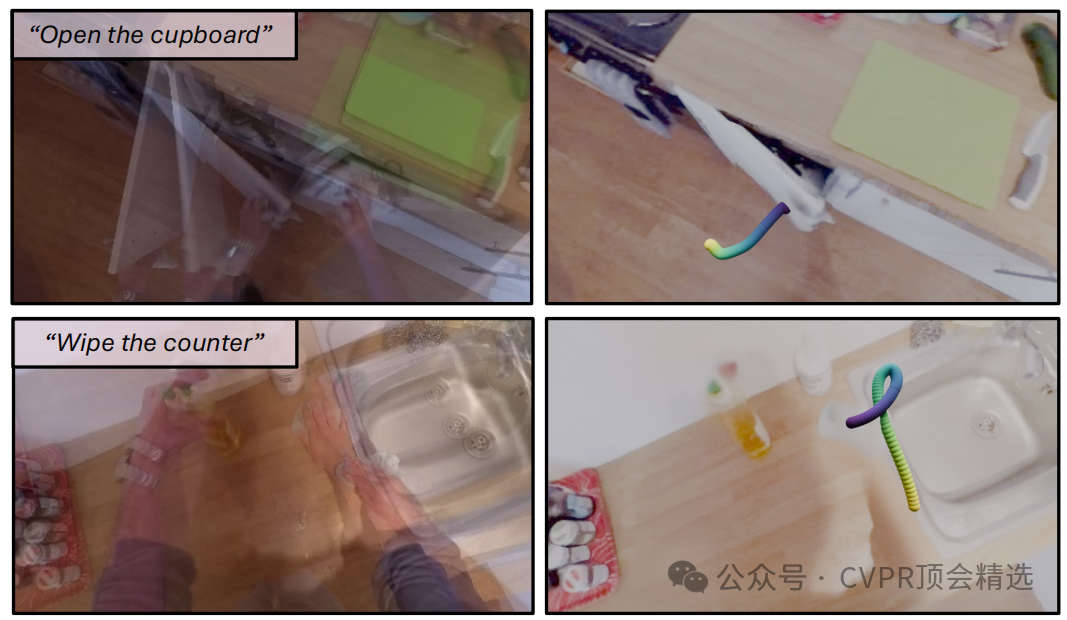
作者首先通过结合结构光重建与单目深度基础模型,从单目移动摄像机拍摄的日常人类视频中优化相机位姿并提取三维接触点与手部轨迹。随后在粗预测阶段利用RGB-D和指令推断接触点与目标点位置,在细预测阶段用条件扩散模型生成完整交互轨迹,并融合三维TSDF场景特征。最后在推理时通过多目标匹配、避碰与法向一致性等可微引导优化生成轨迹,使其适应不同机器人形体与新环境。
创新点:
-
首次从大规模单目RGB人类视频中提取时序一致、具备度量尺度的三维手部轨迹作为具身无关的可供性表示。
-
提出粗到细的可供性学习框架,结合像素级接触/目标点预测与条件扩散模型生成细粒度交互轨迹。
-
在推理阶段引入多目标、法向引导与避碰等可微成本函数,实现上下文感知的轨迹生成与零样本适配。
论文链接:
https://cvpr.thecvf.com/virtual/2025/poster/32561
图灵学术论文辅导
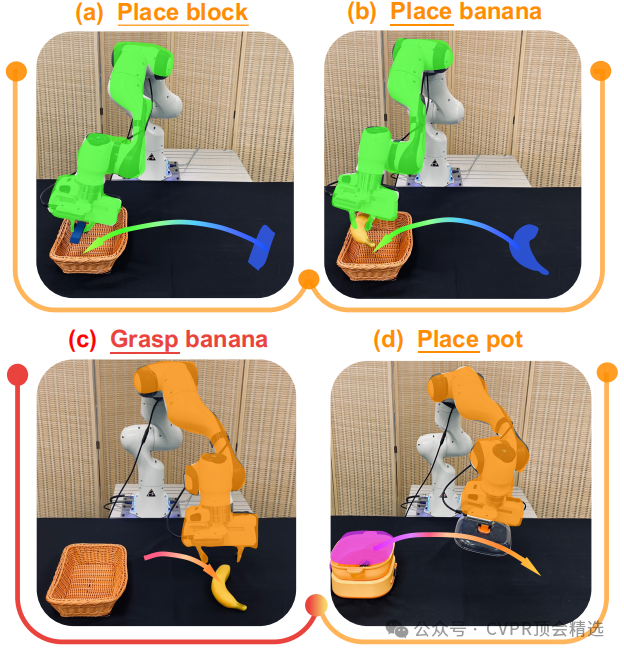
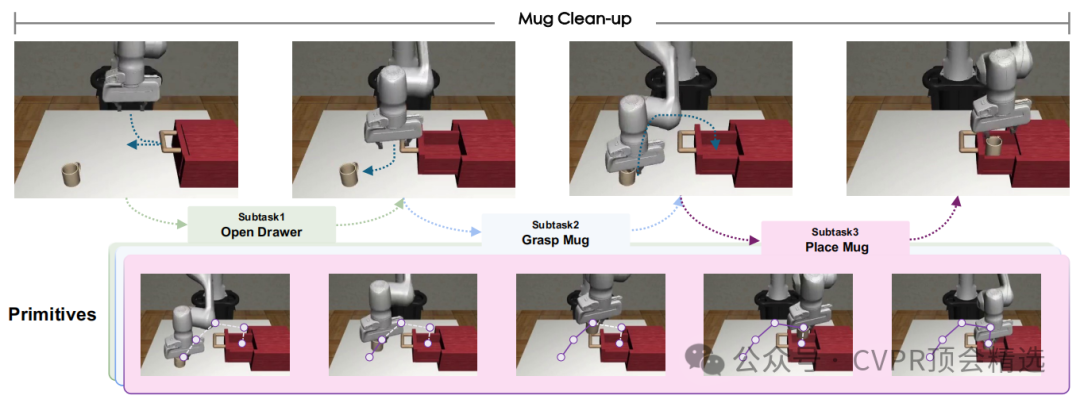
论文二:Think Small, Act Big: Primitive Prompt Learning for Lifelong Robot Manipulation
方法:
首先通过单目SfM与深度估计联合优化相机位姿,利用结构先验恢复视频中的三维场景与人手轨迹。然后在粗预测阶段使用指令与视觉特征定位目标点与接触点,并在细预测阶段借助条件扩散模型生成完整交互轨迹,同时融合三维场景TSDF特征以增强几何一致性。最后在执行阶段对生成轨迹施加可微优化,包括多目标选择、法向对齐与避碰约束,使其在不同机器人形体与新环境中保持稳定可行。
创新点:
-
利用结构化多视图优化与单目深度模型,从互联网人类视频中恢复具备度量尺度的时序一致三维接触轨迹。
-
设计粗到细的两阶段可供性预测框架,结合条件扩散生成实现细粒度交互轨迹合成。
-
引入可微成本优化,在推理阶段实现轨迹的多目标匹配、法向约束与避碰调整,提升跨环境适应性。
论文链接:
https://cvpr.thecvf.com/virtual/2025/poster/33193
图灵学术论文辅导
论文三:RoboTwin: Dual-Arm Robot Benchmark with Generative Digital Twins
方法:
该方法首先利用生成式基础模型,从一张二维图像创建出具备几何、法线和纹理的多种三维数字资产,并为这些资产添加关键点和功能轴的空间注释。随后,一个大型语言模型被用于将复杂的任务分解为子任务,并根据空间注释推断出精确的几何和方向约束。最后,系统基于这些约束生成可执行的机器人运动代码,并采用运动优化算法来生成满足碰撞避免要求的轨迹。
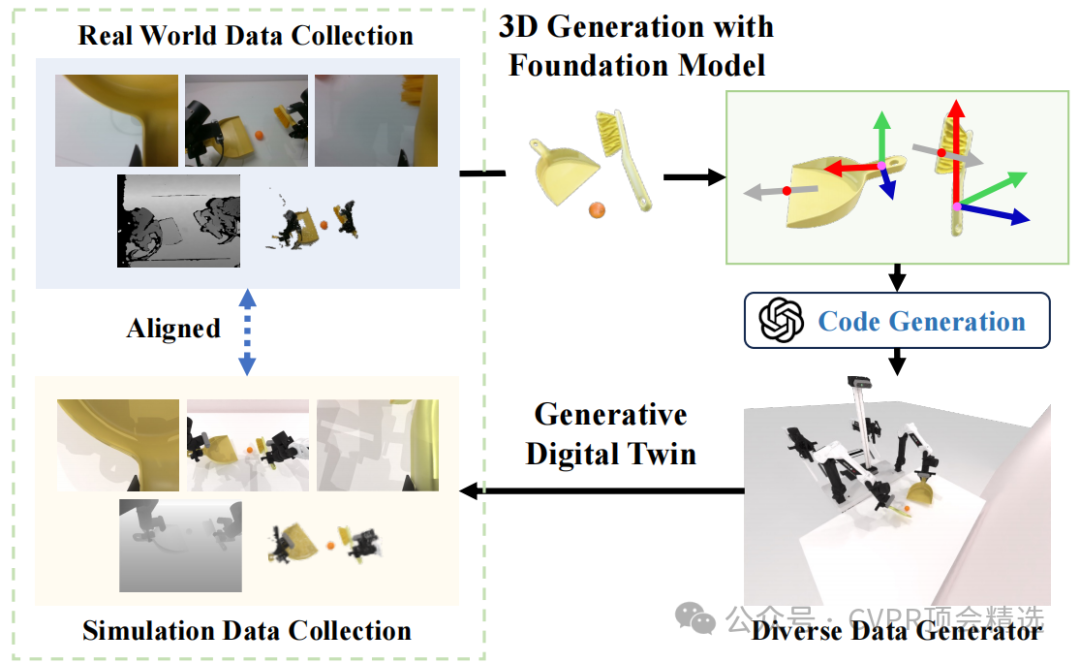
创新点:
-
本文提出了一个仅需一张二维图像即可生成多样化三维对象模型的便捷式“现实到仿真”数据管道。
-
设计了一个空间感知代码生成框架,结合三维对象的空间注释和大型语言模型自动生成专家级任务演示数据。
-
构建了一个包含现实世界和高保真合成数据在内的双臂操作标准基准,用于评估机器人策略。
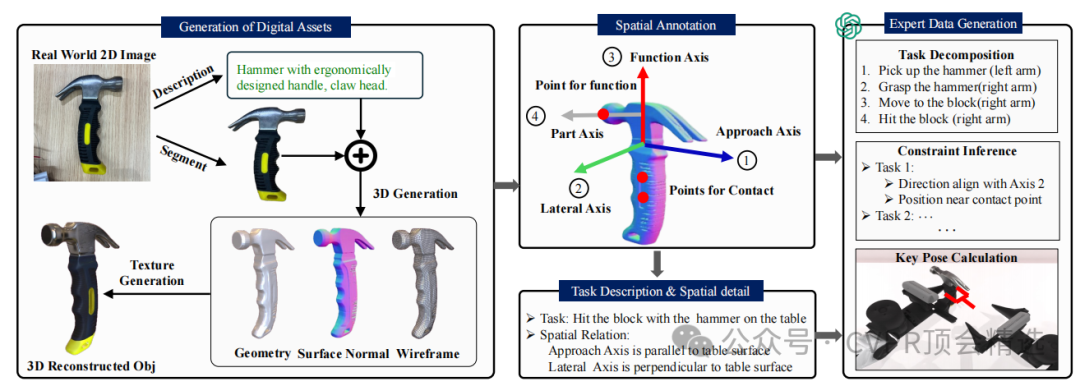
论文链接:
https://cvpr.thecvf.com/virtual/2025/poster/33419
本文选自gongzhonghao【CVPR顶会精选】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)