深度学习系列 | RNN循环神经网络
一、通俗总结
RNN 是 “用循环结构传递有限记忆、靠参数共享处理变长序列” 的模型 —— 核心目标是解决传统模型 “长距离依赖抓不住、长序列参数爆炸” 的问题,让模型能处理 “有顺序、长度不固定” 的数据(比如文本、语音、股票走势)
二、拆解知识步骤
1. 由来的背景
传统模型处理序列数据存在明显缺陷:
- CNN 的固定感受野无法捕捉长距离依赖(如 “虽然价格贵但质量好” 中 “贵” 与 “好” 的转折关系);
- 长序列展开为向量会导致输入维度爆炸(1000 时间步序列维度超 1 万),引发显存不足和训练困难。因此需要一种能动态处理时序依赖、共享参数的模型,RNN 应运而生。
2. 目标及解决的问题
- 目标:通过循环结构实现对序列数据的时序建模,让模型能利用历史信息分析当前输入;
- 解决的问题:
- 处理变长输入(如电商评论长度从几个词到数百词),无需固定输入维度;
- 捕捉序列中的时序依赖(如股票数据的历史趋势对当前波动的影响)。
3. 怎么实现的
- 拓扑结构:隐藏层
(相当于 RNN 的脑子)同时接收当前输入
和前一状态
,通过循环连接形成 “记忆磁带” 机制,持续传递历史信息(“记当前 + 更正好记忆”,但记忆有上限,不是无限装);
- 参数共享:按时间步展开后,T 步序列形成深度为 T 的前馈网络,权重
等在所有时间步共享,大幅减少参数量(如 100 步序列参数仅增加 0.01%)(避免参数爆炸);
- 时序记忆:隐藏状态
4. 局限性
- 梯度消失:tanh 激活函数导致梯度在反向传播时最多衰减至
,当序列长度
时梯度近乎消失,无法学习长期依赖(如长文档中前文与后文的关联);
- 记忆容量有限:隐藏状态无法存储过长序列的信息,长序列中早期关键信息会被后期信息覆盖(如分析 100 词以上文本时,开头的主题易被中间细节冲淡)。
三、案例图解数学公式
我们以NER任务为例,目标是识别输入句子里的人名。我们分别看两个输入:
“我的鞋是李宁的。”
“我叫李宁。”
一个好的NER模型应该能根据上下文识别出第一句里的“李宁”是品牌名,第二句的“李宁”是人名。
为了让RNN能够处理变长的输入,它被设计成循环调用的方式,每次只输入序列里的一个元素。对应到NLP任务里,每个元素就是一个token的embedding。
以第二个句子“我叫李宁”为例,目标是识别人名,所以对于每个token的输出是一个三分类(B-N:名字的开头,I-N:名字的后续,O:其他)。NER的输入Token序列长度和输出序列长度一样。
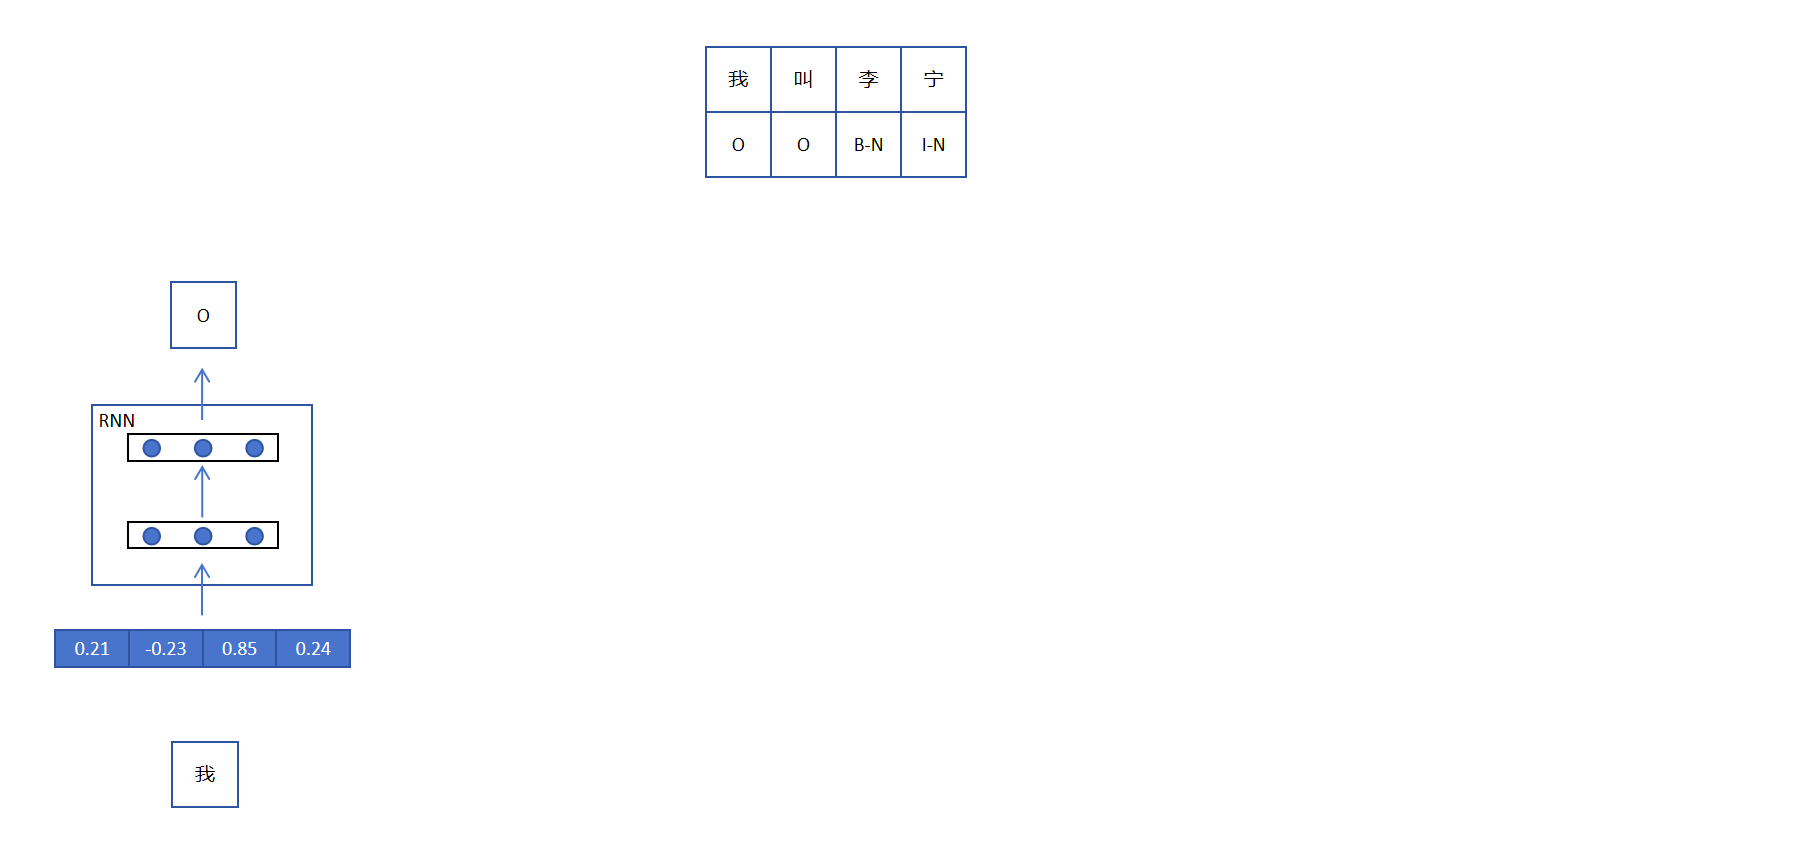
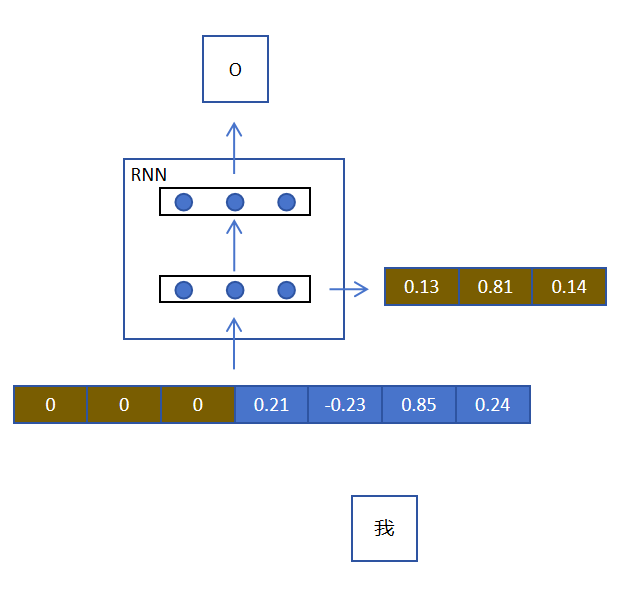
RNN对于第一个token,输入是它的embedding,经过两层,一个隐藏层(3个神经元)。一个是输出层,输出层有3个神经元,对应NER的三分类。这看起来和普通的神经网络没有区别。
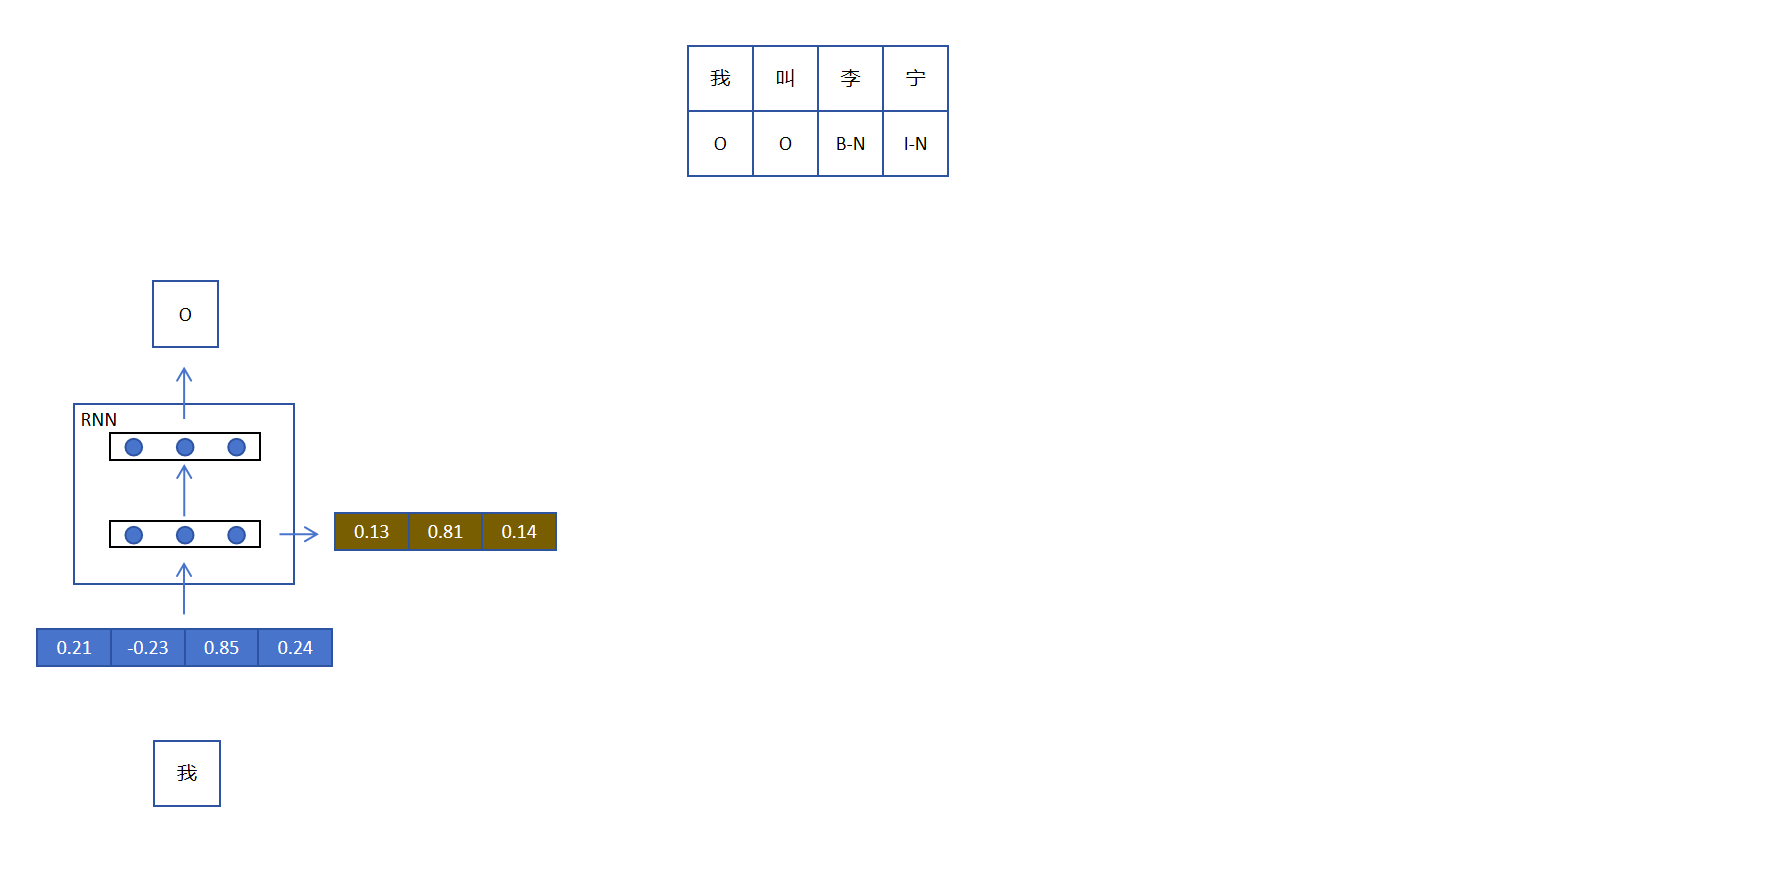
RNN需要能为序列保留记忆,这样后边的token才可能判断自己是人名还是公司名。怎么保存记忆呢?RNN把隐藏层的输出作为记忆保存,如下图:
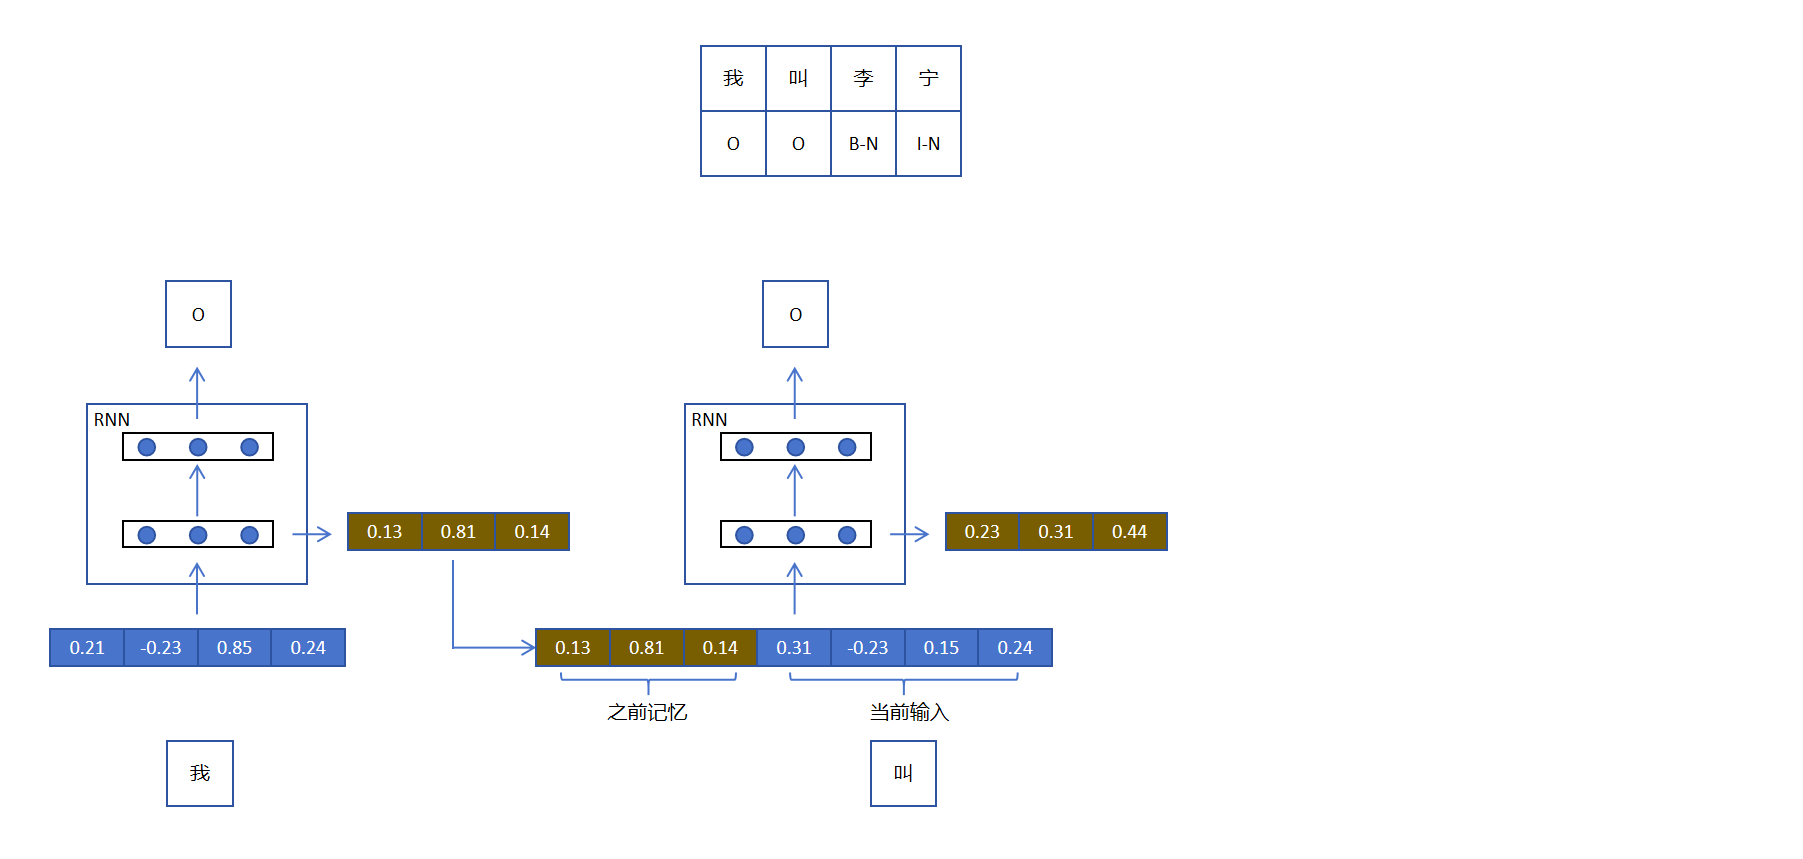
接下来我们看RNN如何处理第二个token,它将当前RNN的记忆与第二个token的embedding进行拼接作为输入,这样第二个token就有了上下文信息了。同时RNN在处理第二个token时会更新RNN网络的记忆,以便后用。特别需要注意的是:第一步和第二步RNN的参数是共享的,如下图所示:
第三步和第二步一样,拼接RNN的记忆和当前token的embedding,传入RNN,并用隐藏层的输出更新RNN的记忆。
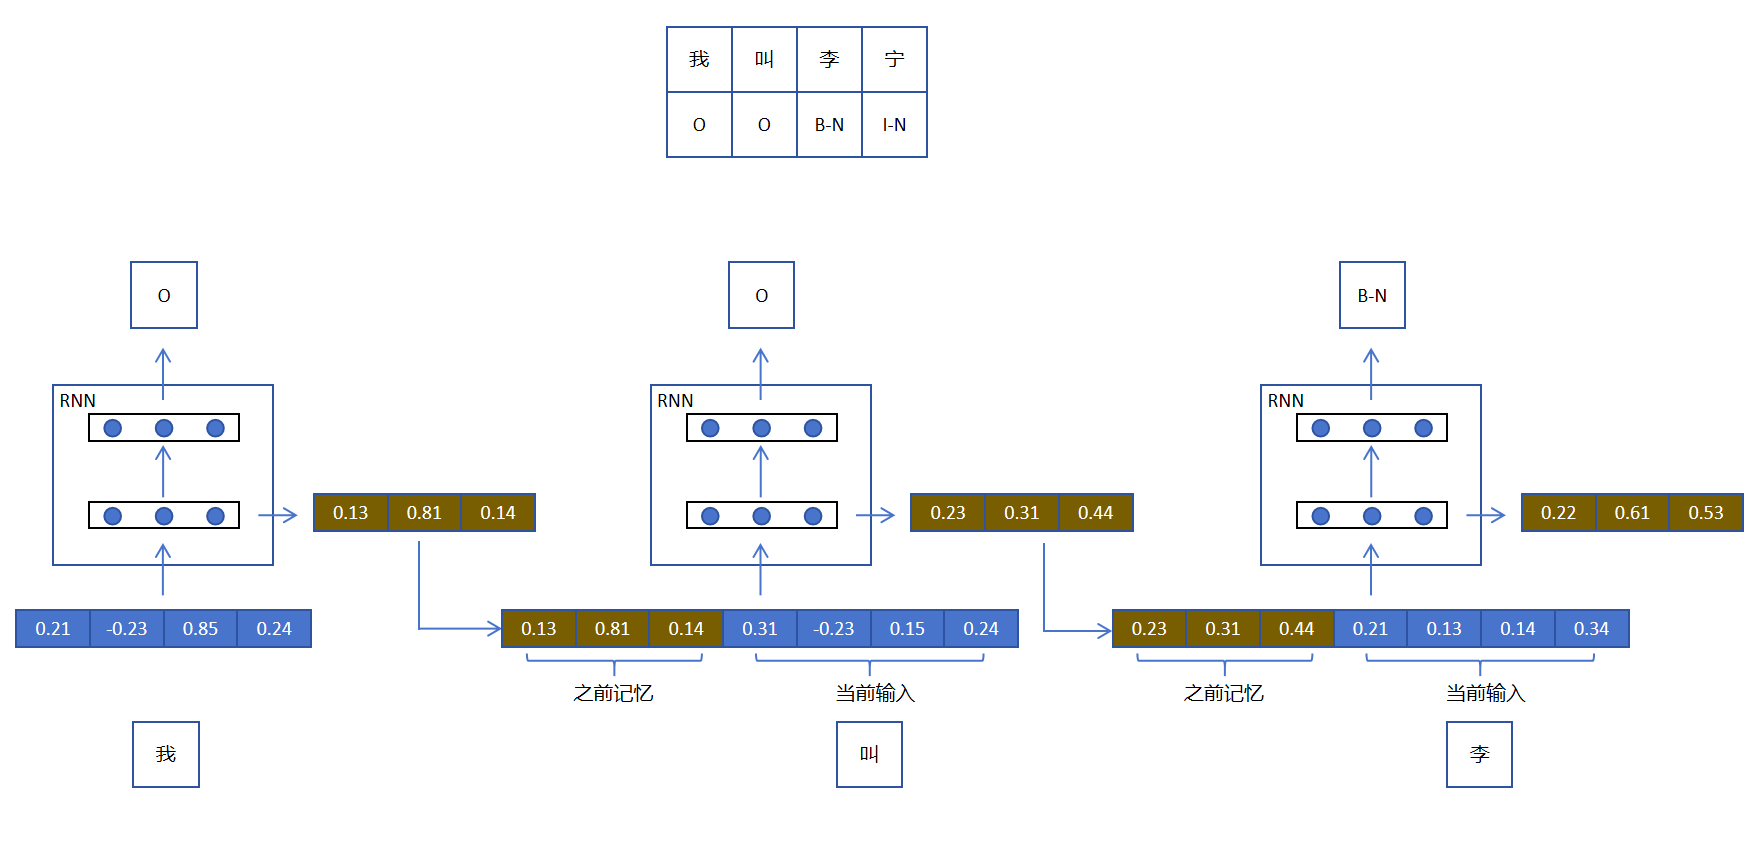
细心的你可能发现处理第一个token时,没有记忆怎么办?答案是即使是第一步,我们会用同维度的全零记忆向量表示当前RNN没有记忆。这样就保证了所有步网络结构和处理逻辑的统一。
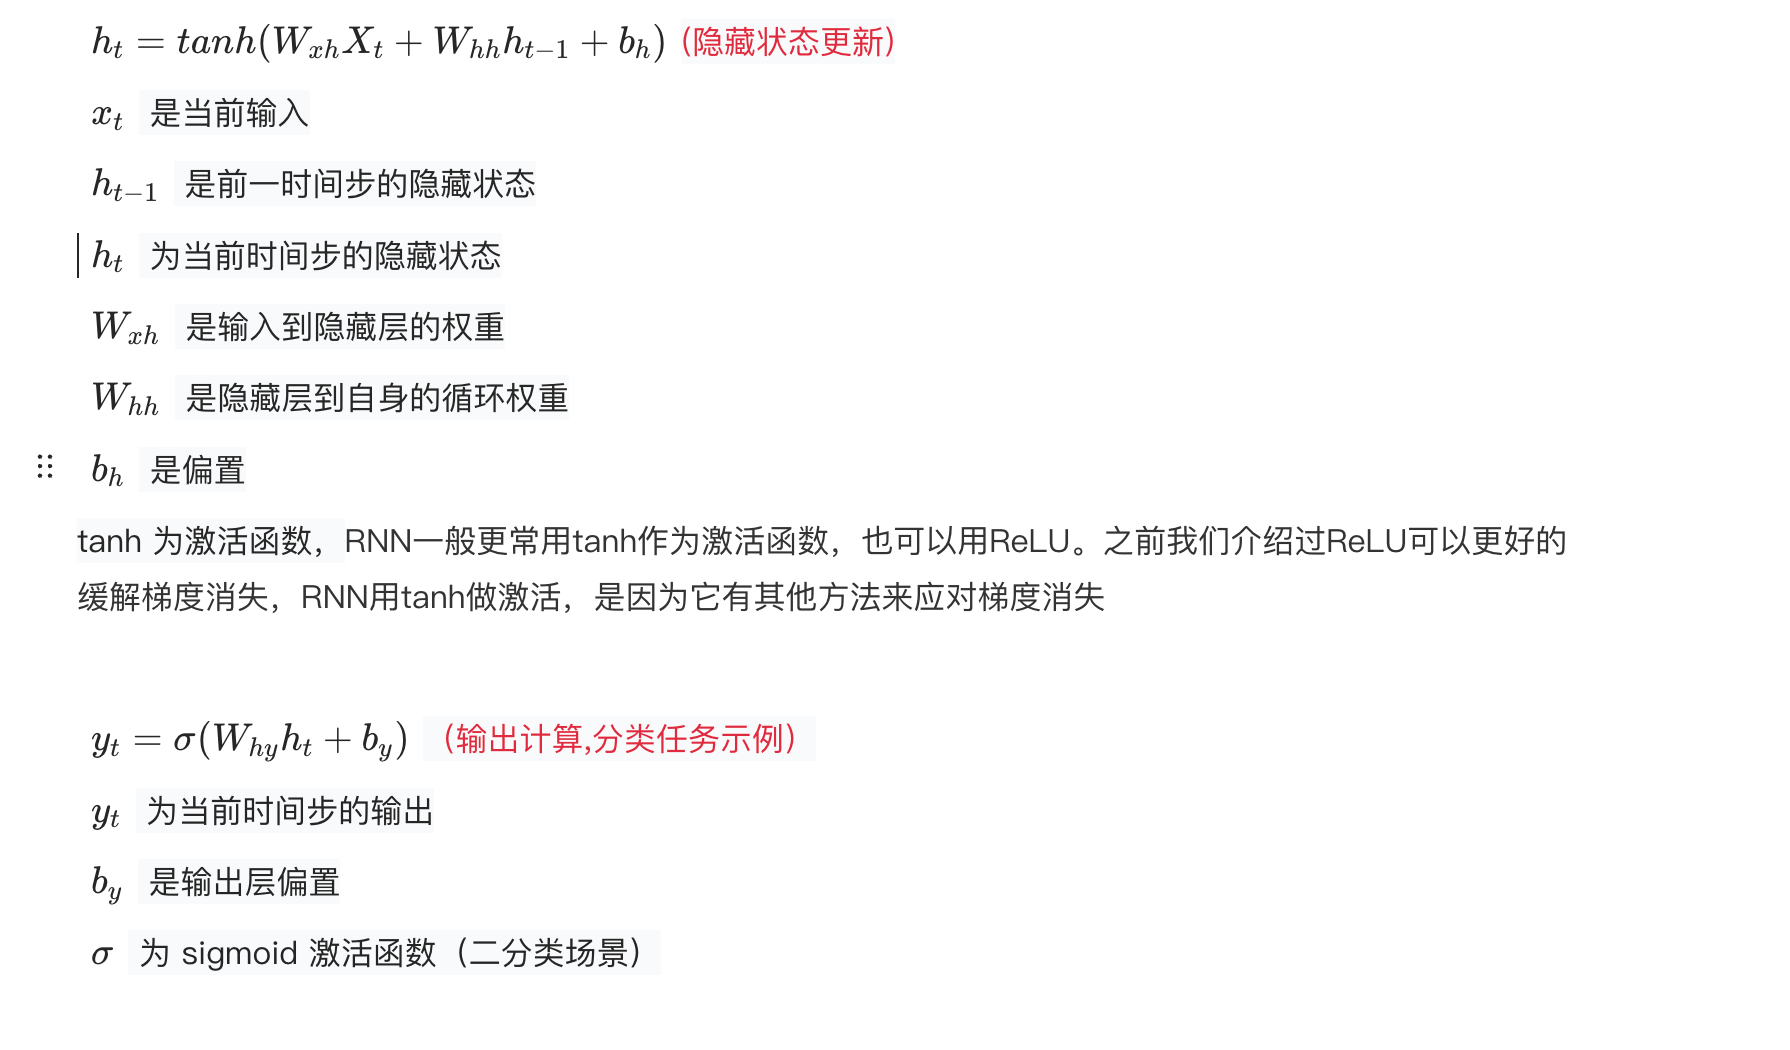
当前时刻的隐状态等于前一时刻的隐状态和当前时刻的序列输入进行拼接,然后经过隐藏层线性变化和激活函数后的输出, 下边我们用公式详细定义一下RNN的计算:
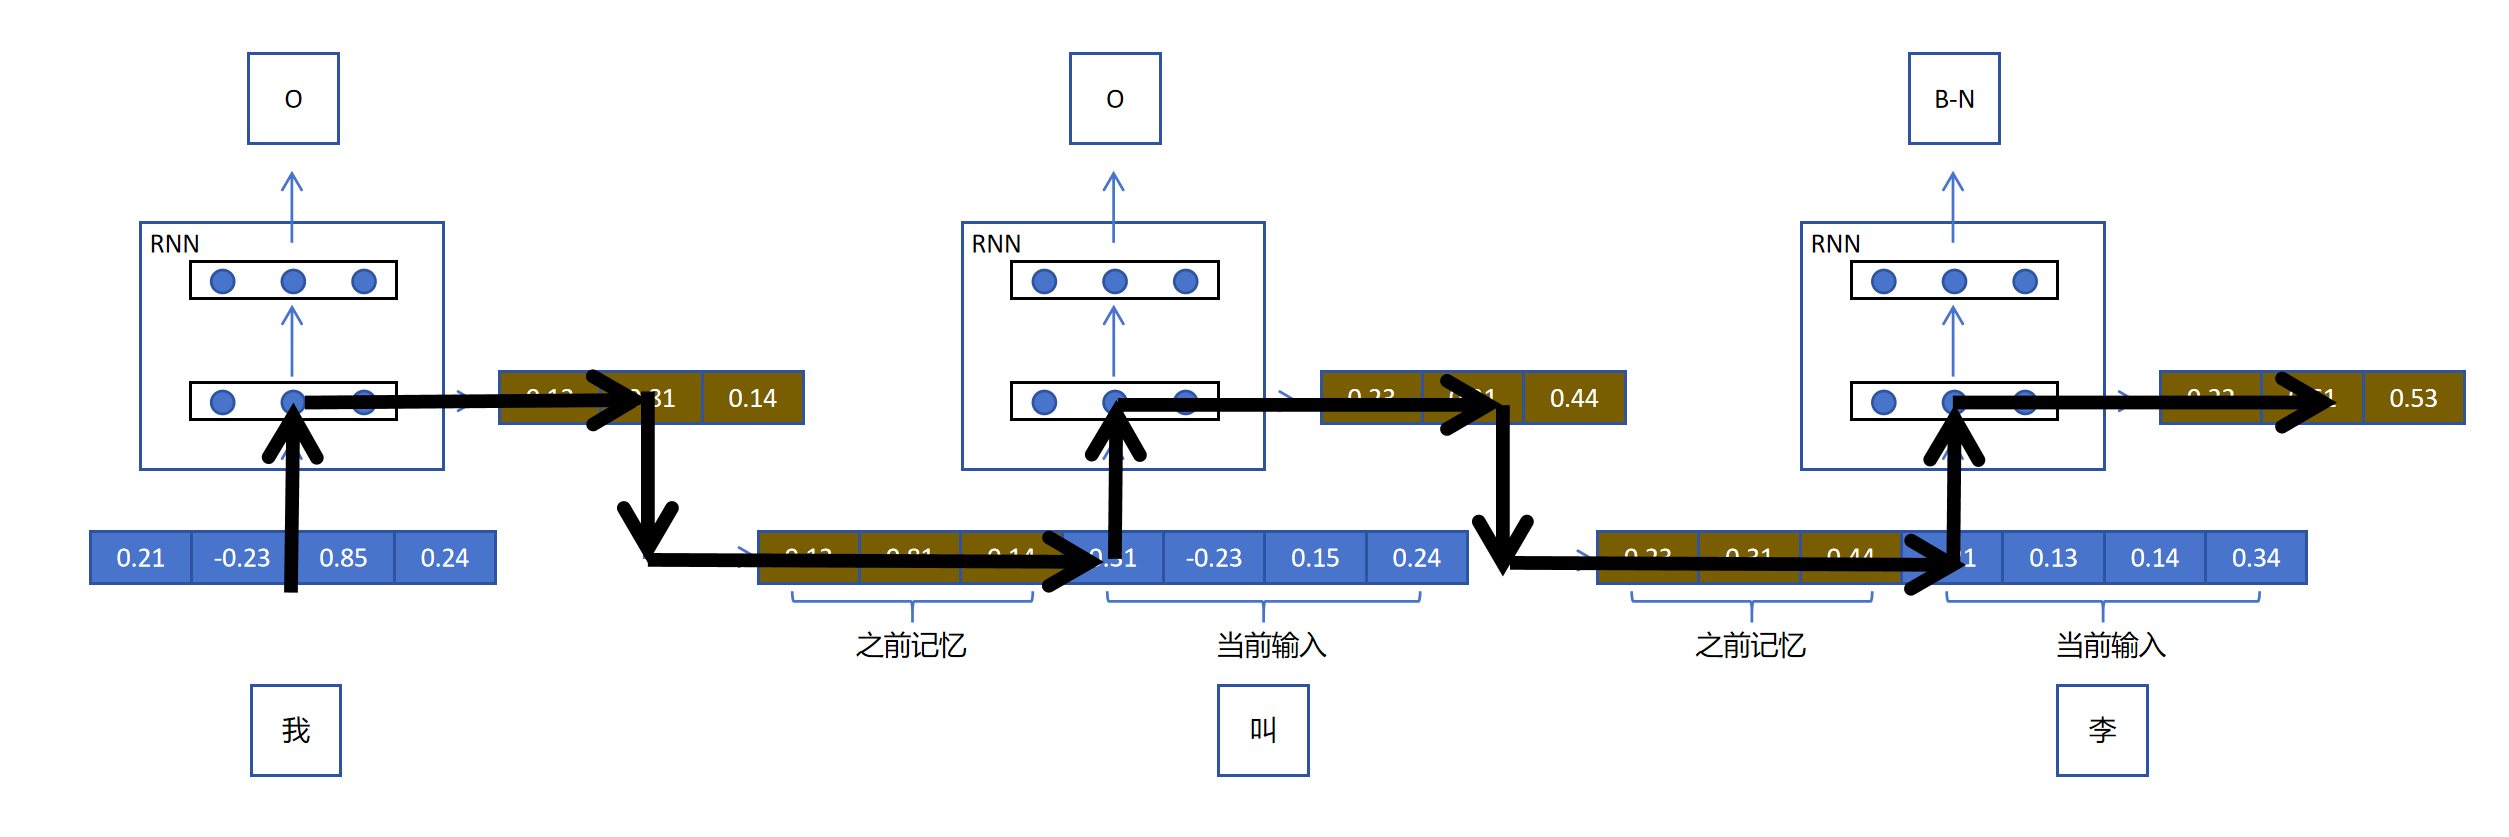
通过上图,我们观察RNN中的计算图,发现RNN中的循环实际上只发生在第一层,它是RNN的关键,是循环实际发生的地方,所以我们可以叫它循环层。每一个时间步对循环层的梯度更新会通过计算图递归调用到前边所有时间步的循环层。循环层的网络参数会被更新多次。
上图中的第二层是普通层,它不参与循环。每一个时间步对普通层的梯度更新,只会发生在当前步,普通层的网络参数只会被更新一次。这和普通神经网络没有区别。
所以说,循环层的递归调用才是RNN的本质。每一时间步通过对之前所有时间步的循环层的调用,输出关键的隐状态htht。对于普通层,可以看成是每一时间步利用htht向量作为输入,进行的额外的分类或者回归任务。普通层不是RNN的核心,它只是为了完成每一步的特定任务添加的任务层。
RNN重要的是循环层,以及循环层在每个时刻输出的隐状态,普通层利用隐状态完成每个时间步的任务
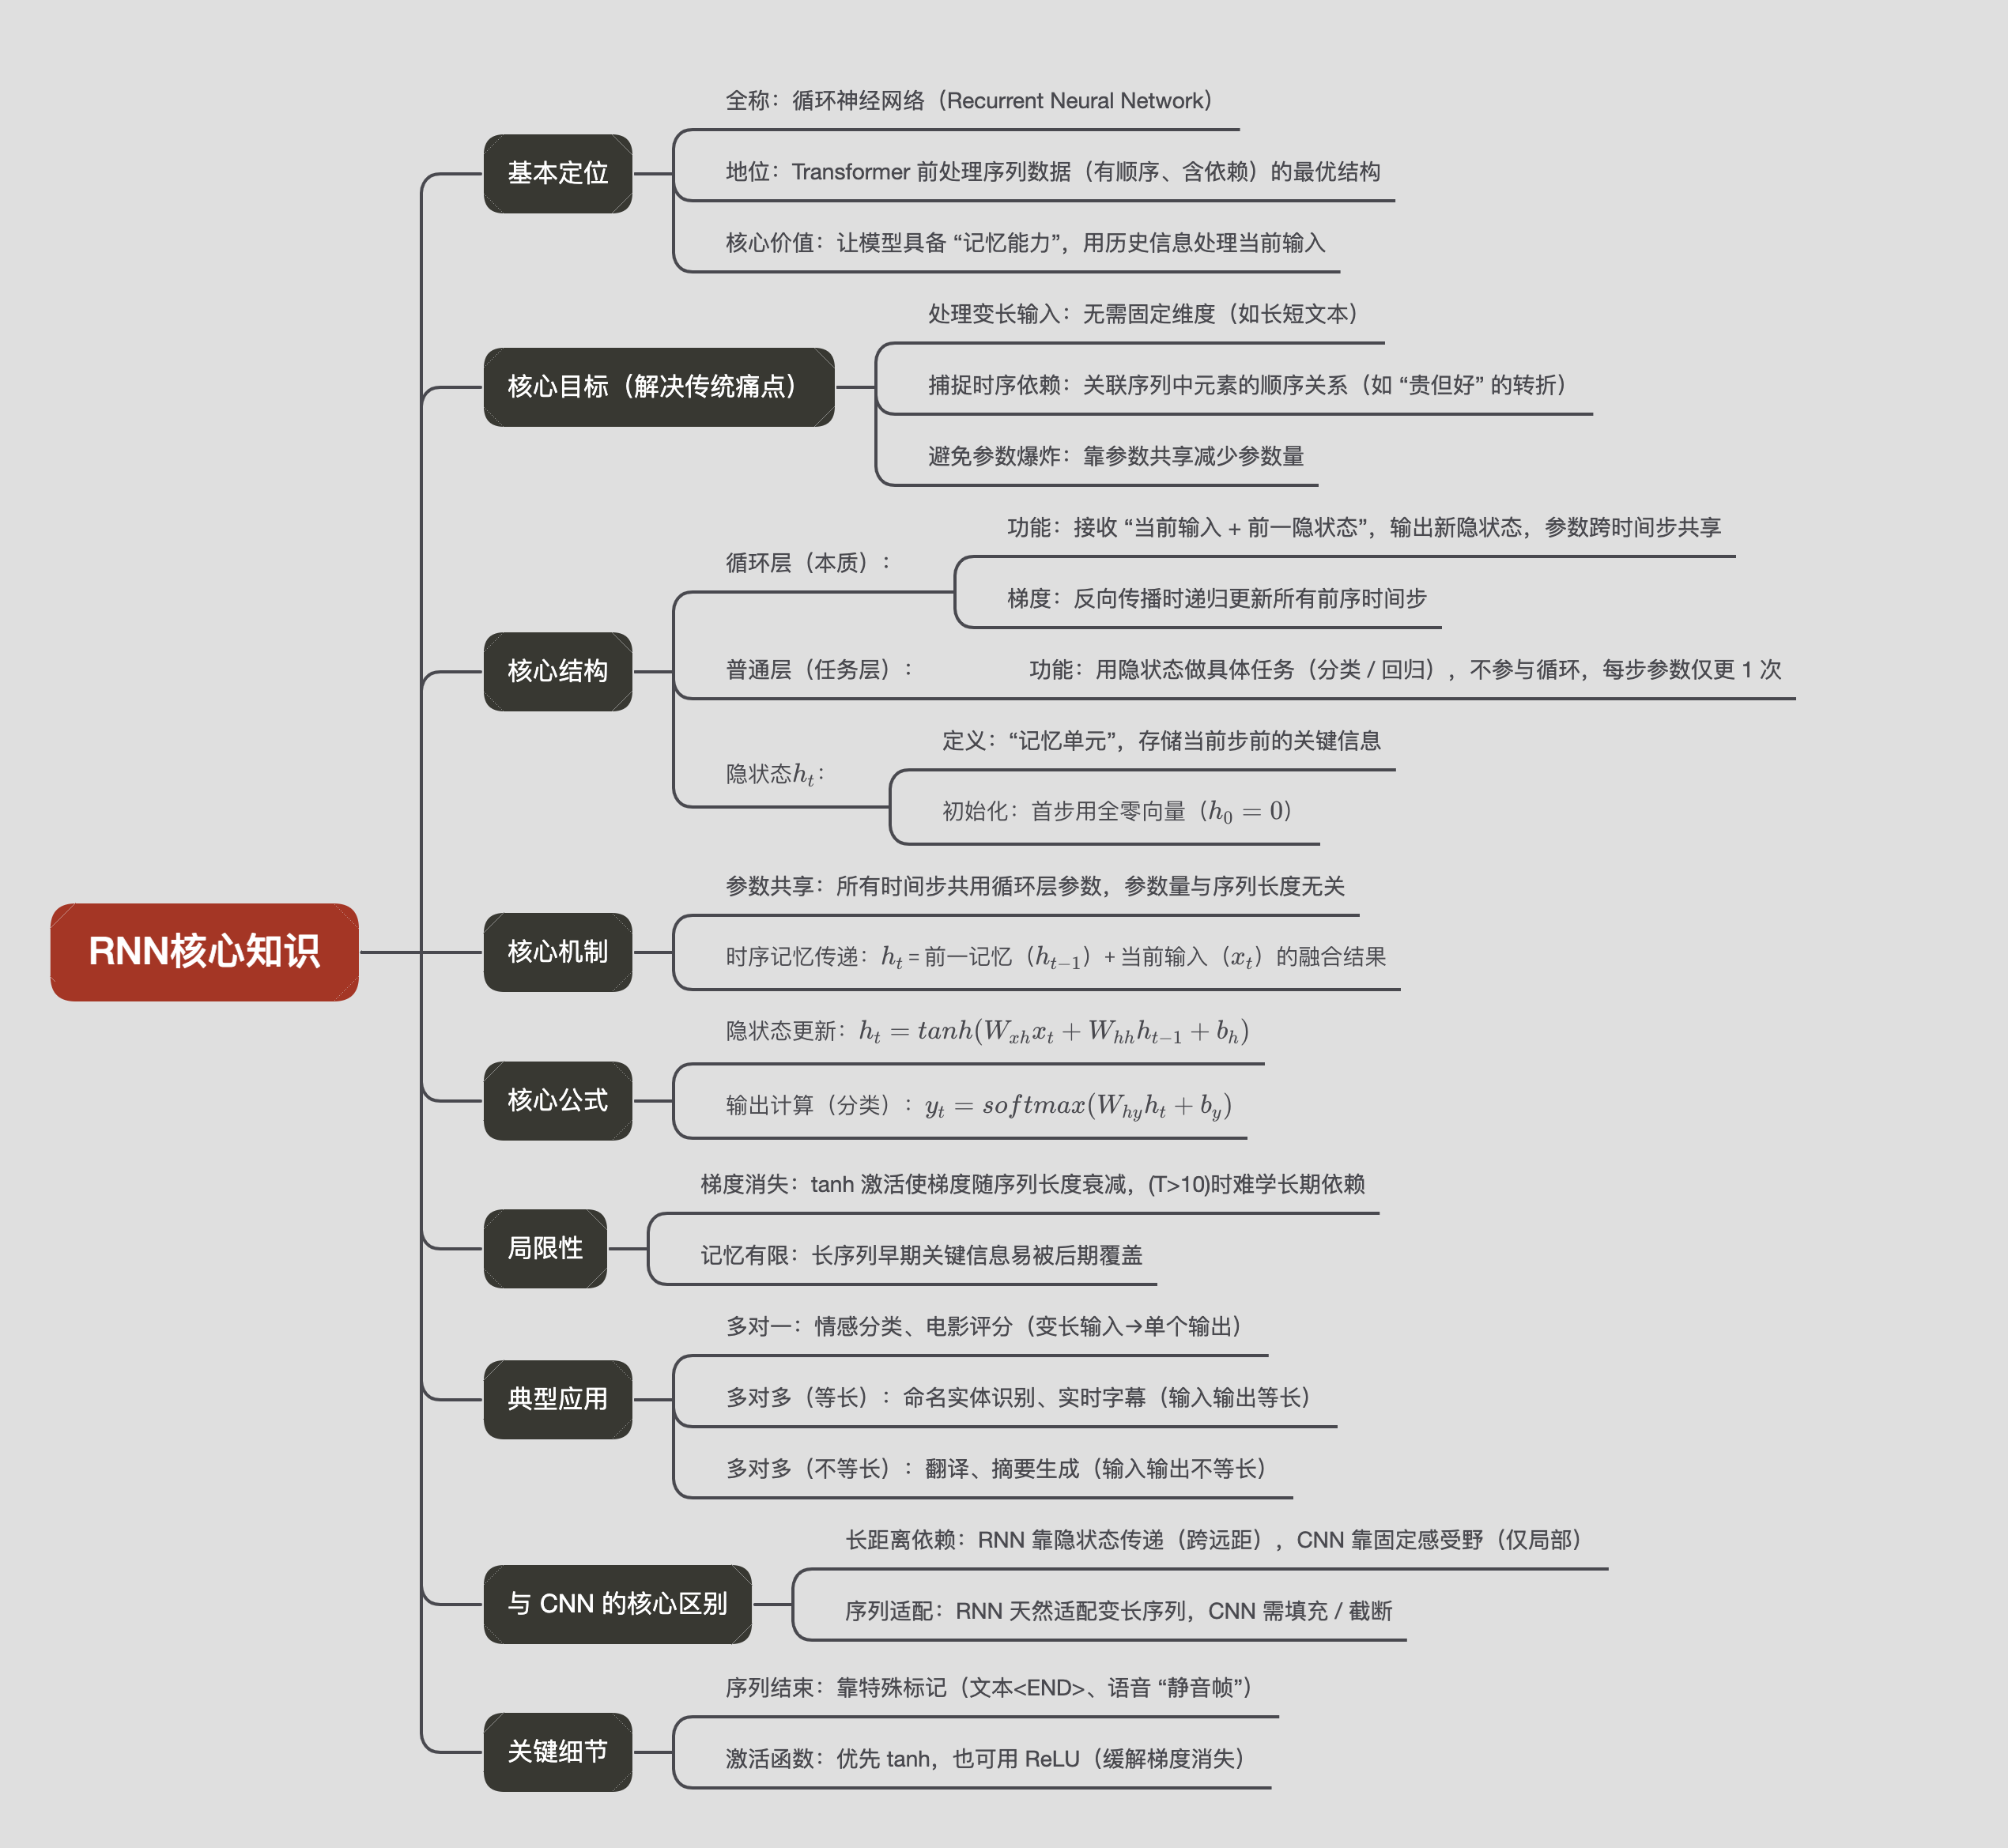
四、核心知识点思维导图
五、知识问答
1. RNN 的 “参数共享” 说能 “省劲儿”,到底能省多少?有没有具体例子能看出来它比传统模型好在哪?
回答:“省劲儿” 主要体现在大幅减少参数量,避免设备因参数过多 “跑不动”。比如处理 100 个时间步的序列(像 100 个词的评论),传统模型需要为每个时间步单独设计一套参数,输入维度会超过 1 万;而 RNN 通过参数共享(比如循环权重 在所有时间步通用),处理 100 步序列时参数仅比处理 1 步增加 0.01%。简单说,传统模型处理 100 步要 100 套 “工具”,RNN 只用 1 套,既能减少显存占用,也能让训练更快。
2. RNN 会 “忘事儿”(梯度消失),那如果序列长度刚好是 10 步,或者稍微超过一点(比如 12 步),还能用 RNN 吗?结果会差很多吗?
回答:能不能用要看任务难度,结果差异也和序列内容有关。根据文档,当序列长度T>10时,tanh 激活函数导致梯度近乎消失,但这不是 “绝对不能用” 的红线:
如果是简单任务(比如判断 12 个词的短评论是 “好评” 还是 “差评”,关键词集中在中间或结尾),RNN 勉强能用,只是可能记不住开头的次要信息(比如 “今天买的” 这种背景),对结果影响不大;
如果是复杂任务(比如分析 12 个词的转折句 “虽然今天下雨但玩得很开心”),RNN 会忘开头的 “下雨”,误判成 “单纯开心”,结果就会差很多。这种情况就需要后面学的 LSTM/GRU 来解决。
3. RNN 能处理 “变长输入”,那它怎么知道一个序列什么时候结束?比如一句话有 5 个词和 10 个词,它不会 “处理到一半停了” 或者 “多处理无效内容” 吗?
回答:RNN 靠序列数据里的 “结束标记” 识别结尾,不会乱停或多处理。比如处理文本时,会在每句话的最后加一个特殊符号(比如 “<END>”),当 RNN 读取到这个符号,就知道 “这个序列结束了,不用再处理后面的内容了”;处理语音时,会用 “静音帧” 作为结束信号 —— 就像我们说话结尾会停顿,RNN 能识别这个 “停顿” 作为结束标志。比如电商评论里,3 个词的 “衣服超棒<END>” 和 300 个词的长评论 “这件衣服面料是棉的…… 很推荐<END>”,RNN 都是读到 “<END>” 就停止,不会乱处理
4. 之前学过 CNN 也能处理 “有顺序的东西”(比如图片的像素是按行列顺序排列的),那 RNN 和 CNN 处理 “顺序” 的核心区别是什么?为啥处理文本非要用 RNN 而不用 CNN?
回答:核心区别是能否捕捉 “长距离依赖”,这也是文本任务选 RNN 的关键。CNN 的 “感受野” 是固定的(比如一次只能看图片里 3×3 的像素块),没法跨很远的距离关联信息;而 RNN 靠隐藏状态传递历史信息,能跨时间步关联 “远处” 的内容。
比如处理句子 “虽然价格贵但质量好”:CNN 一次只能看 2-3 个词,看到 “贵” 时记不住前面的 “虽然”,看到 “好” 时又忘了 “贵”,会误判成 “差评”;但 RNN 能通过隐藏状态记住 “虽然”(表转折),再关联 “贵” 和 “好”,正确判断成 “好评”。简单说,CNN 是 “近视眼”(看不远),RNN 是 “带记忆的正常眼”(能记着远处的信息),所以文本这种需要跨词关联的任务,更适合 RNN。
5. RNN 的 “每步输出”(比如命名实体识别)和 “最后输出”(比如文本分类),除了文档里的例子,还有没有更贴近我们生活的例子?怕记混这两种用法。
回答:结合生活场景很容易区分,再举两个文档外但符合 RNN 逻辑的例子:
- 每步输出:就像 “实时字幕生成”—— 我们说话时,每说一个字(一个时间步),字幕就要对应显示一个字(一个输出),不能等说完一整句话再一次性出字幕;还有 “实时股票涨跌预测”,每过 1 分钟(一个时间步),就预测下 1 分钟的涨跌(一个输出),这都是 “每步要结果” 的场景。
- 最后输出:就像 “电影评分”—— 我们看完一整部电影(一个完整序列),不会每看 10 分钟就打一次分,而是看完最后才给一个总分(一个输出);还有 “快递地址分类”,看完完整的地址 “北京市朝阳区 XX 路”(一个序列),最后只需要判断 “属于朝阳区”(一个输出),这都是 “只要最后结果” 的场景
六、参考文章

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 38
 0
- 0


 已为社区贡献1条内容

所有评论(0)