NeurIPS 2025|MIT提出LGMP:面向预训练自监督视觉模型的数据集蒸馏
点击原文,获取更多顶会论文精读
一、导读
在人工智能的视觉任务中,通常需要大量真实图像来训练模型,这既耗时又耗费资源。数据集蒸馏(Dataset Distillation) 的目标是合成一小批图像,使得用这批图像训练出的模型性能与使用全部真实数据训练出的模型相当。
然而,现有方法主要针对从零开始训练(training from scratch) 的模型,而当前主流视觉模型大多基于预训练的自监督模型(pre-trained self-supervised models) 进行微调或线性分类,这使得传统蒸馏方法难以直接适用。
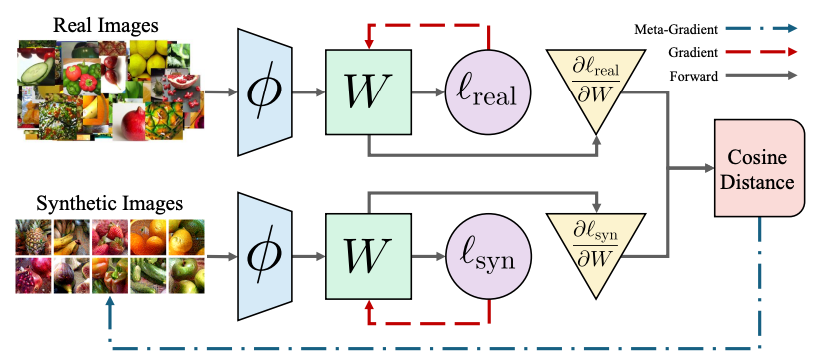
为了解决这一问题,本文提出了一种名为线性梯度匹配(Linear Gradient Matching) 的新方法,专门用于在预训练特征提取器之上训练线性分类器。该方法通过优化合成图像,使其在预训练特征空间中产生的梯度与真实图像一致。
实验表明,该方法在多个数据集和模型上显著优于真实图像基线,甚至能实现跨模型泛化(cross-model generalization)。
二、论文基本信息
-
论文标题:Dataset Distillation for Pre-Trained Self-Supervised Vision Models
-
作者:George Cazenavette, Antonio Torralba, Vincent Sitzmann
-
单位:MIT
-
发表日期与会议/期刊来源:NeurIPS 2025
-
项目地址:georgecazenavette.github.io/linear-gm
三、主要贡献与创新
-
提出线性梯度匹配(Linear Gradient Matching),首次将数据集蒸馏应用于预训练自监督模型的线性分类任务。
-
引入金字塔表示(pyramid representation) 和颜色解相关(color decorrelation),显著提升合成图像的质量与泛化能力。
-
使用可微分增强(differentiable augmentations) 提升蒸馏图像的多样性和鲁棒性。
-
验证了蒸馏图像在细粒度分类(fine-grained classification) 和跨模型泛化中的优越表现。
-
提出蒸馏图像可作为模型对齐(model alignment) 和可解释性(interpretability) 的工具。
四、研究方法与原理
本文提出线性梯度匹配(Linear Gradient Matching),通过优化合成图像,使其在预训练特征提取器中产生的梯度与真实图像一致,从而训练出高性能的线性分类器。
-
梯度匹配目标
给定预训练特征提取器 ,真实数据集 ,目标是合成一个小数据集 。在每一步蒸馏中,随机初始化一个线性分类器 ,计算真实图像和合成图像在特征空间中的分类损失:其中 表示交叉熵损失。接着计算两者对 的梯度,并定义元损失(meta loss) 为两者梯度的余弦距离:
通过反向传播更新合成图像 。
-
金字塔表示与颜色解相关
为避免图像过拟合,合成图像不是直接优化像素,而是通过多尺度金字塔 重建:同时使用颜色解相关技术,减少模型对颜色的偏好。
-
可微分增强
在蒸馏过程中对合成图像进行水平翻转、随机裁剪和高斯噪声等增强,提升图像的多样性和泛化能力。
五、实验设计与结果分析
-
实验设置
使用 ImageNet-1k、ImageNet-100、Spawrious、Waterbirds、Stanford Dogs、CUB-200-2011、ArtBench 等数据集,在 CLIP、DINO-v2、EVA-02、MoCo-v3 四种预训练模型上评估。评测指标为线性分类准确率。 -
对比实验
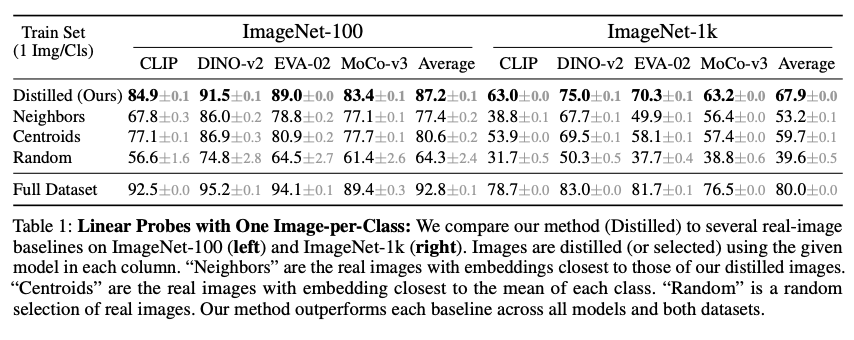
在 ImageNet-100 和 ImageNet-1k 上,本文方法在每类仅一张图像(1 image per class) 的情况下,显著优于所有真实图像基线(Neighbors、Centroids、Random)。例如在 DINO-v2 上,ImageNet-1k 准确率达到 **75.0%**,而全数据集训练为 83.0%。
-
跨模型泛化
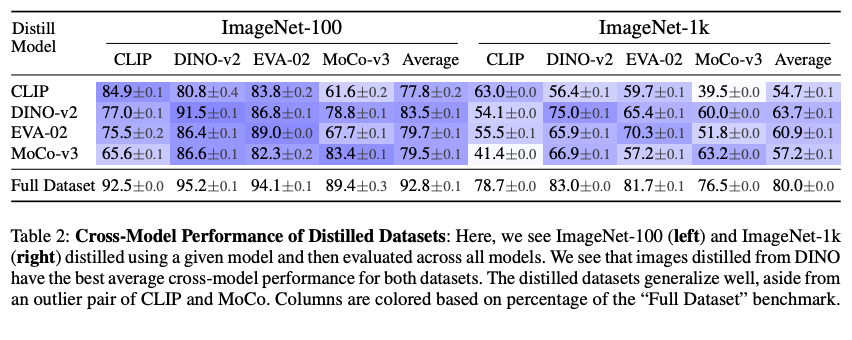
表2 展示了使用某一模型蒸馏的图像在其他模型上的表现。DINO-v2 蒸馏的图像在跨模型评估中表现最佳,说明其具有良好的泛化能力。
-
消融实验
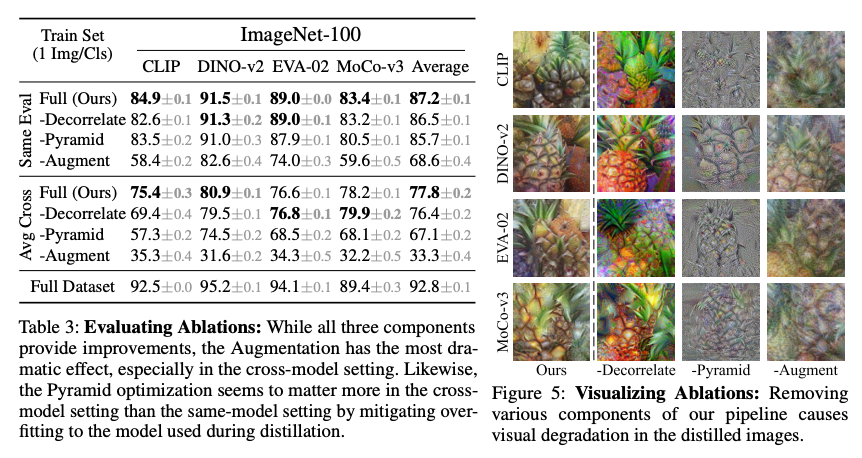
表3 和图5 分析了颜色解相关、金字塔表示和可微分增强的作用。增强对性能影响最大,金字塔表示显著提升跨模型性能,颜色解相关对视觉质量有改善。
-
细粒度分类与对抗数据集
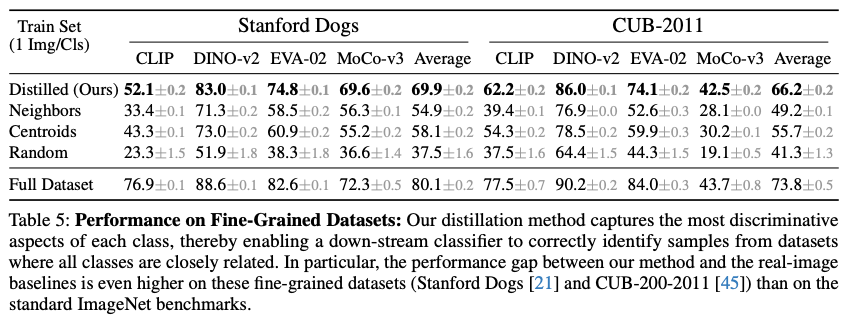
表5 显示在 Stanford Dogs 和 CUB-200-2011 上,本文方法优势更加明显。
-
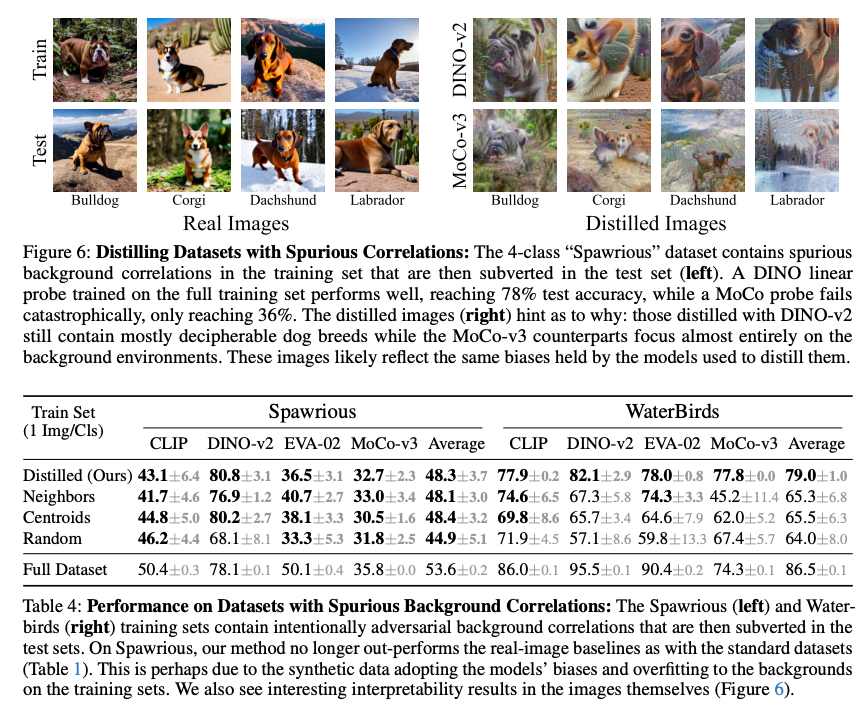
表4 和图6 分析了在 Spawrious 和 Waterbirds 等包含虚假相关性(spurious correlations) 的数据集上的表现,蒸馏图像揭示了模型对背景的依赖程度。
-
模型对齐与可解释性
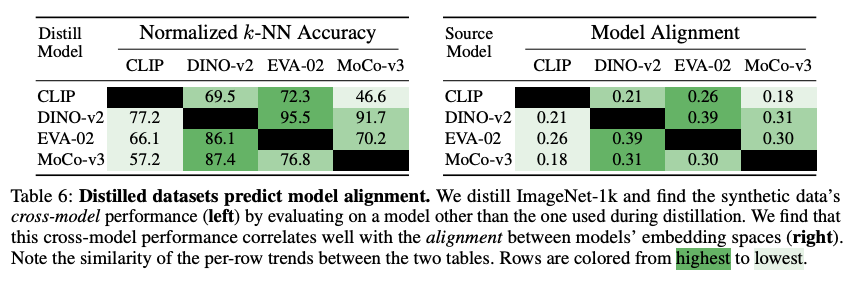
表6 显示,蒸馏图像的跨模型性能与模型间的对齐程度(alignment) 高度相关,验证了柏拉图表示假设(Platonic Representation Hypothesis)。
六、论文结论与评价
-
总结
本文提出了一种针对预训练自监督模型的数据集蒸馏方法,通过线性梯度匹配合成每类仅一张图像,即可训练出高性能线性分类器。该方法在多个数据集和模型上优于真实图像基线,并具备良好的跨模型泛化能力和可解释性。 -
评价
该方法的优势在于高效压缩数据集、提升训练效率,并为模型行为提供可视化解释。缺点是蒸馏过程仍依赖大量真实图像加载和双层次优化,计算成本较高。未来可探索更轻量的蒸馏策略,或将其应用于更多模态与任务中。
点击原文,获取更多顶会论文精读

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 39
 0
- 0


 已为社区贡献2条内容

所有评论(0)