文献阅读篇#10:自动驾驶中的基础模型:场景生成与场景分析综述(1)
文章标题:Foundation Models in Autonomous Driving: A Survey on Scenario Generation and Scenario Analysis
(翻译)自动驾驶中的基础模型:场景生成与场景分析综述
文章发表于预印本:Foundation Models in Autonomous Driving: A Survey on Scenario Generation and Scenario Analysis
摘要:
确保自动驾驶车辆在真实环境中的安全,需要应对各种各样且罕见的驾驶场景。基于场景的测试通过提供一种可扩展且可控的方法来开发和验证自动驾驶系统,从而满足这一需求。然而,依赖规则逻辑、知识驱动模型或数据驱动合成的传统场景生成方法,通常生成的场景多样性有限且不够真实。(背景、问题)随着基础模型的出现,这类新一代预训练通用人工智能(AI)模型,开发者可以处理异构输入(如自然语言、传感器数据、地图和控制动作),从而实现复杂驾驶场景的合成、解析和分析。(引出本文要写的主体)本文回顾了基础模型在自动驾驶中的场景生成与场景分析的应用。我们的调研提出了一个统一的分类体系,包括用于自动驾驶场景生成和分析的大型语言模型、视觉语言模型、多模态大型语言模型、扩散模型以及世界模型,概述了它们的基本原理、应用及相应的评估指标。此外,我们还回顾了相关的方法论、开源数据集、仿真平台和基准挑战。最后,调研总结了在将基础模型应用于自动驾驶场景生成与分析时面临的开放挑战、研究问题及未来有前景的研究方向。所有被回顾的论文均收录在一个持续维护的公共仓库中,该仓库会随着新研究不断更新:GitHub.com/TUM-AVS/FM-for-Scenario-Generation-Analysis。(文章内容总结)
关键词:自主车辆、基础模型、场景生成、场景分析、基于场景的测试
1、Introduction引言
近年来,自动驾驶取得了快速发展,已经达到在特定操作设计域(ODDs)中对人类干预最小化甚至完全不需要的阶段[1]。像Waymo这样的公司自2018年以来已经成功部署了全自动无人出租车服务[2],达到SAE 4级[3],展示了在特定城市环境中无人驾驶出行的可行性。截至2025年,Waymo每周提供25万次商业乘车服务[4]。这些进展得益于高可靠性模块化自动驾驶(AD)软件的开发和严格验证,包括感知、预测、规划和控制 [5]。除了传统的模块化架构之外,基于端到端学习的方法 [6],[7] 也应运而生,利用深度学习处理原始传感器数据,并直接生成轨迹或控制动作 [8]。(背景,一些自动驾驶现状)
基于场景的仿真测试是评估和验证自动驾驶系统安全性和性能的关键因素 [9]。作为物理测试的经济高效替代方案,它能够模拟真实、可重复和可控的驾驶环境 [10],尤其在复现安全关键情境方面效果显著,包括现实世界数据集中常缺失的罕见边缘情况 [11],[12]。因此,系统地产生和分析驾驶场景的能力对于基于场景的测试至关重要 [13]。更具体地说,场景生成侧重于为自动驾驶测试创建多样化、安全关键且可控的驾驶情境,而分析则涉及从安全性、风险和行为理解角度评估这些场景,以便分类或选择测试场景,或提升自动驾驶整体性能。(仿真场景测试)
机器学习(ML)的最新进展,尤其是大规模基础模型(FMs)的出现,为提升自动驾驶场景测试的现实性、多样性和可扩展性提供了新的机会。基础模型由斯坦福以人为本的人工智能研究所(HAI)于2021年8月提出[14],用以描述一类通常通过自监督学习在大规模、多样化数据集上训练的模型。与通常针对特定、狭义任务训练的传统机器学习模型不同,基础模型可以通过提示或微调等技术适应广泛的任务。这些模型在各个领域都表现出强大的性能,包括自然语言处理(NLP)[15]、视觉理解[16]和代码生成[17]。在自动驾驶的背景下,基础模型近年来受到了广泛关注,因为它们将通过大规模预训练学习到的通用知识与对特定自动驾驶任务(如感知、规划、控制)的高效适应性相结合[18]–[20]。(机器学习这一块)
A. 所考虑文献的范围
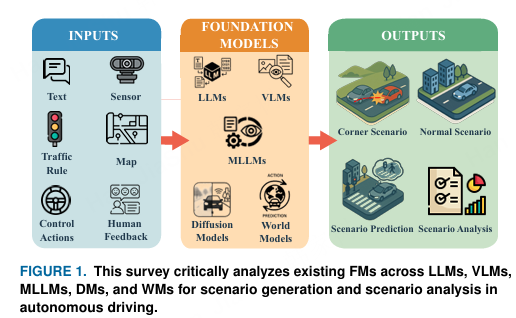
在本次调查中,我们重点关注在自动驾驶背景下,利用基础模型进行场景生成和场景分析的相关出版物(见图1)。我们的调查是基于在 Google Scholar 的关键词搜索。完整的关键词列表以及所有参考论文的概览可在本文的 GitHub 仓库中获取。
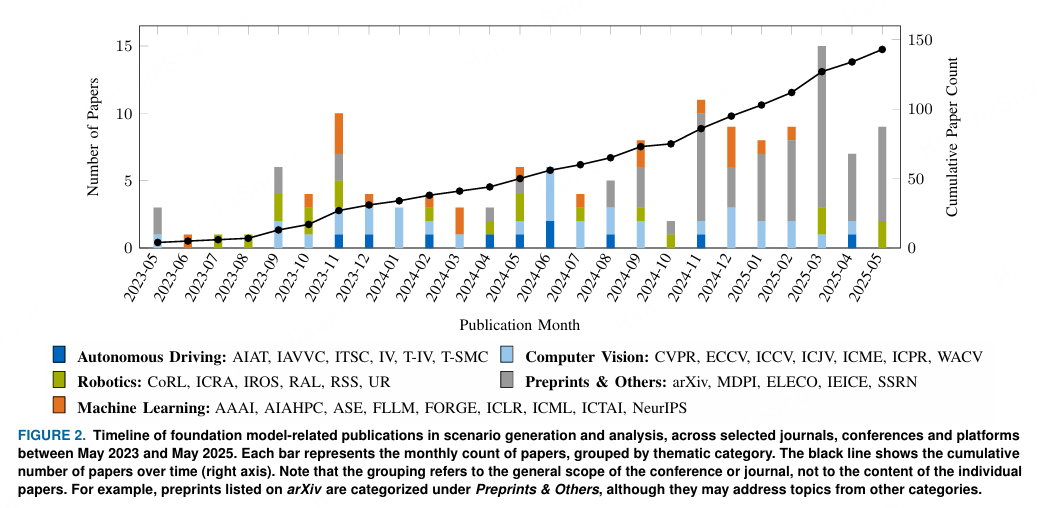
为了确保覆盖面和相关性,我们包括了经过同行评审的会议论文和期刊论文,以及来自 arXiv 的预印本。虽然 arXiv 的出版物没有经过正式的同行评审,但它们通常能够提供及时且具有影响力的研究成果,尤其是在如 FM 应用等快速发展的领域。我们的调研涵盖了 2022 年 10 月至 2025 年 5 月期间发表的论文,主要关注自动驾驶、计算机视觉、机器学习和机器人学等领域的学术场所。图 2 显示了每月的出版数量趋势及其按出版场所主题焦点(如会议、期刊或预印本平台)分布的情况。(很全,截至2025.5)
B. 调查结构
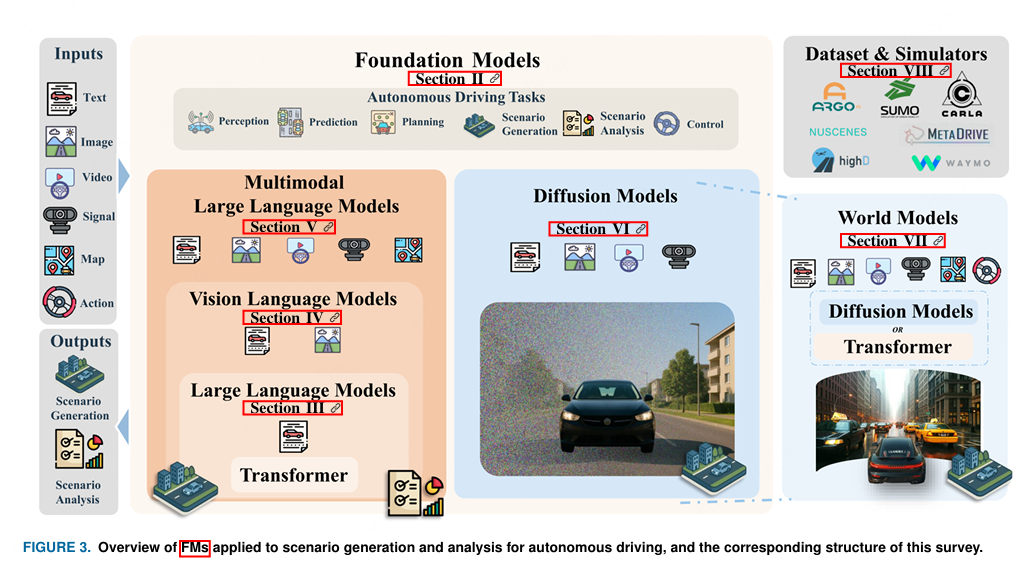
本次调研的结构如图3所示。第二部分介绍了基础模型,并对相关的场景生成与分析的调研进行了批判性回顾,涵盖了经典方法以及近年来基础模型的最新进展。第三、第四和第五部分系统地分析了基于语言的基础模型,先介绍基本概念,再深入讨论大语言模型(LLMs)、视觉语言模型(VLMs)和多模态大语言模型(MLLMs)在场景生成与分析中的最新应用。第六和第七部分涉及以视觉为中心的基础模型,详细说明了扩散模型(DMs)和世界模型(WMs)的原理及其在场景生成中的相关性。第八部分综述了场景生成与分析中常用的评价指标、公开数据集和仿真基准,并突出了该领域的主要竞赛挑战。最后,第九部分和第十部分指出了开放的研究问题并概述了未来的研究方向,第十一部分总结了本次调研的核心发现。(调查的内容)
分析:概述了自动驾驶的发展与基于场景的仿真测试的重要性,并指出机器学习基础模型为提升测试能力提供了新机遇,同时明确了本次综述将聚焦于利用基础模型进行场景生成与分析的相关文献。
2、相关工作与贡献
A. 基础模型的发展
“基础模型”一词于2021年提出[14],指的是在大规模未标注数据上训练的通用模型,旨在跨各种应用场景进行操作和泛化。它们的跨模态适应能力有潜力实现诸如问答(QA)、图像描述、情感分析、信息提取、物体识别和指令执行等任务,将生成能力与深度上下文理解相结合。虽然FMs和生成式AI相关,但它们代表不同的概念:FMs是广泛且可适应的系统,而生成式AI则专注于内容创作。(基础模型定义)
2021 年,OpenAI 发布了 GPT-3[21],这是一个让大规模语言模型(LLM)广为人知的重要里程碑。GPT-3 的成功建立在 Transformer 架构[22]之上,其自注意力机制促进了对长序列的高效并行训练。后续模型进一步改进了这一设计,包括 BERT[15](用于掩码语言建模的仅编码器形式)、GPT[23](用于自回归生成的仅解码器形式)以及 T5[24](用于文本到文本转换的编码器-解码器形式)。每种模型都采用自监督预训练,并作为下游任务适配的骨干。(GPT)
Transformer 架构的原理很快就被扩展到 NLP 之外,并实现了视觉理解、语音、表格数据和多模态学习。Transformer 架构在不同领域的扩展促使了 VLM(视觉语言模型)的发展,例如对比语言-图像预训练(CLIP)和 MLLM(多模态大语言模型),如 LLaVA,它们将 LLM 的语言推理能力与视觉表示结合起来,以实现跨模态对齐和基于感知的理解。更具体地说,紧凑型 VLM 通常以 LLM 作为骨干网络,辅以文本分词器和专门的视觉编码器来提取视觉特征。MLLM 进一步扩展了这一范式,通过整合额外的特定模态编码器,如音频、深度或传感器输入,并使用对齐模块将这些异构表示与 LLM 骨干融合。继承自 LLM 的强大推理能力使这些模型能够执行复杂的多模态推理,而新增的视觉和感官编码器则使 VLM 和 MLLM 能够在真实世界环境中有效运行,在这些环境中,理解语言指令和感知输入都是必不可少的。(VLM和MLLM)
与此同时,生成建模的进展发展了扩散模型(DMs),特别是去噪扩散概率模型(DDPMs)[30],它们通过学习到的去噪过程生成高质量的样本。随后出现的变体,包括改进的DDPMs[31]、潜在扩散模型(LDMs)[32] 和视频扩散模型(VDMs)[33],进一步提升了生成效率、可控性和时序一致性。扩展到图像合成之外,扩散模型自然支持多模态条件,使其能够进行文本、音频和视频引导的生成。其高生成保真度和灵活的条件机制使它们成为基于Transformer架构的有力补充,特别是在多模态学习和世界建模应用中。(扩散模型DMs)
最终,WMs [34] 被开发出来以学习交互环境的紧凑表示。经典的 WMs 结合了视觉编码器(例如变分自编码器(VAEs))与循环记忆模块(例如循环神经网络(RNNs))以及轻量级控制器(例如进化策略),以实现未来预测,例如预测视频帧或展开潜在状态轨迹。最新的 WMs 设计将 FMs 集成到它们的组件中,例如通过用 DMs [35] 或 LLMs [36] 替换编码器或记忆模块,从而有可能在同一框架中统一感知、推理和生成。总体而言,这种互联演进代表了从特定模态 FMs 向通用多模态系统发展的进程,以实现对环境的全面理解和交互。(世界模型WMs)
B. 自动驾驶中的基础模型
最近的研究探讨了将基础模型(FMs)整合到自动驾驶(AD)系统中,利用其在模块化和端到端架构中的适应性和多模态特性。全面的调查例如 [18],[19] 提供了当前领域的广泛概览,涵盖大型语言模型(LLMs)、视觉语言模型(VLMs)、多模态大型语言模型(MLLMs)、扩散模型(DMs)和工作记忆模型(WMs)。(两个大范围综述,如下)
[18] Y. Huang, Y. Chen, and Z. Li, “Applications of large scale foundation models for autonomous driving,” preprint arXiv:2311.12144, 2023.
[19] H. Gao, Z. Wang, Y. Li, K. Long, M. Yang, and Y. Shen, “A survey for foundation models in autonomous driving,” preprint arXiv:2402.01105, 2024.
自动驾驶中的大语言模型(LLM):Zhu 等人 [37] 的综述回顾了大语言模型在模块化自动驾驶系统中的整合,并重点介绍了感知、决策、控制和端到端方法。类似地,Wu 等人 [38] 研究了大语言模型在多智能体感知、决策和仿真中的应用。最后,Li 等人 [39] 回顾了大语言模型在实现模块化和端到端自动驾驶系统中类人推理的作用,并强调了训练和整合策略,这与我们的任务无关。(三个LLM的综述)
自动驾驶中的VLM:综述[40]探讨了VLM在各类自动驾驶任务中的应用,其中扩散模型和世界模型被用于场景理解、视觉推理和数据集生成。(一个VLM的综述,如下)
[40] X. Zhou, M. Liu, E. Yurtsever, B. L. Zagar, W. Zimmer, H. Cao et al., “Vision language models in autonomous driving: A survey and outlook,” IEEE Transactions on Intelligent Vehicles, 2024.
自动驾驶中的多模态大语言模型(MLLMs):Cui 等人的调查 [41] 侧重于 MLLMs 的架构、模态融合及其在自动驾驶任务中的应用。Fourati 等人的调查 [42] 将 XLMs 介绍为 LLMs、VLMs 和 MLLMs 的组合,并提供了它们在自动驾驶中使用的综述,包括概念、工作流程和技术。最后,Li 等人的调查 [43] 探讨了 LLM 和 MLLM 在不同自动驾驶模块中的应用,涵盖了集成和训练技术。(三个MLLM的综述)
自动驾驶中的决策模型(DMs)和世界模型(WMs):Guan 等人 [44] 提供了自动驾驶中世界模型的概述,重点介绍了其在场景生成、运动预测和控制中的应用。Tu 等人 [45] 对驾驶世界模型进行了进一步探讨,将其分类为二维场景演化、三维占用预测和无场景范式。(两个世界模型的综述)
关于与生成式人工智能的重叠,Wang 等人 [46] 回顾了自动驾驶(AD)技术栈中的生成式模型。虽然范围广泛,但他们的综述采用了以模型为中心的视角,缺乏对场景生成的集中讨论。
总之,虽然上述工作涵盖了 AD 中的感知、规划、决策、仿真和测试,但它们并未明确讨论大模型(FMs)在场景生成或分析中的角色,因为这并非它们的主要研究重点。我们的综述旨在填补这一空白。(一个生成式模型的综述)
C. 自动驾驶中的情景生成
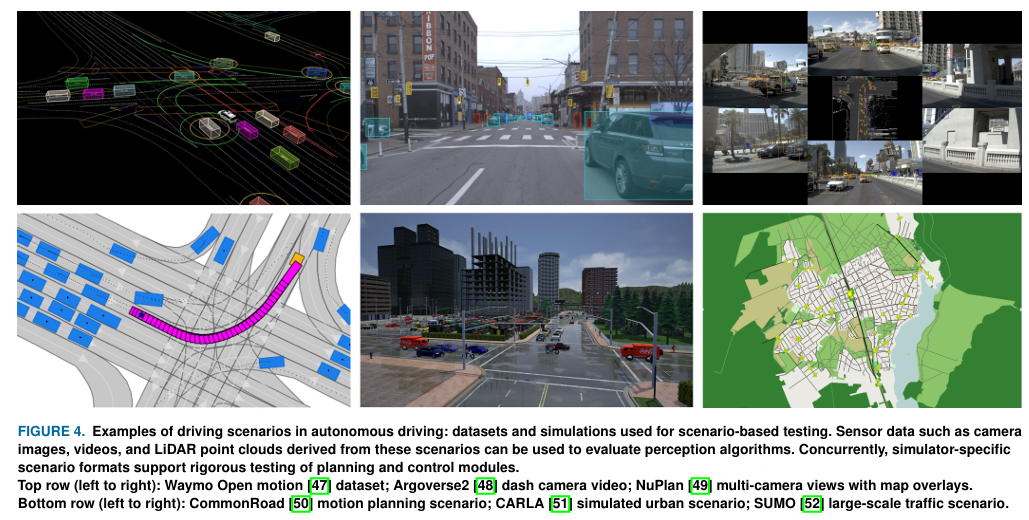
自动驾驶中的场景格式多种多样,包括带注释的传感器数据、多摄像头视频流、基于地图的布局、模拟城市场景以及交通级别的环境,例如 OpenScenario2。图4展示了不同格式的驾驶场景示例。接下来,我们将回顾现有关于经典方法和基于FM方法的场景生成综述。
针对基础模型的调查:
大多数现有的综述都涉及经典方法(即非基于FM的方法)用于场景生成。Nalic 等人 [53] 引入了基于知识和基于数据的生成方法,并讨论了用于场景评估的安全指标。他们还提出了一个六层模型,涵盖了场景的所有核心组成部分。Ding 等人 [54] 将场景生成方法分为基于数据、对抗性和基于知识的方式,并对每种方法的机制提供了详细的见解。他们还强调了深度生成模型在合成基于图像和视频的场景中的作用,并在不同模型的多篇论文中进行了探讨。与 ISO/WD PAS 21448 标准——预期功能安全(SOTIF)——保持一致,Schutt 等人 [55] 研究情景生成跨功能、逻辑和具体的抽象层次。他们的回顾包括基于机器学习的生成、以优化为驱动的场景探索、从驾驶数据中提取场景以及手动场景设计。
针对FMs的调查:
Huang 等人 [18] 提供了各种基础模型的概述,并简要讨论了场景生成。然而,他们的分析仅限于输入模态和模型类型,并未涉及具体的技术或评估策略。
针对VLMs的调查
Yang 等人 [56] 研究了在感知、问答和生成等任务中使用大语言模型(LLMs)和视觉语言模型(VLMs)的情况。他们提到使用 VLMs、扩散模型(DMs)和世界模型(WMs)进行场景生成,但未明确区分这些模型类型。虽然引用了几种评估指标,但这些指标并未按任务或应用进行整理。Tian 等人 [57] 则提供了关于自主驾驶中 VLMs 的更结构化的综述,涵盖了 LLMs、VLMs 和 WMs,特别关注通过 VLM 引导生成的交通仿真及其与扩散模型的整合。然而,该综述缺乏关于输入模态、场景生成技术以及模型类型区分的信息。
[56] Z. Yang, X. Jia, H. Li, and J. Yan, “Llm4drive: A survey of large language models for autonomous driving,” preprint arXiv:2311.01043, 2023.
[57] H. Tian, K. Reddy, Y. Feng, M. Quddus, Y. Demiris, and P. Angeloudis, “Large (vision) language models for autonomous vehicles: Current trends and future directions,” Authorea Preprints, 2024.
针对DMs和WMs的调查:
傅等人 [58] 回顾了视频生成和世界模型(WM),涵盖了基于扩散、自回归以及强化学习的方法。冯等人 [59] 关注于WM,将输出分类为图像、鸟瞰图以及三维点云,并讨论了语义分割和占用预测等评估指标。然而,这些综述都没有将模型输出直接与场景生成任务联系起来。他们也未能区分独立的扩散模型(DM)和世界模型(WM),并且缺乏对具体技术和评估策略的讨论。
D. 自动驾驶中的情景分析
情景分析涉及对驾驶情景的系统评估(图4)。它包括情景评估、场景理解、风险评估、异常检测和事故预测等任务。此外,还包括识别安全关键情况、评估系统的稳健性,以及在模拟和现实环境中支持明智的决策。
针对基础模型的调查:
Riedmaier 等人 [10] 提出了基于场景的安全评估方法的分类,包括基于知识、数据驱动和基于反驳的方法。他们强调使用关键绩效指标(例如,碰撞时间、所需减速度)作为事故风险的替代指标,并主张将形式化方法整合到安全验证中。
Mahmud 等人 [60] 回顾了近端替代指标,如碰撞时间、越界后时间和避免碰撞的减速度。他们对这些指标进行了分类,并指出了主要的研究挑战,包括指标标准化、实际验证以及整合到基于仿真的情景分析框架中。
针对FMs的调查:
Huang 等人 [18] 在“感知数据标注”一词下简要提到了情景分析,但并未根据任务的目标进行分类。此外,他们既没有将数据集与单个研究关联起来,也没有讨论模态转换;因此,他们的综述并未聚焦于预训练的基础模型。
针对VLMs的调查
杨等人 [56] 在问答背景下讨论了场景分析,主要关注数据集描述。他们的分析仍然有限,因为缺少对输入模态、方法学方法、模型分类和评估指标的讨论。同样,田等人 [57] 考虑了视觉问答(VQA)作为使用 VLM 的一种情景分析形式,但涉及的资源较少,并且讨论很有限。
E. 批判性总结
据我们所知,现有关于基于FM的自动驾驶场景生成和/或分析的调查在以下方面存在局限(总结见表1):
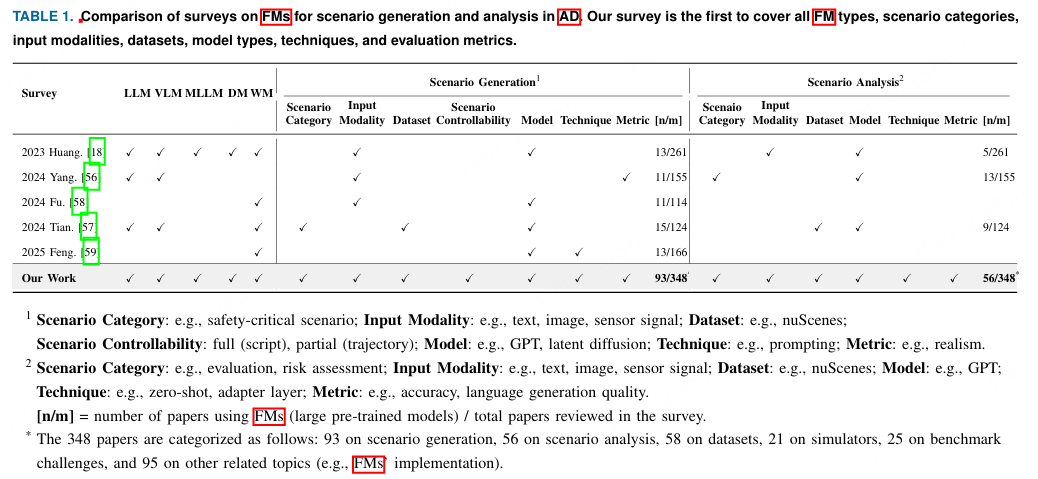
缺乏对场景生成的关注:所有被审查的调查中,没有一项明确关注使用大型模型进行场景生成。在涉及时,场景生成要么只是被简要提及(例如,[18],[43]),要么在讨论时缺乏对生成技术、场景可控性或评估指标的深入分析(例如,[56]–[58])。
情景分析覆盖不完整:诸如情景理解、评估和风险评估等任务被忽视。当被涉及时(例如,[56] 和 [57]),分析通常仅限于问题回答,几乎没有关注任务特定的模型、方法或评估策略。
不同模态和任务之间的联系有限:尽管几项调查考虑了大模型的输入模态,但它们并未在这些模态与用于场景生成和分析的技术、模型以及数据集之间建立明确的联系。
缺乏结构化分类:目前尚无研究提出涵盖场景生成和场景分析的 FMs 结构化分类,考虑预训练模型类型、适应方法(例如提示、微调)、输入模态、数据集以及评估指标。
F. 贡献
为了解决现有文献综述的局限性,本调查评估了情景生成和情景分析领域中基础模型(FMs)的现状(表1)。总的来说,本工作提供了以下关键贡献:
- 我们首次对生成式模型(FMs)在自动驾驶(AD)场景生成与分析中的应用进行了综述。
- 对现有方法的结构化分类:我们的工作提供了一个覆盖所有生成式模型类型(即大型语言模型LLMs、视觉语言模型VLMs、多模态大型语言模型MLLMs、扩散模型DMs、世界模型WMs)、场景类别、输入模态、模型类型、数据集、技术和评估指标的结构化分类。
- 数据集、仿真平台和现有基准竞赛的综述:我们回顾了用于场景生成与分析的公开可获取的数据集和仿真器。同时,我们提供了首个针对生成式模型在自动驾驶中的基准竞赛的综述。
- 识别开放性挑战与未来方向:我们识别了在基于场景的测试中应用生成式模型的开放研究挑战。基于我们的分析,我们提出了未来研究方向,以提升生成式模型驱动方法在场景生成与分析中的适应性和鲁棒性。
分析:系统回顾了自动驾驶领域中将基础模型用于场景生成与分析的现有综述,批判性地指出这些研究普遍存在关注点分散、覆盖不全、缺乏系统性分类等局限,并明确提出本调查旨在填补该空白,首次提供涵盖所有关键模型类型和评估维度的结构化综述。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献4条内容

所有评论(0)