RNN(循环神经网络)
·
1.概念
1.介绍
RNN(循环神经网络,Recurrent Neural Network) 是一种专门用于处理序列数据的神经网络。它的核心特点是循环:网络在读取序列的每一个元素时,都会更新一个“内部状态”,这个状态会作为“记忆”传递到下一个时间步。
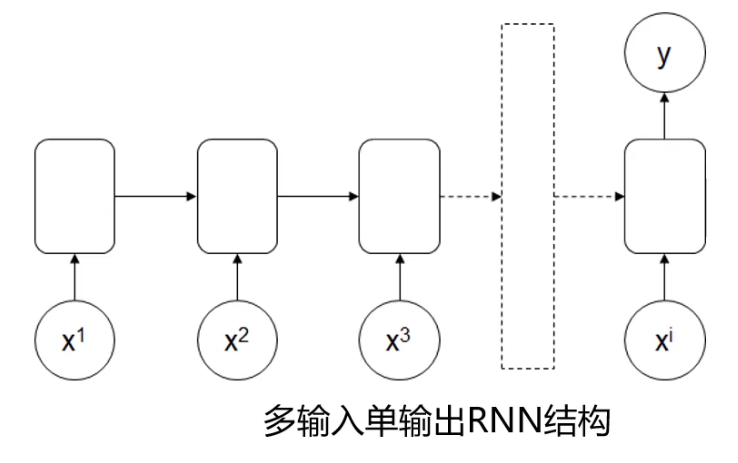
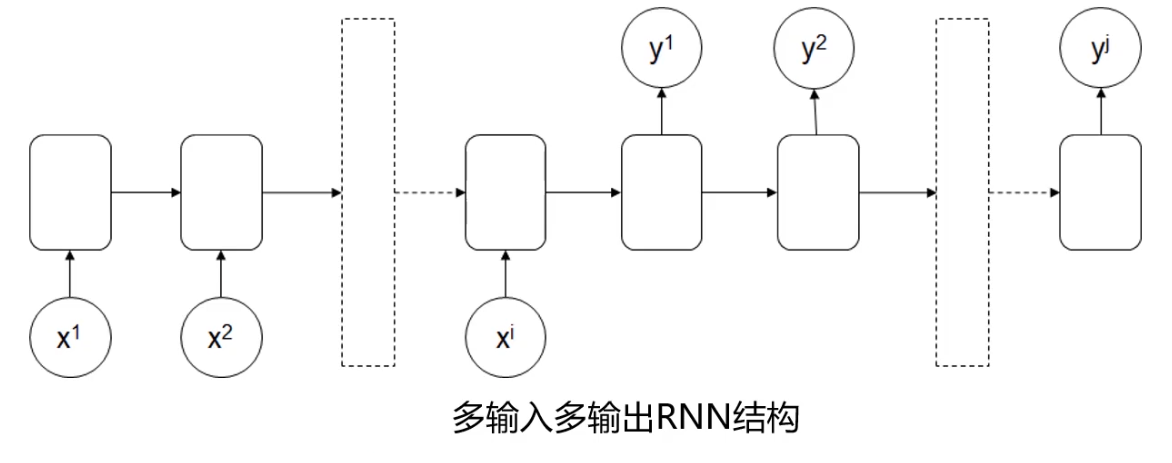
2.分类(按输入输出分类)
单输入多输出: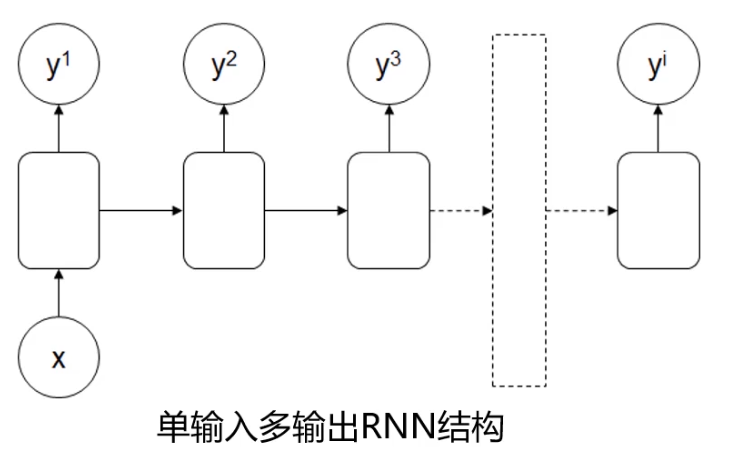
多输入单输出:
多输入多输出:
3.为什么要用RNN,LSTM结构?
CNN擅长处理空间结构,一张图片它可以通过卷积进行扫描分析,而RNN擅长处理时间结构,如一个句子的语序。与此同时,RNN存在“长距离依赖”问题,即早期的信息无法影响到后期,用专业术语来说就是梯度消失,而LSTM通过“遗忘门、输入门、输出门”三个门控和一个独立的“细胞状态”,让网络能够自主选择:记住什么、忘记什么、输出什么,从而显著提升了长距离依赖的学习能力。
2.代码实战(一)RNN股价预测
import pandas as pd
import numpy as np
data = pd.read_csv('zgpa_train.csv')
data.head()

price = data.loc[:,'close']
price.head()

#归一化处理,让数据全部处在0-1的区间
price_norm = price/max(price)
print(price_norm)

from matplotlib import pyplot as plt
fig1 = plt.figure(figsize=(8,5))
plt.plot(price)
plt.title('close price')
plt.xlabel('time')
plt.ylabel('price')
plt.show()

#X,y赋值
def extract_data(data,time_step):
    X = []
    y = []
    for i in range(len(data)-time_step):
        X.append([a for a in data[i:i+time_step]])
        y.append(data[i+time_step])
    X = np.array(X)
    X = X.reshape(X.shape[0],X.shape[1],1)
    return X, y

time_step = 8

X,y = extract_data(price_norm,time_step)
print(X[0,:,:])
print(y)
#建立模型
from keras.models import Sequential
from keras.layers import Dense, SimpleRNN
model = Sequential()
#add RNN layer
model.add(SimpleRNN(units=5, input_shape=(time_step,1),activation='relu'))
#add output layer
model.add(Dense(units=1,activation='linear'))
#configure the model
model.compile(optimizer='adam',loss='mean_squared_error')
model.summary()

model.fit(X,y,batch_size=30,epochs=200)

y_train_predict = model.predict(X)*max(price)
y_train = [i*max(price) for i in y]

fig2 = plt.figure(figsize=(8,5))
plt.plot(y_train,label='real price')
plt.plot(y_train_predict,label='predict price')
plt.title('close price')
plt.xlabel('time')
plt.ylabel('price')
plt.legend()
plt.show()

data_test = pd.read_csv('zgpa_test.csv')
price_test = data_test.loc[:,'close']
price_test_norm = price_test/max(price)
X_test_norm, y_test_norm = extract_data(price_test_norm,time_step)
print(X_test_norm.shape,len(y_test_norm))

y_test_predict = model.predict(X_test_norm)*max(price)
y_test = [i*max(price) for i in y_test_norm]

fig3 = plt.figure(figsize=(8,5))
plt.plot(y_test,label='real price_test')
plt.plot(y_test_predict,label='predict price_test')
plt.title('close price')
plt.xlabel('time')
plt.ylabel('price')
plt.legend()
plt.show()

#预测数据存储
result_y_test = np.array(y_test).reshape(-1,1)
result_y_test_predict = y_test_predict
print(result_y_test.shape,result_y_test_predict.shape)
result = np.concatenate((result_y_test,result_y_test_predict),axis=1)
print(result.shape)
result = pd.DataFrame(result,columns=['real_price_test','predict_price_test'])
result.to_csv('zgpa_predict_test1.csv')
3.代码实战(二)LSTM实现文本生成
data = open('flare').read()
#移除换行符
data = data.replace('\n','').replace('\r','')

#字符去重处理
letters = list(set(data))
print(letters)
num_letters = len(letters)
print(num_letters)


int_to_char = {a:b for a,b in enumerate(letters)}
print(int_to_char)

char_to_int = {b:a for a,b in enumerate(letters)}
print(char_to_int)

time_step = 20

import numpy as np
from keras.utils import to_categorical
#滑动窗口提取数据
def extract_data(data, slide):
    x = []
    y = []
    for i in range(len(data) - slide):
        x.append([a for a in data[i:i+slide]])
        y.append(data[i+slide])
    return x,y
#字符到数字的批量转化
def char_to_int_Data(x,y, char_to_int):
    x_to_int = []
    y_to_int = []
    for i in range(len(x)):
        x_to_int.append([char_to_int[char] for char in x[i]])
        y_to_int.append([char_to_int[char] for char in y[i]])
    return x_to_int, y_to_int
#实现输入字符文章的批量处理,输入整个字符、滑动窗口大小、转化字典
def data_preprocessing(data, slide, num_letters, char_to_int):
    char_Data = extract_data(data, slide)
    int_Data = char_to_int_Data(char_Data[0], char_Data[1], char_to_int)
    Input = int_Data[0]
    Output = list(np.array(int_Data[1]).flatten())
    Input_RESHAPED = np.array(Input).reshape(len(Input), slide)
    new = np.random.randint(0,10,size=[Input_RESHAPED.shape[0],Input_RESHAPED.shape[1],num_letters])
    for i in range(Input_RESHAPED.shape[0]):
        for j in range(Input_RESHAPED.shape[1]):
            new[i,j,:] = to_categorical(Input_RESHAPED[i,j],num_classes=num_letters)
    return new, Output

X, y = data_preprocessing(data,time_step,num_letters,char_to_int)

from sklearn.model_selection import train_test_split
X_train,X_test,y_train,y_test = train_test_split(X,y,test_size=0.1,random_state=10)
print(X_train.shape,len(y_train))

y_train_category = to_categorical(y_train,num_letters)
print(y_train_category)

from keras.models import Sequential
from keras.layers import Dense,LSTM
#建模
model = Sequential()
model.add(LSTM(units=20,input_shape=(X_train.shape[1],X_train.shape[2]),activation='relu'))
model.add(Dense(units=num_letters,activation='softmax'))
model.compile(optimizer='adam',loss='categorical_crossentropy',metrics=['accuracy'])
model.summary()

model.fit(X_train,y_train_category,batch_size=1000,epochs=10)

y_train_predict = model.predict_classes(X_train)
print(y_train_predict)

y_train_predict_char = [int_to_char[i] for i in y_train_predict]
print(y_train_predict_char)

from sklearn.metrics import accuracy_score
accuracy_train = accuracy_score(y_train,y_train_predict)
print(accuracy_train)

y_test_predict = model.predict_classes(X_test)
accuracy_test = accuracy_score(y_test,y_test_predict)

print(accuracy_test)
print(y_test_predict)
print(y_test)


#预测
new_letters = 'flare is a teacher in ai industry. He obtained his phd in Australia.'
X_new, y_new = data_preprocessing(new_letters,time_step,num_letters,char_to_int)
y_new_predict = model.predict_classes(X_new)
print(y_new_predict)

y_new_predict_char = [int_to_char[i] for i in y_new_predict]
print(y_new_predict_char)

for i in range(0,X_new.shape[0]-20):
    print(new_letters[i:i+20],'--predict next letter is---',y_new_predict_char[i])

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)