CSDI:用于概率时间序列插补的条件得分扩散模型
文章信息
文章题目为《CSDI: Conditional Score-based Diffusion Models for Probabilistic Time Series Imputation》,《CSDI:用于概率时间序列插补的条件得分扩散模型》,发表在第35届Conference on Neural Information Processing Systems,作者Yusuke Tashiro,来自斯坦福大学。
摘要
时间序列中缺失值的插补在医疗和金融等领域有着广泛的应用。虽然自回归模型是时间序列插补的自然选择,但近年来得分扩散模型(score-based diffusion models)在图像生成、音频合成等任务中已经超越包括自回归模型在内的现有方法,因此它们在时间序列插补中也具有很大潜力。在本文中,本文提出了一种新的时间序列插补方法——用于插补的条件得分扩散模型(CSDI),该方法利用基于得分的扩散模型并以已观测数据为条件。与现有的得分扩散方法不同,CSDI 的条件扩散模型是专门为插补任务进行训练的,并且能够利用观测值之间的相关性。在医疗和环境数据上的实验结果表明,CSDI 在多种常用性能指标上相比现有的概率插补方法提升了40–65%。此外,CSDI 的确定性插补结果相比目前最先进的确定性插补方法可减少5–20%的误差。除此之外,CSDI 也可以用于时间序列的插值与概率预测,并在这些任务上表现得与现有基线方法具有竞争力。
引言
多变量时间序列在金融、气象和医疗等真实世界应用中十分常见。这些时间序列数据常常由于各种原因(包括设备故障和人为错误)而包含缺失值。由于缺失值会妨碍对时间序列的解释,因此许多研究使用机器学习技术来处理缺失值填补任务。在过去几年中,基于深度神经网络的填补方法在确定性填补和概率性填补方面都取得了巨大成功。这些填补方法通常利用自回归模型来处理时间序列。
基于得分的扩散模型是一类深度生成模型,它们通过逐步将噪声转换为可信的数据样本来生成样本(通过去噪过程)。近期,这类模型在图像生成和音频合成等任务中取得了最先进的样本质量,性能优于包括自回归模型在内的其他模型。扩散模型也可以用于通过对先验分布在观测值条件下得到的后验分布的得分进行近似,实现缺失值填补。虽然这些近似在实践中表现良好,但它们并不对应于精确的条件分布。
在本文中,本文提出了 CSDI,一种新的概率性填补方法,它通过条件得分扩散模型直接学习条件分布。与现有的基于得分的方法不同,这种条件扩散模型专门为填补任务设计,并能够利用观测值中的有用信息。本文在下图中展示了使用 CSDI 进行时间序列填补的流程。本文从图左侧的随机噪声开始填补,并通过条件扩散模型的逆过程pθ逐渐将噪声转换为可信的时间序列。在每一步t,逆过程从前一步(t+1)的输出中去除噪声。与现有的基于得分的扩散模型不同,逆过程可以将观测作为条件输入,使模型能够利用观测信息进行去噪。本文采用注意力机制来捕获时间序列的时间依赖性和特征依赖性。
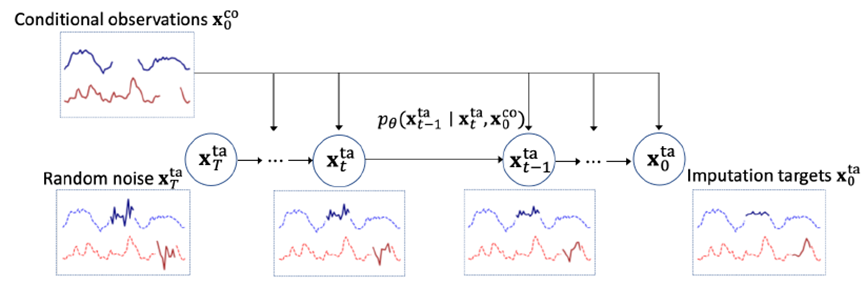
对于训练条件扩散模型,本文需要观测值(即条件信息)和真实的缺失值(即填补目标)。然而,在实际中本文并不知道真实的缺失值,甚至训练数据可能完全不包含缺失值。因此,受到掩码语言模型的启发,本文提出了一种自监督训练方法,将观测值分成条件信息和填补目标。本文注意到,CSDI 是为通用填补任务设计的,并不限于时间序列填补。
本文的主要贡献如下:
本文提出了用于概率性填补的条件得分扩散模型(CSDI),并将其应用于时间序列填补任务。为训练条件扩散模型,本文开发了一种自监督训练方法。
在医疗和环境数据上,本文实证表明 CSDI 相比现有概率性方法,使连续分级概率得分(CRPS)提升 40–65%。此外,CSDI 的确定性填补相比最先进的确定性填补方法,使平均绝对误差(MAE)降低 5–20%。
本文展示了 CSDI 也可用于时间序列插值和概率预测,并在这些任务中达到了与现有基线方法具有竞争力的性能。
问题描述
本文考虑包含缺失值的N个多变量时间序列。记每个时间序列的取值为:
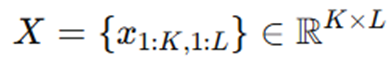
其中K为特征数量,L为时间序列长度。虽然每个时间序列的长度L可以不同,但除非特别说明,本文为简化起见将所有时间序列视为具有相同长度。
本文还定义观测掩码:
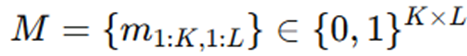
其中mk,l=0表示mk,l缺失,mk,l=1表示mk,l被观测到。
本文允许相邻数据点之间的时间间隔不同,并将时间序列的时间戳表示为:
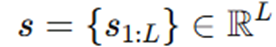
总结而言,每个时间序列可以表示为三元组(X,M,s)。
概率性时间序列填补任务旨在利用X的已观测值来估计其缺失值的分布。本文注意到,这一定义的填补任务涵盖了其他相关任务,例如:
插值(interpolation):在目标时间点填补所有特征;
预测(forecasting):在未来时间点填补所有特征。
模型构建
1. CSDI构建
在本节中,本文提出 CSDI,一种基于条件得分扩散模型的全新填补方法。该条件扩散模型能够利用观测值中的有用信息,从而实现精确的填补。本文将给出条件扩散模型的逆过程,并进一步提出一种自监督训练方法。需要注意的是,CSDI 并不限于时间序列任务。
(1) 使用CSDI进行填补
本文关注条件扩散模型的逆过程,并旨在无近似地建模条件分布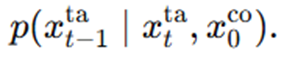
具体而言,本文将DDPM的参数化形式扩展到条件情形。本文定义一个条件去噪函数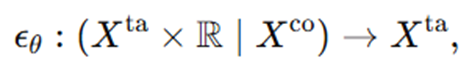 它将条件观测值x0co作为输入。然后,本文使用ϵθ构造以下参数化形式:
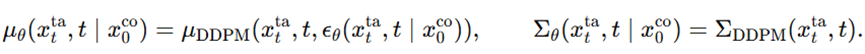
其中μDDPM和ΣDDPM为去噪扩散概率生成模型中定义的函数。给定函数ϵθ和数据x0,本文可以使用扩散模型的逆过程对x0ta(填补目标)进行采样。采样时,本文将x0中所有观测值视为条件观测x0co,将所有缺失值视为填补目标x0ta。
注意,在不提供任何条件观测的情况下,条件模型将退化为无条件模型,因此同样可以用于数据生成。
(2) CSDI的训练
给定条件观测x0co和填补目标x0ta,本文采样带噪目标如下:
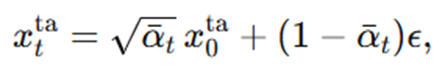
并通过最小化以下损失函数训练ϵθ:
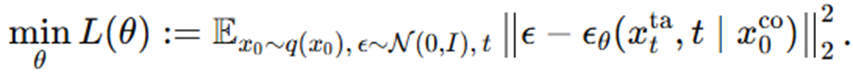
其中噪声ϵθ的维度与填补目标x0ta的维度一致。
然而,这一训练流程存在一个问题:在实际中本文并不知道真实缺失值,因此无法直接从训练样本x0中区分x0co(条件观测)和x0ta(填补目标)。为了解决这一问题,本文借鉴掩码语言模型(masked language modeling)的思想,提出一种自监督学习方法。
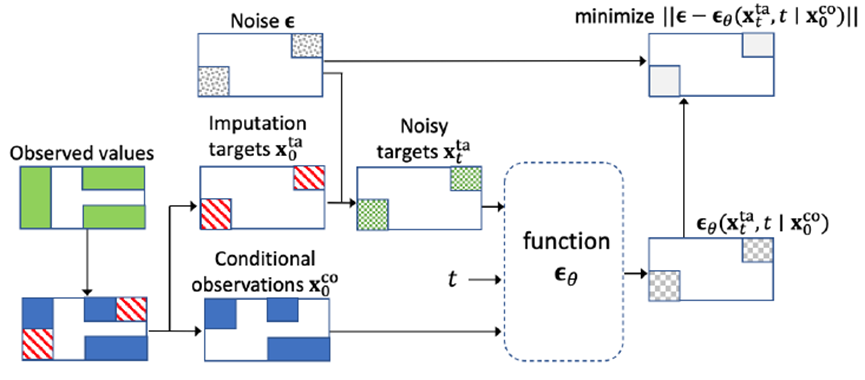
本文在上图中展示了训练流程。给定一个样本x0,本文将其观测值划分为两部分,其中一部分作为填补目标x0ta,另一部分作为条件观测x0co。本文通过一种目标选择策略来确定x0ta,该策略将在下文讨论。随后,本文采样带噪目标xtta,并训练ϵθ。
下表总结了训练与采样阶段如何设置x0co和x0ta。
填补目标x0ta | 条件观测x0co | |
采样 | 所有缺失值 | 所有观测值 |
训练 | 已观测值的一个子集 | 剩余的观测值 |
(3) 自监督学习中填补目标的选择
在所提出的自监督学习方法中,如何选择填补目标至关重要。根据对测试数据集中缺失模式的了解程度,本文提供四种目标选择策略。
a.随机策略(Random strategy):
当本文不了解缺失模式时使用该策略。它会从观测值中随机选择一定比例作为填补目标。该比例从区间[0%,100%]中采样,以适应测试数据集中不同的缺失比例。
b.历史策略(Historical strategy):
该策略利用训练数据集中的缺失模式。给定一个训练样本x0,本文从训练集中再随机抽取另一个样本x0~。然后,将x0的观测索引与x0~的缺失索引的交集设为填补目标。该策略的动机源于真实世界中结构化的缺失模式。例如,时间序列数据中的缺失值通常是连续出现的。当训练集和测试集的缺失模式高度相关时,该策略有助于模型学习到更好的条件分布。
c.混合策略(Mix strategy):
该策略结合前两种策略。历史策略可能会导致模型对训练数据集中的缺失模式过拟合;而混合策略既能从随机策略中获得泛化能力,又能从历史策略中获益于结构化缺失模式。
d.测试模式策略(Test pattern strategy):
当本文已知测试数据集中的缺失模式时,直接将这些模式作为填补目标。例如:在时间序列预测中,测试数据集中的缺失模式由未来时间点决定,因此该策略自然适用。
2. CSDI 在时间序列填补中的实现
在本节中,本文将 CSDI 应用于时间序列填补任务。为实现这一点,本文需要明确输入形式以及条件去噪函数ϵθ的模型结构。
首先,本文描述如何将时间序列数据处理为 CSDI 的输入。如第 3.1 节所定义,一个时间序列表示为{X,M,s},其中X的样本空间为RK×L。本文希望在RK×L的固定样本空间中处理X,以便神经网络可以学习时间序列中的依赖结构。但条件去噪函数ϵθ的输入x0ta和x0co处于不同的子样本空间(即X的一部分),如上图白色区域所示。为解决这一问题,本文将条件去噪函数ϵθ的输入调整为固定的RK×L形状。
具体来说,本文通过对x0ta和x0co进行零填充(zero padding),将它们的形状都固定为(K×L)。换句话说,本文将上图中白色区域的值填补为0。为指示哪些位置是填充得到的,本文引入一个条件掩码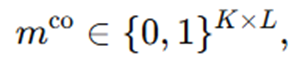 作为ϵθ的额外输入,用于标识哪些索引属于条件观测。为方便处理,本文也将输出形状固定为RK×L(同样使用零填充)。在这种调整下,条件去噪函数可写为:
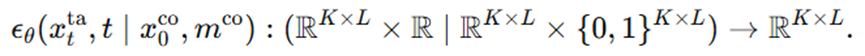
在上述调整下,本文根据上表为时间序列填补任务设置条件观测x0co和填补目标x0ta。在采样阶段,由于条件观测x0co即全部已观测值,因此本文令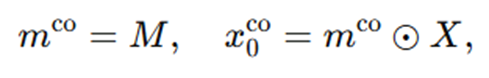 其中⊙表示逐元素乘法。
在训练阶段,本文根据目标选择策略采样x0ta和x0co,并将x0co的索引设置为mco。于是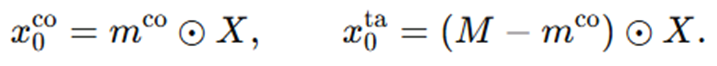
接下来,本文介绍ϵθ的模型结构。本文采用DiffWave的架构作为基础,其由多个具有残差通道数C的残差层组成。本文对该架构进行了适用于时间序列填补的改进,并将扩散步数设为T=50。以下讨论与DiffWave的主要区别。
(1) 注意力机制
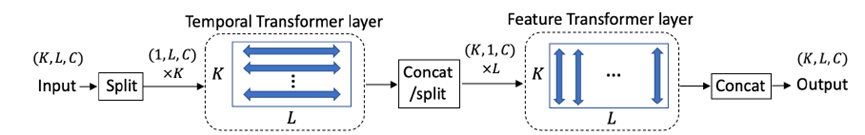
为捕获多变量时间序列的时间依赖和特征依赖,本文在每个残差层中使用二维注意力机制替代卷积结构。如下图所示,本文引入:
时间Transformer层(temporal Transformer layer):对每个特征的时间维序列进行编码,用于学习时间依赖;
特征Transformer层(feature Transformer layer):对每个时间点的特征向量进行编码,用于学习特征依赖。
序列长度L可以随样本变化。注意力机制允许模型处理不同长度的序列。在批训练中,本文对序列进行零填充以统一其长度。
(2) 辅助信息(Side information)
除了ϵθ的基本输入外,本文还提供一些辅助信息作为额外特征输入:
时间戳嵌入(time embedding):利用时间戳s={s1:L}学习时间结构,采用现有研究中常用的128维时间嵌入。
类别特征嵌入(categorical feature embedding):为K个特征引入类别嵌入,维度为16。
实验
在本节中,本文展示CSDI在时间序列插补任务中的有效性。由于CSDI也可应用于插值(interpolation)和预测(forecasting)等相关任务,本文同样在这些任务上评估CSDI,以体现其灵活性。
(1) 数据集与实验设置
本文在两个数据集上进行实验。第一个是 PhysioNet Challenge 2012的医疗数据集,由4000条ICU临床时间序列组成,每条序列包含35个变量、48小时数据。按照前人研究,本文将数据处理为按小时采样、长度为48的时间序列,处理后数据约含80%的缺失值。由于该数据集没有ground-truth,本文在测试集上随机选择10/50/90%的已观测值作为ground-truth。
第二个数据集为空气质量数据集。根据以往研究,本文使用来自北京36个站点12个月的PM2.5小时数据,并将连续36个时间步作为一个时间序列。该数据集约有13%的缺失值,且缺失模式非随机。数据集中包含人工ground-truth,其缺失模式同样具有结构性。
对于两个数据集,本文的每项实验均运行五次。作为训练时的目标选择策略,对于医疗数据集,本文采用随机策略;对于空气质量数据集,本文采用随机策略与历史策略的混合方案,这基于两者不同的缺失模式。
(2) 基线模型
本文将 CSDI 与三个基线方法比较:
Multitask GP:同时学习时间点之间与特征之间的协方差。
GP-VAE:在概率插补方面代表最新的先进方法。
V-RIN:一种确定性插补方法,利用 VAE 的不确定性估计来改善插补。对于 V-RIN,本文将其不确定性视为概率插补结果。
此外,本文还将 CSDI 与使用无条件扩散模型的插补进行比较,以展示条件扩散模型的优势。
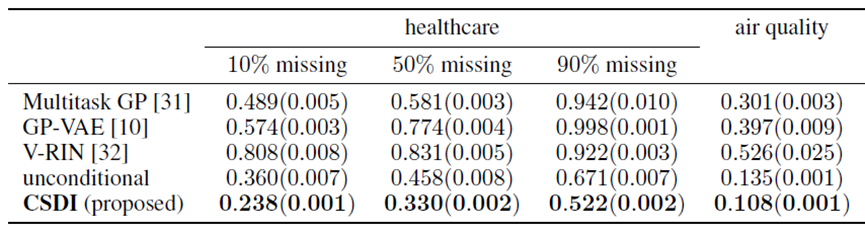
首先展示量化结果。本文采用连续分级概率评分(CRPS)作为评估指标,这是概率时间序列预测中常用的指标,用于衡量预测分布与真实观测之间的兼容性。本文生成100个样本来近似缺失值的概率分布,并按照以往研究,报告所有缺失值CRPS的归一化平均值。
下表给出了各方法的CRPS。CSDI在两个数据集上相较现有基线减少了40–65%的CRPS,表明CSDI生成的分布比其他方法更逼真。本文还观察到,CSDI 的插补效果优于无条件扩散模型,这说明显式建模条件分布是有益的。
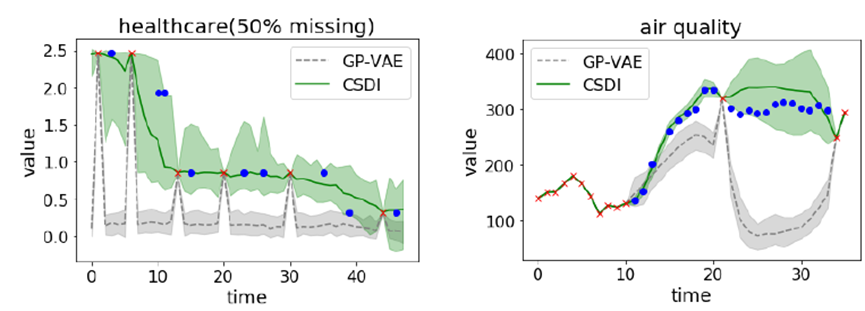
下图展示了插补示例。对于空气质量数据集,CSDI(绿色实线)在高置信度情况下给出了准确插补,而GP-VAE(灰色虚线)结果与ground-truth相差甚远。对于医疗数据集,CSDI 也给出了合理的插补。这些结果表明CSDI能够利用时间和特征依赖关系提供准确插补。
(2) 确定性插补结果
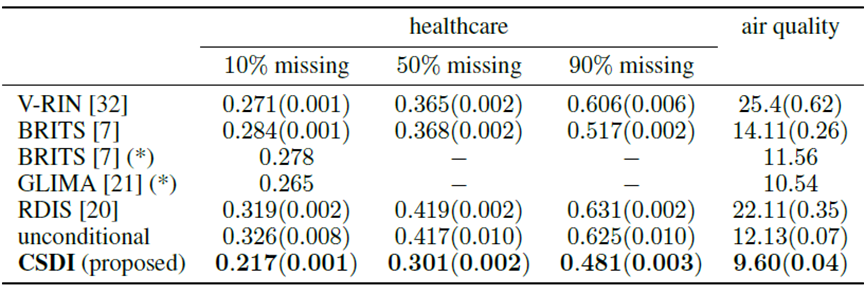
本文进一步展示CSDI也能提供准确的确定性插补,其确定性插补由100个生成样本的中位数得到。本文将CSDI与四种用于确定性插补的基线方法比较,其中包括GLIMA——该方法结合了循环插补与注意力机制以捕获时间与特征依赖关系,并显示了最先进性能。这些方法均基于自回归模型。除 RDIS 外,本文使用其原始实现。
本文使用平均绝对误差(MAE)来评估各方法。在下表中,CSDI的MAE相较基线提高了5–20%。这表明条件扩散模型在学习时间与特征依赖方面对插补任务是有效的。对于医疗数据集,当缺失比例较小时,基线方法与CSDI之间的性能差距尤为明显,因为更多的观测值能帮助CSDI更好地捕获依赖关系。
(3) 非规则采样时间序列的插值(Interpolation)
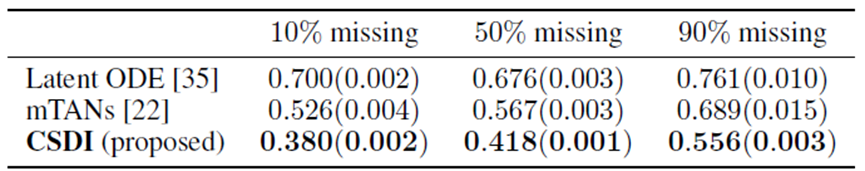
本文使用与上一节相同的医疗数据集,但按照已有研究将其处理为非规则采样时间序列。由于该数据集没有ground-truth,本文在测试集上随机选择 10/50/90% 的时间点,并将这些时间点上的观测值作为 ground-truth。训练时的目标选择策略采用随机策略,并对其进行了调整以适配插值任务,使得部分时间点会被采样为插补目标。
本文将CSDI与两个基线方法比较,其中包括mTANs,该方法利用注意力机制,并在非规则采样时间序列插值任务中取得了最先进结果。与上一节一样,本文生成100个样本以近似缺失值的概率分布。结果如下表所示。CSDI在所有设置下均优于基线方法。
(4) 时间序列预测(Forecasting)
本文使用五个常用于评估概率时间序列预测的数据集。每个数据集包含约100至2000个特征。本文利用过去的时间序列来预测未来时间步的所有特征。预测步长与以往研究中保持一致。目标选择策略采用测试模式策略(Test pattern strategy)。
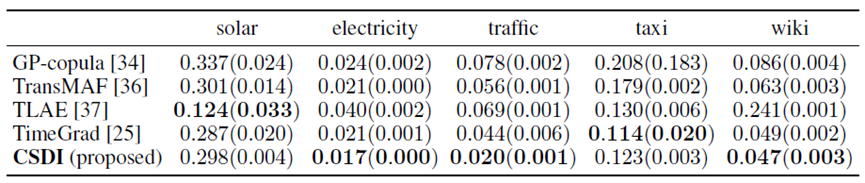
本文将CSDI与四个基线方法比较。特别地,TimeGrad将扩散模型与基于RNN的编码器相结合。本文使用CRPS-sum作为评估指标,它衡量所有特征(K 个特征)的时间序列总和的分布与真实值之间的兼容性,从而反映整体联合效应。
如下表显示,CSDI在electricity和traffic数据集上优于基线方法,并在整体上具有竞争力。然而,CSDI在预测任务上的优势小于其在前文插补任务中的优势。本文推测原因在于预测任务的数据集通常几乎没有缺失值,因此适用于包括RNN在内的现有编码器。而在插补任务中,RNN因缺失值处理困难而表现受限。
结论
在本文中,本文提出了CSDI,一种利用条件扩散模型来填补多变量时间序列缺失值的新方法。本文的实验表明,CSDI 在概率与确定性插补任务上均显著优于现有方法。
未来工作有几个值得探索的方向。一个方向是提升计算效率。尽管扩散模型能够生成高质量的样本,但其采样过程通常比其他生成模型更慢。为缓解这一问题,一些最新研究利用ODE求解器来加速采样过程。将这些方法与本文的模型结合,有望进一步提升采样效率。另一个方向是将CSDI扩展到诸如分类等下游任务。许多研究已经表明,高质量的插补可以提升下游任务表现。由于条件扩散模型能够在不确定性下学习时间和特征依赖关系,基于条件扩散模型的插补与下游任务的联合训练,有望进一步提升下游任务的性能。最后,尽管本文聚焦于时间序列数据,但将 CSDI 作为插补技术应用于其他模态也将是一个值得研究的方向。
欢迎关注微信公众号《当交通遇上机器学习》!如果你和我一样是轨道交通、道路交通、城市规划相关领域的,也可以加微信:Dr_JinleiZhang,备注“进群”,加入交通大数据交流群!希望我们共同进步!
往
期
回
顾
重磅发布 | 《Artificial Intelligence for Transportation》新刊上线!
团队研究成果|大型活动期间城轨短时客流预测
团队研究成果|城市轨道交通短时交通客流OD预测
团队研究成果|城市轨道交通新线客流预测
团队研究成果|城市轨道交通疫情期间短时客流预测
团队研究成果|基于物理信息引导的突发事件期间的城市轨道交通短时OD需求预测
我知道你在看哟

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献14条内容

所有评论(0)