2.Lora微调原理详解
Ch2 Lora微调原理详解
1.为什么需要Lora
- 全参微调的难点:
- 大型语言模型的微调成本高昂:完整微调需要存储和更新所有模型参数的副本
- 部署困难:每个任务都需要存储完整的模型副本,占用大量存储空间
- 计算资源要求高:完整微调需要大量计算资源和GPU内存
- LoRA的核心思想:
- 假设模型权重的更新可以通过低秩分解来表示
- 不直接更新原始权重矩阵,而是训练两个更小的矩阵(低秩分解)
- 通过这种方式大大减少了需要训练和存储的参数数量
- LoRA的优势:
- 显著减少可训练参数数量
- 降低GPU内存需求
- 加快训练速度
- 多个任务可以共享基础模型,只需存储小型任务特定适配器
- 训练稳定性好,性能接近完整微调
假设一个在线客服场景:
- 公司有一个基础的大语言模型用于客服对话需要为不同产品线(如手机、电脑、家电等)定制专门的客服机器人,传统方法需要为每个产品线存储一个完整模型副本
- 使用LoRA后:
- 只需维护一个基础模型
- 为每个产品线训练小型LoRA适配器
- 运行时动态加载对应产品线的适配器
- 大大节省存储空间和训练成本
- 方便快速增加新产品线的支持
这样不仅降低了部署和维护成本,还提高了模型更新和扩展的灵活性。
2.Lora微调方法讲解
2.1 Lora的介绍
LoRA来源于微软在2021年发布的Paper:《LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS》 低秩矩阵微调
地址:https://arxiv.org/pdf/2106.09685.pdf , 同时也在Github上开源了LoRA的技术实现过程,其Github地址:https://github.com/microsoft/LoRA 。
    适配器微调(Adapter Tuning)是在模型中引入了计算模块,本质还是要在模型本身增加层次,会让模型推理走更长的路径。
    LORA的核心思想基准模型不进行变化,额外引入一部分参数来做专属内容处理,同时加上原有模型的推理能力,这部分新增加的的内容就是要训练出来的参数矩阵。
新的矩阵 $ h $ 可以表示为:
$ h = W_0 x + \Delta W x $
其中:
- $ W_0 $ 是原始的权重矩阵。
- $ x $ 是输入向量。
- $ \Delta W $ 是新增的权重矩阵,用于增加训练的特色。
$ x $ 经过原有矩阵计算和现在新增$ \Delta W $ 是矩阵计算后权重给出一个期望的值。
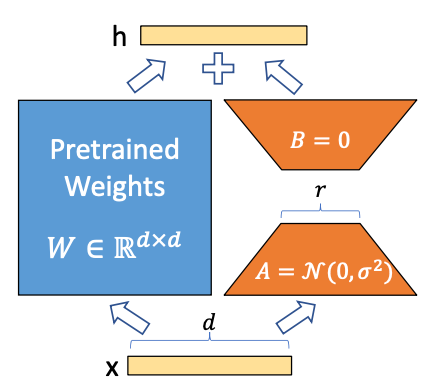
新增这部分参数矩阵我期望不要太大,不然和全参数微调没什么区别了,我想参数量小一点,节约点资源。不然就成了全参数微调了!
线性代数上讲一个参数矩阵可以由两个矩阵相乘得出来,同理$ \Delta W $ 就可以将本身的矩阵拆成矩阵A和矩阵B,A*B=$ \Delta W $
原有算法 $ h = W_0 x + \Delta W x $ 变成 h=W0x+ΔWx=W0x+BAxh = W_0x + \Delta Wx = W_0x + BAxh=W0x+ΔWx=W0x+BAx ( $ x $ 做为向量入参不需要改变只需要跟随即可)
这里引入了一个概念
本征维度(Intrinsic Dimension):是指数据或空间中所需的最小维度,以便充分描述其中的结构或特征。换句话说,尽管数据可能存在于高维空间中,但其实际所包含的信息可能集中在一个更低维度的子空间内,本征维度就是描述这个低维子空间的维度。
- LoRA与本征维度的关系:
-
LoRA的核心假设是神经网络的权重更新矩阵通常具有较低的"本征秩"
-
这意味着虽然模型权重是高维的,但实际的任务相关更新可能位于一个低维子空间中
-
LoRA正是利用了这一特性,使用低秩分解来捕获权重更新
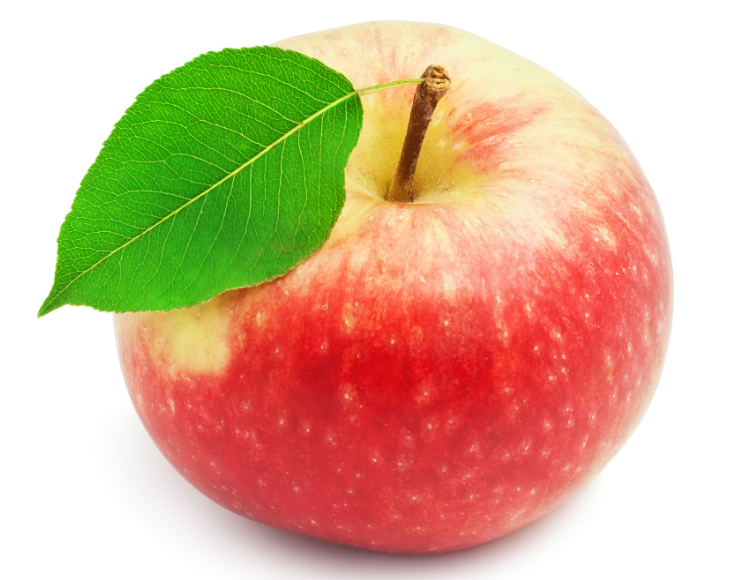 
    例如一张苹果图片,展示很精细,有光线,斑点、叶子脉络、细微的色差等等。
    但是我想要的就是能让我看出苹果才是最关键的点,所以上边的描述是没用的,仅仅用右边最普通的像素点展示就可以了。这个像素极低的几个点才是我最关键的信息。
同理,引入到矩阵中如果将$ \Delta W $ 拆成矩阵A和矩阵B,这两个矩阵的秩与原矩阵相同那就没有意义了,因为想要训练某一个方向专属技能就代表其他技能的参数在想要输出的方向上没那么重要,是不是提炼最相关的那部分业务数据相对更重要。
就会有个关键信息,低秩矩阵,低秩是什么?
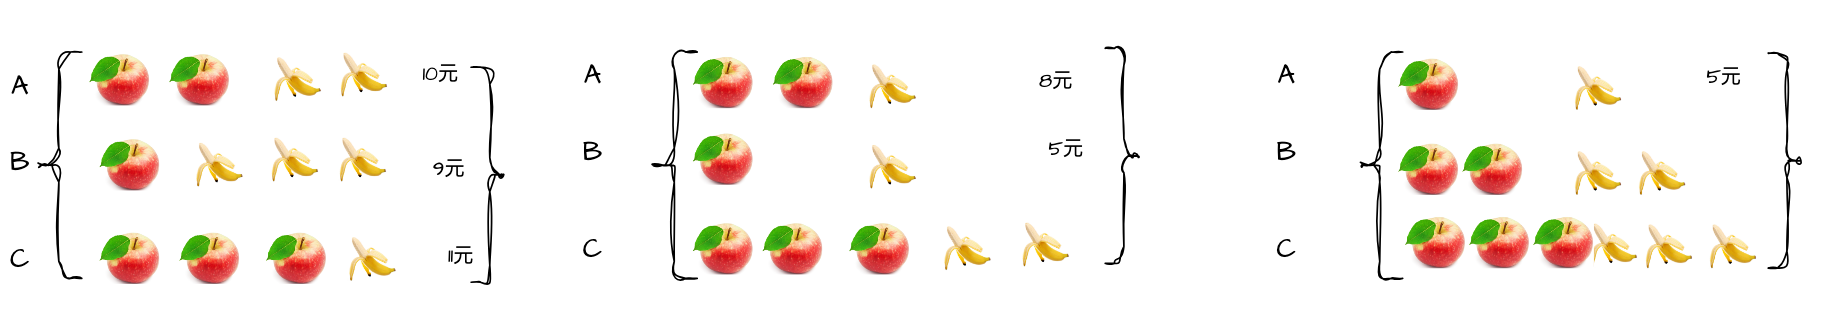
[2∗32∗2101∗33∗293∗31∗211][2∗31∗281∗31∗25][1∗31∗25] \begin{bmatrix} 2*3 & 2*2 & 10 \\ 1*3 & 3*2 & 9 \\ 3*3 & 1*2 & 11 \end{bmatrix} \quad \begin{bmatrix} 2*3 & 1*2 & 8 \\ 1*3 & 1*2 & 5 \\ \end{bmatrix} \quad \begin{bmatrix} 1*3 & 1*2 & 5 \\ \end{bmatrix} 2∗31∗33∗32∗23∗21∗210911[2∗31∗31∗21∗285][1∗31∗25]
一个矩阵的秩是指,矩阵中线性独立行或列的最大数目
第一个矩阵,A、B、C分别各自表示花了多少钱,谁也不能替代谁
第二个矩阵,C买的东西花的钱是A和B的和,那么C就可以被替代,就不属于秩的概念
第三个矩阵,C买的东西花的钱是A3的倍数,那么C就不用表示,B买的东西花的钱是A2的倍数,那么B也就不用表示
对应的秩(Rank) 分别为 3 、2 、1 ,我们是不是可以理解同秩越低占用空间越小
忽略严谨的数学概念定义就可以理解一个矩阵的秩越大,信息含量就越大,对应占用空间也就越大。也就是为什么要用低秩!
具体体现:
    # 假设原始权重矩阵 W ∈ R^{d×k}
    # LoRA将权重更新分解为:
    ΔW = BA   # 其中B ∈ R^{d×r}, A ∈ R^{r×k}, r << min(d,k)
- r 是LoRA的秩(rank),通常远小于原始维度
- r 实际上反映了任务适配所需的本征维度
- 较小的r就足够表达任务所需的权重更新,说明更新确实存在于低维子空间
矩阵是什么呢?怎么表示?
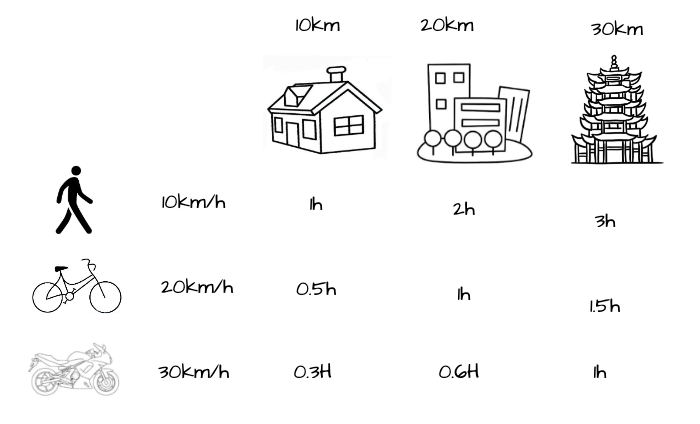
小明想去三个地方距离分别是10、20、30km
他可以步行、自行车、骑摩托去 分别花费了多少时间。
[@@@]与[@@@]能够表达[@@@@@@@@@]矩阵的数量 \begin{bmatrix} @ \\ @ \\ @ \\ \end{bmatrix} 与 \begin{bmatrix} @ & @ & @ \\ \end{bmatrix} 能够表达 \begin{bmatrix} @ & @ & @ \\ @ & @ & @ \\ @ & @ & @ \end{bmatrix} 矩阵的数量 @@@与[@@@]能够表达@@@@@@@@@矩阵的数量
@ 符号仅作为数字占位符使用,不做实际意义,仅用来表达两组数据可以表达一个n*n的矩阵
相比于一开始矩阵9个参数当前替换后的两个小矩阵参数就是3+3=6
    对比之前就是9-6 少了3个参数量的位置与空间。
    如果是一个100w的矩阵的规模,就可以拆成1000*1000的两个矩阵,假设秩=8 那么参数量就是1000*8+1000*8=16000
    这个参数量占原有100w惨数量的 16000/1000000=1.6%
    对于动辄10亿的参数节约的空间就很大了
过参数化模型(Over-parametrized models)是指参数数量远超训练数据样本数量的模型。换句话说,模型中可调参数的数量大于用于训练的样本数量。如GPT系列模型和transformer模型均为此类模型。采用这种策略可以带来性能上的大幅提升。
同样的,如此大的参数量,一定是有冗余的,也就是说:如此多的参数对于很多下游任务,不一定都是有用的。垂直领域的知识所需要的参数一定远小于全量参数,对这样的任务,可能仅仅一部分重要的参数就可以做的足够好。实际上存在于一个较低的内在维度上。
- 假设模型适应过程中权重的变化也具有较低的“内在秩”,基于此这导致了低秩适应(LoRA)方法的灵感。LoRA允许我们通过优化适应过程中密集层变化的秩分解矩阵来间接训练神经网络中的一些密集层,同时保持预先训练的权值冻结,以实现微调效果并节省了计算资源。
# 假设一个客服机器人场景

# 原始模型(过参数化)
- 通用语言理解能力
- 基础对话能力
- 大量冗余参数

# 特定任务适配(如手机客服)
- 只需要学习:
  - 手机相关专业词汇
  - 特定问答模式
  - 服务流程
通俗来讲LoRA的策略是:通过使用较小规模的矩阵来近似模拟大模型的原始矩阵。实现的方式是基于低秩分解的数学原理,通过较少的参数更新实现对大模型复杂功能的有效捕捉和适配,在减少计算资源消耗和提升微调效率的同时,保持或甚至提升模型对特定任务的适应性和性能。
…(代码较长已省略)
输入序列
   ↓
Linear投影层
   ↓
Q、K、V矩阵变换
   ↓
注意力计算
   ↓
O矩阵变换(输出投影)
   ↓
输出结果
- 具体作用:
- Q矩阵:将输入转换为查询形式
- K矩阵:将输入转换为可被查询的键
- V矩阵:存储实际的信息内容
- O矩阵:将注意力机制的输出转换为所需的表示
- 在LoRA中的应用:
- LoRA主要应用在这些权重矩阵的更新上
- 对每个权重矩阵(Wq,Wk,Wv,Wo)都可以应用LoRA
# 以Q为例
原始: Q = input × Wq
LoRA: Q = input × (Wq + BA)  # B和A是低秩矩阵
- LoRA的选择性应用:
- 可以只对部分矩阵应用LoRA
- 常见组合:
- 仅Q和V
- Q、K、V全部
- Q、K、V、O全部
LORA 的作用在于ΔW\Delta WΔW
$ W_0 Q + \Delta W q$
$ W_0 K + \Delta W k$
$ W_0 V + \Delta W v$
…(代码较长已省略)
import numpy as np
import torch
import matplotlib.pyplot as plt

# 1. 创建一个模拟的原始权重矩阵
def create_original_matrix(d=512, k=512):
    """
    创建一个模拟的原始权重矩阵
    d: 输入维度
    k: 输出维度
    """
    original_weight = torch.randn(d, k)  # 随机初始化一个权重矩阵
    return original_weight

# 2. 实现LoRA分解
class LoRALayer:
    def __init__(self, d, k, r):
        """
        d: 输入维度
        k: 输出维度
        r: LoRA秩 (rank)
        """
        self.d = d
        self.k = k
        self.r = r

        # 初始化A和B矩阵
        self.lora_A = torch.randn(d, r) / np.sqrt(r)  # 缩放初始化
        self.lora_B = torch.zeros(r, k)  # B初始化为0

        # 使其需要梯度
        self.lora_A.requires_grad_(True)
        self.lora_B.requires_grad_(True)

    def forward(self, x):
        """前向传播"""
        return (self.lora_A @ self.lora_B) @ x

    def get_weight_update(self):
        """获取权重更新矩阵"""
        return self.lora_A @ self.lora_B

# 3. 演示训练过程
def train_lora(original_weight, lora_layer, num_iterations=1000):
    """
    训练LoRA来近似原始权重矩阵
    Adam是一种优化器,用于更新模型参数
    [lora_layer.lora_A, lora_layer.lora_B]指定需要优化的参数
    lr=0.01是学习率,控制每次更新的步长
    优化器的作用是根据梯度更新A和B矩阵,使得BA的乘积逐渐接近原始权重矩阵
    """
    optimizer = torch.optim.Adam([lora_layer.lora_A, lora_layer.lora_B], lr=0.01)
    losses = []

    for i in range(num_iterations):
        # 计算当前LoRA权重
        current_weight = lora_layer.get_weight_update()

        # 计算与原始权重的差异
        # 计算当前LoRA权重与原始权重的差异
        # 使用均方误差损失函数(MSE)来衡量差异
        # 损失函数越小,表示当前LoRA权重越接近原始权重
        loss = torch.nn.functional.mse_loss(current_weight, original_weight)

        # 反向传播
        optimizer.zero_grad()  # 清除之前的梯度
        loss.backward()       # 计算梯度
        optimizer.step()      # 根据梯度更新参数

        if i % 100 == 0:
            losses.append(loss.item())
            print(f"Iteration {i}, Loss: {loss.item():.6f}")

    return losses

# 4. 可视化结果
# 修改可视化函数
def visualize_results(original_weight, lora_approximation, losses):
    plt.figure(figsize=(15, 5))

    # 绘制损失曲线
    plt.subplot(131)
    plt.plot(losses)
    plt.title('Training Loss')
    plt.xlabel('Iterations (x100)')
    plt.ylabel('MSE Loss')

    # 绘制原始权重矩阵
    plt.subplot(132)
    plt.imshow(original_weight.detach().numpy(), cmap='viridis')
    plt.title('Original Weight Matrix')
    plt.colorbar()

    # 绘制LoRA近似后的矩阵
    plt.subplot(133)
    plt.imshow(lora_approximation.detach().numpy(), cmap='viridis')
    plt.title('LoRA Approximation')
    plt.colorbar()

    plt.tight_layout()
    plt.show()

    # 打印矩阵数值
    print("\n原始权重矩阵的一部分(5x5):")
    print(original_weight.detach().numpy()[:5, :5])

    print("\nLoRA近似后的矩阵的一部分(5x5):")
    print(lora_approximation.detach().numpy()[:5, :5])

    # 计算误差矩阵
    error_matrix = original_weight.detach().numpy() - lora_approximation.detach().numpy()
    print("\n误差矩阵的一部分(5x5):")
    print(error_matrix[:5, :5])

    # 计算一些统计指标
    print("\n统计指标:")
    print(f"最大误差: {np.abs(error_matrix).max():.6f}")
    print(f"平均误差: {np.abs(error_matrix).mean():.6f}")
    print(f"误差标准差: {np.abs(error_matrix).std():.6f}")

    # 计算相似度
    from scipy.stats import pearsonr
    orig_flat = original_weight.detach().numpy().flatten()
    lora_flat = lora_approximation.detach().numpy().flatten()
    correlation, _ = pearsonr(orig_flat, lora_flat)
    print(f"矩阵相似度(相关系数): {correlation:.6f}")

# 5. 主函数
def main():
    # 设置维度
    d, k = 10, 10  # 使用较小的维度便于演示
    r = 2  # LoRA秩

    # 创建原始权重
    original_weight = create_original_matrix(d, k)

    # 创建LoRA层
    lora_layer = LoRALayer(d, k, r)

    # 训练LoRA
    losses = train_lora(original_weight, lora_layer)

    # 获取最终的LoRA近似
    final_approximation = lora_layer.get_weight_update()

    # 计算参数量的节省
    original_params = d * k
    lora_params = r * (d + k)
    reduction = (1 - lora_params/original_params) * 100

    print(f"\n原始参数量: {original_params}")
    print(f"LoRA参数量: {lora_params}")
    print(f"参数减少: {reduction:.2f}%")

    # 可视化结果
    visualize_results(original_weight, final_approximation, losses)

if __name__ == "__main__":
    main()

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献3条内容

所有评论(0)