AMSFusion:一种基于注意力机制的自适应多尺度红外与可见光图像融合网络
AMSFusion:一种基于注意力机制的自适应多尺度红外与可见光图像融合网络
AMSFusion: An Adaptive Multi-Scale Infrared and Visible Image Fusion Network Based on Attention Mechanisms
作者:Qimin Yang, Kan Ren, and Qian Chen
发表期刊:IEEE Transactions on Circuits and Systems for Video Technology
论文地址:https://ieeexplore.ieee.org/document/11114909
摘要
图像融合的目标是生成一幅新图像,该图像能整合源图像中的所有高质量特征,例如红外图像的显著特征与可见光图像的纹理细节。现有图像融合方法主要侧重于深度特征提取,往往忽视了浅层特征的重要性。此外,严重依赖人工干预的融合策略可能导致特征信息丢失,并限制深度学习性能。为解决这些问题,本文提出一种基于注意力机制的自适应多尺度融合网络,命名为AMSFusion。该方法的自编码器部分基于U-Net架构,设计了不同模块分别处理浅层和深层多尺度特征,从而在保证计算效率的同时提升特征处理质量。融合网络部分采用通道-空间注意力块(CSA)为异质特征分配合理权重,并引入移位窗口注意力与卷积混合Transformer(SWACmixT)进行特征融合,增强网络对不同尺度特征的自适应融合能力。在实现过程中,自编码器与融合网络分开训练,且各自采用独特的损失函数,进一步提升了该方法在特征编码、解码及融合方面的性能。在多个数据集上进行的定性和定量实验表明,该方法相较于当前主流算法具有明显优势。此外,在目标检测任务上的实验验证了该方法能有效促进高层计算机视觉任务的性能提升。
关键词:红外与可见光图像融合;深度学习;自编码器;注意力机制;自适应融合
1 引言
图像融合(Image Fusion)是一种借助硬件设备或软件算法,整合来自不同图像的信息,以生成内容质量更优的新图像的技术。近年来,红外与可见光图像采集设备在军事侦察、安防监控、火灾预警系统等领域的应用日益广泛,这使得红外与可见光图像融合技术的应用场景也随之不断拓展。
红外图像与可见光图像是两类具有高度互补性的常见图像。其中,可见光图像通常包含丰富的细节信息和高对比度,但在光照条件不佳的环境下难以获取;而红外图像依靠物体自身发射的热辐射成像,能够有效规避低光照带来的成像难题,不过其生成的图像可能缺乏景深和细致的纹理信息。因此,通过图像融合技术,可充分发挥两类图像的优势,为用户提供更全面的场景信息。
当前的红外与可见光图像融合技术大致可分为两类:传统融合方法与基于深度学习的融合方法。在深度学习技术成熟之前,传统方法一直是该领域的主流。根据理论基础的不同,传统方法可进一步细分为:基于多尺度变换的方法[1,2,3,4]、基于稀疏表示的方法[5,6,7]以及基于子空间的方法[8,9,10]。传统方法构建过程简便,且通过在特征提取与融合设计环节引入人工干预,能够快速适配特定的融合需求,因此在工业应用中仍具有一定的实用价值。
尽管传统方法在计算效率和实现简便性方面具备优势,但仍面临诸多挑战,例如过度依赖人工设计的融合策略,且难以妥善处理多模态图像特征之间的差异。随着深度学习技术的逐步发展,这些局限性在一定程度上得到了缓解。Liu等人[11]首次将卷积神经网络(CNN)引入红外与可见光图像融合任务,标志着深度学习在该领域应用的开端。目前,基于深度学习的融合方法主要分为四类:基于卷积神经网络(CNN)的方法、基于自编码器(AE)的方法、基于生成对抗网络(GAN)的方法以及基于Transformer的方法。
在发展初期,由于卷积神经网络(CNN)具备高效的处理性能和简洁的架构,基于深度学习的融合方法在骨干网络设计上主要依赖CNN,且在多数融合任务中取得了优异的效果。近年来,随着Transformer技术的不断演进,其在红外与可见光图像融合领域的应用也愈发广泛。视觉Transformer(Vision Transformer)在提取全局特征信息方面表现突出,能够克服CNN在感受野上的局限性,但代价是计算开销显著增加。因此,实现CNN与Transformer的有效结合,已成为红外与可见光图像融合技术发展的重要方向。
本文提出一种基于注意力机制的自适应多尺度融合网络,命名为AMSFusion。该方法的设计初衷是构建一个自编码器网络,在尽可能保证较高计算效率的同时,优先提升融合性能。为实现这一目标,本文设计了一个类U-Net结构的模型,采用不同的模块分别处理浅层特征和深层特征,以应对多尺度信息。这种设计在确保高质量特征提取的同时,降低了计算复杂度。此外,本文还构建了一个自适应融合网络,该网络利用通道-空间注意力块(CSA)为异质特征分配权重,并通过自注意力机制对这些特征进行整合。这种方式减少了融合策略设计过程中的人工干预,从而提升了模型的泛化能力。
整体模型采用两阶段训练策略,为自编码器和融合网络分别设计了独特的损失函数,以确保它们在特征处理过程中各自发挥应有的作用。如图1所示,本文方法得到的融合结果成功保留了红外图像中墙体的显著特征,以及可见光图像中树木的纹理细节。
本文的主要贡献可概括为以下四个方面:
- 在自编码器中,设计了双分支Transformer-Dense模块用于提取小尺度深层特征。该模块通过DenseNet分支提升局部特征的传递与复用效率,同时借助Swin Transformer分支确保全局特征和长距离依赖关系的高效提取。通过将双分支的编码结果沿通道维度进行拼接,该模块在降采样过程中提升了模型对小尺度特征的处理能力。
- 提出一种可学习的自适应特征融合网络。该网络利用通道-空间注意力块(CSA)为红外特征和可见光特征分配不同的通道连接权重,随后通过移位窗口注意力与卷积混合Transformer(SWACmixT)对加权后的连接特征进行融合。该网络能为不同尺度下的红外特征和可见光特征分配合理的融合权重,同时高效整合CNN的编码优势与自注意力机制的优势。与传统融合策略相比,该网络能更有效地保留红外图像的显著性特征和可见光图像的纹理细节。
- 引入两阶段训练策略,并为融合网络的训练设计了一种新的损失函数。该损失函数在图像内容层面对全局亮度和纹理进行约束,在特征层面对结构信息和显著性信息进行约束,从而提升了网络在红外与可见光特征融合过程中整合亮度、细节、结构及显著性信息的能力。
本文其余部分的结构安排如下:第2节对相关工作进行综述;第3节详细阐述所提出的AMSFusion算法;第4节对实验结果进行详细分析;最后,第5节对本文工作进行总结。
二、相关工作
在本节中,我们对现有的基于深度学习的图像融合方法进行分类与介绍。
A. 基于卷积神经网络(CNNs)的融合方法
基于卷积神经网络的图像融合主要方法需应对三大核心挑战,即特征提取、融合与重建。损失函数与网络结构的设计至关重要,因为这两者均会对融合性能产生显著影响。IFCNN[12]采用全卷积端到端训练方法,省去了大量后处理步骤,但其较浅的网络结构与人工定义的融合规则限制了融合质量。U2Fusion[13]解决了灾难性遗忘、存储及计算方面的问题,能够通过单一模型完成多项任务,然而其基于自适应梯度的损失函数无法充分捕捉不同融合子任务的重要性。为提升可解释性,AUIF[14]利用神经网络分离低频基础信息与高频细节信息,但其融合过程未能有效平衡低频分量与高频分量的权重。SeAFusion[15]针对高级视觉任务提出了一种轻量化、语义感知的融合框架,该框架借助梯度残差密集块改善细粒度特征表示,不过其优异性能主要在语义丰富的场景中有效。SCGAFusion[16]采用分组卷积注意力块,同时捕捉局部特征与长距离依赖关系,但其对多个注意力模块的依赖导致计算成本较高。尽管基于卷积神经网络的融合方法能有效保留局部细节、对比度与强度,却无法跨模态提取深层次的全局依赖关系;此外,其简单的网络结构还常常导致模型过拟合,泛化能力欠佳。
B. 基于自动编码器(AE)的融合方法
基于自动编码器(AE)的方法通过编码器进行特征提取,采用人工设计或可学习的融合策略,并借助解码器重建融合图像。自动编码器具有结构简单、灵活性高且易于构建的特点。
DenseFuse[17]与UNFusion[18]均采用密集连接的方式,整合各层的特征编码结果,以避免中间信息丢失。其中,UNFusion通过引入多尺度编码,将不同尺度的特征融入融合层,性能更优。然而,这两种方法采用的人工设计融合策略限制了性能提升,且在训练过程中均未考虑红外图像与可见光图像特征编码的差异。
SEDRFuse[19]与MTDFusion[20]分别通过注意力图和多层三重密集网络改善细节表示,但在融合过程中,两者均未能对不同来源的特征进行有效加权。RFN-Nest[21]将NestFuse[22]中人工设计的融合模块替换为可学习的残差融合网络,不过其多级融合模块大幅增加了计算成本。
CS2Fusion[23]利用补偿感知网络捕捉红外图像相对于可见光图像的互补特征,实现了互补信息的有效整合,但其特征映射过程受限于DeVries等人[24]提出的增强技术。MPCFusion[25]中的并行交叉注意力与跨域注意力模块,能有效保留浅层和深层特征中的纹理细节与边缘信息,然而该方法因过度关注纹理细节,导致对显著目标的保留有所忽视。
BTSFusion[26]提出了一种新颖的训练机制,将传统融合方法用作损失函数。通过整合引导滤波(Guided Filter)与潜在低秩表示(Latent Low-Rank Representation),该方法实现了纹理与显著性保留的有效平衡,未来研究需对网络结构进行优化,使其与所提出的损失函数更适配。
为减轻复杂场景中的噪声干扰,LiMFusion[27]提出了一种结合传统分解策略与注意力机制的融合方法,提升了感兴趣区域的信息保留效果,但该模型的计算复杂度较高,需进一步研究网络结构的轻量化设计。
总体而言,基于自动编码器的融合方法通常需通过复杂的网络结构和多轮训练迭代来提升融合性能,这也导致其训练成本与计算成本居高不下。
C. 基于生成对抗网络(GAN)的融合方法
基于生成对抗网络(GAN)的方法通过对抗学习优化模型的学习过程,在该框架中,判别器监督生成器的学习过程,以生成融合图像。
FusionGAN[28]率先将生成对抗网络应用于红外与可见光图像融合,但该方法的生成器过度强调可见光特征,而忽视了红外特征。DDcGAN[29]采用两个判别器来约束融合图像与红外图像、可见光图像的相似性,然而,平衡这两种对抗损失存在较大挑战,易导致目标特征失真。
MFEIF[30]通过密集上下文空洞网络提取多尺度特征,但在特征分解过程中未考虑特征差异,可能引发特征冗余或信息丢失问题。DCDR-GAN[31]利用自适应实例归一化,将模态特征注入到内容特征重建过程中,该方法虽减少了互斥特征的干扰,但在色彩校正与细节增强方面的性能仍有待提升。
DUGAN[32]通过双融合路径与U型判别器学习全局和局部差异,从而提升去噪性能,但其双路径设计与额外分支大幅增加了训练计算成本。GAN-GA[33]通过独特的细节编码与内容编码,对局部和全局信息进行联合建模,并借助梯度惩罚机制缓解融合结果中的强度不一致问题。尽管该模型针对红外与可见光图像融合进行了优化,但其应用范围可扩展至更广泛的多源图像融合场景。
综上,基于生成对抗网络的融合方法通过判别器对融合结果进行约束,减轻了生成器的负担。如何平衡不同类型的判别器,仍是未来该类方法实现实际应用的核心挑战。
D. 基于Transformer的融合方法
受Transformer在自然语言处理领域成功应用的启发,Alexey等人提出了视觉Transformer(Vision Transformer),为提取图像全局依赖关系提供了有效途径。近年来,基于视觉Transformer的图像融合方法迅速兴起。
例如,YDTR[34]利用动态Transformer模块捕捉局部特征与关键上下文信息,但其Y型分支在特征融合过程中,无法平衡不同来源特征的占比。基于Swin Transformer[36]的SwinFusion[35],通过跨域注意力模块实现了互补信息的有效整合与全局交互,然而,其多层Transformer结构导致运行时间较长。
类似地,DATFuse[37]基于Swin Transformer,整合了双注意力残差模块与Transformer模块,以提取局部显著特征与全局依赖关系,但在编码过程中忽视了不同来源特征之间的差异。TFIV[38]通过引入可学习的注意力权重,动态估计特征相关性,从而改善模态内与模态间的令牌(token)交互,不过该方法忽略了局部特征在图像融合中的作用。
TCCFusion[39]的双分支特征提取模块克服了感受野的局限性,有效建模了长距离依赖关系,虽然该模块能保留互补信息,但其对提取特征的精准融合能力仍有限。MMIFEMMA[40]引入了基于等变成像先验的自监督学习方法,以提升融合质量并支持下游任务,然而其特征提取与重建模块忽视了对不同尺度特征的差异化处理。
CFNet[41]采用多通道损失与基于变分自动编码器的图像压缩技术,在压缩过程中保持融合质量并减少冗余,未来研究需整合更多特征级语义信息,以提升融合图像的语义完整性。
综上,基于Transformer的融合方法在提取全局深层特征方面表现优异,但存在计算成本高的问题。未来研究将聚焦于在保持处理效率的同时降低计算复杂度。
三、方法(METHOD)
在本节中,我们将详细介绍AMSFusion(自适应多尺度融合模型)。首先,对红外与可见光图像融合任务进行简要拆解;其次,分析AMSFusion的网络结构;最后,深入阐述所设计的损失函数。
A. 问题建模(Problem Formulation)
给定一对已配准的红外图像IirI_{ir}Iir和可见光图像IviI_{vi}Ivi,本文的目标是利用模型从IirI_{ir}Iir和IviI_{vi}Ivi中提取充足的图像特征,并将这些特征融合以生成融合图像IfI_fIf。
首先,编码器EEE从源图像中提取特征:
{Fir1,…,FirN}=Eir(Iir)(1)\{F_{ir}^1, \dots, F_{ir}^N\} = E_{ir}(I_{ir}) \tag{1}{Fir1,…,FirN}=Eir(Iir)(1)
{Fvi1,…,FviN}=Evi(Ivi)(2)\{F_{vi}^1, \dots, F_{vi}^N\} = E_{vi}(I_{vi}) \tag{2}{Fvi1,…,FviN}=Evi(Ivi)(2)
其中,EirE_{ir}Eir和EviE_{vi}Evi分别表示红外图像编码器和可见光图像编码器;FirF_{ir}Fir和FviF_{vi}Fvi分别表示提取得到的红外特征图和可见光特征图;NNN表示编码器输出的特征图数量。
随后,融合模块Φ\PhiΦ对特征进行融合:
{Ff1,…,FfN}={Φ1(Fir1,Fvi1),…,ΦN(FirN,FviN)}(3)\{F_f^1, \dots, F_f^N\} = \{\Phi^1(F_{ir}^1, F_{vi}^1), \dots, \Phi^N(F_{ir}^N, F_{vi}^N)\} \tag{3}{Ff1,…,FfN}={Φ1(Fir1,Fvi1),…,ΦN(FirN,FviN)}(3)
其中,FfF_fFf表示融合后的特征图。
最后,解码器DDD生成融合图像IfI_fIf:
If=D(Ff1,…,FfN)(4)I_f = D(F_f^1, \dots, F_f^N) \tag{4}If=D(Ff1,…,FfN)(4)
(注:文中IirI_{ir}Iir代表“infrared image”,即红外图像;IviI_{vi}Ivi代表“visible image”,即可见光图像;IfI_fIf代表“fused image”,即融合图像;FFF均表示“feature map”,即特征图;下标对应不同图像类型,上标数字表示特征图层级。)
B. 网络结构
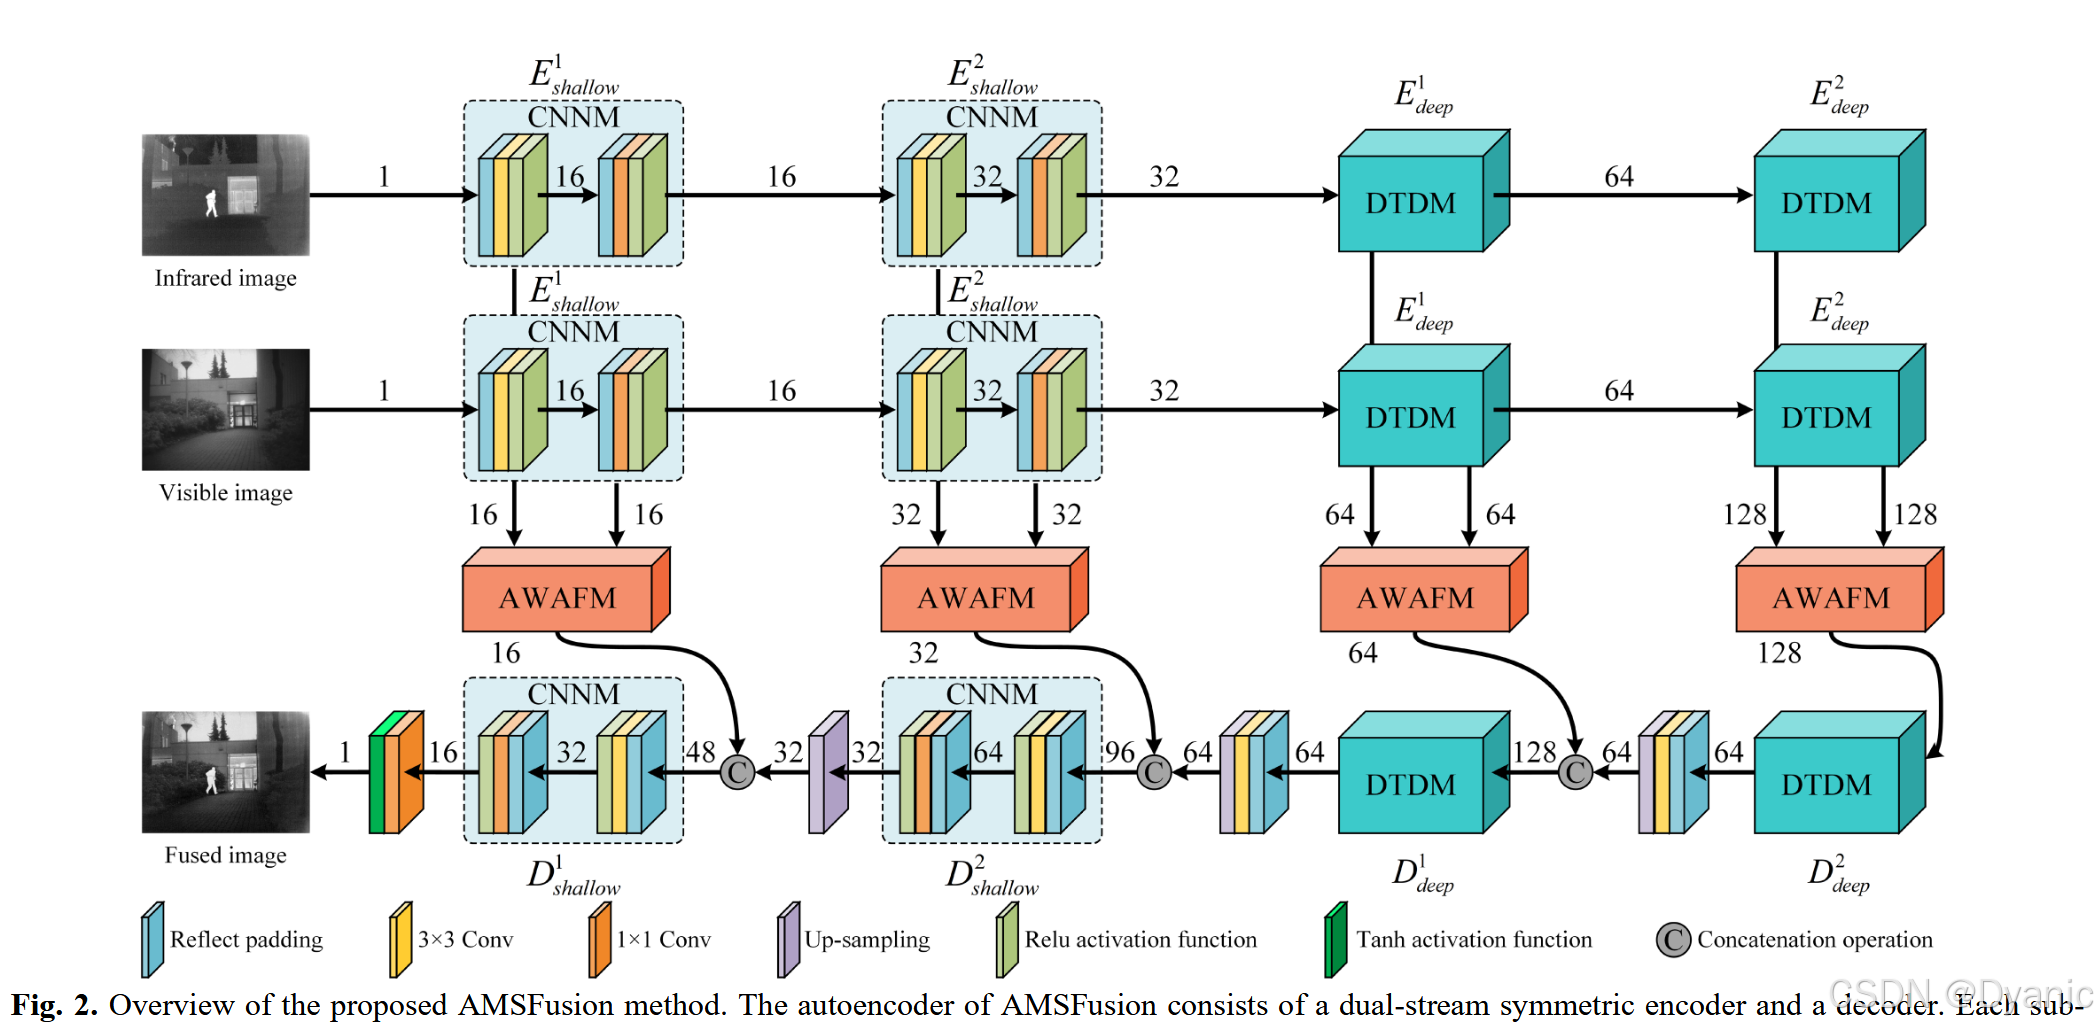
本文所提模型基于自动编码器架构构建,主要包含双流对称编码器、解码器以及融合网络三部分。整体网络结构如图2所示。
1)编码器(Encoder)
编码器的核心任务是对源红外图像和可见光图像的特征进行处理,将包含显著目标的红外信息与包含纹理细节的可见光信息转换为特征图。由于红外图像与可见光图像由不同传感器采集且包含的特征存在显著差异,因此采用双流对称编码器对两类图像分别进行编码。每个子编码器均由2个浅层特征编码模块(Eshallowi,i∈{1,2}E_{shallow}^i, i \in \{1,2\}Eshallowi,i∈{1,2})和2个深层特征编码模块(Edeepi,i∈{1,2}E_{deep}^i, i \in \{1,2\}Edeepi,i∈{1,2})构成。
如图2所示,浅层特征编码模块EshallowE_{shallow}Eshallow采用卷积神经网络模块(CNNM)提取浅层特征;深层特征编码模块EdeepE_{deep}Edeep则通过双分支特征编码模块(DTDM)实现局部与全局特征编码,该模块包含密集网络分支(EDenseE_{Dense}EDense)和Swin Transformer分支(ESwinTE_{SwinT}ESwinT),用于提取深层特征,具体结构如图3所示。
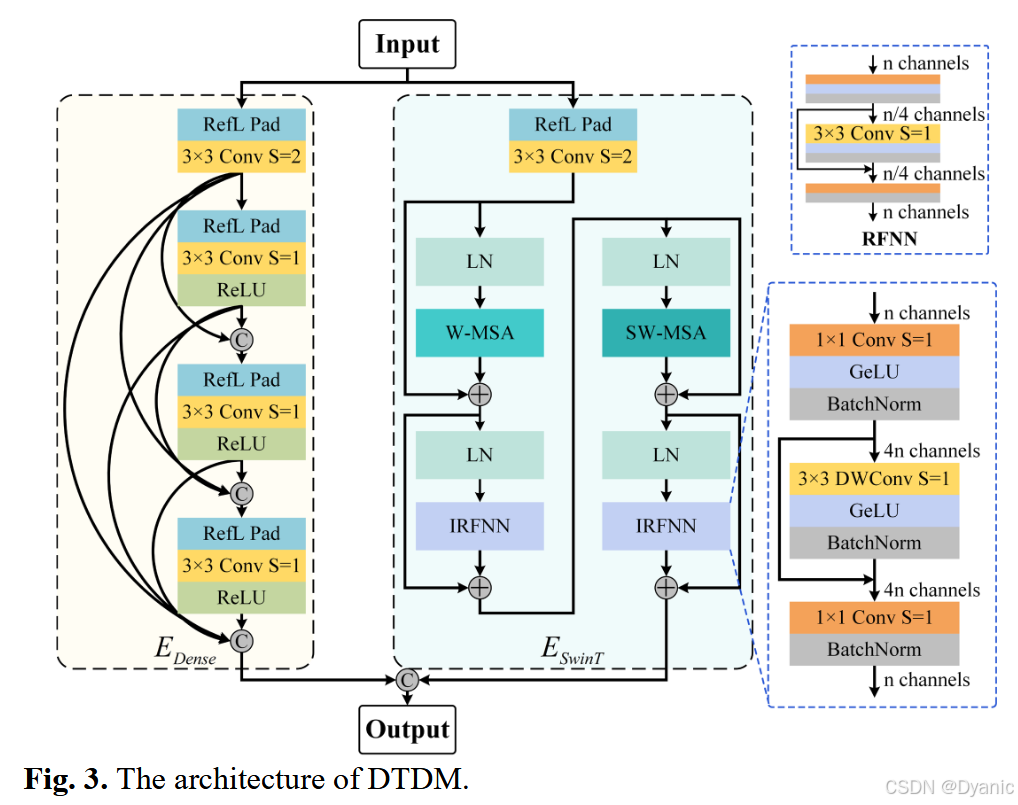
- 密集网络分支(EdenseE_{dense}Edense):主要通过密集连接增强不同层级特征间的交互与特征复用,利用卷积神经网络(CNNs)构建密集块,以捕捉特征图中的局部信息。
- Swin Transformer分支(ESwinTE_{SwinT}ESwinT):将Transformer与自注意力机制相结合,实现特征图中的全局长距离注意力建模。如图3所示,EsaiddSSE_{saiddSS}EsaiddSS采用两层Transformer编码结构,每层均包含层归一化(LN)、多头自注意力(MSA)、层归一化(LN)以及逆残差前馈网络(IRFFN)。子层之间(如LN与MSA之间)采用残差连接。为提升计算效率,第一层Transformer采用基于窗口的多头自注意力(W-MSA),第二层则采用基于移位窗口的多头自注意力(SW-MSA),以替代传统多头自注意力(MSA)。
如图3所示,逆残差前馈网络(IRFFN)与逆残差块[42]结构相似,其与传统前馈网络(RFFN)的核心差异在于通道维度的变化方式:IRFFN先提升通道数再降低通道数,而RFFN的通道数变化趋势则相反。具体而言,IRFFN采用高效深度可分离卷积(DWCNN)替代传统卷积[43]进行局部特征提取;此外,IRFFN中的跳跃连接可增强层间信息传播,避免信息丢失。IRFFN的具体计算过程如下:
P1=BN(GeLU(Conv1×1(Fin)))(5)P_1 = BN(GeLU(Conv_{1×1}(F^{in}))) \tag{5}P1=BN(GeLU(Conv1×1(Fin)))(5)
P2=P1+BN(GeLU(DWConv3×3(P1)))(6)P_2 = P_1 + BN(GeLU(DWConv_{3×3}(P_1)))\tag{6}P2=P1+BN(GeLU(DWConv3×3(P1)))(6)
Fout=BN(Conv1×1(P2))(7)F^{out} = BN(Conv_{1×1}(P_2))\tag{7}Fout=BN(Conv1×1(P2))(7)
其中,BNBNBN表示批归一化(Batch Normalization),GeLUGeLUGeLU表示高斯误差线性单元激活函数(Gaussian Error Linear Unit);Conv1×1Conv_{1×1}Conv1×1表示卷积核大小为1×1的卷积操作,DWConv3×3DWConv_{3×3}DWConv3×3表示卷积核大小为3×3的深度可分离卷积操作。
多头自注意力(MSA)是本文Transformer架构的核心组件,用于从不同角度捕捉特征信息。在自注意力机制中,查询向量(QQQ)、键向量(KKK)和值向量(VVV)的设计目标是计算输入序列中不同位置间的关联关系,进而为每个位置生成加权表示。具体而言,QQQ与KKK用于计算注意力权重(反映序列中不同位置的相关性),VVV提供每个位置的关联信息,再根据注意力权重对VVV进行加权求和,得到最终输出。注意力机制的数学定义如下:
{Q,K,V}={XWQ,XWK,XWV}(8)\{Q, K, V\} = \{XW_Q, XW_K, XW_V\} \tag{8}{Q,K,V}={XWQ,XWK,XWV}(8)
AttnFunc(Q,K,V)=Softmax(QKT/dk+B)V(9)AttnFunc(Q, K, V) = Softmax(QK^T/\sqrt{d_k} + B)V\tag{9}AttnFunc(Q,K,V)=Softmax(QKT/dk+B)V(9)
其中,X∈RM2×CX \in \mathbb{R}^{M^2×C}X∈RM2×C表示局部窗口特征(M2M^2M2为窗口内像素数,CCC为特征通道数);WQ∈RC×CW_Q \in \mathbb{R}^{C×C}WQ∈RC×C、WK∈RC×CW_K \in \mathbb{R}^{C×C}WK∈RC×C、WV∈RC×CW_V \in \mathbb{R}^{C×C}WV∈RC×C分别表示可学习权重矩阵;dkd_kdk表示键向量(KKK)的维度;BBB表示可学习相对位置编码;SoftmaxSoftmaxSoftmax表示软最大化激活函数。
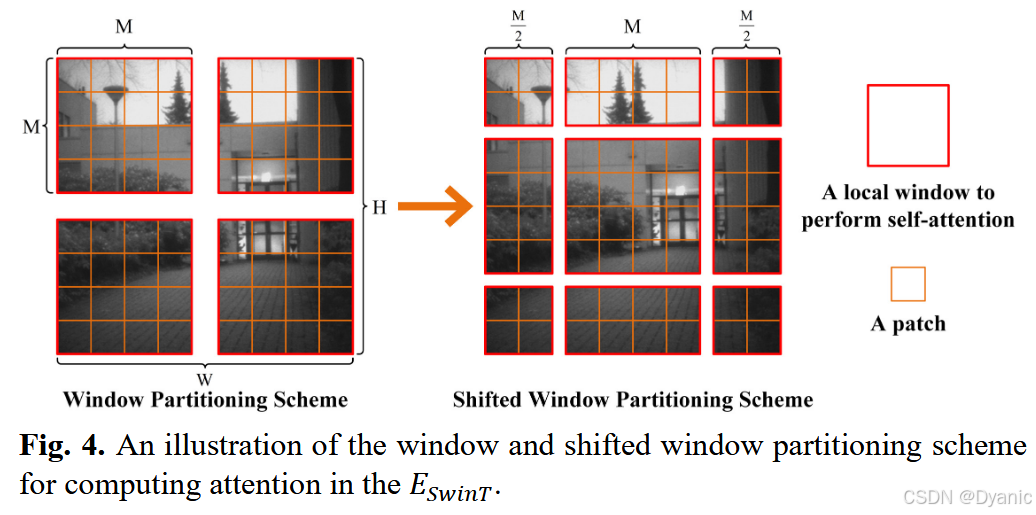
如图4所示,在窗口划分策略中,对于尺寸为H×W×CH×W×CH×W×C(HHH为高度、WWW为宽度、CCC为通道数)的特征图,窗口机制将其划分为互不重叠的M×MM×MM×M局部窗口,划分后特征图尺寸变为HWM2×M2×C\frac{HW}{M^2}\times M^2 \times CM2HW×M2×C(HWM2\frac{HW}{M^2}M2HW表示局部窗口数量),随后在每个窗口内部执行MSA操作。在移位窗口划分策略中,参考Liu等人[36]的方法,通过将窗口位置沿⌊M2,M2⌋\lfloor \frac{M}{2}, \frac{M}{2} \rfloor⌊2M,2M⌋方向移位,实现跨窗口连接。这种设计确保移位窗口层中的局部窗口包含原始窗口层中相邻区域的特征,从而建立窗口间特征的关联关系。
2)解码器(Decoder)
为提升解码器对不同深度特征的解码能力并保留浅层特征,本文基于U-Net架构设计了解码器结构。如图2所示,该结构对深层特征与浅层特征依次进行解码,最终将特征图恢复为图像。为保留前序层级的特征信息,采用通道维度拼接的方式融合不同层级的特征,并通过上采样操作将特征尺度恢复至与低层特征匹配的尺寸。由于解码器无需进行下采样,因此将解码器所有模块中第一层卷积的步长由2调整为1。
3)融合网络(Fusion Network)
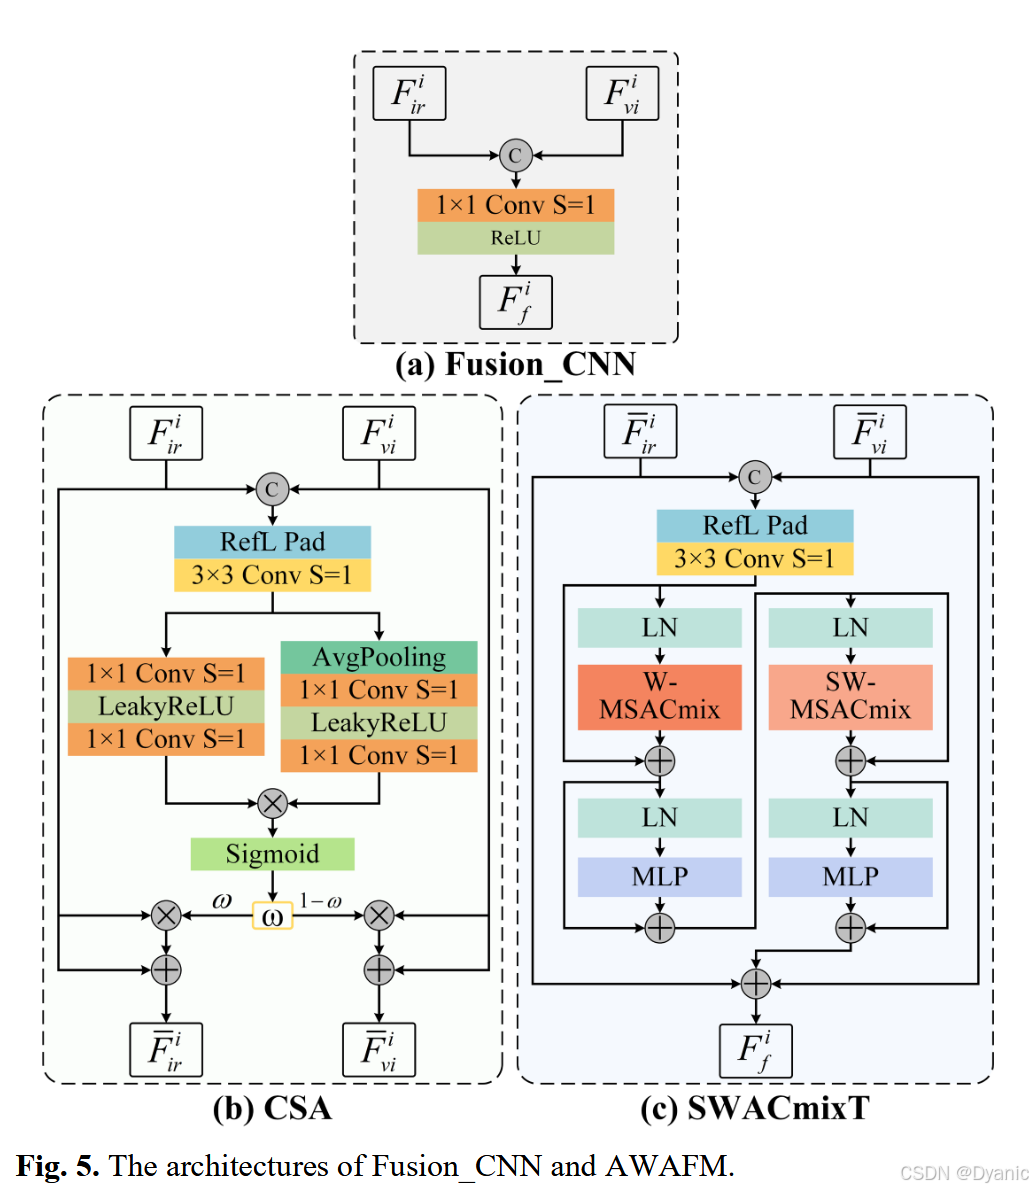
图5(a)展示了基于神经网络的基础可学习融合模块,该模块将红外特征与可见光特征沿通道维度拼接后,通过卷积神经网络进行降维,从而实现特征融合。然而,该模块存在两点不足:一是未考虑不同特征在融合结果中的占比;二是依赖卷积神经网络,难以有效编码全局特征。
针对上述问题,本文提出自适应权重注意力融合模块(AWAFM)。该模块通过通道-空间注意力(CSA)为红外特征与可见光特征分配不同权重,确保在特征拼接时二者强度比例合理;随后通过基于移位窗口的注意力-卷积混合模块(SWACmixT)对拼接后的特征进行高效融合,兼具卷积神经网络(CNN)与自注意力机制的编码优势。融合网络共包含4个AWAFM模块,分别处理不同通道维度与尺度空间下的特征融合任务。
如图5(b)所示,通道-空间注意力(CSA)利用Sigmoid函数计算通道注意力与空间注意力结果,为输入的红外特征与可见光特征分配不同权重,从而调整后续融合过程中红外图像与可见光图像信息的占比。在完成自适应权重分配后,红外特征与可见光特征被输入至SWACmixT模块进行特征融合。
如图5(c)所示,SWACmixT模块与EsaiddSSE_{saiddSS}EsaiddSS结构相近,主要改进包括:将W/SW-MSA(基于窗口/移位窗口的多头自注意力)替换为基于窗口或移位窗口的多头自注意力-卷积混合块(W/SW-MSACmix)[44],并将IRFFN(逆残差前馈网络)替换为多层感知机(MLP)。
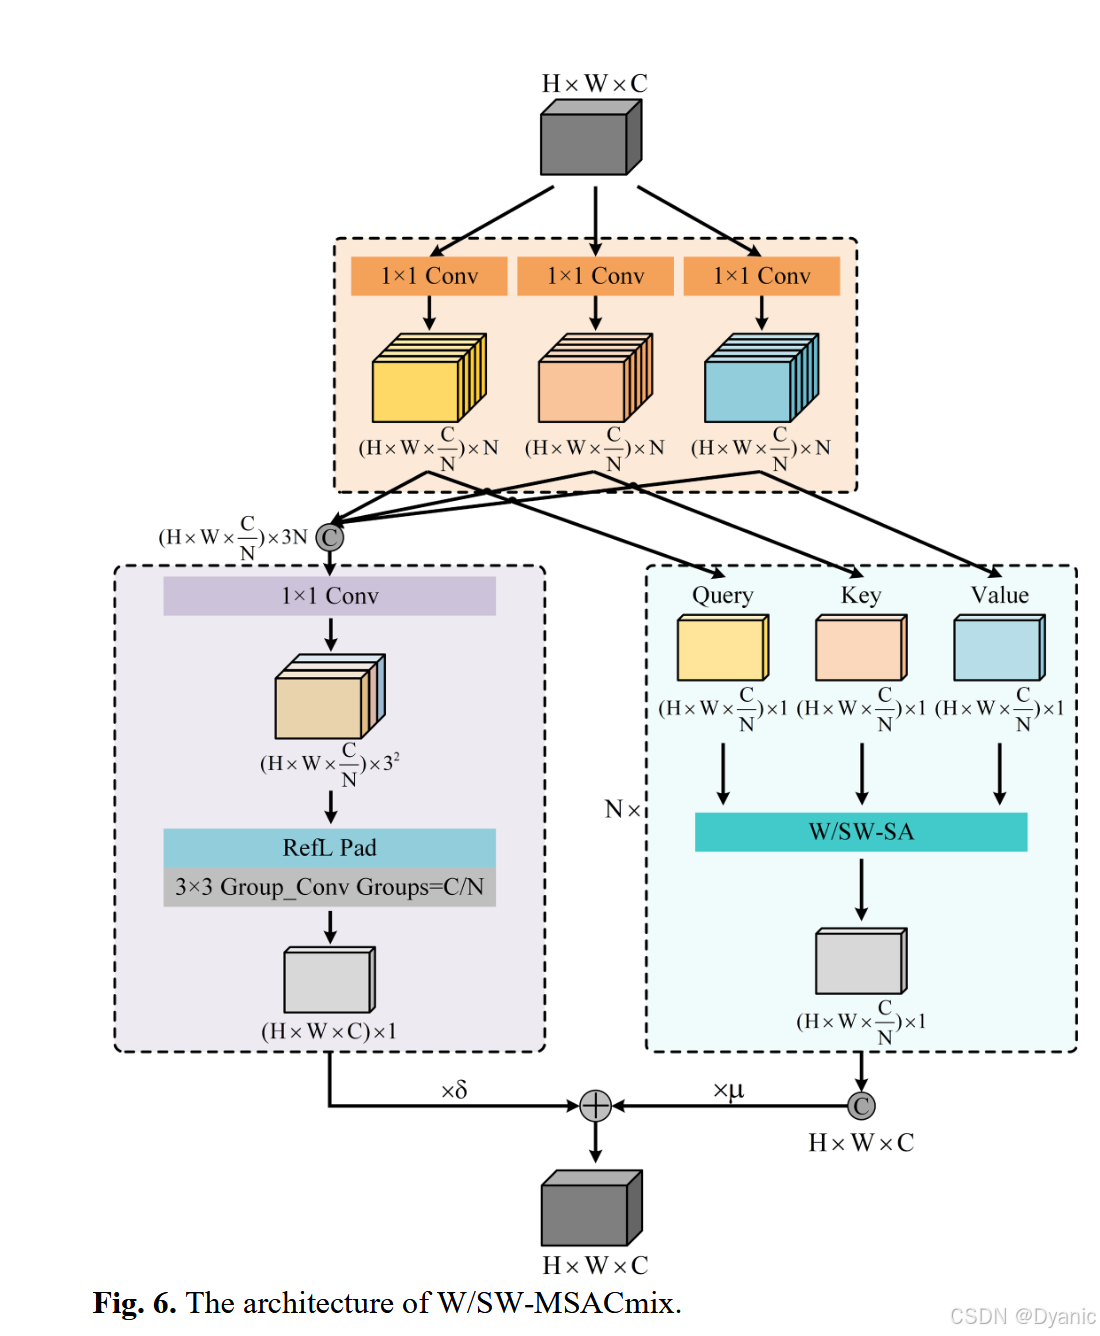
如图6所示,W/SW-MSACmix网络结构包含三个阶段:
- 第一阶段:通过3个独立的1×1卷积将输入特征通道数CCC扩展3倍,并将其划分为NNN个特征组。
- 第二阶段:包含两个并行分支:
- 卷积分支:先通过1×1卷积扩展特征通道数,得到多偏移方向的特征,再通过3×3分组卷积实现特征移位与聚合;
- 自注意力分支:将第一阶段得到的每组特征分别划分为QQQ、KKK、VVV,执行W/SW-SA(基于窗口/移位窗口的自注意力)操作,形成NNN个自注意力结构,最后将NNN组自注意力结果沿通道维度合并。
- 第三阶段:将自注意力分支与卷积分支的输出进行求和,分支权重由可学习标量控制。
该结构可高效整合卷积神经网络与W/SW-MSA的优势,在兼具局部与全局特征编码能力的同时,降低计算成本。
C. 两阶段训练策略
能否处理红外图像中的显著性信息与可见光图像中的纹理细节,直接影响融合图像的视觉质量及后续应用效果。为确保实现有效的特征提取与图像重建,本文对自动编码器与融合网络进行分开训练:第一阶段训练自动编码器以实现输入图像的重建,第二阶段训练融合网络以使其能够适配不同尺度下红外与可见光特征的融合。两阶段训练策略的具体细节如下:
1)自动编码器的训练
由于红外图像与可见光图像具有不同特征,模型需从两类图像中分别提取显著性特征与纹理细节特征。因此,本文采用双流对称编码器对红外图像与可见光图像分别进行编码。鉴于解码器需基于融合特征实现图像重建,要求解码器具备通用的图像重建能力。在自动编码器训练过程中,针对红外特征与可见光特征训练一个统一的解码器。自动编码器网络中各层的输入与输出通道配置如图2所示,网络执行过程如下:
{Fir1,Fir2,Fir3,Fir4}=Eir(Iir)(10)\{F_{ir}^1, F_{ir}^2, F_{ir}^3, F_{ir}^4\} = E_{ir}(I_{ir}) \tag{10}{Fir1,Fir2,Fir3,Fir4}=Eir(Iir)(10)
{Fvi1,Fvi2,Fvi3,Fvi4}=Evi(Ivi)(11)\{F_{vi}^1, F_{vi}^2, F_{vi}^3, F_{vi}^4\} = E_{vi}(I_{vi})\tag{11}{Fvi1,Fvi2,Fvi3,Fvi4}=Evi(Ivi)(11)
Iirre=D(Fir1,Fir2,Fir3,Fir4)(12)I_{ir}^{re} = D(F_{ir}^1, F_{ir}^2, F_{ir}^3, F_{ir}^4)\tag{12}Iirre=D(Fir1,Fir2,Fir3,Fir4)(12)
Ivire=D(Fvi1,Fvi2,Fvi3,Fvi4)(13)I_{vi}^{re} = D(F_{vi}^1, F_{vi}^2, F_{vi}^3, F_{vi}^4)\tag{13}Ivire=D(Fvi1,Fvi2,Fvi3,Fvi4)(13)
其中,{Fir1,Fir2,Fir3,Fir4}\{F_{ir}^1, F_{ir}^2, F_{ir}^3, F_{ir}^4\}{Fir1,Fir2,Fir3,Fir4}与{Fvi1,Fvi2,Fvi3,Fvi4}\{F_{vi}^1, F_{vi}^2, F_{vi}^3, F_{vi}^4\}{Fvi1,Fvi2,Fvi3,Fvi4}分别表示编码器EirE_{ir}Eir与EviE_{vi}Evi的输出特征;IirreI_{ir}^{re}Iirre与IvireI_{vi}^{re}Ivire分别表示解码器DDD利用编码特征重建得到的红外图像与可见光图像。
用于训练自动编码器的损失函数Lauto\mathcal{L}_{auto}Lauto定义如下:
Lauto=Lcont+αLdecomp(14)\mathcal{L}_{auto} = \mathcal{L}_{cont} + \alpha \mathcal{L}_{decomp} \tag{14}Lauto=Lcont+αLdecomp(14)
式中,Lcontent\mathcal{L}_{content}Lcontent表示重建图像与原始图像间的强度及结构差异损失函数,Ldecomp\mathcal{L}_{decomp}Ldecomp表示编码特征的损失函数;α\alphaα为超参数,用于平衡Lcontent\mathcal{L}_{content}Lcontent与Ldecomp\mathcal{L}_{decomp}Ldecomp的比例。
内容损失Lcontent\mathcal{L}_{content}Lcontent的定义如下:
Lcontent=Lint+βLssim(15)\mathcal{L}_{content} = \mathcal{L}_{int} + \beta \mathcal{L}_{ssim} \tag{15}Lcontent=Lint+βLssim(15)
Lint=Lintir+Lintvi(16)\mathcal{L}_{int} = \mathcal{L}_{int}^{ir} + \mathcal{L}_{int}^{vi} \tag{16}Lint=Lintir+Lintvi(16)
Lintx=1HW∥Ixout−Ix∥1(17)\mathcal{L}_{int}^x = \frac{1}{HW} \|I_{x}^{out} - I_x\|_1 \tag{17}Lintx=HW1∥Ixout−Ix∥1(17)
Lssim=2−SSIM(Iirout,Iir)−SSIM(Iviout,Ivi)(18)\mathcal{L}_{ssim} = 2 - SSIM(I_{ir}^{out}, I_{ir}) - SSIM(I_{vi}^{out}, I_{vi}) \tag{18}Lssim=2−SSIM(Iirout,Iir)−SSIM(Iviout,Ivi)(18)
SSIM(X,Y)=(2μXμY+C1)(2σXY+C2)(μX2+μY2+C1)(σX2+σY2+C2)(19)SSIM(X,Y) = \frac{(2\mu_X\mu_Y + C_1)(2\sigma_{XY} + C_2)}{(\mu_X^2 + \mu_Y^2 + C_1)(\sigma_X^2 + \sigma_Y^2 + C_2)} \tag{19}SSIM(X,Y)=(μX2+μY2+C1)(σX2+σY2+C2)(2μXμY+C1)(2σXY+C2)(19)
其中,Lint\mathcal{L}_{int}Lint用于计算重建图像的强度损失,Lssim\mathcal{L}_{ssim}Lssim用于计算图像重建后的结构相似性损失;β\betaβ为超参数,用于平衡二者比例。HHH与WWW分别表示图像的高度与宽度;IxoutI_{x}^{out}Ixout表示自动编码器基于IxI_xIx重建得到的图像;∥⋅∥1\|\cdot\|_1∥⋅∥1表示L1L_1L1范数;μ\muμ与σ\sigmaσ分别表示均值与标准差;σXY\sigma_{XY}σXY表示图像XXX与YYY间的协方差;C1C_1C1与C2C_2C2为稳定性系数。
随着编码过程的深入,提取的红外特征与可见光特征间的差异逐渐增大。Ldecomp\mathcal{L}_{decomp}Ldecomp的作用是训练编码器,使其在浅层从红外与可见光图像中提取相似特征,同时在深层能够提取具有区分度的特征。Ldecomp\mathcal{L}_{decomp}Ldecomp的计算公式如下:
Ldecomp=(CC(Fir4,Fvi4))2CC(Fir2,Fvi2)+ε(20)\mathcal{L}_{decomp}= \frac{(CC(F_{ir}^4, F_{vi}^4))^2}{CC(F_{ir}^2, F_{vi}^2) + \varepsilon} \tag{20}Ldecomp=CC(Fir2,Fvi2)+ε(CC(Fir4,Fvi4))2(20)
式中,CC(⋅,⋅)CC(\cdot,\cdot)CC(⋅,⋅)表示相关系数算子,其取值范围为[−1,1][-1,1][−1,1];ε\varepsilonε设为1.01,以确保该损失项始终为正值;FiriF_{ir}^iFiri与FviiF_{vi}^iFvii分别表示EirE_{ir}Eir与EviE_{vi}Evi中第iii个模块的输出特征。
2)融合网络的训练
自动编码器训练完成后,对融合网络进行训练,使其能够融合编码器输出的尺寸与维度相同的红外特征与可见光特征;随后,将融合特征作为解码器的输入,用于重建融合图像。融合网络需具备融合红外与可见光图像中相似特征及差异特征的能力。融合网络各模块的输入与输出通道如图2所示,其训练过程与第3.1节(III.A)所述一致。由于编码器与解码器已完成预训练,此阶段仅训练融合网络。
融合网络的损失函数Lfusion\mathcal{L}_{fusion}Lfusion设计如下:
Lfusion=Ltexture+γLstructure(21)\mathcal{L}_{fusion} = \mathcal{L}_{texture} + \gamma \mathcal{L}_{structure} \tag{21}Lfusion=Ltexture+γLstructure(21)
式中,Ltexture\mathcal{L}_{texture}Ltexture表示融合图像的强度与细节损失函数,Lstructure\mathcal{L}_{structure}Lstructure表示融合图像的显著性与结构特征损失函数;γ\gammaγ为超参数,用于平衡LtextureL_{texture}Ltexture与LstructureL_{structure}Lstructure的比例。
LtextureL_{texture}Ltexture的定义如下:
Ltexture=Lgrad+Lmse(22)\mathcal{L}_{texture} = L_{grad} + L_{mse} \tag{22}Ltexture=Lgrad+Lmse(22)
Lgrad=∥∇(If),max[∇(Iir),∇(Ivi)]∥1(23)\mathcal{L}_{grad} = \|\nabla(I_f), max[\nabla(I_{ir}), \nabla(I_{vi})]\|_1 \tag{23}Lgrad=∥∇(If),max[∇(Iir),∇(Ivi)]∥1(23)
Lmse=∥If,max[Iir,Ivi]∥2(24)\mathcal{L}_{mse} = \|I_f, max[I_{ir}, I_{vi}]\|_2 \tag{24}Lmse=∥If,max[Iir,Ivi]∥2(24)
其中,∇\nabla∇表示索贝尔算子(Sobel operator);max[⋅,⋅]max[\cdot,\cdot]max[⋅,⋅]表示逐像素最大值选择操作;∥⋅,⋅∥2\|\cdot,\cdot\|_2∥⋅,⋅∥2表示L2L_2L2范数;Lgrad\mathcal{L}_{grad}Lgrad用于训练融合网络,使其将红外图像的显著性边缘与可见光图像的纹理信息相结合;Lmse\mathcal{L}_{mse}Lmse用于在融合过程中保留红外图像与可见光图像的像素强度分布。
Lstructure\mathcal{L}_{structure}Lstructure的定义如下:
Lstructure=Lssim+Lspa(25)\mathcal{L}_{structure} = \mathcal{L}_{ssim} + \mathcal{L}_{spa} \tag{25}Lstructure=Lssim+Lspa(25)
Lssim=2−SSIM(If,Iir)−SSIM(If,Ivi)(26)\mathcal{L}_{ssim} = 2 - SSIM(I_f, I_{ir}) - SSIM(I_f, I_{vi} ) \tag{26}Lssim=2−SSIM(If,Iir)−SSIM(If,Ivi)(26)
Lspai=1M∑i=1M∑j∈Ω(i)((∣If,i−If,j∣−∣Iir,i−Iir,j∣)2+(∣If,i−If,j∣−∣Ivi,i−Ivi,j∣)2)(27)\mathcal{L}_{spai} = \frac{1}{M}\sum_{i=1}^{M}\sum_{j \in \Omega(i)} \left( (|I_{f,i} - I_{f,j}| - |I_{ir,i} - I_{ir,j}|)^2 + (|I_{f,i} - I_{f,j}| - |I_{vi,i} - I_{vi,j}|)^2 \right) \tag{27}Lspai=M1i=1∑Mj∈Ω(i)∑((∣If,i−If,j∣−∣Iir,i−Iir,j∣)2+(∣If,i−If,j∣−∣Ivi,i−Ivi,j∣)2)(27)
式中,MMM表示局部区域的数量;Ω(i)\Omega(i)Ω(i)表示以像素iii为中心的4个相邻区域;局部区域的尺寸根据经验设为4×44×44×4。Lssim\mathcal{L}_{ssim}Lssim用于训练融合特征,使其保留红外图像与可见光图像的结构特征;Lspa\mathcal{L}_{spa}Lspa用于在融合结果中保留源图像的显著性目标特征。
四、实验(EXPERIMENTS)
A. 实现细节(Implementation Details)
本实验所用数据集包括TNO[45]、RoadScene[13]、LLVIP[46]和M3FD[47]。其中,M3FD数据集既用作图像融合训练数据集,也用作目标检测数据集;为验证所提方法的泛化能力,TNO、RoadScene和LLVIP被用作图像融合测试数据集。
将M3FD数据集按8:1:1的比例随机划分为训练集、验证集和测试集,训练集用于训练所提方法,所有划分后的数据集均用于后续目标检测实验。在图像融合测试数据集方面,从每个数据集中随机选取20对图像用于测试。
所有实验均在配置为3.40GHz Core™ i7-14700KF CPU、NVIDIA GeForce RTX 4090 GPU及MATLAB R2022b的设备上进行,代码基于PyTorch平台实现。训练总轮次(epochs)设为400,其中第一阶段(自动编码器训练)为300轮,第二阶段(融合网络训练)为100轮。优化器采用Adam,学习率设为1e-5,批处理大小(batch size)为4;超参数ααα、βββ、γγγ分别设为2、10和0.1。
为避免图像裁剪对全局语义信息产生影响,所有训练图像均调整为224×224的尺寸。此外,所有输入彩色图像均转换为YCbCr格式,仅对Y通道与红外图像进行融合,最终得到融合图像。
B. 对比方法与评价指标(Comparison Methods and Evaluation Metrics)
为验证所提方法的性能,将其与12种红外与可见光图像融合领域的现有最优(SOTA)方法进行对比,包括GTF[48]、MDLatLRR[2]、EgeFusion[4]、DenseFuse[17]、IFCNN-MAX[12]、RFN-Nest[21]、MTDFusion[20]、YDTR[34]、SwinFusion[35]、DATFuse[37]、MPCFusion[25]和MMIF-EMMA[40]。所有对比方法均采用其论文中公布的默认参数进行实验。
图像融合性能评估采用领域内8项公认的质量评价指标,具体包括:熵(EN)[49]、平均梯度(AG)[50]、空间频率(SF)[51]、标准差(SD)[52]、相关差异和(SCD)[53]、总边缘信息(QAB/F)[54]、视觉信息保真度(VIF)[55]及结构相似性(SSIM)[56]。
C. TNO数据集上的实验结果(Results on the TNO Dataset)
1)定性对比(Qualitative Comparisons)
在TNO数据集上,通过两个典型场景对所提方法进行直观评估,图像中的显著目标区域与纹理细节区域分别用红色框和绿色框标记。
图7主要展示了丛林中存在烟雾遮挡的人体场景。GTF、MDLatLRR、DenseFuse、IFCNN-MAX、RFN-Nest、MTDFusion和YDTR的融合结果虽能清晰呈现人体目标,但缺乏丰富的环境细节;与之相反,SwinFusion、DATFuse和MMIF-EMMA的融合结果包含丰富环境细节,人体目标却难以识别;EgeFusion和MPCFusion虽能同时保留细节与目标,但存在明显失真。所提方法的融合结果在保证人体目标可识别性的前提下,在环境细节呈现与视觉信息保真度方面均优于其他方法。
在图8中,GTF、MDLatLRR、DenseFuse、RFN-Nest、YDTR和DATFuse的融合结果场景对比度较低;EgeFusion和MPCFusion存在一定失真;IFCNN-MAX、MTDFusion和SwinFusion的结果虽突出了人体目标,却丢失了灌木丛纹理。MMIF-EMMA与所提方法在场景对比度和灌木丛细节呈现上表现优异,但所提方法在人体目标突出度上优于MMIF-EMMA。
综上,所提方法在融合图像的视觉信息保真度、目标有效突出及环境细节保留方面均表现出较强性能。这一优势得益于所设计的深浅层特征提取网络——该网络能有效捕捉图像的浅层细节特征与深层结构特征;同时,通道-空间注意力(CSA)可对异质特征自适应分配权重,使融合结果既能保留红外图像的显著信息,又能保留可见光图像的纹理细节。
2)定量对比(Quantitative Comparisons)
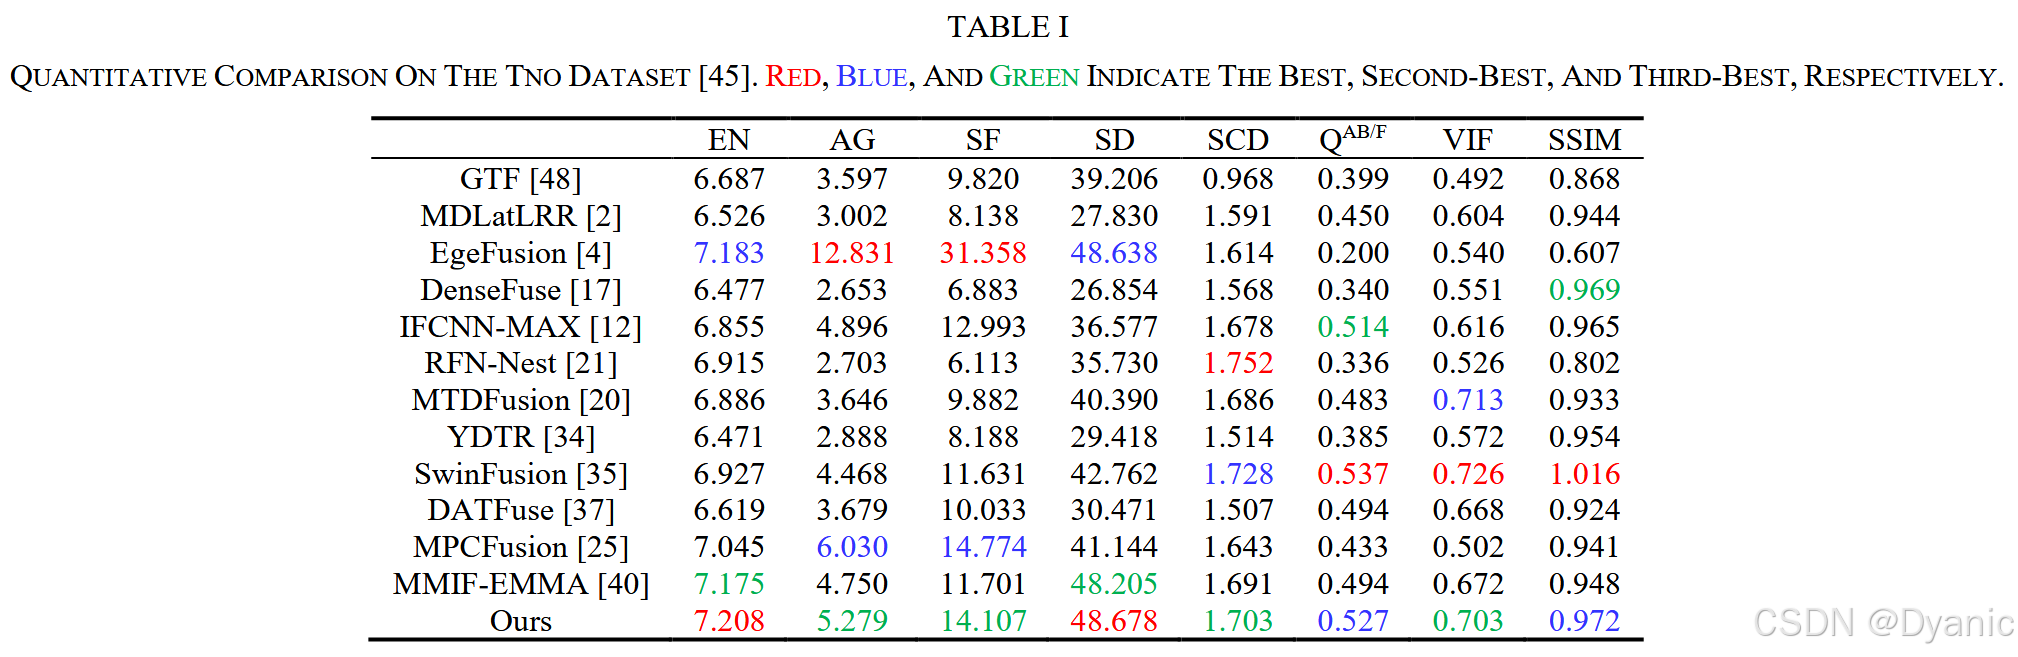
表1(TABLE I)给出了TNO数据集上的定量分析结果。所提方法在8项评价指标中均位列前三:
- 熵(EN)指标结果表明,所提方法保留了更丰富的信息,这得益于类U-Net网络结构在解码过程中能保留对称位置的特征融合信息;
- 为红外与可见光图像设计了独立的编码分支,为两类图像提供了具有针对性的编码信息,使融合结果能从两种源图像中获取高质量特征,这也解释了所提方法在平均梯度(AG)和空间频率(SF)指标上的优异表现;
- 标准差(SD)数值显示,所提方法使融合图像保持了较高对比度,在保证关键目标突出的同时提升了视觉质量,这归因于网络训练过程中采用了与强度相关的损失函数;
- 总边缘信息(QAB/F)指标结果表明,所提方法保留了源图像更多的视觉信息,这得益于网络对红外与可见光特征的自适应融合;
- 相关差异和(SCD)与视觉信息保真度(VIF)指标结果证明,所提方法在保留源图像信息与提升视觉体验方面同样表现出色;
- 结构相似性(SSIM)指标结果则体现了所提算法在保留源图像结构信息上的优势。
综上,TNO数据集的定量分析表明,所提方法满足军事与监控场景下多波段红外与可见光图像融合的需求,与其他现有最优方法相比,展现出明显的性能优势。
D. RoadScene数据集上的实验结果(Results on the RoadScene Dataset)
1)定性对比(Qualitative Comparisons)
RoadScene是一个聚焦道路场景的数据集,图9(Fig. 9)和图10(Fig. 10)分别对应该数据集中白天与夜间道路两个典型场景。
在图9(白天场景)中,GTF、MDLatLRR、DenseFuse和RFN-Nest的结果对人体与环境细节的刻画效果较差;IFCNN-MAX、YDTR、SwinFusion和DATFuse的融合结果虽提升了关键热目标的可见度,却未能保留植物的纹理细节;MPCFusion改善了场景纹理细节的丰富度,但图像对比度较低,无法充分突出关键目标;EgeFusion在环境细节与人体显著性呈现上表现较好,但视觉保真度不足;MTDFusion、MMIF-EMMA与所提模型在突出人与车辆的重要性,以及保留场景植物纹理细节与文字信息方面均表现出较强性能,但MTDFusion在细节区域存在轻微对比度问题,MMIF-EMMA的结果则在人体区域出现一定模糊。
在图10(夜间场景)中,DATFuse效果最差,不仅未解决眩光问题,还导致融合后人体背部细节严重丢失;GTF虽解决了眩光问题,但环境细节丢失严重;MDLatLRR、DenseFuse、RFN-Nest和MTDFusion缓解了眩光,却产生了低对比度问题,影响环境信息识别;YDTR、SwinFusion和MMIF-EMMA提升了图像对比度,显著改善了关键目标的可见度,但未解决眩光问题;EgeFusion和MPCFusion虽能解决眩光并有效识别环境信息,但融合图像缺乏平滑性且存在噪声;IFCNN-MAX与所提方法均能有效解决眩光问题,同时保留环境纹理;此外,所提方法在图像对比度方面表现更优,使融合图像具备更出色的视觉体验。
综上,所提方法在白天与夜间道路场景中均表现出优异性能:既能保留场景纹理细节与显著目标,又能保证融合结果的高对比度,提升场景元素的可识别性;尤其在夜间场景中,可减少因眩光导致的场景元素丢失。这一效果的实现,一方面得益于融合网络的损失函数在训练过程中对纹理细节与结构特征的约束,确保场景各区域元素的高可识别性;另一方面借助红外图像的抗干扰特性,有效减轻了眩光的影响。
2)定量对比(Quantitative Comparisons)
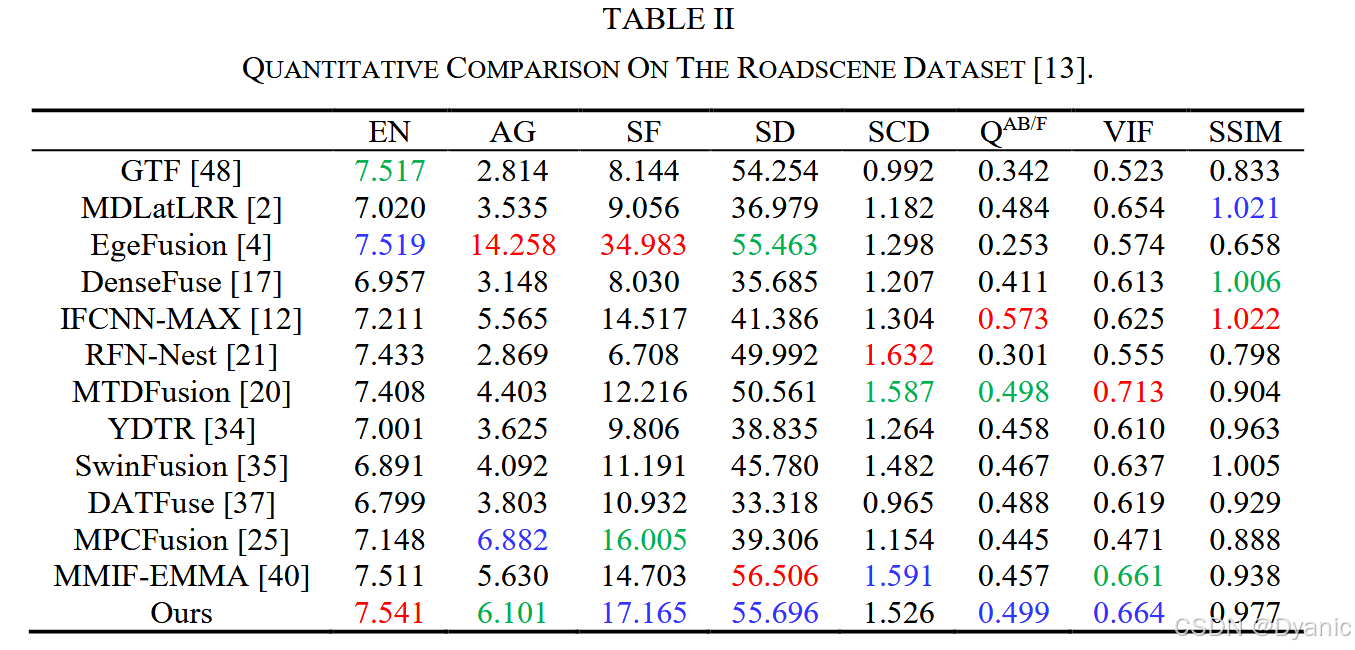
表2(TABLE II)给出了RoadScene数据集的定量分析结果,所提方法在6项评价指标中位列前三。与TNO数据集相比,所提模型在空间频率(SF)和视觉信息保真度(VIF)指标上的排名有所提升。这一成绩得益于网络训练过程中,损失函数对图像强度、显著性及结构特征的约束,同时通过合理设置超参数,有效平衡了细节损失(Ldetail)与显著性损失(Lsalient),从而解决了RoadScene数据集中夜间眩光场景的融合难题——在保留眩光区域元素的同时,增强了该区域物体的结构与纹理,显著提升了视觉体验。
尽管所提方法在相关差异和(SCD)与结构相似性(SSIM)指标上未达到最优,但仍处于中上游水平,满足对光谱特性与结构特性的常规要求。RoadScene数据集的实验结果最终表明,所提方法适用于白天与夜间的道路场景图像融合任务。
E. LLVIP数据集上的实验结果
1)定性对比
在LLVIP数据集上,选取两组具有代表性的测试图像进行展示。图11(Fig. 11)和图12(Fig. 12)分别对应夜间正常光照和低光照条件下的道路场景。
在图11中,MDLatLRR、DenseFuse、RFN-Nest、MTDFusion、DATFuse和MPCFusion在低光照区域车辆的呈现效果较差;GTF和YDTR虽改善了车辆细节与对比度,却丢失了行人与路面细节;EgeFusion、IFCNN-MAX、SwinFusion、MMIF-EMMA及所提方法能够平衡阴影区域与明亮区域的目标细节及显著性,但IFCNN-MAX和SwinFusion在人行道细节的呈现上,性能不及EgeFusion、MMIF-EMMA与所提方法。
在图12中,GTF、DenseFuse、MTDFusion、YDTR、DATFuse和MMIF-EMMA对人行道信息的保留效果较差,导致纹理大量丢失;MDLatLRR、IFCNN-MAX、RFN-Nest和MPCFusion虽保留了可见的地面纹理,但受阴影区域影响,人物呈现模糊或对比度偏低;EgeFusion、SwinFusion与所提方法在显著性与场景细节呈现上均表现优异,不过EgeFusion在细节丰富度上优于SwinFusion与所提方法。
综上,所提方法有效利用红外图像的抗干扰特性,为阴影区域提供了显著的目标信息;同时,在光照区域捕捉可见光图像的纹理细节,呈现出车辆、人物、路面等环境元素的细致特征。
2)定量对比
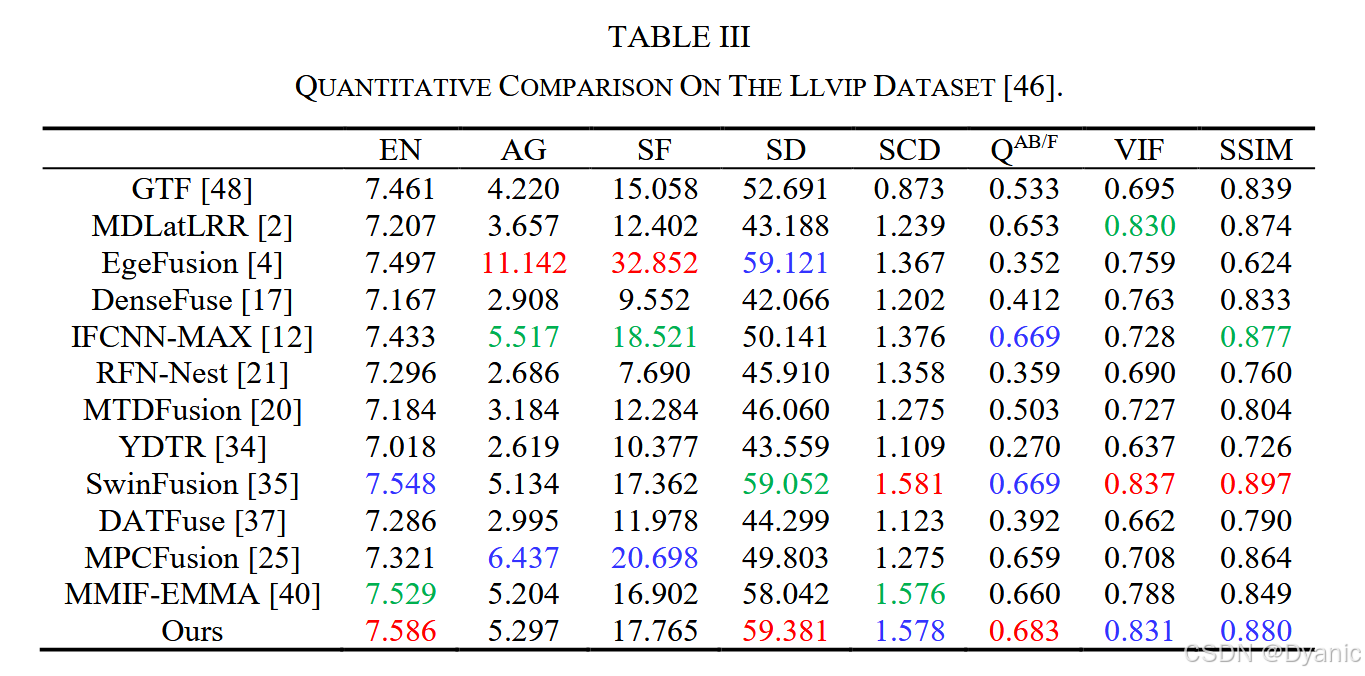
LLVIP数据集上的定量分析结果如表3(TABLE III)所示。所提方法在6项指标中均位列前两名:具体而言,熵(EN)、标准差(SD)、相关差异和(SCD)、总边缘信息(QAB/F)、视觉信息保真度(VIF)及结构相似性(SSIM)指标结果表明,所提方法在保留源图像充足原始特征的同时,提供了最佳的视觉体验。尽管平均梯度(AG)和空间频率(SF)指标结果并非最优,但仍处于中上游水平,说明所提模型在纹理细节保留方面表现依旧良好。
综上,实验结果表明,所提方法适用于光照变化显著的夜间场景图像融合任务,融合结果能有效突出关键目标信息,适合人眼视觉观察。
F. 消融实验
1)自动编码器分析
如图13(Fig. 13)所示,若将卷积神经网络模块(CNNM)完全替换为双分支特征编码模块(DTDM),纹理细节性能会显著下降,这是因为DTDM对局部浅层特征的编码效果较差;反之,若将DTDM完全替换为CNNM,对比度性能会降至最差,原因是CNNM难以对全局特征进行编码。这些变化与表4(TABLE IV)中的指标变化一致。
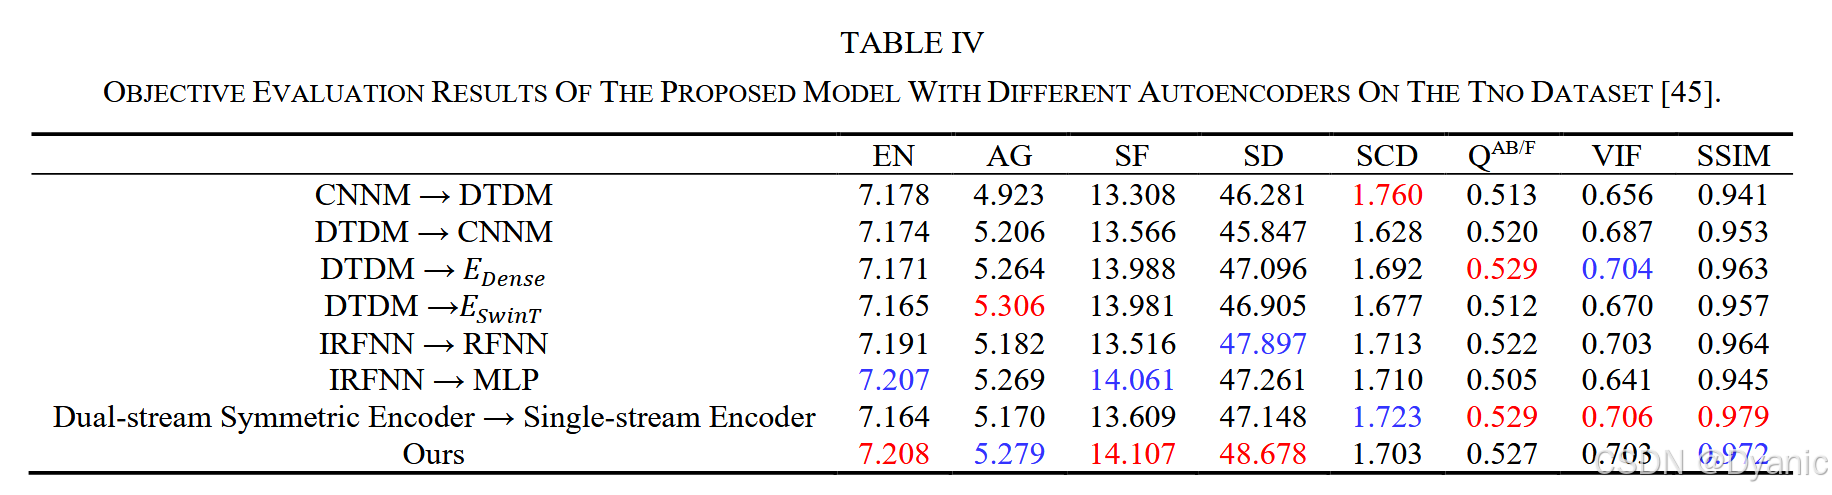
当DTDM仅保留密集网络分支(EddssE_{ddss}Eddss)时,其视觉效果与最终模型的差异较小,但如表4所示,多数指标出现下降,仅总边缘信息(QAB/F)和视觉信息保真度(VIF)略有提升;若仅保留Swin Transformer分支(EsaiddSSE_{saiddSS}EsaiddSS),虽能改善细节区域的融合效果,但关键区域的显著性会降低。
在EsaiddSSE_{saiddSS}EsaiddSS中,若将图3(Fig. 3)中的逆残差前馈网络(IRFFN)替换为传统前馈网络(RFNN),会导致细节与显著性特征减少;若将IRFFN替换为多层感知机(MLP),虽能提升显著性,但因引入过多红外特征,会降低视觉保真度。
若采用单流编码器,模型融合结果在围栏显著性方面有所提升,保留了更多红外图像信息,但场景细节性能下降——这是因为依赖单一编码器难以实现红外与可见光特征的均衡编码。如表4所示,与上述各类模型相比,最终模型在5项指标中取得最优结果,总边缘信息(QAB/F)和视觉信息保真度(VIF)也接近最优水平。定性与定量结果均证实了所提自动编码器结构设计的必要性。
2)融合网络分析
如图14(Fig. 14)所示,可学习融合网络在人体显著性保留方面优于人工融合方法,但在图像对比度上表现稍差;人工融合方法在地面植被区域保留了过多红外特征,导致细节丢失,视觉效果欠佳。
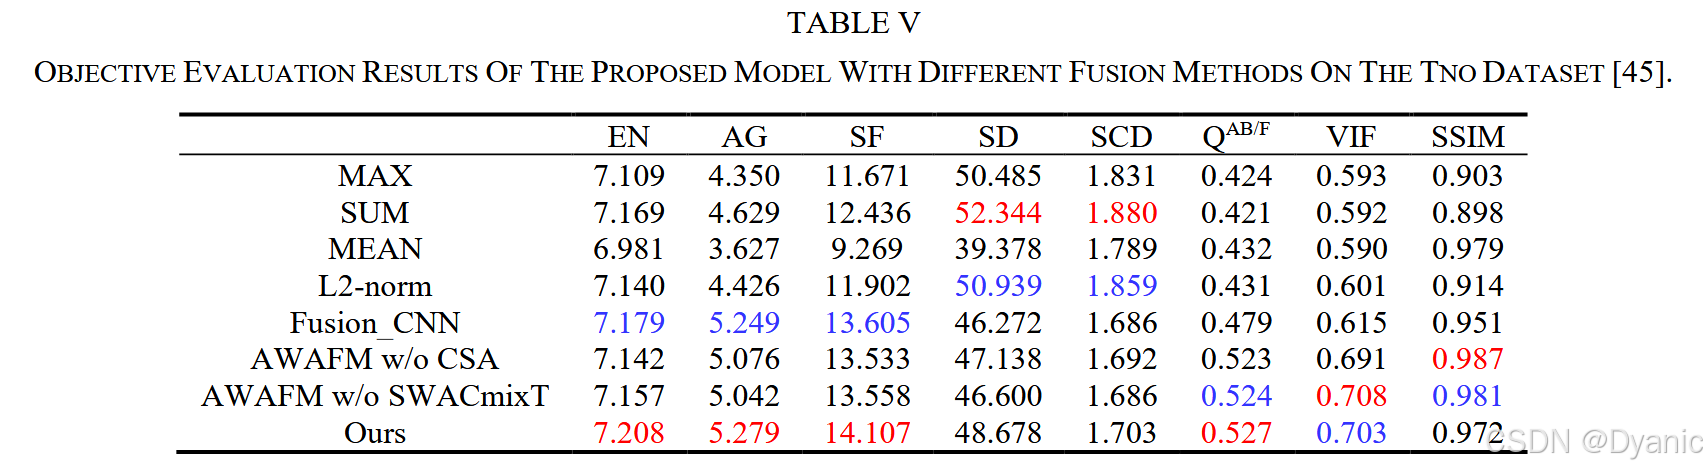
表5(TABLE V)显示,最大值(max)、求和(sum)及L2范数(L2-norm)等人工融合方法在标准差(SD)和相关差异和(SCD)指标上表现较好,但在平均梯度(AG)、空间频率(SF)、总边缘信息(QAB/F)和视觉信息保真度(VIF)指标上落后于可学习融合网络。
与图5(a)(Fig. 5(a))中的卷积融合模块(Fusion_CNN)相比,所提融合网络在环境细节保留方面表现更优,同时保持了相近的关键热目标显著性。如图14所示,若自适应权重注意力融合模块(AWAFM)未采用通道-空间注意力(CSA)进行特征权重分配,或未采用基于移位窗口的注意力-卷积混合模块(SWACmixT)进行特征融合,虽不会显著降低显著性信息的保留能力,但会削弱纹理细节与全局对比度。表5结果显示,缺少CSA或SWACmixT的AWAFM在平均梯度(AG)、空间频率(SF)和标准差(SD)指标上均出现显著下降,与图14中的结论一致。
SWACmixT整合了卷积神经网络(CNN)与自注意力机制的优势,在全局特征编码方面性能优于CNN,因此,缺少SWACmixT的AWAFM在全局对比度上的下降更为明显。
3)损失函数分析
由于自动编码器与融合网络采用独立训练方式,且使用不同的损失函数,因此在针对自动编码器损失函数(LautoL_{auto}Lauto)的消融实验中,固定融合网络损失函数(LfusionL_{fusion}Lfusion)的超参数;在针对LfusionL_{fusion}Lfusion的消融实验中,固定LautoL_{auto}Lauto的超参数。
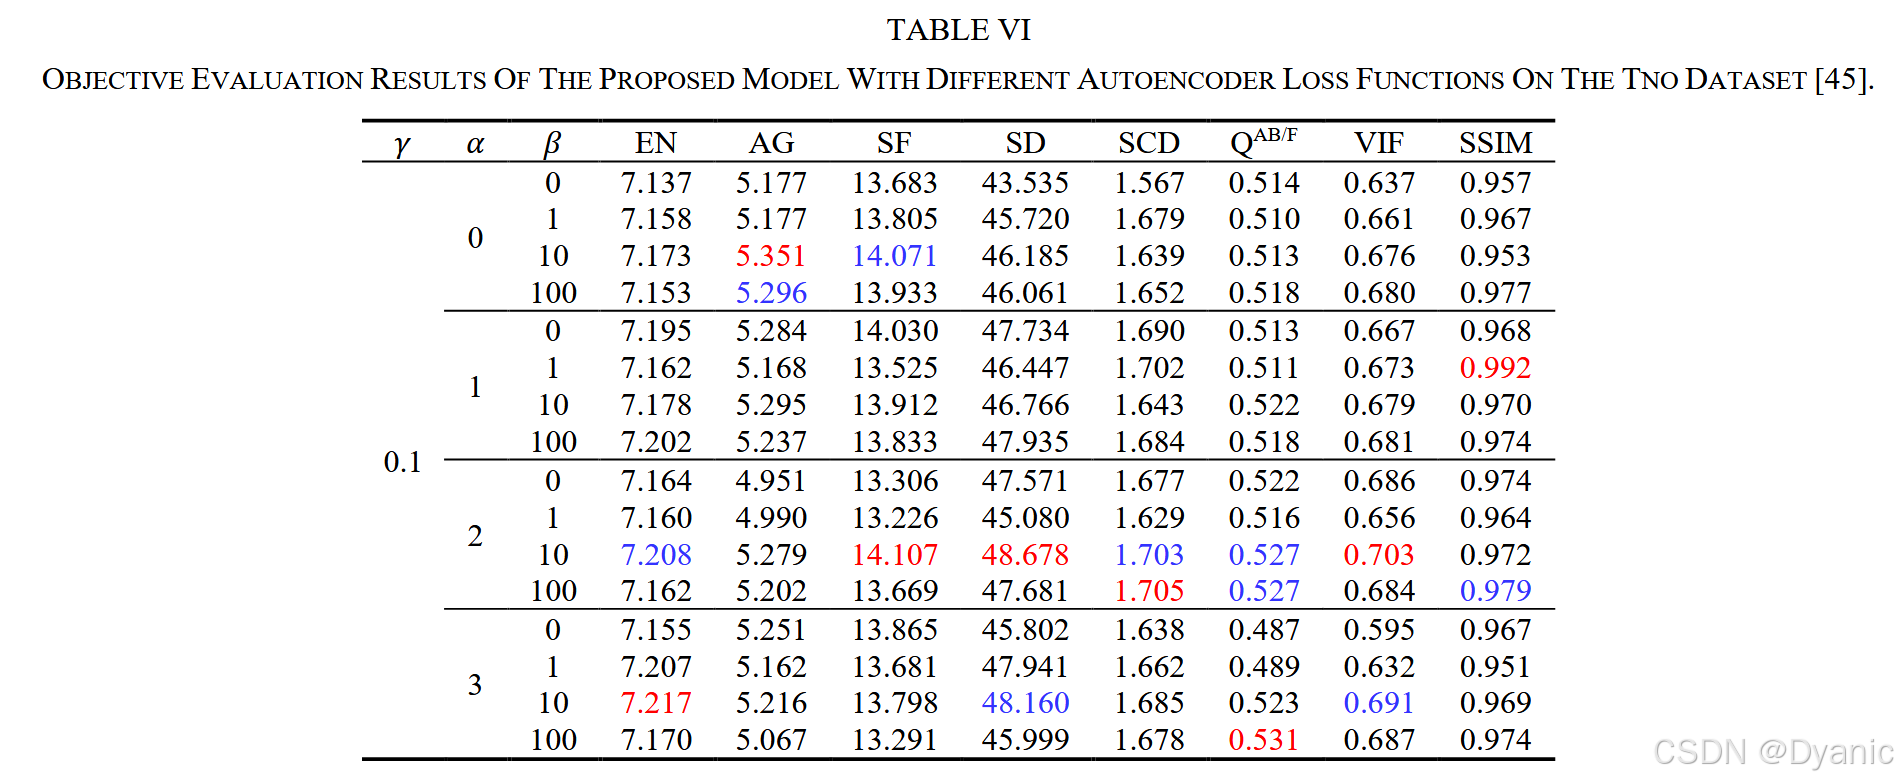
自动编码器的损失函数在训练过程中需设置超参数α和β。如图15(Fig. 15)所示,随着α增大,融合图像中人物的显著性逐渐增强,当α达到2时趋于稳定;随着β增大,灌木丛、标牌等环境细节愈发清晰,在β=10时达到最佳效果,超过该值后,灌木丛细节会出现失真,标牌清晰度也会下降。表6(TABLE VI)结果显示,随着α和β的增大,模型对各项指标的平衡效果逐步提升,在α=2、β=10时实现最优融合,在6项指标中均位列前两名。
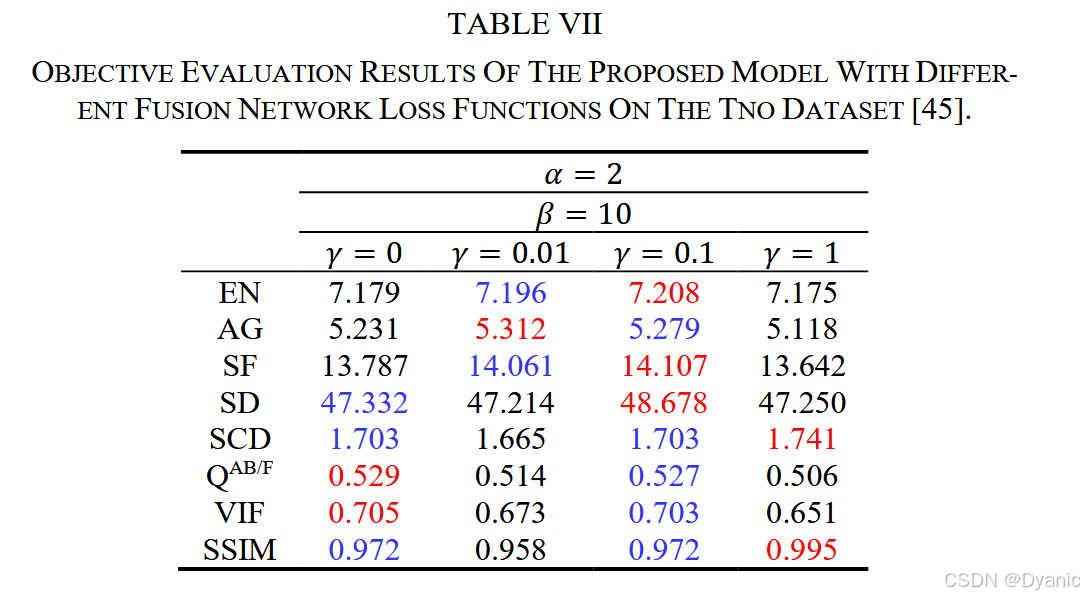
融合网络的损失函数在训练过程中需设置超参数γ。如图16(Fig. 16)所示,当γ过小时,对图像显著性的约束减弱,导致长椅识别效果不佳;当γ达到0.1时,对纹理细节与显著性的约束达到平衡,在保持长椅高识别度的同时,优化了灌木丛细节。表7(TABLE VII)中,当γ=0.1时,模型在所有指标中均位列前两名,进一步验证了上述分析结论。
综上,设置α=2、β=10、γ=0.1可实现最优融合效果。
4)训练策略分析
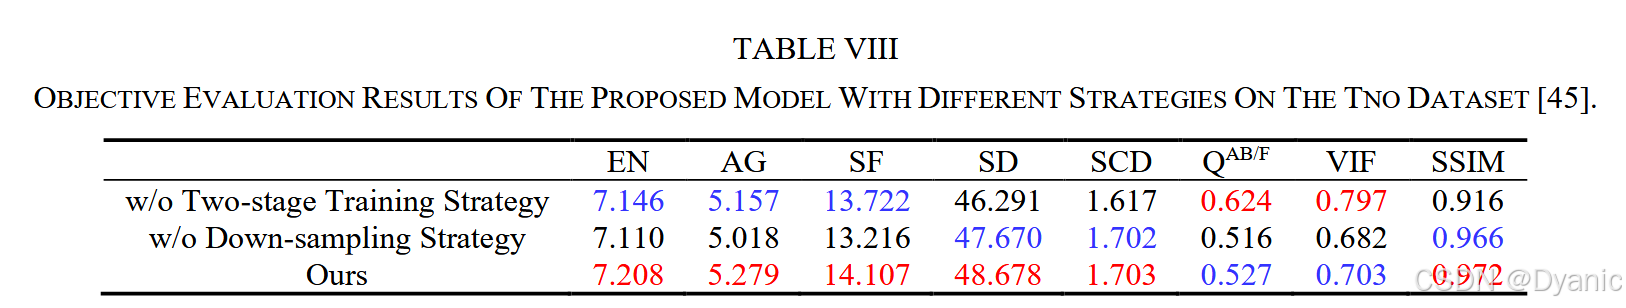
本部分采用单阶段训练策略,结合融合网络的损失函数重新训练模型。如图14所示,采用单阶段策略的模型,其融合图像的显著性与细节均有所下降,且细节模糊问题更为明显。表8(TABLE VIII)中,与最终模型相比,单阶段训练策略在总边缘信息(QAB/F)和视觉信息保真度(VIF)指标上略有提升——这是因为在单阶段策略中,解码器基于融合特征进行训练,更符合其重建融合图像的功能定位,因此能生成视觉效果更优的融合图像。
但单阶段策略无法明确区分网络各组件的功能定位,导致组件(尤其是编码器)的训练效果下降,进而使模型在熵(EN)、平均梯度(AG)、空间频率(SF)、标准差(SD)和相关差异和(SCD)指标上出现显著下降,最终性能不及采用两阶段训练策略的模型。
5)下采样分析
为验证下采样策略的优势,移除该策略并重新训练模型。如图14所示,未采用下采样的模型在人物显著性与树木纹理呈现上均表现较差,尤其在纹理性能上存在明显不足。表8中,未采用下采样的模型在所有指标上均出现下降,原因在于:在训练轮次有限的情况下,双分支特征编码模块(DTDM)难以有效处理大尺度特征;此外,未采用下采样的模型运行时间显著增加。因此,采用下采样策略的模型在性能与实用性上均优于未采用该策略的模型。
G. 计算复杂度
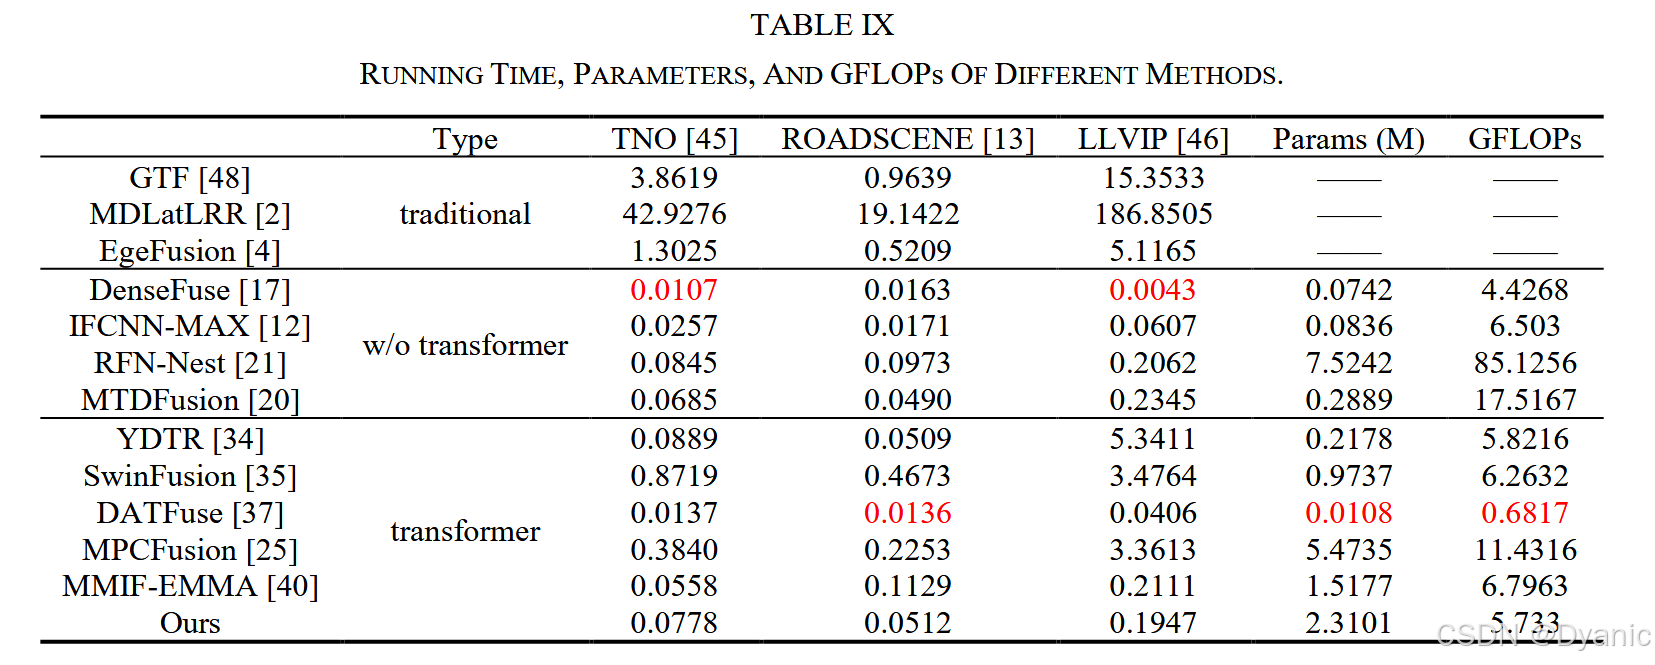
如表9(TABLE IX)所示,与传统方法相比,所提方法在运行时间上具有显著优势;但与未使用Transformer的方法相比,其性能不及DenseFuse和IFCNN-MAX——这两种方法采用人工设计的融合策略,因此在运行时间上更具优势。
在基于Transformer的方法中,DATFuse因其更简单的Transformer结构,在运行时间上表现最优,但牺牲了融合质量;与之相反,所提方法实现了融合质量与运行时间的平衡。在基于Transformer的方法中,所提方法在三个数据集上的运行时间均位列中上游,这得益于所采用的下采样策略:由卷积神经网络模块(CNNM)处理大尺度特征,双分支特征编码模块(DTDM)处理小尺度特征。
为研究不同方法的计算复杂度,实验采用224×224尺寸的图像。尽管所提方法的参数数量并非最优,但在每秒千兆次浮点运算(GFLOPs)指标上位列第三,表明其计算复杂度表现良好。
综上,所提模型在融合质量、运行时间与计算复杂度之间实现了良好平衡。
H. 目标检测性能评估
为验证所提方法在高层计算机视觉任务中的有效性,开展目标检测实验。实验采用现有最优(SOTA)检测器YOLOv5作为目标检测模型,以mAP@0.5(交并比为0.5时的平均精度均值)为评价指标评估检测性能。
实验数据集M3FD包含6类目标,分别为公交车(bus)、轿车(car)、路灯(lamp)、摩托车(motorcycle)、行人(people)和卡车(truck)。实验环境与图像融合实验保持一致,训练总轮次为400,批处理大小为8,优化器采用随机梯度下降(SGD),初始学习率为1e-2。基于上述设置,在融合结果与源图像上分别训练YOLOv5模型。
1)定性对比
三组典型场景的目标检测结果涵盖了M3FD数据集中所有标注目标,体现了各类方法对目标检测任务的提升效果。
图17(Fig. 17)展示了简单道路场景下的YOLOv5目标检测结果。在此场景中,所有融合方法均能检测出人物与车辆目标;与源图像的检测结果相比,所有方法的检测概率均有所提升。值得注意的是,采用所提方法的融合图像中,所有目标的检测概率均不低于0.9,表明所提方法对目标检测的提升效果具有较强稳定性。
图18(Fig. 18)展示了复杂道路场景下的目标检测结果。仅YDTR与所提方法的融合图像正确识别出公交车两侧的轿车,且所提方法的检测置信度更高。这一结果凸显了所提方法在小目标与遮挡目标融合上的优势,能够确保此类目标的关键特征得以保留。
图19(Fig. 19)展示了目标密集的道路场景下的检测结果。对于近距离重叠目标,RFN-Nest、YDTR和MMIF-EMMA的融合图像出现检测错误;与其他方法相比,所提方法的平均检测概率更高,表明其在密集重叠目标融合任务中表现更优。
2)定量对比
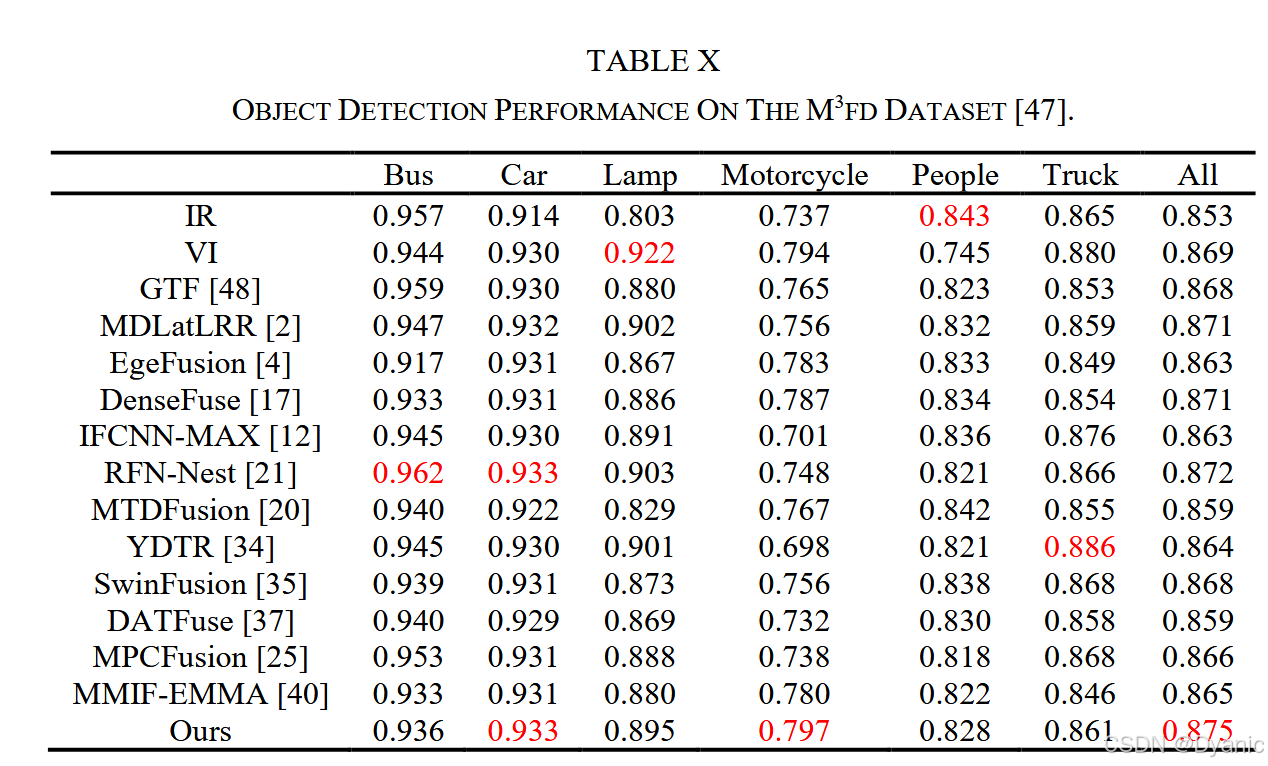
如表10(TABLE X)所示,所提方法在提升道路场景中小型机动车(尤其是轿车和摩托车)的检测能力方面表现突出;尽管在其他目标的检测上未取得最优结果,但对于大多数类别,其性能均优于最差结果,体现了对各类目标的稳定融合效果。
这一优势确保了所提方法在不同检测场景的高层视觉任务中性能稳定,同时最大限度减少了对小型机动车目标的漏检与误检。在所有类别目标检测的mAP@0.5指标上均处于领先水平,进一步验证了上述结论。
V. 结论
本文提出一种基于注意力机制的红外与可见光图像自适应多尺度融合网络,命名为AMSFusion。具体而言,本文设计了卷积神经网络模块(CNNM)、双分支特征编码模块(DTDM)及跳跃连接,以提升模型的特征提取、特征重建能力与计算效率;随后,通过由通道-空间注意力(CSA)和基于移位窗口的注意力-卷积混合模块(SWACmixT)构成的融合网络,实现不同尺度特征的自适应融合;最后,采用两阶段训练策略,增强模型对多尺度特征的提取与融合能力。
通过在多个数据集上开展大量实验,与12种现有最优方法相比,验证了所提方法的性能、泛化能力与实用性;此外,目标检测实验证明,所提方法可显著提升高层计算机视觉任务的性能。
在未来工作中,计划探索所提方法在其他领域的应用,例如星光条件下的红外与可见光图像融合、多曝光图像融合及多聚焦图像融合。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献5条内容

所有评论(0)