【图结构】之图神经网络GCN详解
作者:張張張張
github地址:https://github.com/zhanghekai
【转载请注明出处,谢谢!】
G
C
N
GCN
GCN源代码地址:https://github.com/tkipf/gcn
G
C
N
GCN
GCN论文地址:https://arxiv.org/pdf/1609.02907.pdf
一、GCN诞生的由来
\qquad C N N CNN CNN系列: 做图像识别时,对象是图片,是一个二维的结构,于是人们发明了 C N N CNN CNN这种神奇的模型来提取图片的特征。 C N N CNN CNN的核心在于它的 k e r n e l kernel kernel, k e r n e l kernel kernel是一个个小窗口,在图片上平移,通过卷积的方式来提取特征。这里的关键在于图片结构上的平移不变性: 一个小窗口无论移动到图片的哪一个位置,其内部的结构都是一模一样的,因此是 C N N CNN CNN可以实现所在。
\qquad R N N RNN RNN系列: 它的对象是自然语言这样的序列信息,是一个一维的结构, R N N RNN RNN就是专门针对这些序列的结构而设计的,通过各种"门"的操作,使得序列前后的信息互相影响,从而很好地捕捉序列的特征。
\qquad
上面讲的图片或者语言,都属于欧式空间的数据,因此才有维度的概念,欧式空间的数据的特点就是结构很规则。但是现实生活中,其实有很多很多不规则的数据结构,典型的就是图结构,或称拓扑结构,如社交网络、化学分子结构、知识图谱等等。
\qquad
图的结构一般来说是十分不规则的,可以认为是无限维的一种数据,所以它没有平移不变性。每一个节点的周围结构可能都是独一无二的,这种结构的数据,就让传统的
C
N
N
CNN
CNN、
R
N
N
RNN
RNN瞬间失效。为了处理这类数据,涌现出了许多方法,
G
C
N
GCN
GCN只是其中的一种。
G r a p h    C o n v o l u t i o n a l    N e t w o r k s ( G C N ) : Graph\;Convolutional\;Networks(GCN): GraphConvolutionalNetworks(GCN): 图卷积神经网络,实际上跟 C N N CNN CNN的作用一样,就是一个特征提取器,只不过它的对象是图数据。 G C N GCN GCN精妙地设计了一种从图数据中提取特征的方法,从而让我们可以使用这些特征去对图数据进行: 节 点 分 类 ( n o d e c l a s s i f i c a t i o n ) 节点分类(node classification) 节点分类(nodeclassification)、 图 分 类 ( g r a p h c l a s s i f i c a t i o n ) 图分类(graph classification) 图分类(graphclassification)、 边 预 测 ( l i n k p r e d i c t i o n ) 边预测(link prediction) 边预测(linkprediction) ,还可以顺便得到 图 的 嵌 入 表 示 ( g r a p h e m b e d d i n g ) 图的嵌入表示(graph embedding) 图的嵌入表示(graphembedding)。
二、GCN核心公式
\qquad 假设我们有一批图数据,其中有 N N N个节点(node),每个节点都有自己的特征,我们设这些节点的特征组成一个 N × d N×d N×d维的矩阵 X X X,然后各个节点之间的关系也会形成一个 N × N N×N N×N维的矩阵 A A A,也称为邻接矩阵(adjacency matrix)。 X X X和 A A A便是我们模型的输入。
核心公式:
G
C
N
GCN
GCN是一个神经网络,它的层与层之间的传播方式是:
H
l
+
1
=
σ
(
D
~
−
1
2
A
~
D
~
−
1
2
H
(
l
)
W
(
l
)
)
H^{l+1}=\sigma(\tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}}H^{(l)}W^{(l)})
Hl+1=σ(D~−21A~D~−21H(l)W(l))
其中:
- A ~ = A + I \tilde{A}=A+I A~=A+I是无向图 G G G的邻接矩阵加上自连接(就是每个顶点和自身加一条边), I I I是单位矩阵。
矩阵 A A A为什么要加一个单位矩阵呢?
\qquad 只用 A A A的话,由于 A A A的对角线上都是 0 0 0,所以在和特征矩阵 H H H相乘的时候,只会计算这个 n o d e node node的所有邻居的特征的加权和,而该 n o d e node node自己的特征却被忽略了。因此,我们可以做一个小小的改动,给 A A A加上一个单位矩阵 I I I,这样就让对角线元素变成 1 1 1了,我们希望在进行信息传播的时候顶点自身的特征信息也得到保留。
- D ~ \tilde{D} D~是度矩阵(degree matrix),公式为: D ~ i i = ∑ j A ~ i j \tilde{D}_{ii}=\sum_j\tilde{A}_{ij} D~ii=∑jA~ij。度矩阵 D ~ \tilde{D} D~为对角矩阵,对角线上的元素值即为该节点的度 + 1 +1 +1。
D ~ − 1 2 A ~ D ~ − 1 2 \tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}} D~−21A~D~−21的作用是什么?
\qquad 首先,这个部分是可以事先算好的,因为这两个矩阵均已知。 A ~ \tilde{A} A~是没有经过归一化的矩阵,这样与特征矩阵相乘会改变特征原本的分布,产生一些不可预测的问题。所以我们对 A A A做一个标准化处理。归一化后的矩阵中每个元素取值都在 ( 0 , 1 ) (0,1) (0,1)之间。
- H H H是每一层的特征,对于输入层的话, H H H就是 X X X
D ~ − 1 2 A ~ D ~ − 1 2 H ( l ) \tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}}H^{(l)} D~−21A~D~−21H(l)的作用是什么?
\qquad 原论文中记 Y ( l ) = D ~ − 1 2 A ~ D ~ − 1 2 H ( l ) Y^{(l)}=\tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}}H^{(l)} Y(l)=D~−21A~D~−21H(l)这个运算可以理解为实现了空间信息的聚合。其中第0层的输入,是原始的特征,以后每增加一层,就会多聚合一阶neighbor上的信息( l l l层就对每个顶点融合了 l l l 阶邻域的信息)。
- W i W^i Wi是第 i i i层的权重矩阵,权重矩阵的维度为 F i × F i + 1 F^i\times F^{i+1} Fi×Fi+1,即权重矩阵第二个维度的大小决定了下一层的特征数。注意: 核心公式有几层,最终就会训练出几个参数矩阵 W W W
\qquad 很显然模型可学习的参数是 W l W^l Wl, Y ( l ) W ( l ) Y^{(l)}W^{(l)} Y(l)W(l)进行了线性变换,有人认为可能是实现了feature augment。也就是说模型在每一层中,所有节点共享了用于特征增强的参数变化矩阵。( H l H^l Hl的第二个维度,根据特征增强需要设计的维度(是超参数))。 D ~ − 1 2 A ~ D ~ − 1 2 \tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}} D~−21A~D~−21结果矩阵大小为 N × N N \times N N×N, H ( 0 ) = X H^{(0)}=X H(0)=X的大小为 N × d N \times d N×d,所以求出的 Y ( l ) Y^{(l)} Y(l)的大小为 N × d N \times d N×d,参数矩阵 W ( l ) W^{(l)} W(l)要想和 Y ( l ) Y^{(l)} Y(l)进行运算,它的第一维(也就是行数)必须是 d d d,而它的第二维又是超参数,很显然,这个矩阵维度与顶点数目或者每个顶点的度无关,于是说这是一个在同层内顶点上共享的参数矩阵。
- σ \sigma σ是非线性激活函数,例如 S i g m o i d Sigmoid Sigmoid、 R e L u ReLu ReLu等。
归一化举例:
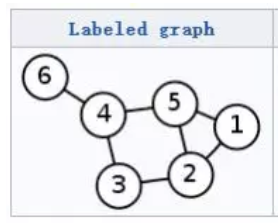
\qquad
由上图可知:
A
=
[
0
1
0
0
1
0
1
0
1
0
1
0
0
1
0
1
0
0
0
0
1
0
1
1
1
1
0
1
0
0
0
0
0
1
0
0
]
A
~
=
[
1
1
0
0
1
0
1
1
1
0
1
0
0
1
1
1
0
0
0
0
1
1
1
1
1
1
0
1
1
0
0
0
0
1
0
1
]
D
~
=
[
3
0
0
0
0
0
0
4
0
0
0
0
0
0
3
0
0
0
0
0
0
4
0
0
0
0
0
0
4
0
0
0
0
0
0
2
]
D
~
−
1
2
=
[
0.577
0
0
0
0
0
0
0.5
0
0
0
0
0
0
0.577
0
0
0
0
0
0
0.5
0
0
0
0
0
0
0.5
0
0
0
0
0
0
0.707
]
D
~
−
1
2
A
~
D
~
−
1
2
=
[
0.333
0.289
0
0
0.289
0
0.289
0.25
0.289
0
0.25
0
0
0.289
0.333
0.289
0
0
0
0
0.289
0.25
0.25
0.354
0.289
0.25
0
0.25
0.25
0
0
0
0
0.354
0
0.5
]
A=\begin{bmatrix} 0 & 1 & 0 & 0 & 1 & 0 \\ 1 & 0 & 1 & 0 & 1 & 0 \\ 0 & 1 & 0 & 1 & 0 & 0\\ 0 & 0 & 1 & 0 & 1 & 1 \\ 1 & 1 & 0 & 1 & 0 & 0 \\ 0 & 0 & 0 & 1 & 0 & 0\end{bmatrix}\tilde{A}=\begin{bmatrix} 1& 1 & 0 & 0 & 1 & 0 \\ 1 & 1& 1 & 0 & 1 & 0 \\ 0 & 1 & 1 & 1 & 0 & 0\\ 0 & 0 & 1 & 1 & 1 & 1 \\ 1 & 1 & 0 & 1 & 1 & 0 \\ 0 & 0 & 0 & 1 & 0 & 1\end{bmatrix}\\[2ex] \tilde{D}=\begin{bmatrix} 3 & 0 & 0 & 0 & 0 & 0 \\ 0 & 4 & 0 & 0 & 0 & 0 \\ 0 & 0 & 3 & 0 & 0 & 0\\ 0 & 0 & 0 & 4 & 0 & 0 \\ 0 & 0 & 0 & 0 & 4 & 0 \\ 0 & 0 & 0 & 0 & 0 & 2\end{bmatrix} \tilde{D}^{-\frac{1}{2}}=\begin{bmatrix} 0.577 & 0 & 0 & 0 & 0 & 0 \\ 0 & 0.5 & 0 & 0 & 0 & 0 \\ 0 & 0 & 0.577 & 0 & 0 & 0\\ 0 & 0 & 0 & 0.5 & 0 & 0 \\ 0 & 0 & 0 & 0 & 0.5 & 0 \\ 0 & 0 & 0 & 0 & 0 & 0.707\end{bmatrix}\\[2ex] \tilde{D}^{-\frac{1}{2}}\tilde{A}\tilde{D}^{-\frac{1}{2}}=\begin{bmatrix} 0.333 & 0.289 & 0 & 0 & 0.289 & 0 \\ 0.289 & 0.25 & 0.289 & 0 & 0.25 & 0 \\ 0 & 0.289 & 0.333 & 0.289 & 0 & 0\\ 0 & 0 & 0.289 & 0.25 & 0.25 & 0.354 \\ 0.289 & 0.25 & 0 & 0.25 & 0.25 & 0 \\ 0 & 0 & 0 & 0.354 & 0 & 0.5\end{bmatrix}
A=⎣⎢⎢⎢⎢⎢⎢⎡010010101010010100001011110100000100⎦⎥⎥⎥⎥⎥⎥⎤A~=⎣⎢⎢⎢⎢⎢⎢⎡110010111010011100001111110110000101⎦⎥⎥⎥⎥⎥⎥⎤D~=⎣⎢⎢⎢⎢⎢⎢⎡300000040000003000000400000040000002⎦⎥⎥⎥⎥⎥⎥⎤D~−21=⎣⎢⎢⎢⎢⎢⎢⎡0.5770000000.50000000.5770000000.50000000.50000000.707⎦⎥⎥⎥⎥⎥⎥⎤D~−21A~D~−21=⎣⎢⎢⎢⎢⎢⎢⎡0.3330.289000.28900.2890.250.28900.25000.2890.3330.28900000.2890.250.250.3540.2890.2500.250.2500000.35400.5⎦⎥⎥⎥⎥⎥⎥⎤
三、GCN的输入矩阵X是什么样的?
\qquad 由上述可知, G C N GCN GCN的输入矩阵 A A A为图的邻接矩阵,大小为 N × N N \times N N×N, N N N为节点数量,它表示任意两个顶点之间的邻接关系,邻接则为 1 1 1,不邻接则为 0 0 0
★上述所说的大小为
N
×
d
N \times d
N×d的由节点特征组成的矩阵
X
X
X是什么意思呢?
\qquad
这部分的信息是需要自己从数据中进行提取的,比如人物画像、属性信息等,可以是对该节点一段话的描述,然后整理成词向量的形式;也可以是用户的行为信息等。
★对于很多网络,我们可能没有节点的特征,这个时候可以使用
G
C
N
GCN
GCN吗?
\qquad
答案是可以的,如原论文中作者对那个俱乐部网络,采用的方法就是用单位矩阵
I
I
I 替换特征矩阵
X
X
X。
四、如何实现用GCN来进行分类?
\qquad 经过上述核心公式的求解, G C N GCN GCN最终得到的结果是一个经过 l l l层特征加强后得到的 Z = H ( l ) Z=H^{(l)} Z=H(l)各个节点的特征向量。也就是说,通过若干层 G C N GCN GCN后每个 n o d e node node的特征从 X X X变成了 Z N × C Z^{N\times C} ZN×C,其中 C C C为待分类的类别数量。
★ G C N GCN GCN是采用 s o f t m a x softmax softmax进行分类的:
-
s
o
f
t
m
a
x
softmax
softmax函数如下:
p i = e a i ∑ k = 1 C e a k p_i = \frac{e^{a_i}}{\sum_{k=1}^{C}e^{a_k}} pi=∑k=1Ceakeai
\qquad 其中, a 1 , a 2 , ⋯   , a c a_1,a_2,\cdots,a_c a1,a2,⋯,ac是 Z Z Z中某个节点的特征( Z Z Z中行数代表节点数,也就是 Z Z Z中某一行的数据代表了该行所对应节点的特征); p i p_i pi为该节点属于类别 i i i的概率。通过上式可以保证 ∑ i = 1 c y 1 = 1 \sum_{i=1}^{c}y_1=1 ∑i=1cy1=1,即待分类节点属于各个类别的概率和为 1 1 1。
\qquad 通过上式我们可以得到该节点在每个 l a b e l label label下的概率。
\qquad 综上所述, 可以通过将核心公式计算出来的 Z N × C Z^{N \times C} ZN×C,用在 s o f t m a x softmax softmax函数上,实现节点的分类预测。
注意: 这里的 l a b e l label label都是用 o n e − h o t one-hot one−hot形式表示的!
五、GCN是如何进行训练并最终得到参数矩阵W的?
\qquad 得到预测的分类结果后,根据已知的 l a b e l label label我们可以知道哪些分类正确了,哪些分类错误了,那我们应该如何改进,从而更新参数矩阵 W W W呢?
★ G C N GCN GCN采用的是交叉熵损失函数+梯度下降法更新参数:
- 交叉熵损失函数: 交叉熵反映了实际的输出与预测的输出之间的相似程度。
L = − ∑ k = 1 N ∑ i = 1 C p k i log ( q k i ) L = -\sum_{k=1}^{N}\sum_{i=1}^{C}p_{ki}\log (q_{ki}) L=−k=1∑Ni=1∑Cpkilog(qki)
\qquad 其中 N N N为节点的数量, C C C为分类类别的数量, p i j p_{ij} pij是节点 k k k属于类别 i i i的概率 (真实值) , q k i q_{ki} qki是模型对节点 k k k预测为属于类别 i i i的概率 (预测值)。
\qquad 综上所述, 交叉熵损失函数最终求得的是一个值。
- 梯度下降法: 由于梯度下降法公式写起来比较复杂,我们用代码代替。
'''-------------------------------------------------------------------------------------'''
		'''
			tf.train.AdamOptimizer利用梯度的一阶矩估计和二阶矩估计动态调整每个参数的学习率。
			Adam的优点主要在于经过偏置校正后,每一次迭代学习率都有个确定范围,使得参数比较平稳.
		'''
		# self.lr为事先设置好的梯度下降中的学习率
        self.optimizer = tf.train.AdamOptimizer(self.lr)

		'''
			由tf源代码可以知道optimizer.minimize()实际上包含了两个步骤,
			即optimizer.compute_gradients和optimizer.apply_gradients,前者用于计算梯度,
			后者用于使用计算得到的梯度来更新对应的变量。
		'''

		'''
			computer_gradients(loss, val_list):
			    ●loss: 需要被优化的Tensor;这里的loss为self.loss+self.l2
			最终返回的是元组列表,即[(gradient, variable),...]。
			例:x = 50, w = 10, y = x*w;结果是[(50,10),(10,50)]
			列表中第一个元组中第一个元素是y对w求导的结果,第二个元素是w。
			列表中第二个元组中第一个元素是y对x求导的结果,第二个元素是x。
		'''
		# self.loss是通过tf.losses.softmax_cross_entropy计算得到的损失函数的Tensor
		# l2是一个正则化项
        gradients = self.optimizer.compute_gradients(self.loss+self.l2)

		'''
			self.optimizer.apply_gradients的作用是将compute_gradients()返回的值作为输入参数对变量进行更新。

			使用tf.clip_by_value来修正梯度:
			输入一个张量grad,把grad中的每一个元素的值都压缩在-5和5之间。小于-5的让它等于-5,大于5的元素的值等于5。
		'''
        capped_gradients = [(tf.clip_by_value(grad, -5., 5.), var) for grad, var in gradients if grad is not None]
        self.train_op = self.optimizer.apply_gradients(capped_gradients)
		'''
			那为什么minimize()会分开两个步骤呢?原因是因为在某些情况下我们需要对梯度做一定的修正,
			例如为了防止梯度消失(gradient vanishing)或者梯度爆炸(gradient explosion),
			我们需要事先干预一下以免程序出现Nan的尴尬情况;
			有的时候也许我们需要给计算得到的梯度乘以一个权重或者其他乱七八糟的原因,所以才分开了两个步骤。
		'''

		'''多次执行self.train_op后,即可训练成功'''

		'''---------------------------------------------------------------------------------------'''
六、GCN优缺点
优点:
- 这样的共享方式, W l W^l Wl 的维度是可以进行调节的,与顶点的数目无关,使得模型可以用于大规模的 g r a p h graph graph数据集。
缺点:
- 这个模型对于同阶的邻域上分配给不同的邻居的权重是完全相同的(也就是 G A T GAT GAT论文里说的:无法允许为邻居中的不同节点指定不同的权重)。这一点限制了模型对于空间信息的相关性的捕捉能力,这也是在很多任务上不如 G A T GAT GAT的根本原因。
- G C N GCN GCN结合临近节点特征的方式和图的结构依依相关,这局限了训练所得模型在其他图结构上的泛化能力。
【参考文献】
- 何时能懂你的心——图卷积神经网络(GCN). By郭必扬
- 精通GCN全攻略:https://zhuanlan.zhihu.com/p/72373094
- 利用GCN进行节点分类:http://www.sohu.com/a/253579047_395209
- 解读三种经典GCN中的Parameter Sharing:https://zhuanlan.zhihu.com/p/72373094
- TensorFlow学习笔记:https://www.cnblogs.com/marsggbo/p/10056057.html

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 75
 0
- 0


 已为社区贡献3条内容

所有评论(0)