镜像视界 Pixel-to-Space 空间引擎:像素即坐标的空间智能技术路线
镜像视界 Pixel-to-Space 空间引擎:像素即坐标的空间智能技术路线
副标题
融合 视频空间反演 × 矩阵视频融合 × 动态三维实时重构 × 无感定位 × 行为认知建模 × 风险预测推演,构建“人工智能+空间计算”时代的新一代空间智能底座
一、从“人工智能+”到“空间智能”:数字中国的新型基础设施
在新一轮科技革命背景下,人工智能正在成为推动经济社会发展的关键引擎。在近年来的全国两会中,“人工智能+行动计划”“新质生产力”“数字中国建设”“智能体技术”“具身智能”等关键词频繁出现,明确提出要推动人工智能与实体经济深度融合,构建面向未来的新型数字基础设施。
随着大模型技术的发展,人工智能已经从单一任务系统演进为具备复杂认知能力的智能体系。以DeepSeek等大模型为代表的人工智能系统,已经能够进行语言理解、知识推理、多模态分析以及复杂决策。然而,当人工智能试图进入现实世界时,一个关键问题逐渐显现:
机器缺乏对真实空间的理解能力。
现实世界中的绝大多数信息都存在于空间结构与动态行为之中。例如:
-
城市交通运行依赖道路空间结构
-
工业生产依赖设备空间布局
-
人群行为发生在真实物理空间中
如果人工智能无法理解空间结构,就无法真正理解现实世界。因此,在“人工智能+”战略背景下,一个新的技术方向逐渐成为行业关注的焦点:
空间智能(Spatial Intelligence)。
空间智能的核心目标,是让机器能够理解真实空间、解析动态行为并进行风险预测。这一能力正是推动智慧城市、数字孪生城市以及智能体系统发展的关键技术基础。
在这一背景下,镜像视界提出了 Pixel-to-Space 空间引擎技术路线,通过视频空间反演与三维重建技术,使视频数据从二维影像升级为三维空间感知系统。
二、像素即坐标:Pixel-to-Space技术理念
Pixel-to-Space 技术是镜像视界空间智能体系的核心技术路线,其核心理念可以概括为三句话:
像素即坐标
视频即传感器
空间即智能
在传统视频系统中,视频画面只是二维像素集合。系统能够识别像素中的对象,但无法获取真实空间信息。
例如,在一个监控画面中,系统可能识别出:
-
一个人
-
一辆车
但系统无法确定:
-
这个人在真实空间中的位置
-
他距离其他目标有多远
-
他正在向哪个方向移动
Pixel-to-Space 技术的核心目标,就是通过空间计算算法,将视频中的二维像素转换为真实空间坐标,从而实现:
像素 → 三维空间坐标
一旦系统能够从视频中恢复空间坐标,视频数据就不再只是图像信息,而成为一种 空间数据来源。
这意味着视频系统可以直接感知真实世界的空间结构。
三、Pixel-to-Space空间反演原理
Pixel-to-Space技术的核心是 空间反演(Spatial Inversion)。
该技术通过计算机视觉与空间计算算法,将二维视频画面中的像素位置映射到真实三维空间坐标。
这一过程通常包括以下几个关键步骤。
1 相机标定
首先需要对摄像设备进行标定,以确定摄像头与真实空间之间的几何关系。
标定过程包括:
-
相机内参标定
-
相机外参标定
-
空间坐标系统一
通过标定,可以确定摄像头在空间中的位置以及其拍摄视角。
2 像素坐标解析
在视频画面中,每一个目标都对应一定的像素位置。系统通过目标检测算法识别目标后,可以获得:
-
目标像素坐标
-
目标轮廓信息
这些信息构成空间反演计算的基础。
3 多视角空间计算
为了恢复真实空间位置,系统通常需要多个摄像头提供不同视角。
通过多视角数据,可以利用 三角测量算法计算目标在空间中的真实坐标。
基本原理是:
来自不同摄像头的视线在空间中相交,交点即为目标真实位置。
4 三维坐标恢复
通过空间计算算法,系统可以获得目标的三维坐标,包括:
-
X坐标
-
Y坐标
-
Z坐标
从而确定目标在真实空间中的位置。
四、矩阵视频融合:构建空间视觉网络
在大规模空间场景中,通常存在大量摄像设备。传统视频系统中,每个摄像头都是独立运行的,系统无法统一理解空间信息。
镜像视界提出 矩阵视频融合技术(Matrix Video Fusion),将多个摄像头的视频数据进行统一融合,形成完整的空间视觉网络。
矩阵视频融合技术包括:
-
多视角视频同步
-
空间坐标统一
-
视觉重叠区域融合
-
空间一致性校正
通过该技术,可以将分散的视频数据整合为一个统一的空间系统。
在这一体系中,每个摄像头不再是独立设备,而是成为 空间感知网络的一部分。
五、动态目标三维实时重构
在获得目标空间坐标后,系统可以进一步构建动态三维模型。
通过多视角视频数据,系统可以实时重建:
-
人体三维模型
-
车辆三维模型
-
设备三维模型
这种能力被称为:
动态目标三维实时重构。
三维重构技术可以记录目标在空间中的完整运动轨迹。例如:
-
人员运动路径
-
车辆行驶轨迹
-
设备运行状态
这些数据构成 空间行为分析的重要基础。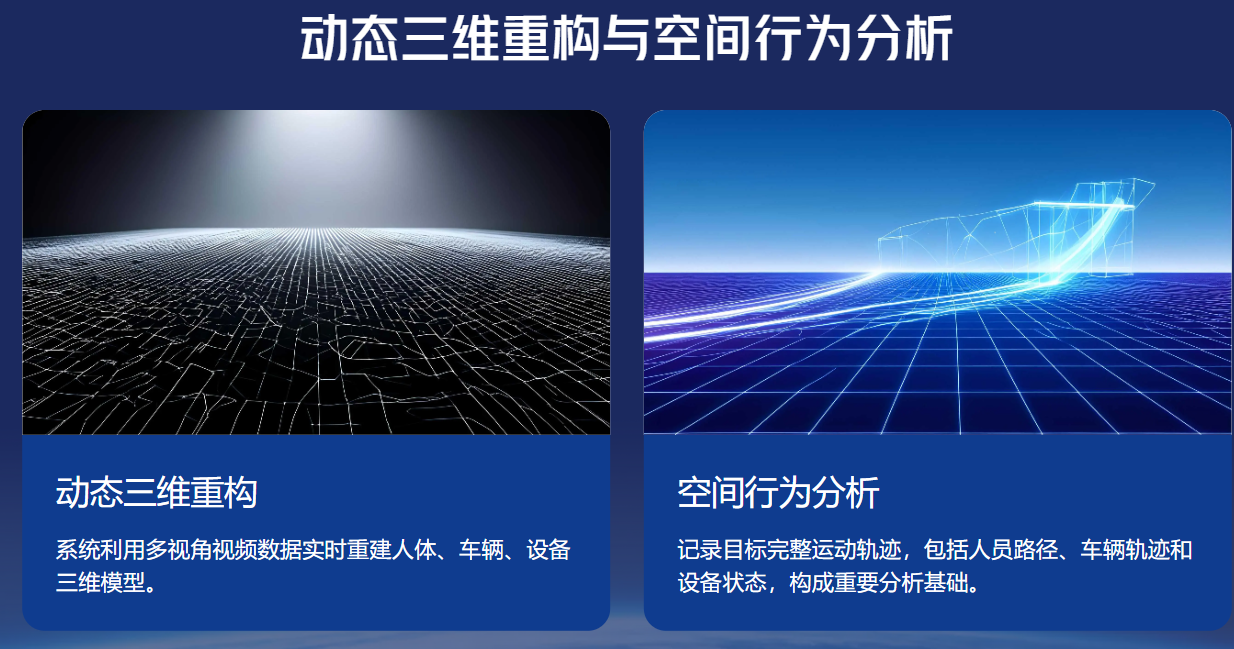
六、无感定位:无需设备的空间定位技术
传统定位技术通常依赖额外设备,例如:
-
GPS
-
蓝牙
-
RFID
这些技术需要用户携带设备或安装标签。
镜像视界提出的 无感空间定位技术,通过视觉系统即可实现人员定位。
该技术具有三个重要特点:
无标签
无信号
无设备依赖
系统通过视觉识别和空间计算,即可获得人员的空间坐标。
在多摄像头环境下,该技术可以实现 厘米级定位精度。
这一能力为智慧城市、工业管理以及公共安全提供了全新的技术手段。
七、行为认知建模:从轨迹到行为理解
当系统获得目标的空间轨迹后,可以进一步进行行为分析。
通过轨迹建模技术,系统可以分析目标的行为模式,例如:
-
人群聚集趋势
-
异常行为模式
-
非法闯入行为
通过机器学习算法,系统可以不断学习行为模式,从而实现:
行为认知能力。
这意味着系统不仅能够看到目标,还能够理解目标的行为。
八、风险预测推演:从感知到决策
空间智能系统的最终目标,是实现 风险预测与智能决策。
通过结合:
-
空间轨迹数据
-
行为认知模型
-
AI预测算法
系统可以预测潜在风险,例如:
-
人群拥堵
-
交通事故
-
安全威胁
这种能力使城市管理系统从 被动响应 转变为 主动预防。
这也是“人工智能+治理”理念的重要体现。
九、空间智能:AI进入现实世界的关键技术
随着人工智能、大模型和空间计算技术的融合,空间智能系统正在成为新的技术基础设施。
在未来城市中,视频系统将不再只是监控工具,而将成为一种 空间感知网络。
通过 Pixel-to-Space 技术,视频数据可以直接生成空间信息,从而构建真实世界的数字模型。
这一技术体系将广泛应用于:
-
智慧城市
-
港口管理
-
工业园区
-
机场管理
-
公共安全
在“人工智能+”战略背景下,空间智能系统将成为推动 数字中国建设与新质生产力发展的重要技术基础。
Pixel-to-Space 技术路线的提出,使视频系统从二维监控升级为三维空间认知平台,为人工智能进入现实世界提供了关键技术路径。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)