Transformer for visual tracking目标跟踪论文总结 -- CVPR 2021 ORAL
·
Transformer Meets Tracker: Exploiting Temporal Context for Robust Visual Tracking
这一篇是中国科学技术大学 周文罡 老师团队的作品,2021 CVPR ORAL
1. Motivation
In video object tracking, there exist rich temporal contexts among successive frames, which have been largely overlooked in existing trackers.
在视频目标跟踪中,连续帧间存在着丰富的时间上下文,但是现有的跟踪器大多忽略了这一点。
2. 主要贡献
- 使用Siamese-like 跟踪pipeline,将transformer的encoder 和 decoder 结构分割成两个并行的分支
3. 主体设计
主体框架:
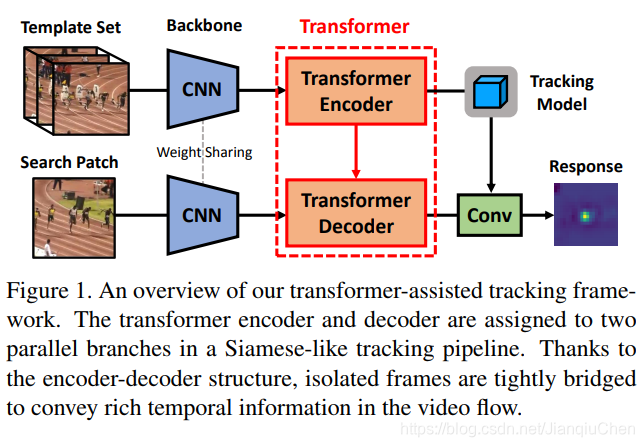
创新点:
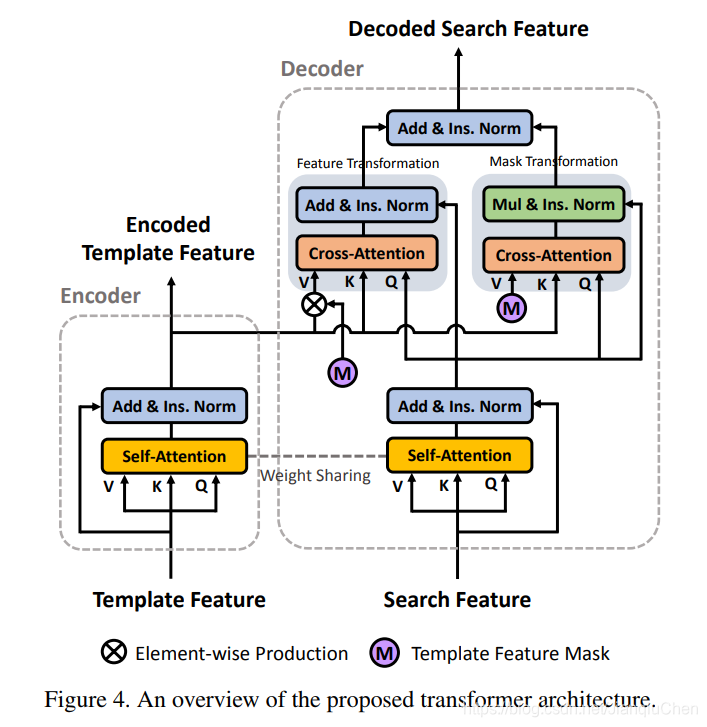
- 改变传统Transformer中的固有结构,受Siamese like 模型的影响,将encoder 和 decoder 分割成为平行的两个分支。
- Block Weight-sharing encoder及decoder 中的自注意力块共享权重,将模板和搜索区域嵌入到一个特征空间以方便进行 cross-attention 计算。
- Instance Normalization: 通过实例层面的归一化,保留有价值的图像振幅信息。
- Slimming Design 轻量化设计 去掉了全连接层并保持了single-head attention。
具体细节可以查看论文原文:Transformer Meets Tracker: Exploiting Temporal Context for Robust Visual Tracking
或者这篇文章: https://blog.csdn.net/qq_39621037/article/details/115189929

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)