卷积神经网络(中)GoogLenet网络结构+代码
GoogLenet网络结构图:

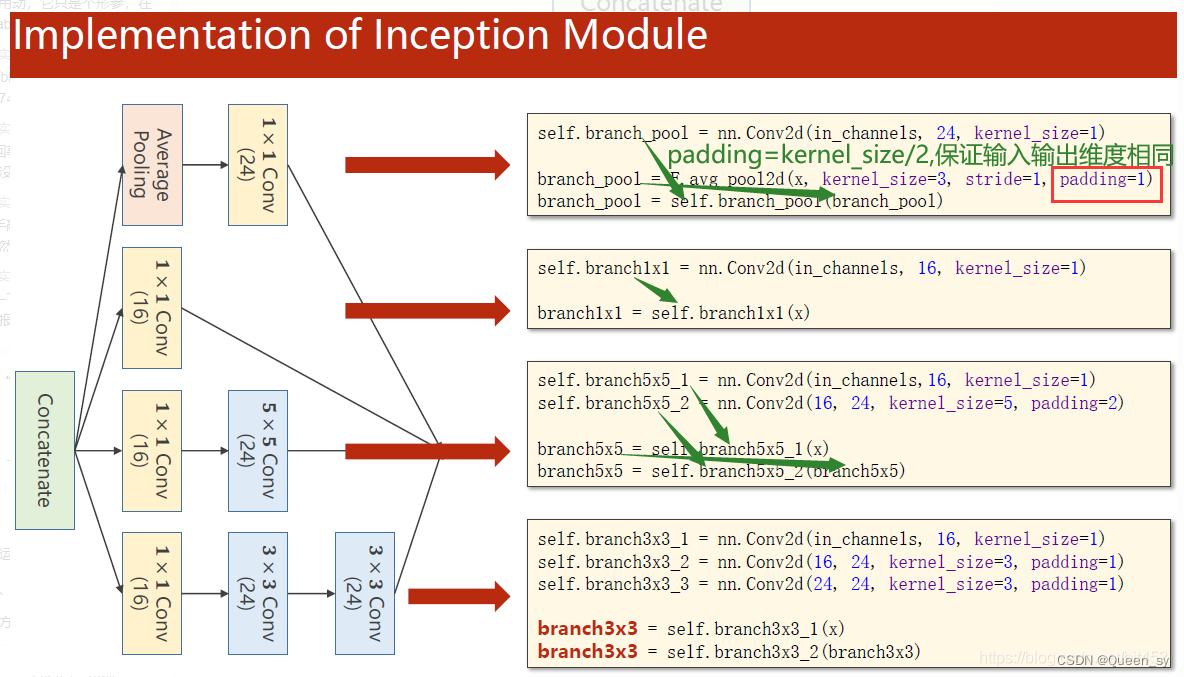
里面的一个Inception Moudel盗梦空间模块
1、分析:
1)图中包括结构:Conv Average Pooling
2)Conv包括1*1convolution 3*3convolution 5*5convolution。
average pooling平均池化
3)卷积核超参数选择困难,自动找到卷积的最佳组合分支,最后采取不同权重
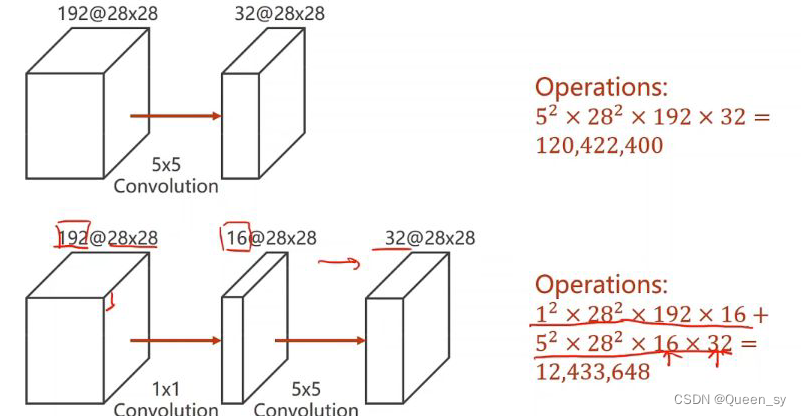
4)每个组合分支都先经过1*1convolution的好处是降低了计算量,如下图
2、流程:
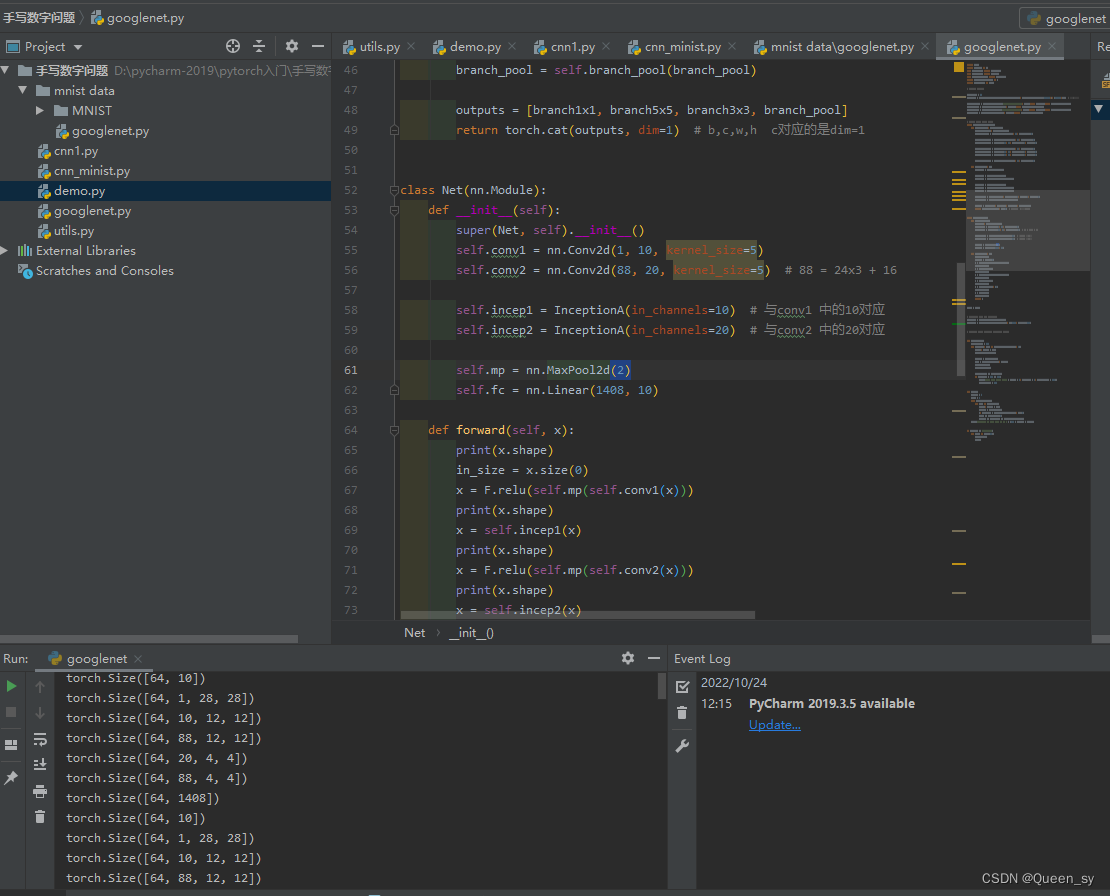
注意上图每个输出的shape,下图是原理。
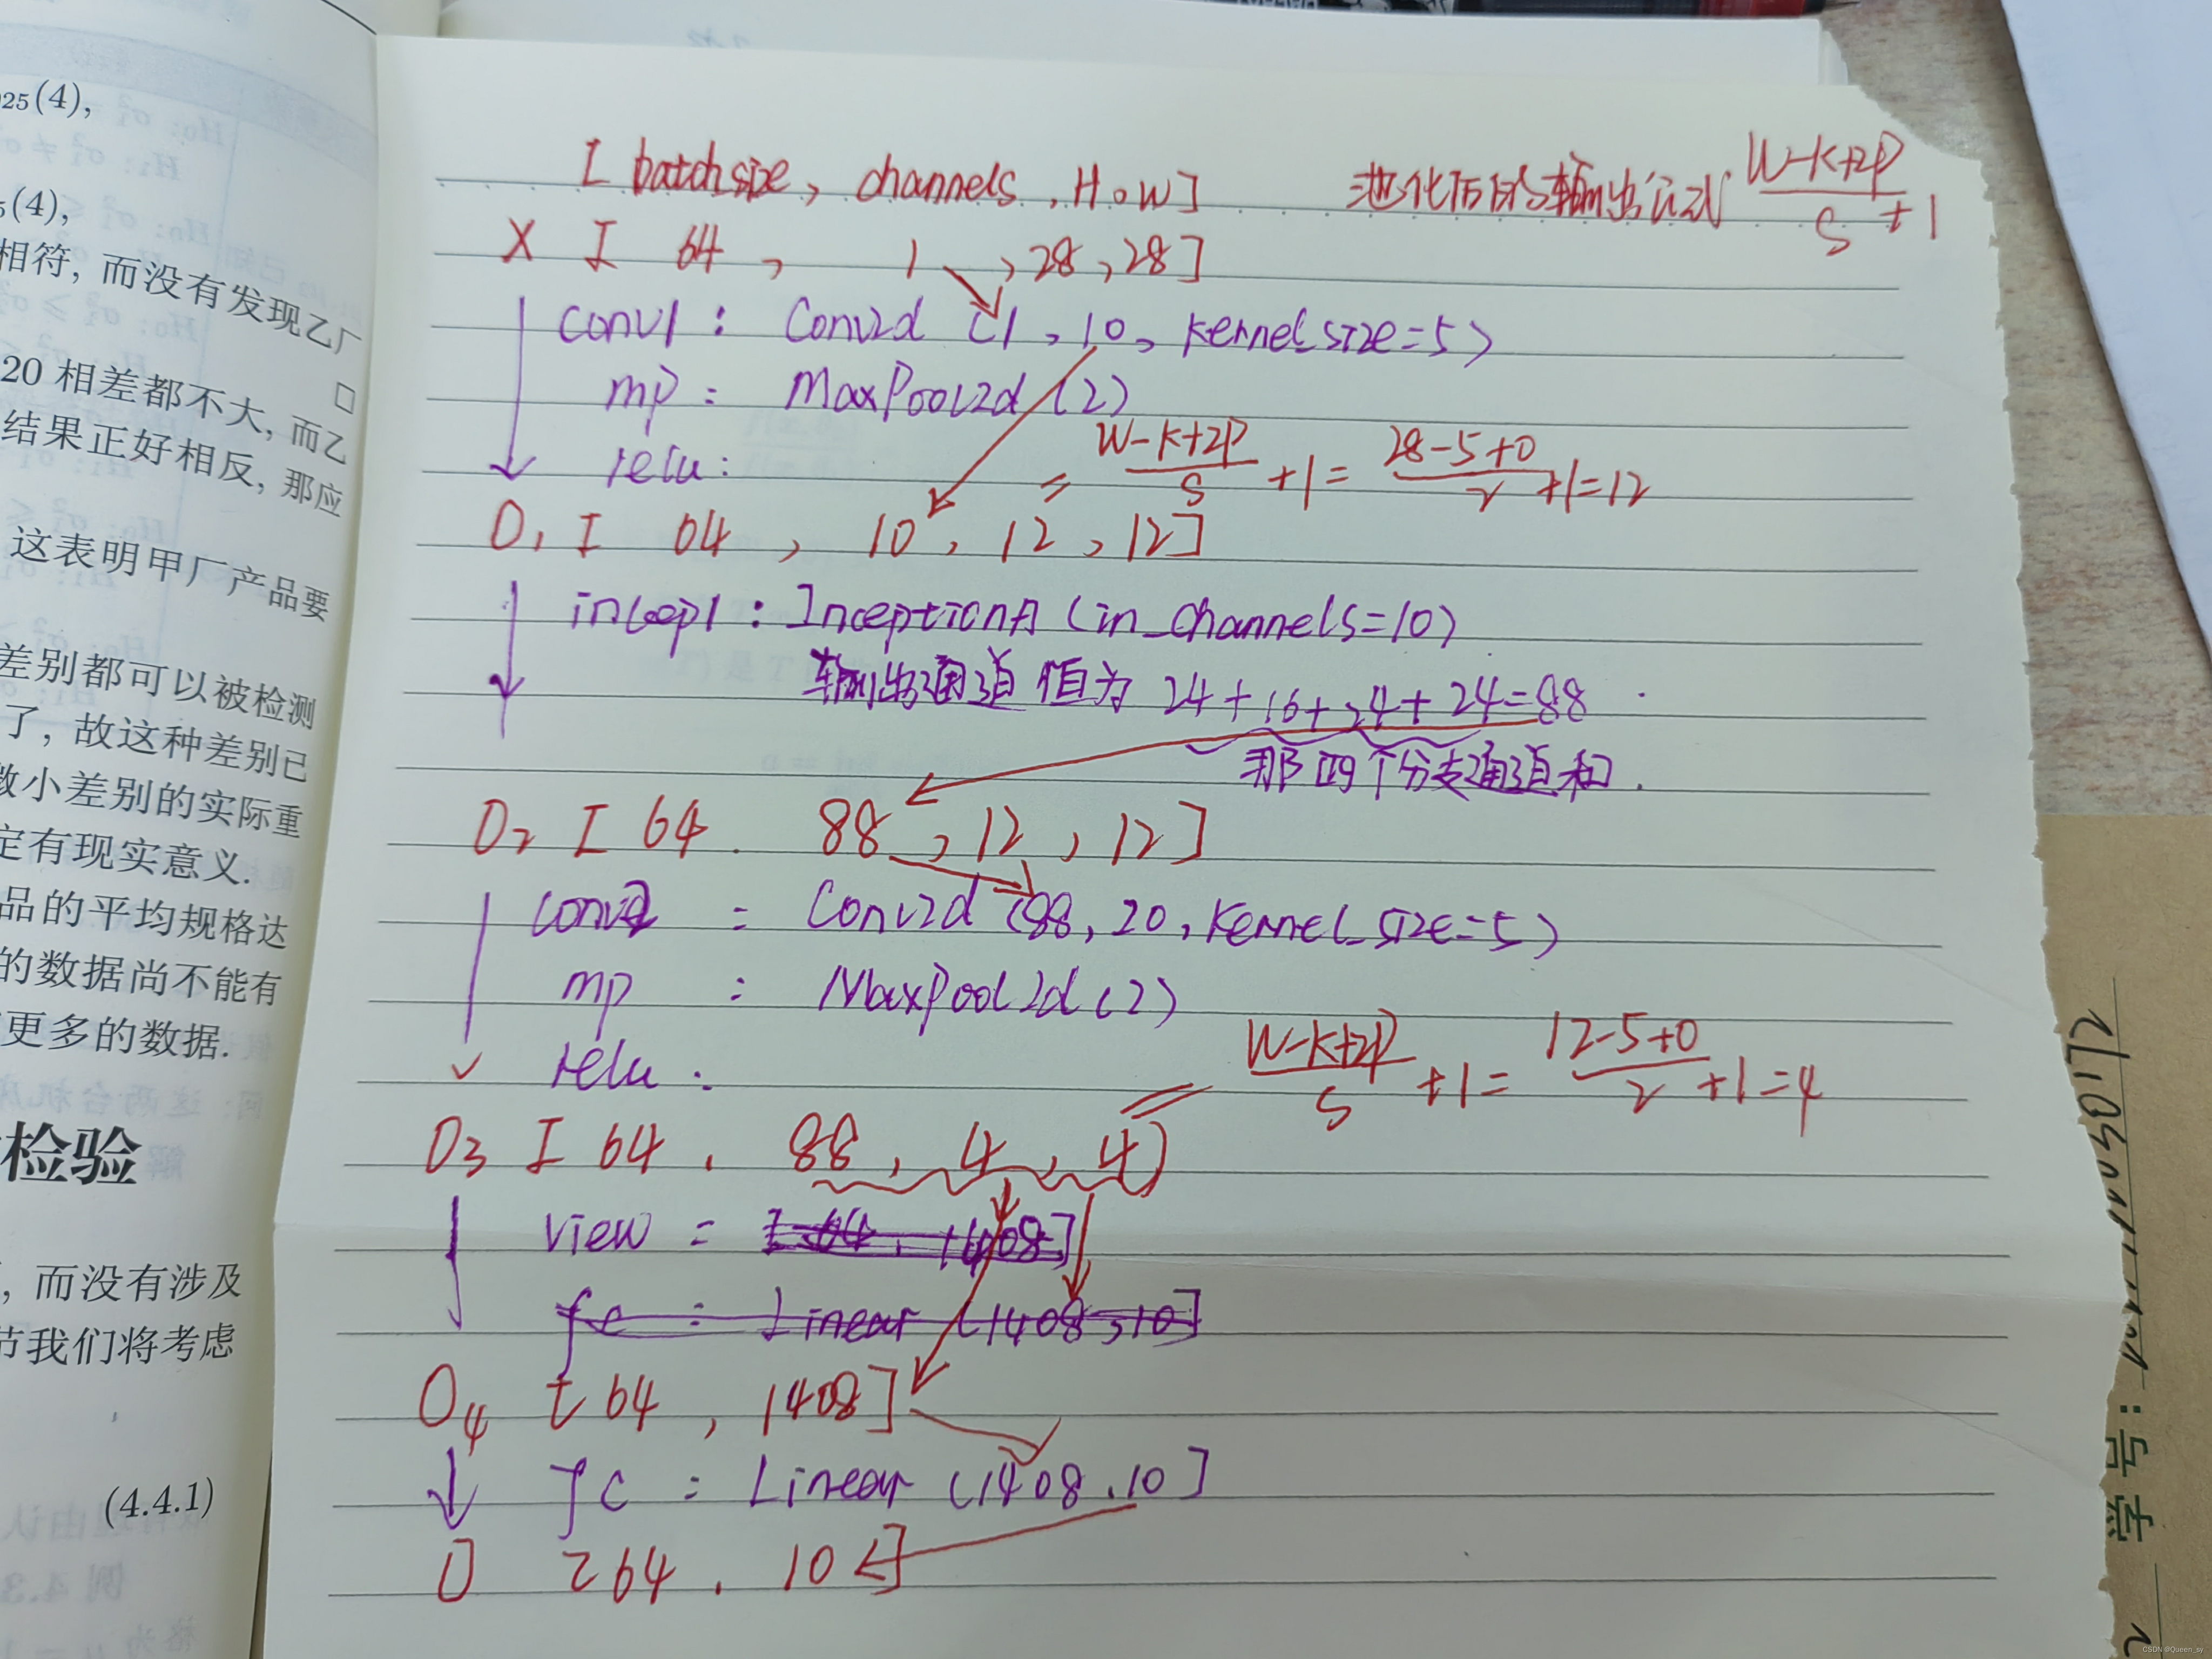
其中池化公式(W−K+2P)/S + 1
MaxPool2D参数
tf.keras.layers.MaxPool2D( pool_size=(2, 2), strides=None, padding='valid', data_format=None, **kwargs )
pool_size = (2,2),池化核的尺寸,默认是2×2
strides = None,移动步长的意思 ,默认是池化核尺寸,即2,
padding = ‘valid’,是否填充,,默认是不填充
data_format = ‘channels_last’,输入数据的格式为(batch_size, pooled_rows, pooled_cols, channels))
参数为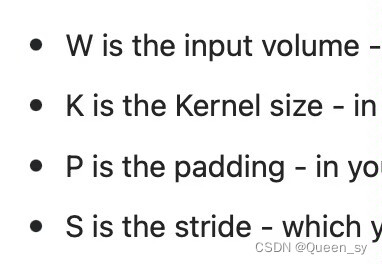
代码
import torch
import torch.nn as nn
from torchvision import transforms
from torchvision import datasets
from torch.utils.data import DataLoader
import torch.nn.functional as F
import torch.optim as optim

# prepare dataset

batch_size = 64
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))])  # 归一化,均值和方差

train_dataset = datasets.MNIST(root='../dataset/mnist/', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
test_dataset = datasets.MNIST(root='../dataset/mnist/', train=False, download=True, transform=transform)
test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)


# design model using class
class InceptionA(nn.Module):
    def __init__(self, in_channels):
        super(InceptionA, self).__init__()
        self.branch1x1 = nn.Conv2d(in_channels, 16, kernel_size=1)

        self.branch5x5_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch5x5_2 = nn.Conv2d(16, 24, kernel_size=5, padding=2)

        self.branch3x3_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch3x3_2 = nn.Conv2d(16, 24, kernel_size=3, padding=1)
        self.branch3x3_3 = nn.Conv2d(24, 24, kernel_size=3, padding=1)

        self.branch_pool = nn.Conv2d(in_channels, 24, kernel_size=1)

    def forward(self, x):
        branch1x1 = self.branch1x1(x)

        branch5x5 = self.branch5x5_1(x)
        branch5x5 = self.branch5x5_2(branch5x5)

        branch3x3 = self.branch3x3_1(x)
        branch3x3 = self.branch3x3_2(branch3x3)
        branch3x3 = self.branch3x3_3(branch3x3)

        branch_pool = F.avg_pool2d(x, kernel_size=3, stride=1, padding=1)
        branch_pool = self.branch_pool(branch_pool)

        outputs = [branch1x1, branch5x5, branch3x3, branch_pool]
        return torch.cat(outputs, dim=1)  # b,c,w,h  c对应的是dim=1


class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = nn.Conv2d(88, 20, kernel_size=5)  # 88 = 24x3 + 16

        self.incep1 = InceptionA(in_channels=10)  # 与conv1 中的10对应
        self.incep2 = InceptionA(in_channels=20)  # 与conv2 中的20对应

        self.mp = nn.MaxPool2d(2)
        self.fc = nn.Linear(1408, 10)

    def forward(self, x):
        in_size = x.size(0)
        x = F.relu(self.mp(self.conv1(x)))
        x = self.incep1(x)
        x = F.relu(self.mp(self.conv2(x)))
        x = self.incep2(x)
        x = x.view(in_size, -1)
        x = self.fc(x)

        return x


model = Net()

# construct loss and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)


# training cycle forward, backward, update


def train(epoch):
    running_loss = 0.0
    for batch_idx, data in enumerate(train_loader, 0):
        inputs, target = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, target)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if batch_idx % 300 == 299:
            print('[%d, %5d] loss: %.3f' % (epoch + 1, batch_idx + 1, running_loss / 300))
            running_loss = 0.0


def test():
    correct = 0
    total = 0
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            outputs = model(images)
            _, predicted = torch.max(outputs.data, dim=1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print('accuracy on test set: %d %% ' % (100 * correct / total))


if __name__ == '__main__':
    for epoch in range(10):
        train(epoch)
        test()
结果。。。。。。。
[5, 600] loss: 0.056
[5, 900] loss: 0.055
accuracy on test set: 98 %
[6, 300] loss: 0.048
[6, 600] loss: 0.054
[6, 900] loss: 0.052
accuracy on test set: 98 %
[7, 300] loss: 0.049
[7, 600] loss: 0.048
[7, 900] loss: 0.043
accuracy on test set: 98 %
[8, 300] loss: 0.041
[8, 600] loss: 0.042
[8, 900] loss: 0.044
accuracy on test set: 98 %
[9, 300] loss: 0.043
[9, 600] loss: 0.037
[9, 900] loss: 0.037
accuracy on test set: 98 %
[10, 300] loss: 0.036
[10, 600] loss: 0.039
[10, 900] loss: 0.038
accuracy on test set: 98 %

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)