遗传算法在低碳冷链路径规划中的应用探索
低碳冷链路径规划 遗传算法 车辆路径规划问题 遗传算法考虑惩罚成本的低碳冷链物流配送 以固定成本,制冷成本,惩罚成本,货损成本,运输成本,碳排放成本总和最小为优化目标
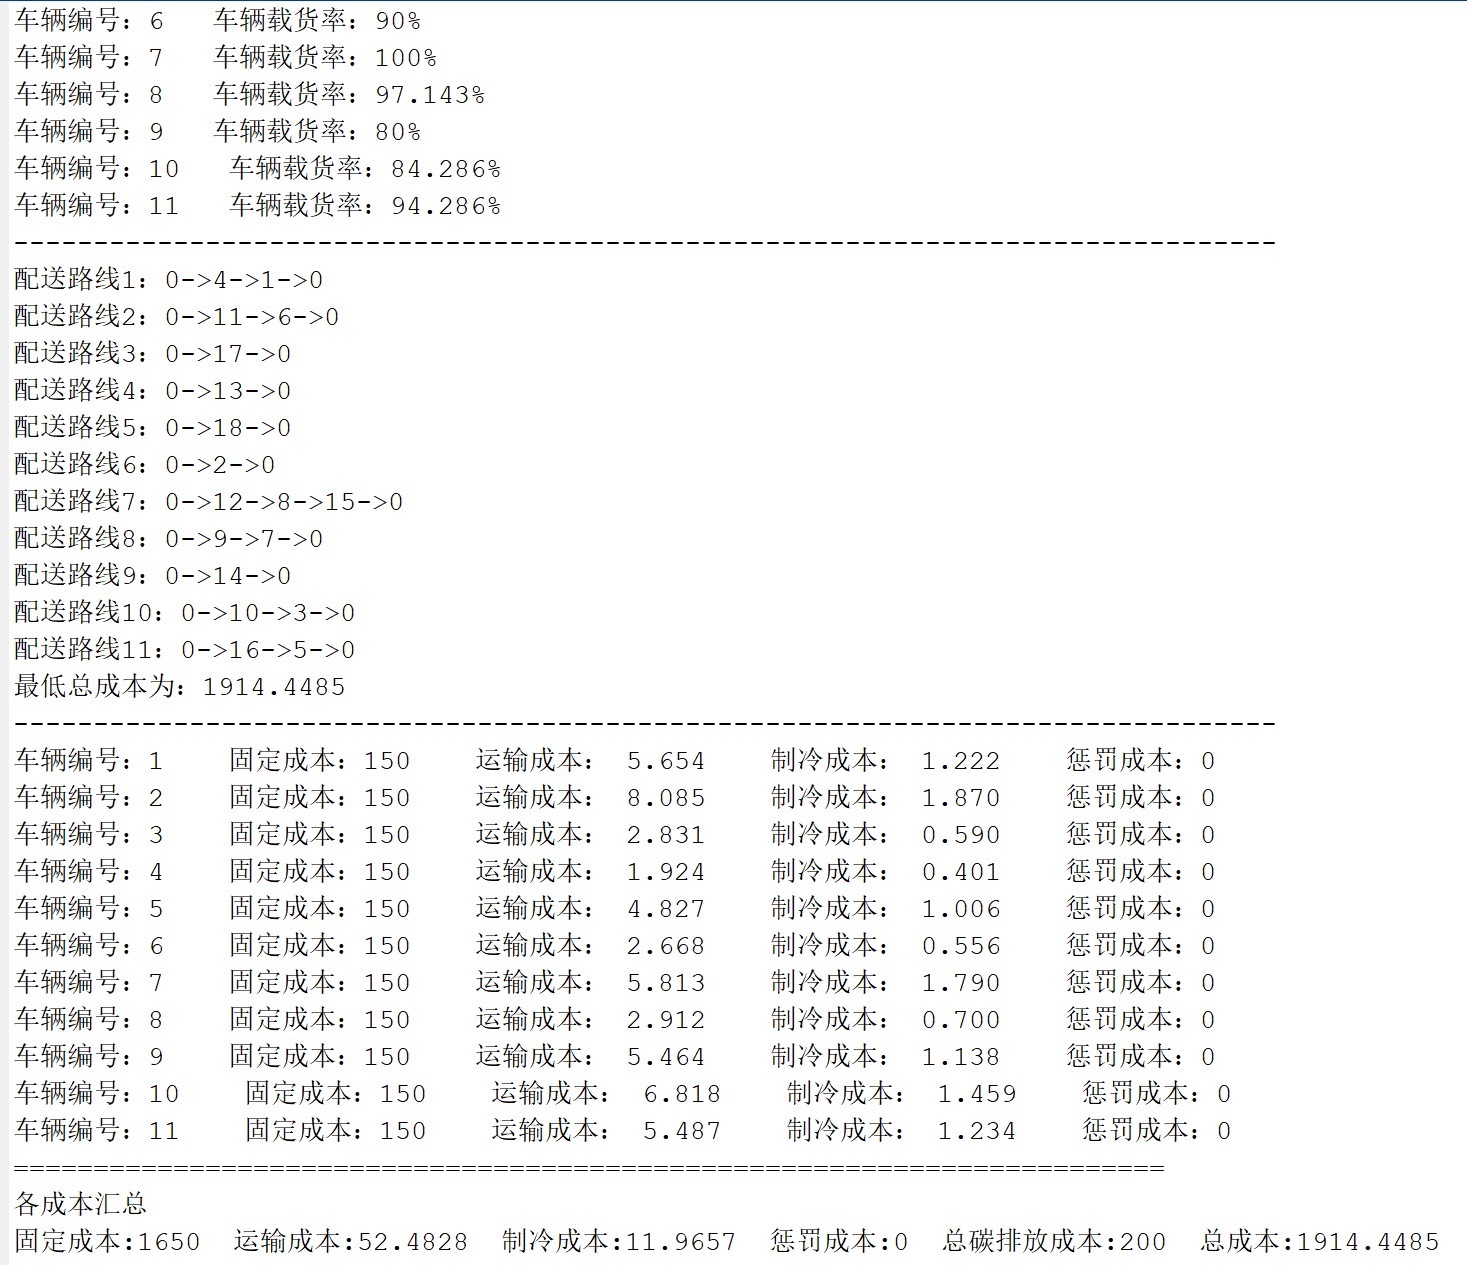
在物流行业蓬勃发展的当下,冷链物流因其对温度控制的严格要求,在配送路径规划上极具挑战性。同时,随着环保理念的深入人心,低碳目标也成为冷链物流路径规划中不可忽视的一环。今天,咱们就来唠唠如何运用遗传算法,考虑惩罚成本,实现低碳冷链物流配送路径规划,让成本总和最小化。
一、车辆路径规划问题简述
车辆路径规划问题(VRP),简单理解就是给定一些客户点、车辆资源,要求找到一种车辆行驶路径的安排,使得在满足一定约束条件下,达到诸如成本最小、路程最短等目标。对于冷链物流而言,除了常规的 VRP 约束,还得考虑货物的冷藏保鲜需求,这就给路径规划增加了难度。
二、成本构成与优化目标
我们的优化目标是让固定成本、制冷成本、惩罚成本、货损成本、运输成本、碳排放成本总和最小。下面简单介绍下各成本:
- 固定成本:比如车辆的购置成本、仓库的租赁成本等,这部分成本相对固定,在每次配送任务开始前就已确定。
- 制冷成本:冷链运输中,为了保持货物所需温度,制冷设备持续运行产生的成本。与运输时间、制冷功率等相关。
- 惩罚成本:如果配送过程中违反了一些约束条件,比如交货时间延迟、温度超出允许范围等,就会产生惩罚成本。这是我们在遗传算法设计中需要重点考虑的部分,以确保生成的路径尽可能满足各种约束。
- 货损成本:由于温度波动、运输时间过长等原因导致货物损坏带来的成本。
- 运输成本:与行驶距离、油耗、司机薪酬等相关的成本。
- 碳排放成本:车辆行驶过程中因燃油消耗产生碳排放,为了满足环保要求,对碳排放进行量化后的成本。
三、遗传算法实现思路
遗传算法是一种模拟自然选择和遗传机制的优化算法,通过种群的进化迭代找到最优解。下面咱们结合代码来看看大致实现过程(以下代码以 Python 为例,为简化说明,仅展示核心逻辑,实际应用中需根据具体场景完善):
import random


# 定义基因(路径中的一个节点)
class Gene:
    def __init__(self, customer_id):
        self.customer_id = customer_id


# 定义染色体(一条完整的路径)
class Chromosome:
    def __init__(self, genes):
        self.genes = genes
        self.fitness = self.calculate_fitness()

    def calculate_fitness(self):
        # 这里计算适应度,也就是成本总和,简化示例中暂不考虑实际成本计算细节
        total_cost = 0
        for i in range(len(self.genes) - 1):
            # 这里可添加实际成本计算逻辑,比如根据节点间距离计算运输成本等
            total_cost += 1
        return total_cost


# 初始化种群
def initialize_population(population_size, num_customers):
    population = []
    for _ in range(population_size):
        genes = [Gene(i) for i in range(num_customers)]
        random.shuffle(genes)
        chromosome = Chromosome(genes)
        population.append(chromosome)
    return population


# 选择操作(轮盘赌选择法)
def selection(population):
    total_fitness = sum([chromosome.fitness for chromosome in population])
    selection_probabilities = [chromosome.fitness / total_fitness for chromosome in population]
    selected_index = random.choices(range(len(population)), weights=selection_probabilities)[0]
    return population[selected_index]


# 交叉操作(顺序交叉)
def crossover(parent1, parent2):
    start, end = sorted(random.sample(range(len(parent1.genes)), 2))
    child_genes = [None] * len(parent1.genes)
    child_genes[start:end] = parent1.genes[start:end]
    remaining_genes = [gene for gene in parent2.genes if gene not in child_genes[start:end]]
    j = 0
    for i in range(len(child_genes)):
        if child_genes[i] is None:
            child_genes[i] = remaining_genes[j]
            j += 1
    return Chromosome(child_genes)


# 变异操作(随机交换变异)
def mutation(chromosome):
    index1, index2 = random.sample(range(len(chromosome.genes)), 2)
    chromosome.genes[index1], chromosome.genes[index2] = chromosome.genes[index2], chromosome.genes[index1]
    return chromosome


# 遗传算法主循环
def genetic_algorithm(population_size, num_generations, num_customers):
    population = initialize_population(population_size, num_customers)
    for generation in range(num_generations):
        new_population = []
        for _ in range(population_size):
            parent1 = selection(population)
            parent2 = selection(population)
            child = crossover(parent1, parent2)
            child = mutation(child)
            new_population.append(child)
        population = new_population
    best_chromosome = min(population, key=lambda chromosome: chromosome.fitness)
    return best_chromosome
代码分析
- 基因与染色体定义:
-Gene类代表路径中的一个客户节点,这里仅简单用customerid标识。实际应用中可能需要包含更多信息,比如客户位置、需求、时间窗等。
-Chromosome类表示一条完整的配送路径,由多个Gene组成。calculatefitness方法用于计算该路径的适应度,也就是我们的成本总和。在实际应用中,这里需要根据各种成本的计算公式,精确计算成本。 - 种群初始化:
-initializepopulation函数用于生成初始种群。通过随机打乱客户节点顺序,生成多条不同的路径,作为初始的染色体集合。种群规模populationsize和客户数量num_customers作为参数传入。 - 选择操作:
- 采用轮盘赌选择法,在selection函数中实现。适应度越好(成本越低)的染色体,被选中的概率越高。通过计算每个染色体的适应度占总适应度的比例,作为选择概率,随机选择一个染色体。 - 交叉操作:
-crossover函数实现了顺序交叉。随机选择两个位置,将父代 1 对应位置的基因片段直接复制到子代,然后将父代 2 中剩余的基因,按照顺序填充到子代的剩余位置。这样既保留了父代的部分特征,又引入了新的组合。 - 变异操作:
-mutation函数进行随机交换变异。随机选择染色体中的两个基因位置,交换它们的位置,为种群引入新的基因组合,避免算法过早收敛。 - 遗传算法主循环:
-geneticalgorithm函数是遗传算法的主循环。在每一代中,通过选择、交叉和变异操作生成新的种群。经过numgenerations代的进化后,返回适应度最优(成本最小)的染色体,即最优的配送路径。
四、考虑惩罚成本
在实际冷链物流配送中,违反时间窗、温度限制等约束条件会产生惩罚成本。我们可以在 Chromosome 类的 calculate_fitness 方法中加入对惩罚成本的计算。例如,如果配送时间超过客户要求的时间窗,可以根据超出的时间长短计算惩罚成本,加到总成本中。这样,在遗传算法进化过程中,不满足约束条件的路径会因为较高的惩罚成本而降低被选择的概率,从而引导算法生成更符合实际约束的路径。
# 假设配送时间超过时间窗会产生惩罚成本,这里添加惩罚成本计算逻辑到 calculate_fitness 方法
class Chromosome:
    def __init__(self, genes):
        self.genes = genes
        self.fitness = self.calculate_fitness()

    def calculate_fitness(self):
        total_cost = 0
        # 假设这里有个函数 get_delivery_time 可以获取配送时间
        delivery_time = get_delivery_time(self.genes)
        for i in range(len(self.genes) - 1):
            # 这里可添加实际成本计算逻辑,比如根据节点间距离计算运输成本等
            total_cost += 1
        # 假设客户要求的时间窗为 10 小时,每超出 1 小时惩罚成本为 10
        if delivery_time > 10:
            total_cost += (delivery_time - 10) * 10
        return total_cost
通过以上方式,我们在遗传算法实现低碳冷链路径规划中,有效地考虑了惩罚成本,使得规划出的路径不仅满足低碳要求,还能尽量符合各种实际约束条件,降低总成本。
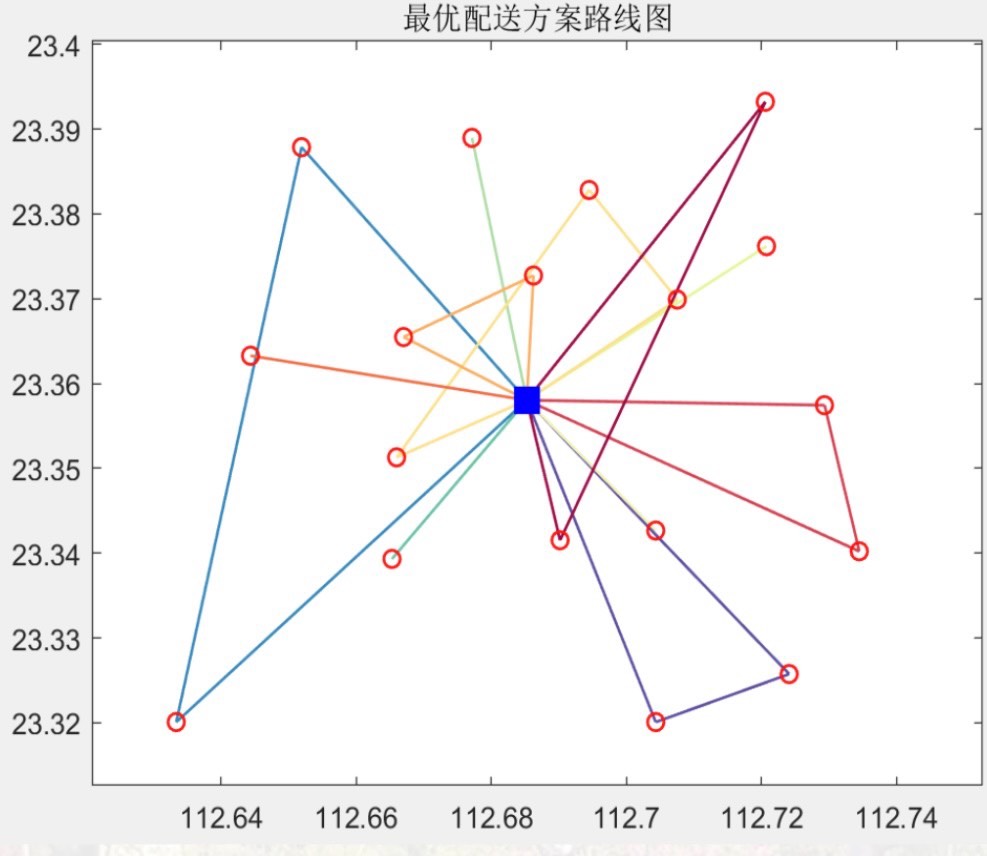
在实际应用中,还需要根据具体的物流场景,精确确定各种成本的计算模型,优化遗传算法的参数设置,以获得更优的路径规划结果。希望这篇博文能给对冷链物流路径规划感兴趣的小伙伴们一些启发,咱们一起在优化物流配送的道路上探索前行!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献13条内容

所有评论(0)