Blip2:使用冻结图像编码器和大型语言模型的Bootstrapping图像预训练-2301
·
Blip2-2301
code:https://github.com/salesforce/LAVIS/tree/main/projects/blip2
背景:如何不重新训练巨大的视觉模型和 LLM,只训练一个很小的“桥梁”,就让 LLM 看懂图片?
方案: Frozen Image Encoder + Q-Former + Frozen LLM。视觉模型和语言模型都冻结,只重点训练中间的 Q-Former,从而大幅降低多模态预训练成本。
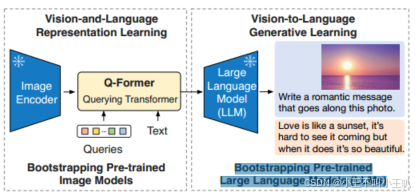
1、Q-Former
Q-Former(Querying Transformer):它放了一组可学习的 Query 去主动从图像特征中“询问”有用的信息。论文使用 32 个 query,每个 768 维。因此原本类似 257 × 1024 的大量 ViT 特征,最后被压缩成 32 × 768,形成一个信息瓶颈。
                ViT visual tokens
                     │
                    K, V
                     │
                     ▼
Q tokens ──Q──→ Cross Attention   × N
                     │
                     ▼
         image-aware Query tokens
2、训练、推理
BLIP-2 不是直接把 Q-Former 接到 LLM 上训练。采用两阶段训练
第一阶段:让 Q-Former“学会看图”
Image
  ↓
Frozen Image Encoder
  ↓
visual features
  ↓
Q-Former
  ↕  #让 Q-Former 学会从海量视觉特征中提取“与文字有关”的信息。
Text
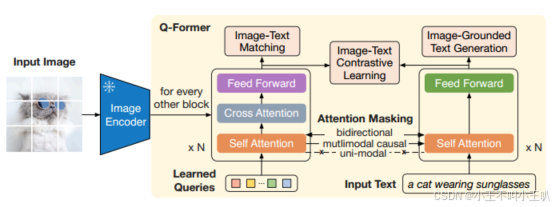
使用三种任务进行学习:
ITC:Image-Text Contrastive Learning
正确 image-text → 拉近
错误 image-text → 推远
ITM:Image-Text Matching
(image, text)
       ↓
是否匹配?
   Yes / No
ITG:Image-Grounded Text Generation
Image Encoder
     ↓
   Query
     ↓
   Text
第二阶段:让 Q-Former“学会说 LLM 的语言”
Image
  ↓
Frozen Image Encoder
  ↓
Q-Former
  ↓
FC Projection
  ↓
Visual Tokens
  ↓
Frozen LLM
  ↓
Text
为什么要分两阶段?
Image → Q-Former → LLM
loss:P(text | image)
理论上也能训练。Frozen、Flamingo 等模型本质上都更接近这种路线。
BLIP-2 的观点是:
单纯 image-to-text generation loss 不足以有效解决 modality gap。
多模态特征空间存在 “modality gap”,即图文特征并不是完全拉齐的分布。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)