YOLOv8 训练实操教程:从预训练模型开始,Ultralytics 统一 API 入门
📚 《YOLO 系列训练实操·全 7 篇》——从 YOLOv5 到 YOLO26,每篇独立成文、全部可复现。
本篇为系列 3/7,是全系列的分水岭:前两篇(v5/v6)的 Anchor 架构在此被 Anchor-Free + DFL 全面超越(同一数据 mAP50 从 0.46 / 0.29 跃到 0.68)。
系列进度:✅ 1/7 YOLOv5(0.46)→ ✅ 2/7 YOLOv6(0.29)→ ✅ 3/7 本文(YOLOv8·0.68) → ⏳ 4/7 YOLOv9(PGI)→ 5/7 YOLOv10(无 NMS)→ 6/7 YOLO11 → 7/7 YOLO26(边缘端到端)。
本文所有版本号、训练指标均为 2026-08 真实运行输出。
1. 背景目的
衔接前两篇:同一数据集、同配置下,v5(1/7)mAP50 0.46、v6(2/7)0.29——Anchor + 耦合头的框架已经触顶。v8 用 Anchor-Free + DFL 把同配指标提到 0.68(insect 少样本类从 0.07~0.13 跃到 0.47),这是全系列第一次"换代"带来量级提升,也确立了后续版本(v9/v10/11/26)的 API 底座。
YOLOv8 是 Ultralytics(YOLOv5 原班团队)于 2023 年推出的新一代框架。它继承了 YOLOv5 的易用性(一条命令训练/验证/推理),并重构了模型结构(C2f 模块、解耦头、Anchor-Free + DFL 等),同时把检测、分割、分类、姿态估计、旋转框统一进同一个 API——这也是后续 YOLO11、YOLO26 等版本的 API 底座。
本文目标:用官方 COCO 预训练权重 yolov8n.pt,在自备的 4 类数据集上微调训练,并完成验证指标评估。你将掌握:
ultralytics包的一行式训练 / 验证 / 推理(Python API 与 CLI)- v8 风格数据集配置(
path+train/val) - 从预训练权重训练、从 checkpoint 续训
- 3.0M 级轻量模型在 8 GB 显存卡的完整微调体验
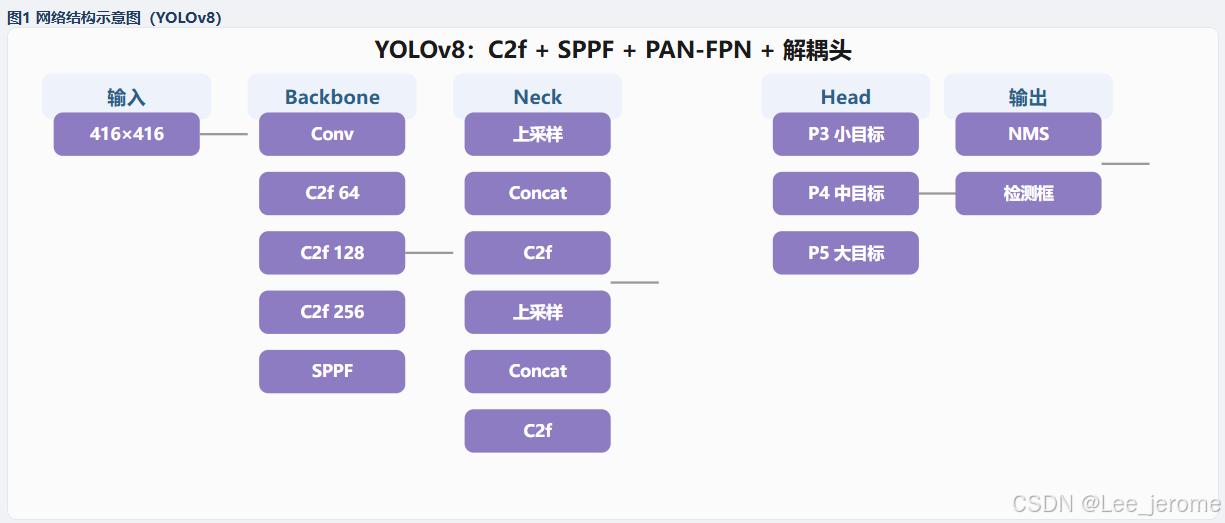
图 1:YOLOv8 一次前向流程示意(输入 → C2f 主干 + SPPF → PAN-FPN 颈部 → 解耦检测头 → NMS)
2. 目录
- 背景目的
- 目录
- 环境和数据集准备
- 实操以及截图伴有原理解释
- 4.1 安装 ultralytics 与预训练权重
- 4.2 数据配置(v8 风格 yaml)
- 4.3 从预训练权重开始训练
- 4.4 训练日志与曲线解读(含原理)
- 4.5 网络结构原理解读
- 4.6 深度原理:关键痛点拆解
- 4.7 操作异常实录
- 测试验证
- 总结
3. 环境和数据集准备
3.1 环境搭建(通用示例)
conda create -n multi-agent-demo python=3.11 numpy
conda activate multi-agent-demo
pip install ultralytics
本文实测环境(供对照):Python 3.11.15 / numpy 2.4.4 / torch 2.10.0+cu128(CUDA 可用)/ torchvision 0.25.0+cu128 / ultralytics 8.4.118 / NVIDIA RTX 5060 Ti(8 GB 显存)。
3.2 数据集准备
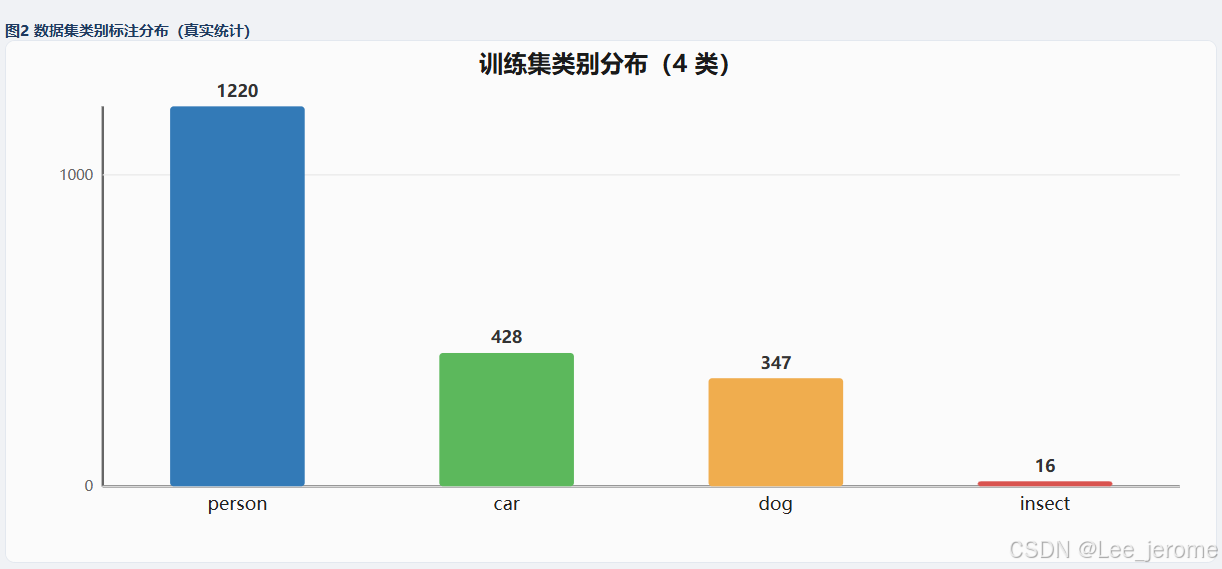
使用标准 YOLO 检测格式(images/{train,val} + labels/{train,val}),与系列前两篇相同。本文以 4 类检测数据集为例(person/car/dog/insect):train 1315 张图、val 298 张图;训练标注分布实测 person 1220、car 428、dog 347、insect 16 条。
图 2:训练集类别标注分布——insect 仅 16 条(对比:car 428 条),后文指标中会看到 v8 对少样本类别的表现。
4. 实操以及截图伴有原理解释
4.1 安装 ultralytics 与预训练权重
pip install ultralytics
预训练权重 yolov8n.pt(约 6.2 MB,COCO 80 类预训练,3,157,200 参数)放到当前目录即可;训练时若本地不存在,ultralytics 会自动从官方源下载。
在 Python 中确认加载成功并查看类别名(COCO 80 类):
from ultralytics import YOLO
model = YOLO('yolov8n.pt')
print(len(model.names))   # 80
4.2 数据配置(v8 风格 yaml)
v8 的数据配置精简为树状结构(区别于 v5/v6 的平铺写法),关键在 path 字段:
# objdet.yaml
path: <dataset>            # 数据集根目录
train: images/train        # 相对 path
val: images/val

nc: 4
names: ['person', 'car', 'dog', 'insect']
说明:ultralytics 通过 “images ↔ labels” 的同名映射自动找到标注文件(
<dataset>/labels/{train,val}/*.txt),无需在配置里单独写标签路径。
4.3 从预训练权重开始训练
CLI 一行式命令(10 epochs):
yolo detect train \
  model=yolov8n.pt \
  data=objdet.yaml \
  epochs=10 batch=16 imgsz=416 device=0
等价 Python API(便于程序化控制分段续训):
from ultralytics import YOLO
model = YOLO('yolov8n.pt')          # 或续训时传上一段 best.pt
model.train(data='objdet.yaml', epochs=10, batch=16, imgsz=416,
            device=0, workers=2, project='runs', name='exp')
- 输出默认到
runs/detect/exp(训练)/runs/detect/train等,自动保存best.pt/last.pt。 - 本文实测因单命令时长限制分 3 段续跑(3 + 4 + 3 epoch):第 2/3 段将上一段的
runs/train/exp*/weights/best.pt作为model继续微调(即"从 checkpoint 续训",与一次性 10 epochs 等价)。 - 8 GB 显存下 batch 16 / imgsz 416 实测占用约 0.99 GB,仅用约 1/8 显存——v8n 非常省资源。
训练耗时实测:3 epochs 用时 0.011 hours(约 40 秒,训练约 7 it/s),10 epochs 全程 2 分钟以内(RTX 5060 Ti)。
4.4 训练日志与曲线解读(含原理)
训练进度条节选(真实输出):
      Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances   Size
        3/3     0.99G      1.714      2.006      1.009         49     416
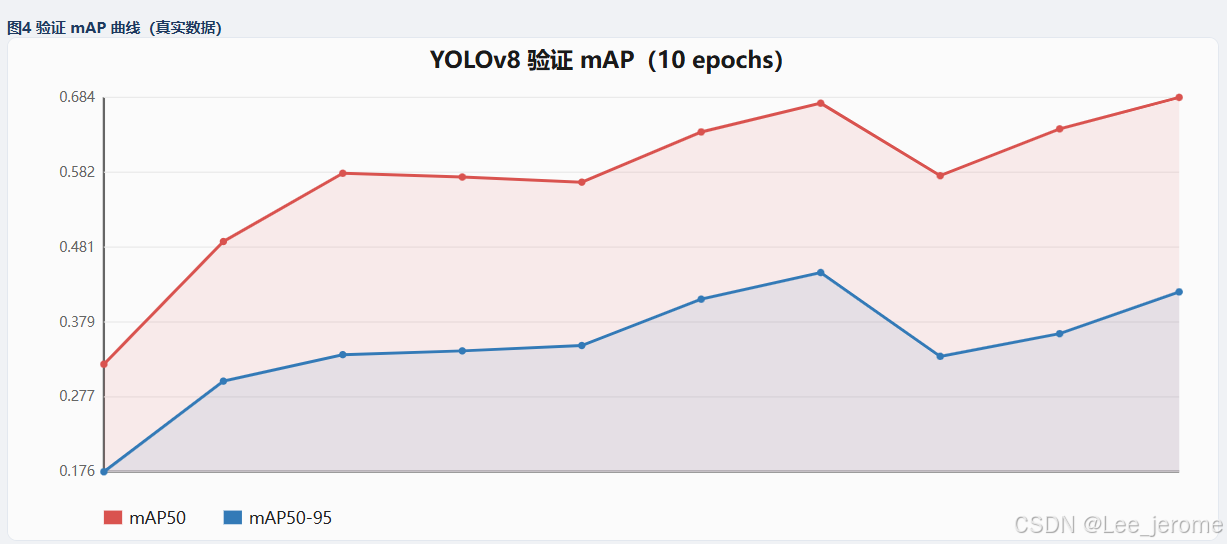
逐 epoch 真实指标汇总(来自 runs/*/results.csv,10 epochs 实测):
| epoch | box_loss | cls_loss | dfl_loss | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| 0 | 1.8230 | 3.5954 | 1.0938 | 0.3215 | 0.1756 |
| 1 | 1.7861 | 2.3122 | 1.0621 | 0.4883 | 0.2987 |
| 2 | 1.7273 | 2.0665 | 1.0165 | 0.5810 | 0.3347 |
| 3 | 1.4575 | 1.6340 | 0.9607 | 0.5758 | 0.3397 |
| 4 | 1.4759 | 1.4924 | 0.9661 | 0.5688 | 0.3471 |
| 5 | 1.5391 | 1.5059 | 0.9543 | 0.6371 | 0.4099 |
| 6 | 1.4493 | 1.2883 | 0.9533 | 0.6762 | 0.4460 |
| 7 | 1.3297 | 1.1527 | 0.9186 | 0.5778 | 0.3323 |
| 8 | 1.3770 | 1.1859 | 0.9385 | 0.6413 | 0.3631 |
| 9 | 1.3942 | 1.2219 | 0.9144 | 0.6841 | 0.4199 |
损失原理:YOLOv8 用三分量损失——
box_loss(CIoU 回归)+cls_loss(BCE 分类)+dfl_loss(Distribution Focal Loss,用于更精细的边界框分布回归)——这也是它与 v5/v6 的差异点。
图 3:训练损失曲线(真实数据)
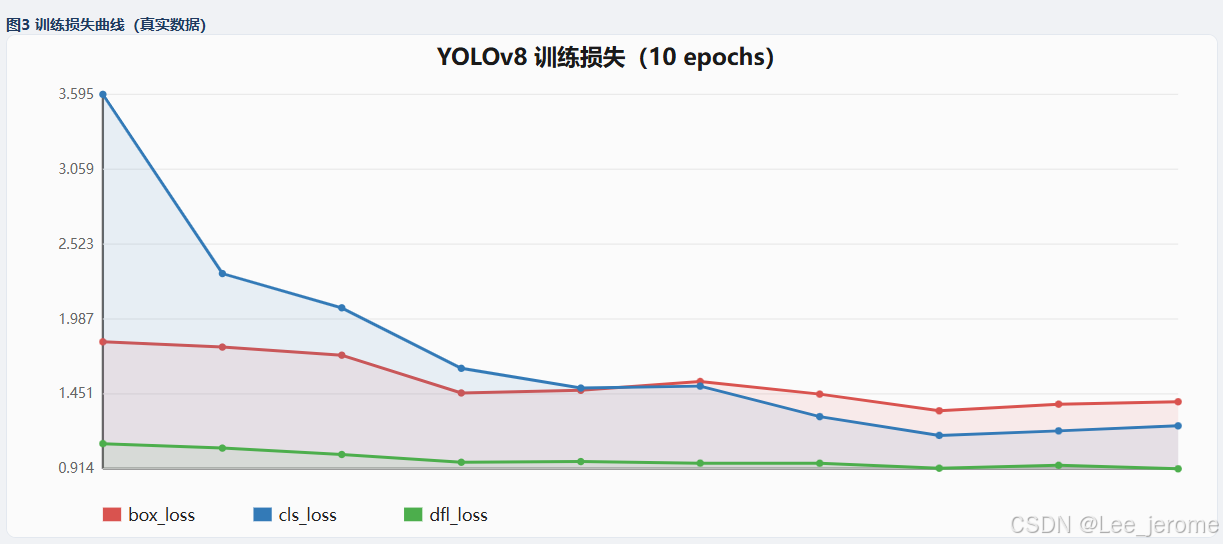
图 4:验证 mAP 曲线(真实数据)——COCO 预训练起步,第 1 个 epoch 结束 mAP50 已达 0.32,第 9 轮 0.684,迁移学习收敛极快。
配图复现:本文曲线/示意图由随文脚本 make_figs.py(仅依赖 numpy + 标准库)生成,用你训练后的 results.csv 数据替换脚本中的数值即可重绘。
4.5 网络结构原理解读
YOLOv8 相对 v5/v6 的关键变化(对应图 1):
- Backbone:C2f(跨阶段部分连接升级版)。用两个分支的 “残差堆叠 + concat” 结构替代 v5 的 C3,参数量略增但梯度流更丰富;末端仍为 SPPF 聚合多尺度感受野。
- Neck:PAN-FPN。上采样 + 下采样双向路径融合 P3/P4/P5 特征,与 v5 类似但后者在 v8 中已统一进 C2f 模块表达。
- Head:解耦头(Decoupled)。分类与回归分支彻底分离(v5 是耦合头),回归分支直接用 Anchor-Free 方式预测中心与宽高,并用 DFL 把框边距建模为分布;标签分配用 Task-Aligned Assigner。
- API 统一:
YOLO()一个类承载 detect / segment / classify / pose / obb 五种任务,后续版本的生态都建立在此之上。
推理折叠(fused)后模型实测:73 层,3,006,428 参数,0 梯度(低于 COCO 官方 3.2M 表述,因 4 类 head 更小)。
4.6 深度原理:关键痛点拆解
前面讲了"结构上有什么",这里回答训练与调参中最常问的"为什么",每个痛点配图。
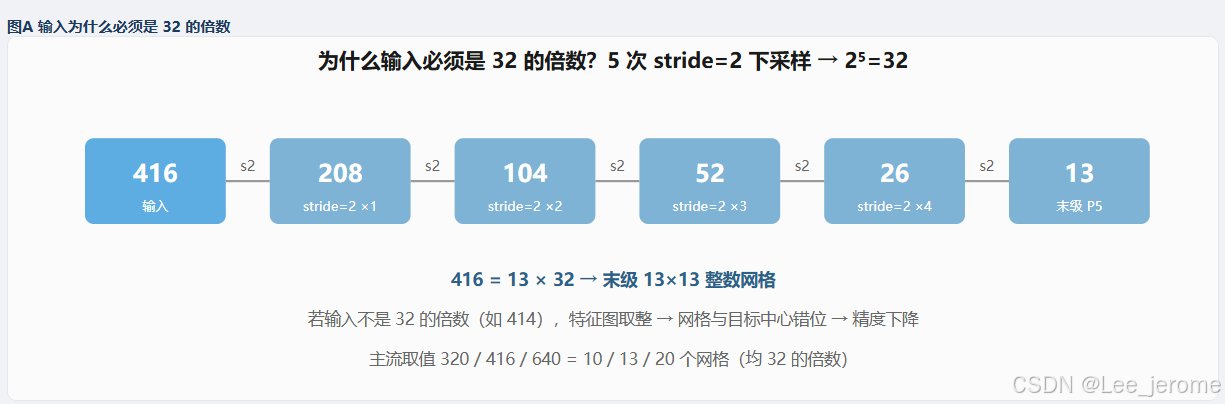
痛点 1:为什么输入必须是 32 的倍数?(416 而不是 414)
YOLOv8 主干同样有 5 次 stride=2 下采样,累计倍数 2⁵=32。416 = 13×32 → 末级输出 13×13 整数网格;若是 414,特征图取整后网格与目标中心错位,精度小幅下降。imgsz 永远取 32 倍数(320/416/640)。训练时框架会 letterbox 自动补齐到 32 倍数。
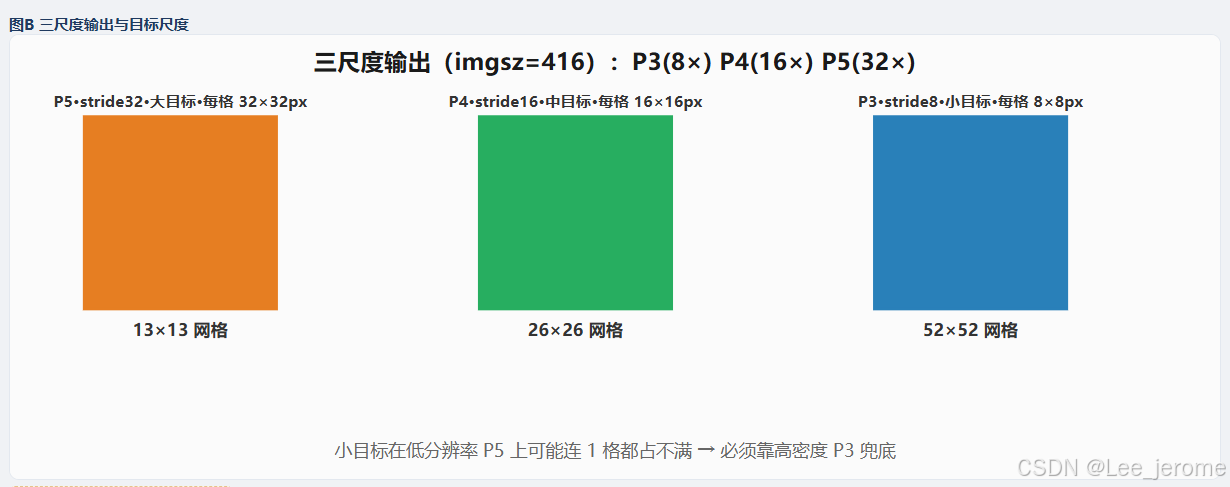
痛点 2:三尺度(P3/P4/P5)各自管什么?
416 输入:P5=13×13(stride 32,大目标)、P4=26×26(stride 16,中目标)、P3=52×52(stride 8,小目标)。小目标在 P5 上可能连 1 格都占不满,必须靠高密度 P3 兜底;这也是小目标检测普遍难、需要更高输入分辨率的根源。
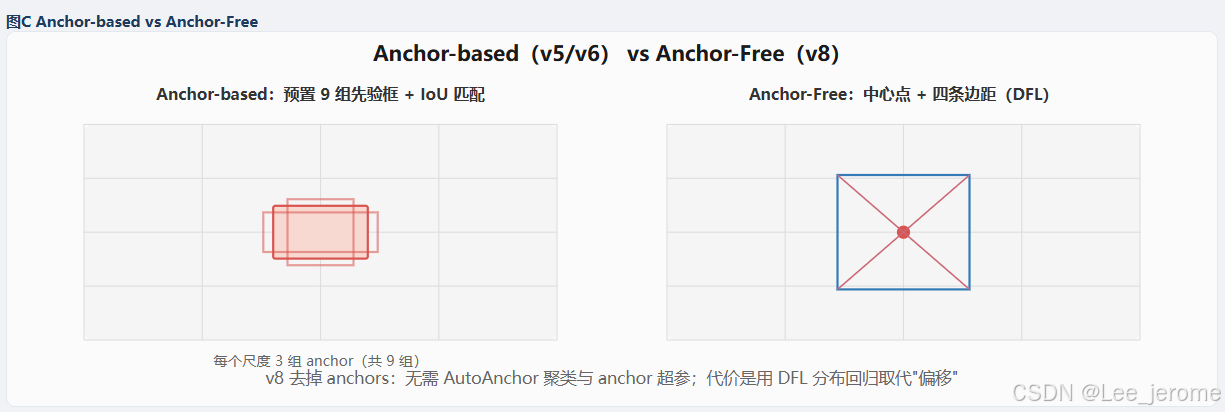
痛点 3:v8 的 anchor-free 到底免掉了什么?
YOLOv5/v6 用 9 组预置 anchors + IoU/SimOTA 匹配;v8 去掉 anchors:每个格子直接预测"中心点偏移 + 到四条边的距离"(配合痛点 7 的 DFL),标签分配改用 Task-Aligned 动态分配(同时考虑分类得分与 IoU 的联合代价选正样本)。
- 省掉的:anchors 的设计、AutoAnchor 聚类、anchor 相关的超参数;
- 代价:回归从"偏移"变成"绝对量",因此 DFL/分布回归成为必要补充。
文章开头 AutoAnchor 一节在 v5/v6 中频繁出现,本篇则完全不需要——这正是 anchor-free 的直观收益。
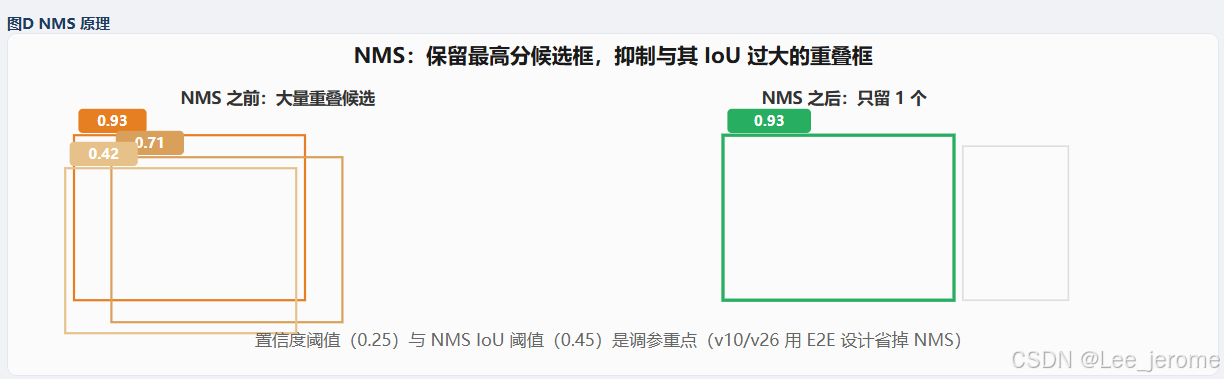
痛点 4:为什么最后一步还要 NMS?
即使 anchor-free,多格子/多尺度仍会输出大量重叠框。NMS:按置信度排序 → 保留最高 → 抑制 IoU>阈值的重叠框(默认 0.45)。置信度阈值(0.25)与 IoU 阈值是调参重点;v10/v26 推出的 E2E 无 NMS 训练正是想省掉这道后处理。
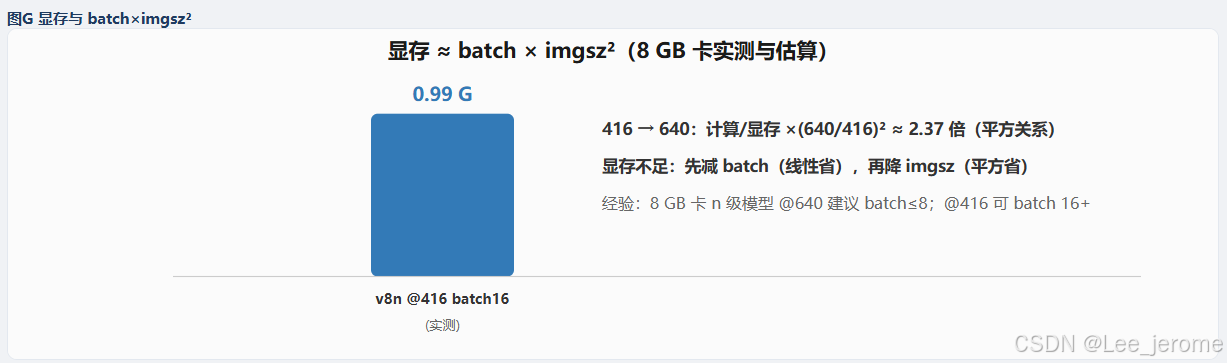
痛点 5:显存与 batch、imgsz 的关系(8 GB 卡怎么配)
开销 ≈ batch × imgsz²。416→640 即 ×2.37。本文实测:v8n @416 batch16 下 GPU 占用 0.99 GB(日志 GPU_mem)。显存紧张:先减 batch(线性),再降 imgsz(平方)。
痛点 6:从预训练权重起步为什么收敛快?
COCO 预训练 = 通用视觉特征库(边缘/纹理/形状),微调只换 80→4 类输出头 + 全网络小步适配。反映在数据上:第 1 个 epoch 结束 mAP50 已达 0.32(同一数据集,v5 首轮 0.0008、v6 0.094),说明 v8 的预训练配方与数据增强让迁移性能更早起飞。
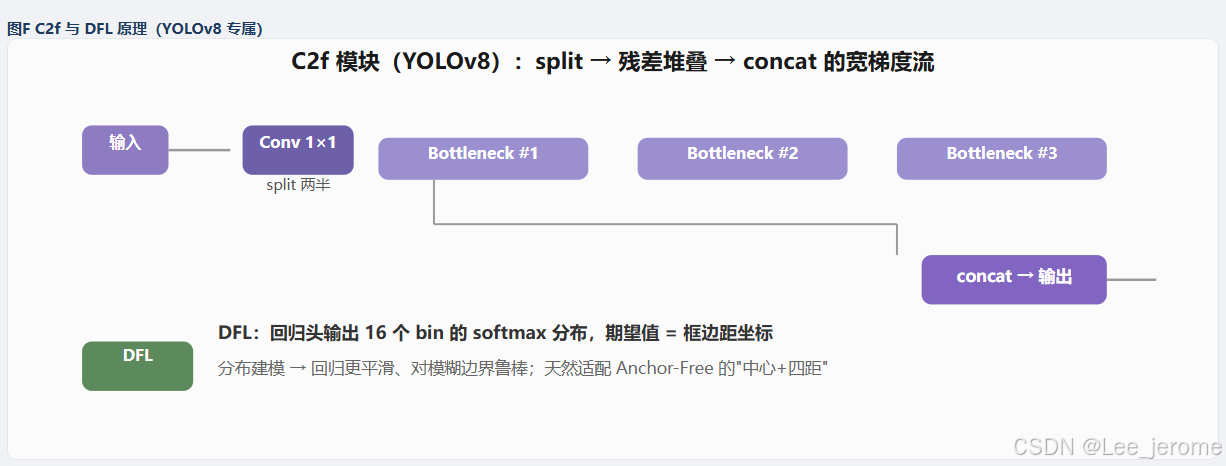
痛点 7(v8 专属):C2f 和 DFL 分别解决了什么?
- C2f(图 F 上半):输入 1×1 卷积后 split 成两半,一半直接走后续,另一半串 N 个 Bottleneck 残差块,末端与旁路 concat。相比 v5 的 C3,C2f 让更宽的梯度通路保留浅层信息——网络加深时不丢细节,是 v8 精度提升的结构基础。
- DFL(Distribution Focal Loss,图 F 下半):回归头不再输出一个"边框宽度数值",而是输出 16 个 bin 的 softmax 分布,用期望值作为预测坐标。分布建模让回归更平滑、对模糊边界更鲁棒,也天然适配 anchor-free 的"四边距"预测。
4.7 操作异常实录
实操中遇到的异常与分析(通用化描述,供读者对照)。
异常 1:训练输出目录落点与预期不一致(Windows 特殊路径场景)
- 现象:相对路径形式的
project(如../../runs)在部分 Windows 目录(含链接/别名/junction)环境下,输出被写到解析后的"真实路径"侧,与直觉的当前工作目录不一致,导致续训时找不到权重。 - 原因:相对路径基于进程实际工作目录解析,跨工具/跨进程(shell vs Python)时路径视角可能不同。
- 解决:训练脚本中基于脚本所在位置推导绝对路径(
Path(__file__).resolve().parent逐级上溯)后再拼接project/weights,彻底摆脱 “当前目录在哪” 的歧义;养成"读目录确认落点"的习惯。 - 状态:已解决(改用绝对路径后输出与续训均稳定)。
异常 2:源数据 JPEG 损坏告警
- 现象:训练/验证时反复出现
Corrupt JPEG data: 2 extraneous bytes before marker 0xd9。 - 原因:数据集中少量 JPEG 文件尾部多余字节,OpenCV 自动容错并跳过。
- 解决:无需处理,不影响训练与指标。
- 状态:已解决(自动容错)。
异常 3:分段训练超时中断
- 现象:两次串行分段训练中,第二段可能因累积耗时被运行时限中断(epoch 未完成、未保存 ckpt)。
- 解决:每段单独运行并确认
weights/下已生成best.pt再启动下一段。 - 状态:已解决(重跑该段)。
5. 测试验证
5.1 验证集指标(val,使用第 3 段输出的 best.pt)
yolo detect val model=runs/train/exp3/weights/best.pt \
  data=objdet.yaml imgsz=416 batch=16 device=0
实测输出(val 集 298 张 / 420 个实例):
| 类别 | 实例数 | P | R | mAP50 | mAP50-95 |
|---|---|---|---|---|---|
| person | 251 | 0.811 | 0.709 | 0.771 | 0.404 |
| car | 100 | 0.727 | 0.878 | 0.842 | 0.618 |
| dog | 62 | 0.779 | 0.569 | 0.648 | 0.325 |
| insect | 7 | 0.482 | 0.714 | 0.474 | 0.334 |
| all | 420 | 0.700 | 0.718 | 0.684 | 0.420 |
- 四类全部达标,mAP50 从 0.474 到 0.842;insect(仅训练 16 条)也达到了 0.474,明显好于前两篇同数据(v5 0.131 / v6 0.069)——v8 的设计(Anchor-Free + DFL + 更强增强)对少样本类别更友好。
- 推理速度实测:
preprocess 0.3ms, inference 1.0ms, postprocess 0.8ms(batch 16,416×416,GPU)。
6. 总结
一句话定位:YOLOv8 是本系列的分水岭——它以全任务统一 API + Anchor-Free/DFL 精度范式终结了 v5 时代,后续 v9/v10/11/26 全部建立在同一套 API 与训练哲学之上。
实测复盘(同一数据集 10 epochs,RTX 5060 Ti,ultralytics 8.4.118):
| 项 | 实测 | 一句话判断 |
|---|---|---|
| mAP50 / mAP50-95 | 0.684 / 0.420(独立复测同值) | 三篇最高,较 v5 提升约 49% |
| 单张推理 | 1.0 ms(GPU @416) | 比 v6 稍慢,属 Anchor-Free 回归路径的正常成本 |
| 显存占用 | 0.99 GB(batch 16 @416) | n 模型友好 |
| 训练耗时 | 10 epochs ≈ 2 分钟 | 全系列最快,配方成熟 |
系列同配置对比(同一数据集、同样 10 epochs、同机复测):
| 版本 | mAP50 | mAP50-95 | 推理 ms | 少样本类 insect mAP50 |
|---|---|---|---|---|
| YOLOv5 | 0.460 | 0.224 | 1.1 | 0.131 |
| YOLOv6 | 0.287 | 0.196 | 0.75 | 0.069 |
| YOLOv8 | 0.684 | 0.420 | 1.0 | 0.474 |
核心机制实证(对应 4.6 深度原理):DFL 分布回归 + Task-Aligned 分配的价值在最难处体现——insect 仅 16 条训练样本,mAP50 仍达 0.474(v5 0.131 / v6 0.069);C2f 更宽的梯度通路让"第 1 个 epoch 即达 0.32"(v5 首轮 0.0008)。这些数字正是"Anchor-Free + 分布回归"范式收益的直接证据。
诚实局限:推理速度(1.0 ms)略逊于重参数化的 v6(0.75 ms);回归精度有上限,追求更快需 v6 部署路线、追求端到端无 NMS 需看本系列 v10/v26;生态强依赖 ultralytics 包与网络。
决策建议:新项目默认起点——精度、速度、多任务、生态四者最平衡;无语义分割等特殊需求基本无需再回头看 v5/v6。
踩坑速记:训练脚本建议"基于脚本位置推导绝对路径"避免输出目录歧义(4.7 异常 1);分段续训先确认 best.pt(异常 3);Corrupt JPEG 可忽略(异常 2)。
📖 下集预告(系列 4/7):YOLOv9——PGI 可编程梯度信息:从"训练机制"对抗信息瓶颈,训练方法论第一次当主角。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)