点云数据聚类处理流程
·
点云数据聚类处理流程
点云数据聚类处理是将点云数据中的点按照相似性划分为不同的组(簇)的过程,在目标识别、场景分析等领域有广泛应用。以下是一个通用的点云数据聚类处理流程:
1. 数据获取
- 激光雷达采集:利用激光雷达设备对物体或场景进行扫描,获取三维空间中各个点的坐标信息,形成点云数据。常见的激光雷达有机械式激光雷达、固态激光雷达等,不同类型的激光雷达在精度、扫描范围和速度等方面有所差异。
- 三维重建:通过多视角的图像数据,利用结构光、双目视觉等技术进行三维重建,生成点云数据。这种方法常用于文物数字化、建筑建模等领域。
- 数据导入:从已有的数据集中导入点云数据,例如 KITTI、ModelNet 等公开数据集,方便进行算法测试和验证。
2. 数据预处理
- 去噪
- 统计滤波:计算每个点邻域内点的距离统计信息,将距离超过一定标准差倍数的点视为离群点并去除。在 Open3D 中可以使用
remove_statistical_outlier函数实现。 - 半径滤波:以每个点为中心,设置一个半径范围,若该范围内的点数少于某个阈值,则将该点视为离群点并去除。
- 统计滤波:计算每个点邻域内点的距离统计信息,将距离超过一定标准差倍数的点视为离群点并去除。在 Open3D 中可以使用
- 降采样
- 体素降采样:将点云划分为体素网格,每个体素内只保留一个代表点,从而减少点云的点数,提高后续处理的效率。在 Open3D 中可以使用
voxel_down_sample函数实现。 - 均匀采样:按照一定的间隔均匀地选择点云数据中的点。
- 体素降采样:将点云划分为体素网格,每个体素内只保留一个代表点,从而减少点云的点数,提高后续处理的效率。在 Open3D 中可以使用
- 归一化:将点云数据的坐标范围归一化到一个特定的区间,如
[0, 1]或[-1, 1],有助于提高聚类算法的稳定性和收敛速度。
3. 特征提取
- 几何特征
- 法线估计:计算点云每个点的法线方向,反映点云表面的局部几何信息。在 Open3D 中可以使用
estimate_normals函数实现。 - 曲率计算:描述点云表面的弯曲程度,可用于区分平面、曲面等不同的几何形状。
- 法线估计:计算点云每个点的法线方向,反映点云表面的局部几何信息。在 Open3D 中可以使用
- 描述子特征
- FPFH(Fast Point Feature Histograms):一种快速计算的局部特征描述子,能够有效地表示点云的局部几何特征。
- SHOT(Signature of Histograms of Orientations):对表面方向直方图进行签名,具有旋转不变性和尺度不变性。
4. 聚类算法选择与应用
- 基于密度的聚类算法
- DBSCAN(Density-Based Spatial Clustering of Applications with Noise):基于数据点的密度来进行聚类,能够将具有足够高密度的区域划分为簇,并将低密度区域中的点视为噪声点。在 Open3D 中可以使用
cluster_dbscan函数实现。 - OPTICS(Ordering Points To Identify the Clustering Structure):是 DBSCAN 的一种扩展算法,能够处理不同密度的簇,并且可以生成聚类的层次结构。
- DBSCAN(Density-Based Spatial Clustering of Applications with Noise):基于数据点的密度来进行聚类,能够将具有足够高密度的区域划分为簇,并将低密度区域中的点视为噪声点。在 Open3D 中可以使用
- 基于层次的聚类算法
- 凝聚式层次聚类:从每个点作为一个单独的簇开始,逐步合并相似的簇,直到满足某个终止条件。
- 分裂式层次聚类:从所有点作为一个簇开始,逐步分裂成更小的簇。
- 基于划分的聚类算法
- K-Means:将点云数据划分为
K个簇,每个簇的中心由该簇内所有点的均值表示。该算法需要预先指定簇的数量K。
- K-Means:将点云数据划分为
5. 聚类结果评估
- 内部评估指标
- 轮廓系数:综合考虑了簇内的紧密性和簇间的分离度,取值范围为
[-1, 1],值越接近 1 表示聚类效果越好。 - Calinski-Harabasz 指数:衡量簇内的紧凑性和簇间的分离度,值越大表示聚类效果越好。
- 轮廓系数:综合考虑了簇内的紧密性和簇间的分离度,取值范围为
- 外部评估指标:如果有已知的真实标签,可以使用外部评估指标,如调整兰德指数(Adjusted Rand Index)、F1 分数等,来评估聚类结果与真实标签的一致性。
6. 后处理
- 合并小簇:将点数较少的小簇合并到相邻的大簇中,减少簇的数量,使聚类结果更加简洁。
- 去除噪声簇:将点数过少或不符合特定条件的簇视为噪声簇并去除,提高聚类结果的质量。
7. 结果可视化与应用
- 可视化:使用可视化工具(如 Open3D、Matplotlib 等)将聚类结果以直观的方式展示出来,方便用户观察和分析。
- 应用:将聚类结果应用于实际场景,如目标识别、物体分割、场景理解等。
以下是一个使用 Open3D 实现点云聚类处理的简单示例代码:
import open3d as o3d
import numpy as np

# 读取点云数据
pcd = o3d.io.read_point_cloud("table_scene_lms400.pcd")

# 预处理:去噪与降采样
cl, _ = pcd.remove_statistical_outlier(nb_neighbors=10, std_ratio=0.6)
voxel_pcd = cl.voxel_down_sample(voxel_size=0.01)
# 法线估计
voxel_pcd.estimate_normals(search_param=o3d.geometry.KDTreeSearchParamHybrid(radius=0.1, max_nn=50))

# 平面分割(RANSAC)
plane_model, inliers = voxel_pcd.segment_plane(distance_threshold=0.01, ransac_n=3, num_iterations=1000)
inlier_cloud = voxel_pcd.select_by_index(inliers)
outlier_cloud = voxel_pcd.select_by_index(inliers, invert=True)

# 运行DBSCAN算法
with o3d.utility.VerbosityContextManager(o3d.utility.VerbosityLevel.Debug) as cm:
    labels = np.array(outlier_cloud.cluster_dbscan(eps=0.05, min_points=20, print_progress=True))

# 获取聚类的最大标签
max_label = labels.max()
print(f"点云被聚类成了 {max_label + 1} 个簇。")

# 为每个簇分配不同的颜色
colors = o3d.utility.Vector3dVector(np.random.uniform(0, 1, (max_label + 1, 3)))
print(np.asarray(colors))

pcd_colors = np.array([colors[label] if label >= 0 else [0, 0, 0] for label in labels])
outlier_cloud.colors = o3d.utility.Vector3dVector(pcd_colors)

# 可视化聚类结果
o3d.visualization.draw_geometries([outlier_cloud])

# 保存聚类结果
o3d.io.write_point_cloud("clustered_point_cloud.pcd", outlier_cloud)

# 统计每个label的点的数量
unique_labels, counts = np.unique(labels, return_counts=True)
# 排除噪声点(label为 -1)
non_noise_indices = unique_labels != -1
unique_labels = unique_labels[non_noise_indices]
counts = counts[non_noise_indices]

# 找到点数最多的label
max_count_index = np.argmax(counts)
max_count_label = unique_labels[max_count_index]

# 找到所有属于点数最多的label的点的索引
max_count_indices = np.where(labels == max_count_label)[0]

# 根据索引提取点数最多的label对应的点云
max_count_cloud = outlier_cloud.select_by_index(max_count_indices)

# 可视化提取的点云
o3d.visualization.draw_geometries([max_count_cloud])

# 保存提取的点云
o3d.io.write_point_cloud(f"max_count_label_{max_count_label}_point_cloud.pcd", max_count_cloud)
该代码主要实现了对输入点云数据的一系列处理操作,包括去噪、降采样、法线估计、平面分割、DBSCAN 聚类,最后统计聚类结果中每个簇的点数,提取点数最多的簇并进行可视化和保存。
代码详细解释
- 导入必要的库
import open3d as o3d
import numpy as np
导入 open3d 用于点云处理和可视化,numpy 用于数值计算和数组操作。
- 读取点云数据
pcd = o3d.io.read_point_cloud("table_scene_lms400.pcd")
使用 o3d.io.read_point_cloud 函数从文件 table_scene_lms400.pcd 中读取点云数据。
- 数据预处理
cl, _ = pcd.remove_statistical_outlier(nb_neighbors=10, std_ratio=0.6)
voxel_pcd = cl.voxel_down_sample(voxel_size=0.01)
voxel_pcd.estimate_normals(search_param=o3d.geometry.KDTreeSearchParamHybrid(radius=0.1, max_nn=50))
remove_statistical_outlier:通过统计每个点邻域内点的距离,去除离群点(噪声点)。nb_neighbors是用于统计的邻域点数,std_ratio是标准差倍数的阈值。voxel_down_sample:进行体素降采样,将点云划分为体素网格,每个体素内只保留一个代表点,voxel_size是体素的大小。estimate_normals:估计点云每个点的法线方向,search_param指定搜索参数,这里使用混合搜索策略,radius是搜索半径,max_nn是最大搜索点数。
- 平面分割(RANSAC)
plane_model, inliers = voxel_pcd.segment_plane(distance_threshold=0.01, ransac_n=3, num_iterations=1000)
inlier_cloud = voxel_pcd.select_by_index(inliers)
outlier_cloud = voxel_pcd.select_by_index(inliers, invert=True)
segment_plane:使用 RANSAC 算法进行平面分割,distance_threshold是点到拟合平面的距离阈值,ransac_n是每次随机抽样的点数,num_iterations是迭代次数。返回平面模型参数plane_model和属于平面的点的索引inliers。select_by_index:根据索引提取点云,inlier_cloud是属于平面的点云,outlier_cloud是不属于平面的点云。
- 运行 DBSCAN 算法
with o3d.utility.VerbosityContextManager(o3d.utility.VerbosityLevel.Debug) as cm:
    labels = np.array(outlier_cloud.cluster_dbscan(eps=0.05, min_points=20, print_progress=True))
使用上下文管理器将日志详细程度设置为 Debug 级别,对 outlier_cloud 进行 DBSCAN 聚类,eps 是邻域半径,min_points 是成为核心点所需的最小点数,print_progress 表示是否打印聚类进度。
- 聚类结果分析与可视化
max_label = labels.max()
print(f"点云被聚类成了 {max_label + 1} 个簇。")
colors = o3d.utility.Vector3dVector(np.random.uniform(0, 1, (max_label + 1, 3)))
pcd_colors = np.array([colors[label] if label >= 0 else [0, 0, 0] for label in labels])
outlier_cloud.colors = o3d.utility.Vector3dVector(pcd_colors)
o3d.visualization.draw_geometries([outlier_cloud])
o3d.io.write_point_cloud("clustered_point_cloud.pcd", outlier_cloud)
- 计算聚类的最大标签,加 1 得到聚类的数量并打印。
- 为每个簇随机分配不同的颜色,噪声点(标签为 -1)设为黑色。
- 将颜色信息赋值给
outlier_cloud的colors属性,可视化聚类结果并保存为clustered_point_cloud.pcd文件。
- 提取点数最多的簇
unique_labels, counts = np.unique(labels, return_counts=True)
non_noise_indices = unique_labels != -1
unique_labels = unique_labels[non_noise_indices]
counts = counts[non_noise_indices]
max_count_index = np.argmax(counts)
max_count_label = unique_labels[max_count_index]
max_count_indices = np.where(labels == max_count_label)[0]
max_count_cloud = outlier_cloud.select_by_index(max_count_indices)
o3d.visualization.draw_geometries([max_count_cloud])
o3d.io.write_point_cloud(f"max_count_label_{max_count_label}_point_cloud.pcd", max_count_cloud)
- 统计每个
label的点的数量,排除噪声点(label为 -1)。 - 找到点数最多的
label,提取该label对应的点云,可视化并保存为文件。
- 代码优化建议
- 参数调优:可以通过实验调整
remove_statistical_outlier、voxel_down_sample、segment_plane和cluster_dbscan等函数的参数,以获得更好的处理和聚类效果。 - 多次平面分割:可以多次调用
segment_plane函数,逐步分割出多个平面,提高点云处理的精度。 - 添加更多评估指标:除了统计点数,还可以使用内部评估指标(如轮廓系数、Calinski - Harabasz 指数)或外部评估指标(如果有真实标签)来评估聚类结果的质量。
from sklearn.metrics import silhouette_score, calinski_harabasz_score
# 排除噪声点后进行评估
non_noise_points = np.asarray(outlier_cloud.points)[labels != -1]
non_noise_labels = labels[labels != -1]

# 计算轮廓系数
if len(set(non_noise_labels)) > 1:  # 轮廓系数要求至少有两个簇
    silhouette_coefficient = silhouette_score(non_noise_points, non_noise_labels)
    print(f"轮廓系数: {silhouette_coefficient}")
else:
    print("由于只有一个簇,无法计算轮廓系数。")

# 计算Calinski - Harabasz指数
if len(set(non_noise_labels)) > 1:  # Calinski - Harabasz指数要求至少有两个簇
    calinski_harabasz = calinski_harabasz_score(non_noise_points, non_noise_labels)
    print(f"Calinski - Harabasz指数: {calinski_harabasz}")
else:
    print("由于只有一个簇,无法计算Calinski - Harabasz指数。")
轮廓系数: 0.34218226564564175
Calinski - Harabasz指数: 1208.8283085347264
9. 结果
原始点云:
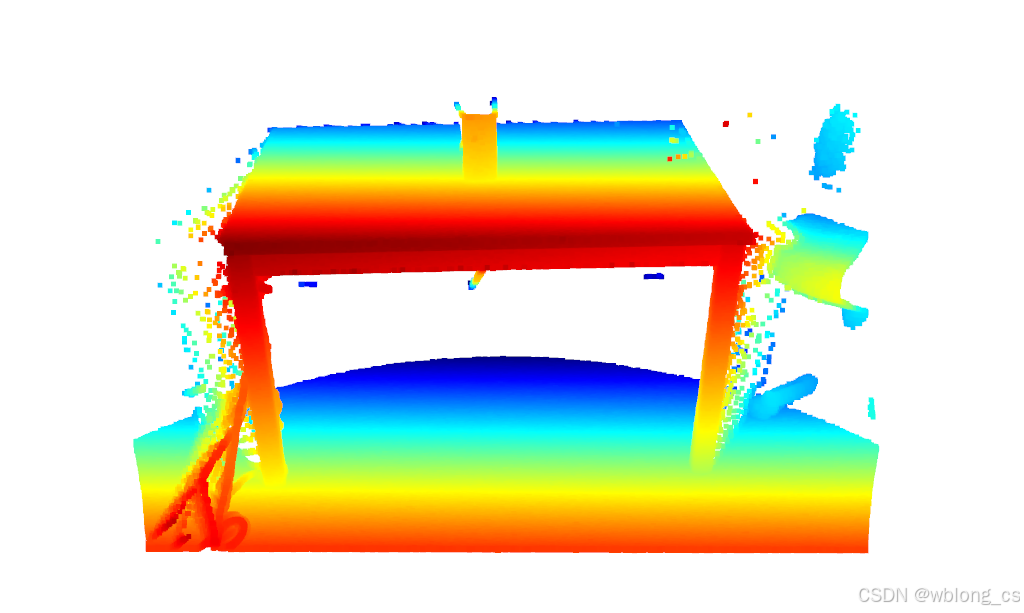
显然,数据中包含一个类似地面的平面,聚类之前可以将这个平面单独提取出来。
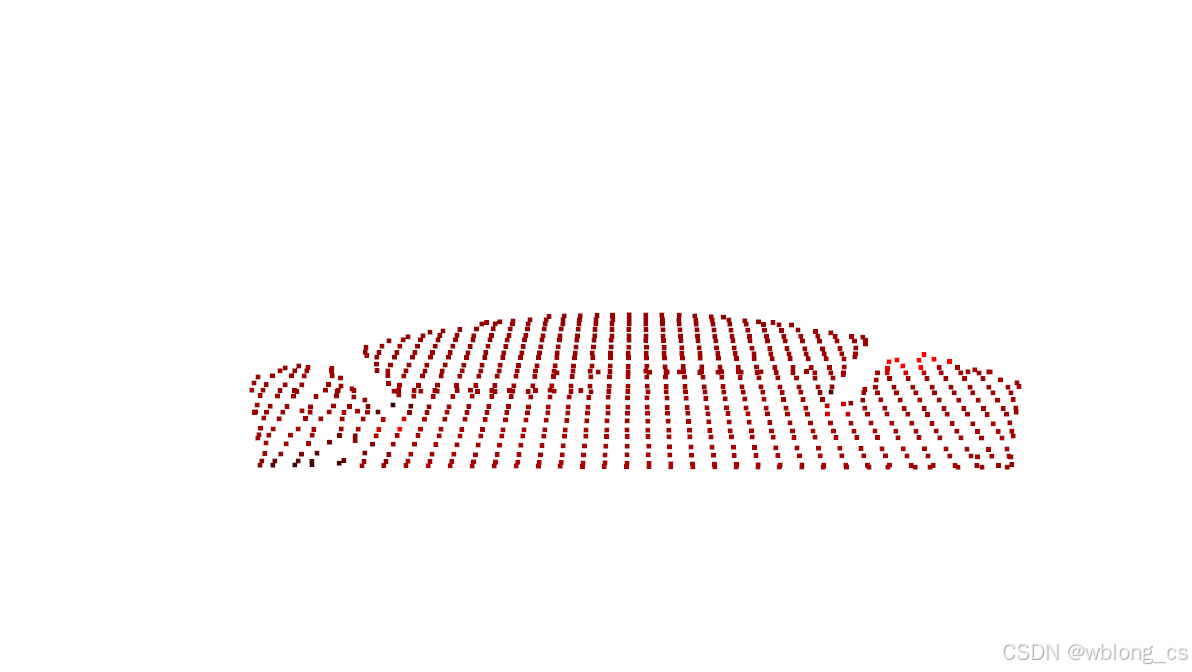
去除地面后,聚类结果:
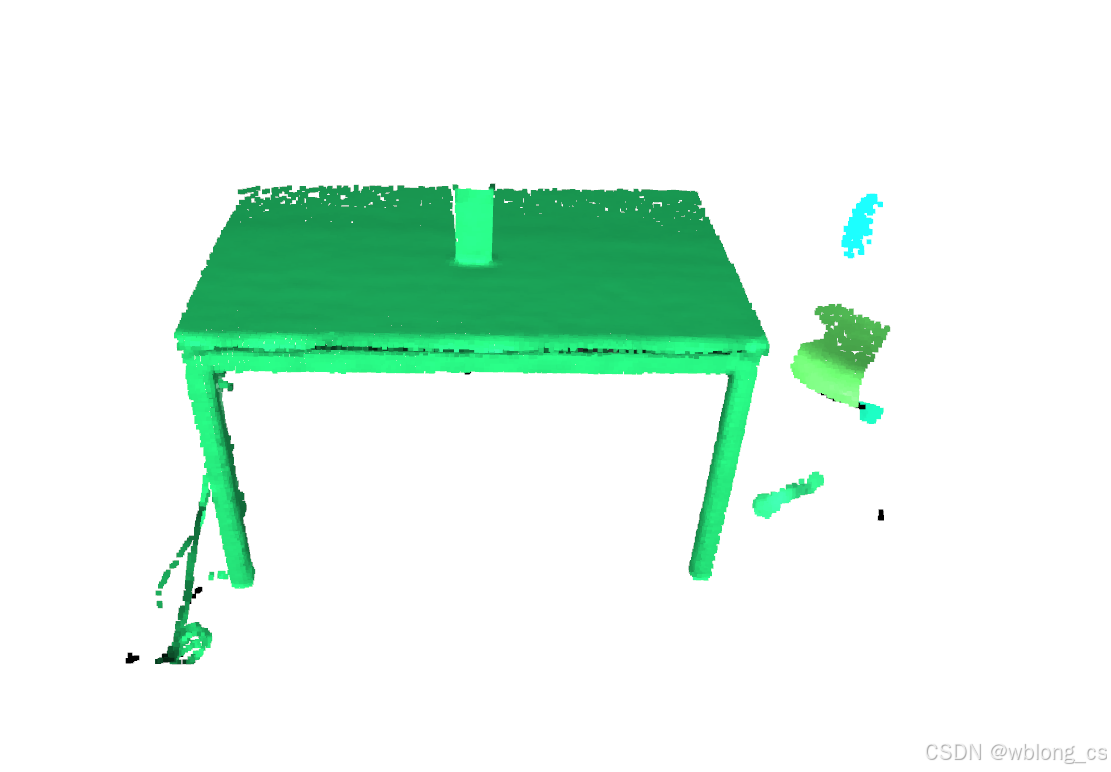
从聚类结果中,提取桌子这个簇:


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献2条内容

所有评论(0)