使用交叉监督进行半监督语义分割(CVPR2021语义分割)
今天和大家分享CVPR2021中语义分割领域的一篇文章,面向半监督语义分割领域。
论文下载链接:https://arxiv.org/abs/2106.01226
代码下载链接:https://github.com/charlesCXK/TorchSemiSeg
0.动机
训练语义分割任务的卷积神经网络通常需要像素级别(pixel-level)的人工标注,相比于其他视觉任务,这种标注信息较为昂贵。因此,使用半监督方法,利用带标注信息的数据和无标注信息的数据一起训练语义分割网络是很有意义的。
作者提出了cross pseudo supervision方法,利用无标签数据和有标签数据共同训练网络,相当于扩充了数据集,提高了网络性能。
1.Cross Pseudo Supervision
假设有包含NNN张带标注的图片集合,记作Dl\mathcal{D}^{l}Dl;以及包含MMM张不带标注的图片集合,记作Du\mathcal{D}^{u}Du。半监督学习的目的是利用带标注和不带标注的图片训练网络。
构建同样结构、权重初始值不同的2个语义分割网络:
P1=f(X;θ1)P2=f(X;θ2) \begin{aligned} &\mathrm{P}_{1}=f\left(\mathrm{X} ; \boldsymbol{\theta}_{1}\right) \\ &\mathrm{P}_{2}=f\left(\mathrm{X} ; \boldsymbol{\theta}_{2}\right) \end{aligned} P1=f(X;θ1)P2=f(X;θ2)
上式中的θ1\boldsymbol{\theta}_{1}θ1和θ2\boldsymbol{\theta}_{2}θ2分别表示2个网络的权重,X\mathrm{X}X表示经过增强变换后的输入图片。
P1\mathrm{P}_{1}P1和P2\mathrm{P}_{2}P2表示语义分割网络中最后的softmax层的输出。
cross pseudo supervision方法如下图所示:
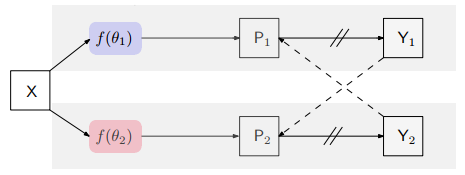
上图中的Y1\mathrm{Y}_{1}Y1和Y2\mathrm{Y}_{2}Y2分别表示2个网络输出的one hot标签,⟶\longrightarrow⟶表示前向计算,−−→--\rightarrow−−→表示监督信息的传播,//////表示不进行梯度计算。
将带标签的数据输入2个网络,使用ground truth分别监督这2个网络进行训练。
对于无标签的数据,输入同样的图片到2个网络中,分别得到各自的输出结果,这里将输出结果称为伪标签(pseudo label)。利用网络f(θ1)f\left(\theta_{1}\right)f(θ1)得到的伪标签监督网络f(θ2)f\left(\theta_{2}\right)f(θ2)的训练,同时,利用网络f(θ2)f\left(\theta_{2}\right)f(θ2)得到的伪标签监督网络f(θ1)f\left(\theta_{1}\right)f(θ1)的训练。
使用带标签的数据训练时,用像素级别的交叉熵损失,损失函数为:
Ls=1∣Dl∣∑X∈Dl1W×H∑i=0W×H(ℓce(p1i,y1i∗)+ℓce(p2i,y2i∗))\mathcal{L}_{s}=\frac{1}{\left|\mathcal{D}^{l}\right|} \sum_{\mathbf{X} \in \mathcal{D}^{l}} \frac{1}{W \times H} \sum_{i=0}^{W \times H}\left(\ell_{c e}\left(\mathbf{p}_{1 i}, \mathbf{y}_{1 i}^{*}\right)+\ell_{c e}\left(\mathbf{p}_{2 i}, \mathbf{y}_{2 i}^{*}\right)\right)Ls=∣Dl∣1X∈Dl∑W×H1i=0∑W×H(ℓce(p1i,y1i∗)+ℓce(p2i,y2i∗))
上式中的ℓce\ell_{c e}ℓce表示交叉熵损失,y1i∗\mathbf{y}_{1 i}^{*}y1i∗和y2i∗\mathbf{y}_{2 i}^{*}y2i∗表示ground truth,WWW和HHH分别表示输入图片的宽和高。
使用无标签的数据训练时,使用网络f(θ1)f\left(\theta_{1}\right)f(θ1)的输出Y1\mathrm{Y}_{1}Y1监督网络f(θ2)f\left(\theta_{2}\right)f(θ2)的输出P2\mathrm{P}_{2}P2;同时,使用网络f(θ2)f\left(\theta_{2}\right)f(θ2)的输出Y2\mathrm{Y}_{2}Y2监督网络f(θ1)f\left(\theta_{1}\right)f(θ1)的输出P1\mathrm{P}_{1}P1。定义cross pseudo supervision损失函数为:
Lcps u=1∣Du∣∑X∈Du1W×H∑i=0W×H(ℓce(p1i,y2i)+ℓce(p2i,y1i))\mathcal{L}_{\text {cps }}^{u}=\frac{1}{\left|\mathcal{D}^{u}\right|} \sum_{\mathbf{X} \in \mathcal{D}^{u}} \frac{1}{W \times H} \sum_{i=0}^{W \times H}\left(\ell_{c e}\left(\mathbf{p}_{1 i}, \mathbf{y}_{2 i}\right)+\ell_{c e}\left(\mathbf{p}_{2 i}, \mathbf{y}_{1 i}\right)\right)Lcps u=∣Du∣1X∈Du∑W×H1i=0∑W×H(ℓce(p1i,y2i)+ℓce(p2i,y1i))
对于带标签的数据,除了使用普通的监督方法训练外,也使用上述方法进行训练,损失函数记作Lcps l\mathcal{L}_{\text {cps }}^{l}Lcps l。融合了带标签数据和无标签数据的cross pseudo supervision损失函数为:
Lcps=Lcpsl+Lcpsu \mathcal{L}_{c p s}=\mathcal{L}_{c p s}^{l}+\mathcal{L}_{c p s}^{u} Lcps=Lcpsl+Lcpsu
因此,整体损失函数为:
L=Ls+λLcps \mathcal{L}=\mathcal{L}_{s}+\lambda \mathcal{L}_{c p s} L=Ls+λLcps
上式中的λ\lambdaλ用于平衡2种损失的重要程度。
在实现过程中,作者使用了CutMix增强方法。在生成pseudo时,将2张图片输入网络中,对网络的输出结果进行混合作为监督信息;在训练时,输入为2张图片CutMix的结果。
2.实验结果
使用DeepLabv3+方法进行语义分割,在网络初始化时,2个网络backbone部分使用同样的ImageNet预训练权重,Segmentation Head部分使用不同的随机初始化权重。
分别使用ResNet-50和ResNet-101作为Backbone,在Cityscapes数据集上训练。在该数据集上,随机采样总数据集的1/2、1/4、1/8、1/16作为带标签的数据,其余图片作为不带标签的数据。在实现时,令损失函数中λ\lambdaλ的值为6。
在Cityscapes的验证集上测试,使用cross pseudo supervision方法对性能的提升情况如下图所示:
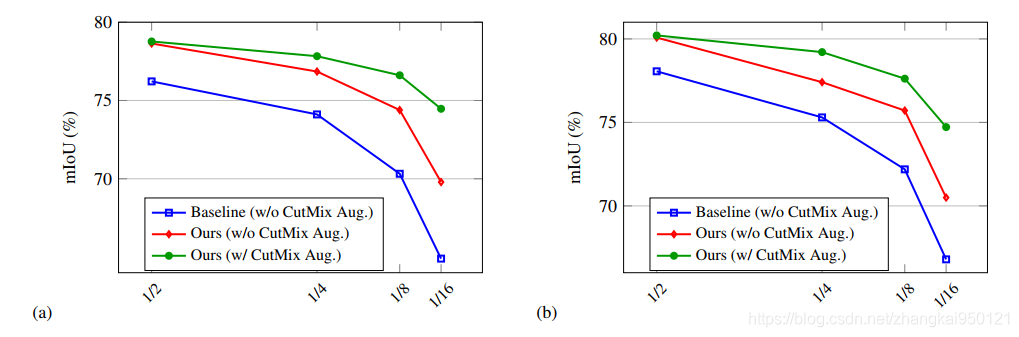
上图中图(a)表示使用ResNet-50作为Backbone,图(b)表示使用ResNet-101作为Backbone。Baseline表示只在带标签的数据集上训练得到的网络模型,“w/o CutMix Aug.”表示未使用CutMix增强方法,“w/ CutMix Aug.”表示使用了CutMix增强方法。
从上图中可以看出cross pseudo supervision方法能够充分利用不带标签的数据集,有效地提升网络性能;且使用CutMix增强方法能进一步提升网络性能。
下表为cross pseudo supervision方法与其他半监督学习方法的性能对比情况,同样是在Cityscapes的验证集上进行测试:
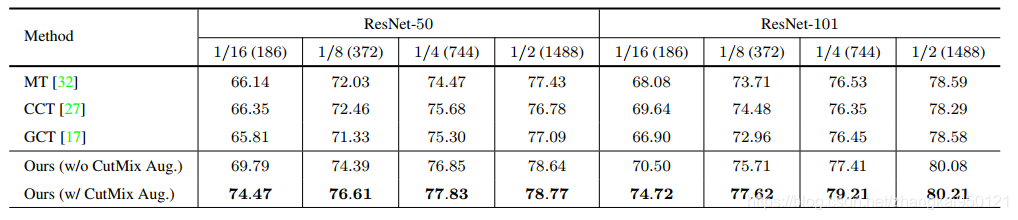
上表中的“MT”表示Mean-Teacher,“CCT”表示Cross-Consistency Training,“GCT”表示Guided Collaborative Training。
从上表中可以看出,使用cross pseudo supervision方法训练的网络有更强的性能,配合CutMix方法能进一步提升性能。
3.总结
作者提出了cross pseudo supervision方法,用于半监督语义分割,该方法简单、方便,性能优于同类半监督语义分割方法。此外,该方法配合CutMix使用,能进一步增强网络性能。
如果你对计算机视觉中的目标检测、跟踪、分割、轻量化神经网络感兴趣,欢迎关注公众号一起学习交流~

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)