Sequence的处理+自注意力机制+transformer
参考视频:https://www.bilibili.com/video/BV1v3411r78R?p=4&spm_id_from=pageDriver&vd_source=7266164bac828afa96b5c3e3dcb1b738
Sequence的处理
input是Sequence的情况下,会存在1. 序列长度不一定固定;2. 输出序列长度不一定固定等问题。
对于一般性的Sequence处理应用有:
- 对词汇/语句:通过One-hot或embedding对各个词汇进行编码
- 对语音信号:通过一个窗口的移动(常用窗宽25ms,stride为10ms),构成一个向量组输入信息
- 对图:每个点可以看作是一个样本对象,其边就是其样本数据
根据output的维度分为3种情况:
- 输出维度确定的情况;
- 输出维度与输入一致的情况(bert, auto-encoder)
- 输出维度不固定的情况(在输出引入end截断字符,判断是否达到最大输出),这种问题也成为Seq2Seq问题
对于Sequence labeling有几种方法:
- 一个输入vector对应一个输出,中间无与其他vector信息的交互
- 一个输出有多个输入vector决定,这可以通过窗口实现,在窗口内的输入vector考虑进来
- 对于有长有短的Sequence,需要使用自注意力机制,有多少个输入就给多少个输出(或者引入end进行阶段来实现机器自定义输出维度)
自注意力机制self-attention
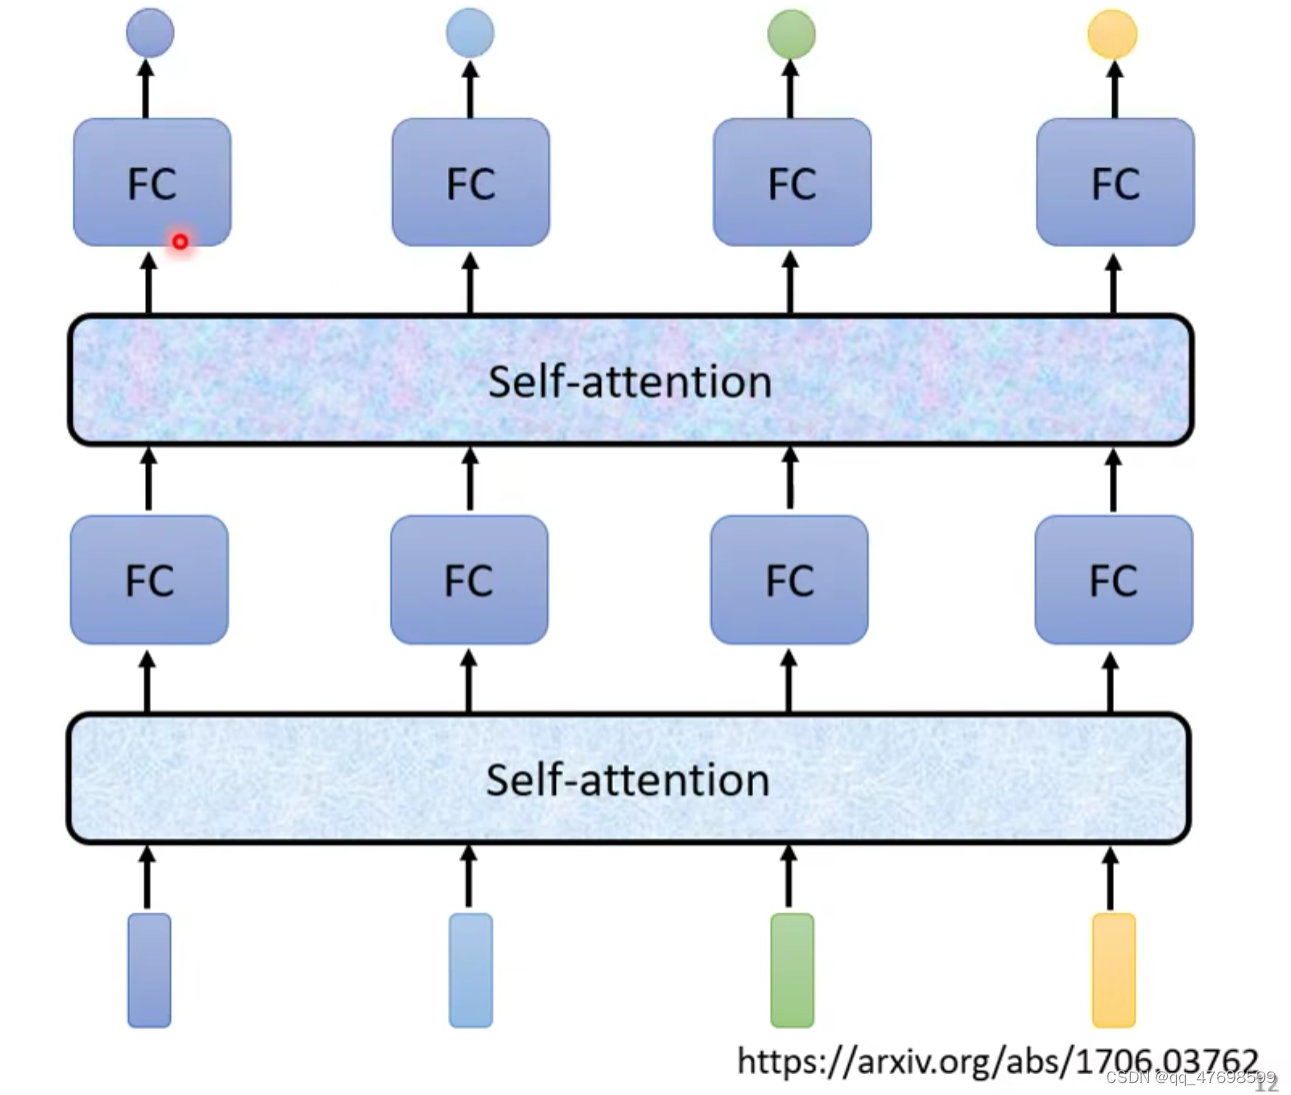
自注意力,其实就是融合了输入Sequence所有向量的信息,只不过各个输入向量对当前输出的贡献量需要进行计算,这取决于当前输入向量与其他输入向量之间的相关性。
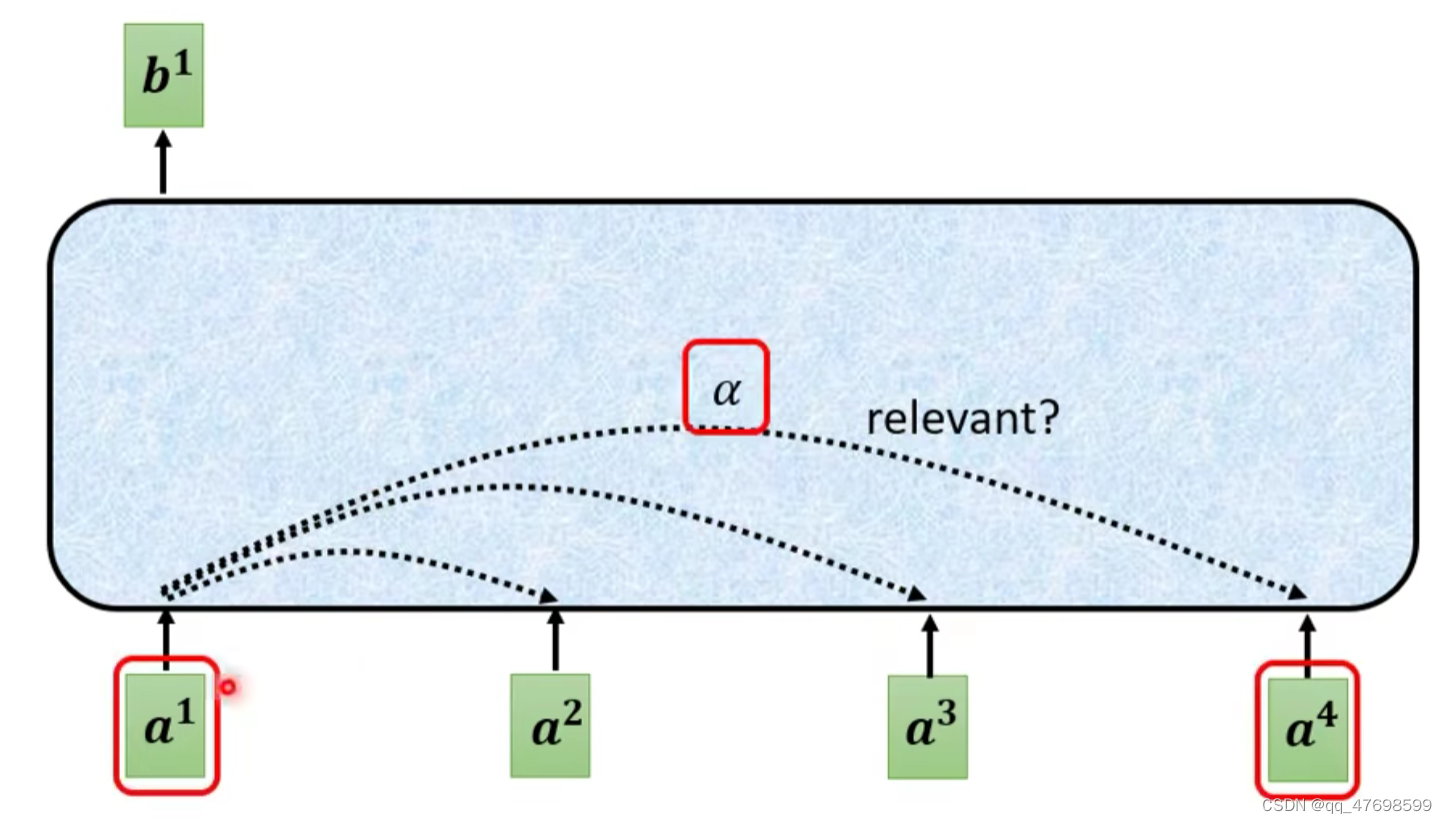
自注意力机制**与CNN不同的点在于:其将所有vector的内容全部考虑了,只不过用scores对各个vector之间的相关性进行了评分和权衡;CNN从本质上可以看作自注意力机制的一种简化版本,是对感受野内的自注意力;在样本量较少的情况下CNN优于Self-attention,反之self-attention可能在性能上超过CNN。
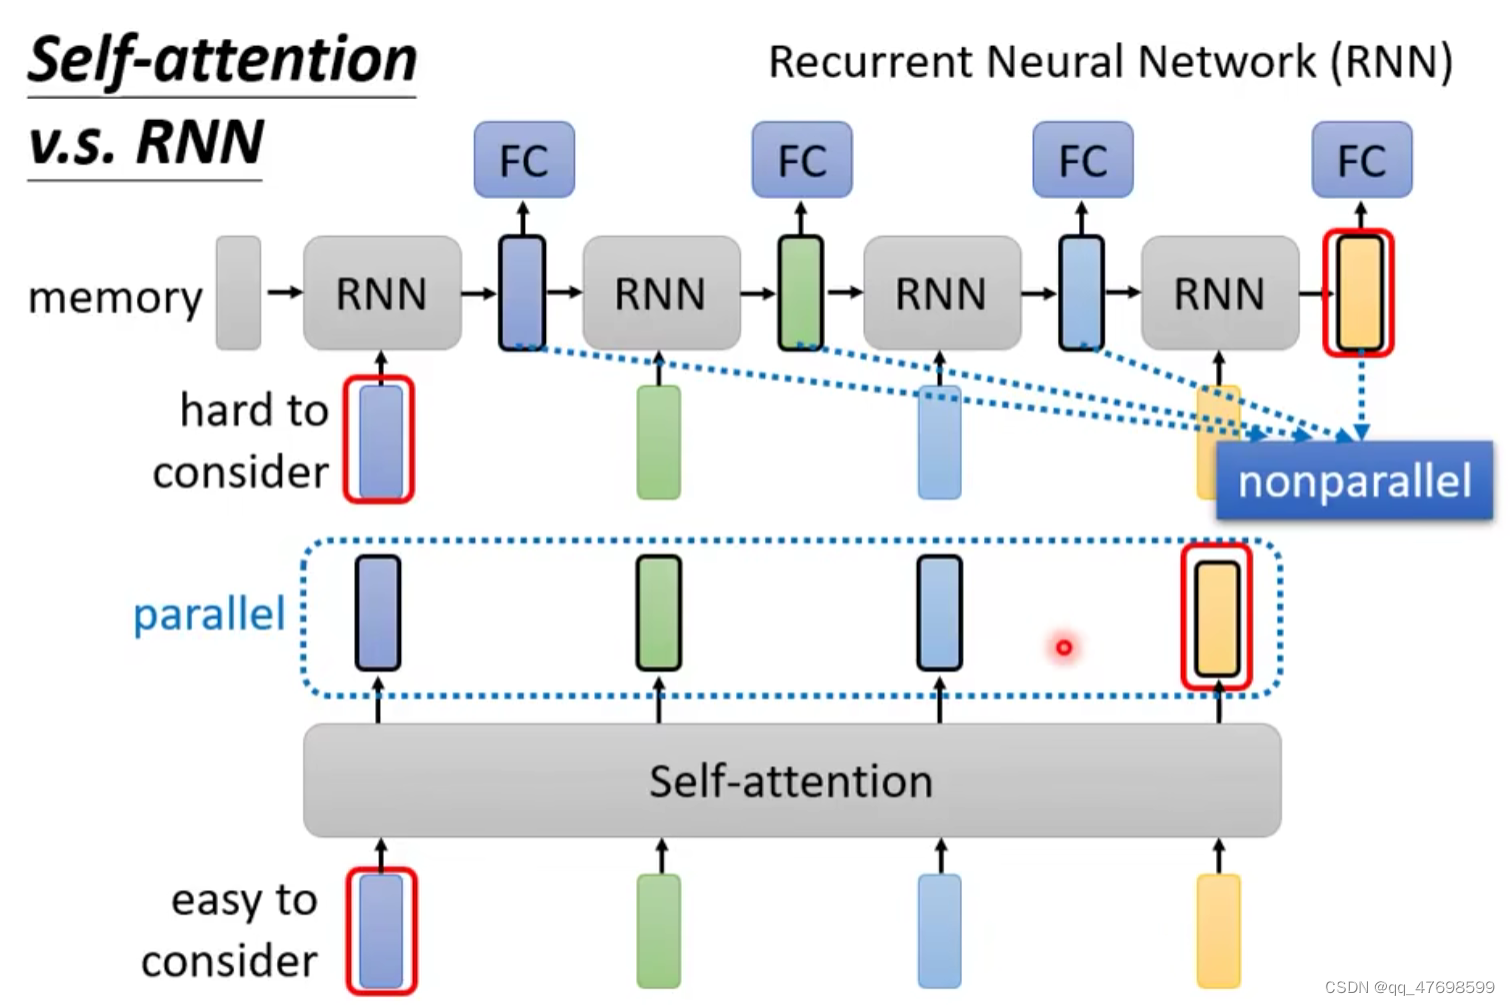
自注意力和RNN的区别:**RNN是将历史输出考虑到当前输入的运算中来,注重于记忆,而自注意力机制是将所有输入向量都与当前输入向量进行融合,得到最后的输出,注重于所有输入向量的相关性,并且自注意力可以实现parallel计算
自注意力的计算流程:query和key的scores计算,再进行softmax,最后进行乘和运算得到输出。
相关性scores的计算:
这个过程需要query和key向量,query就是需要求相关性的当前向量(如上图a1),key就是与query做相关性计算的向量(一般为所有向量,包括自身)
使用dot-product,整个self-attention的训练参数仅为Wq和Wk,query和key乘上Wq和Wk之后,再相互点乘,得到α即相关性大小。
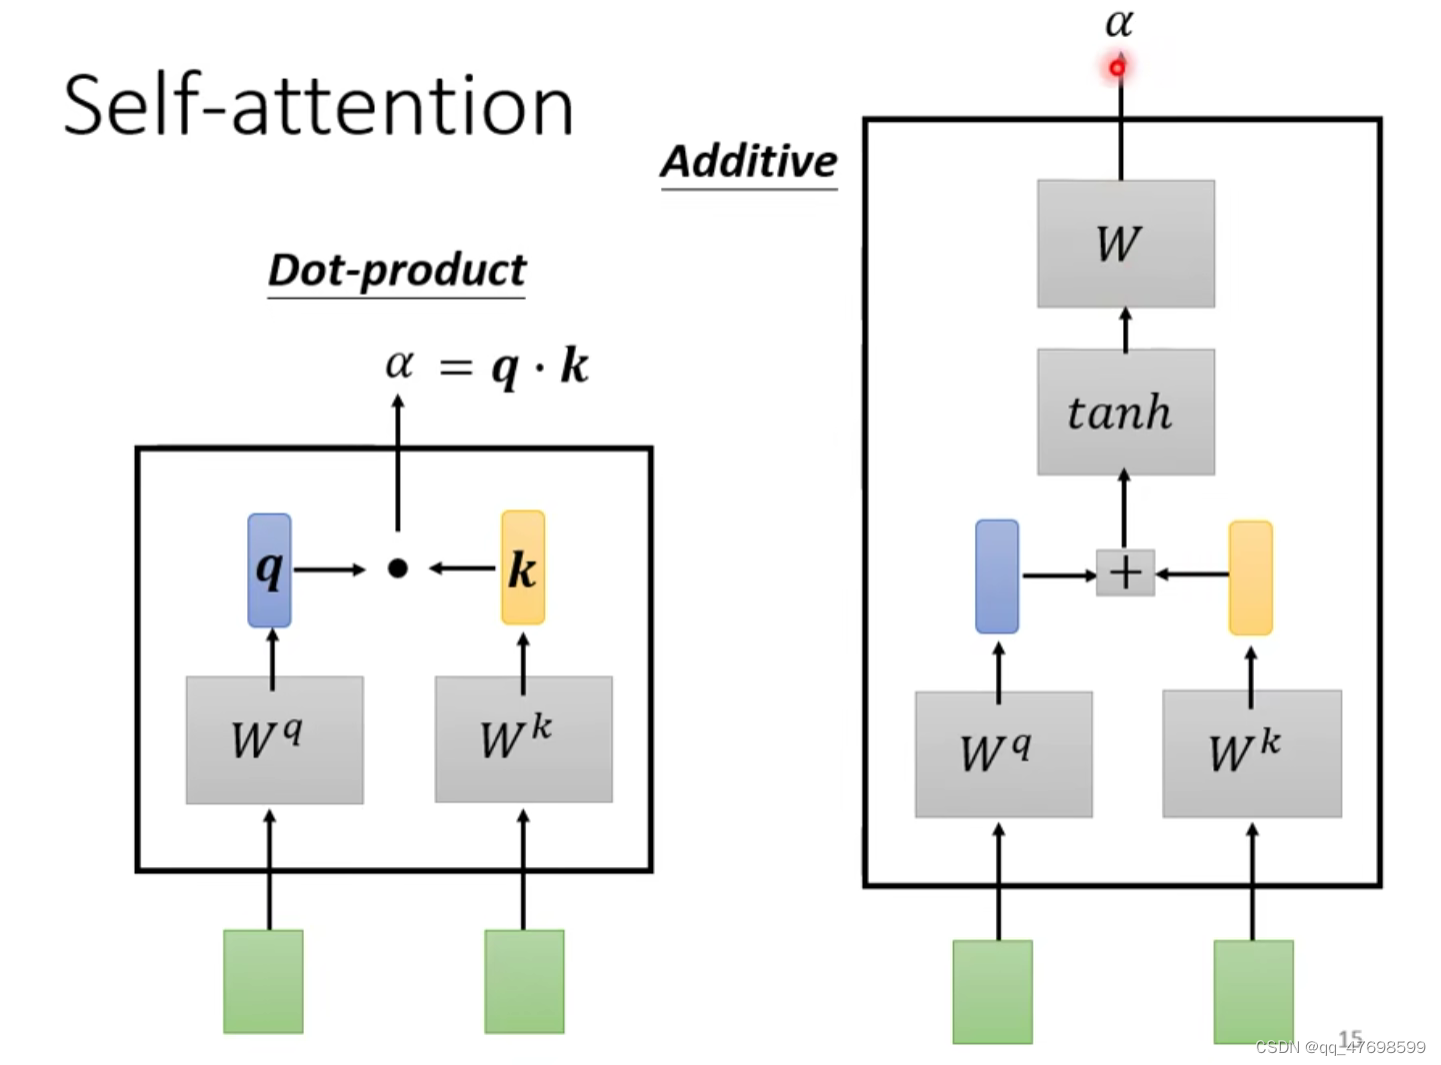
计算完相关性之后,需要对其进行softmax,得到α’,再用α’乘以v后加和得到self-attention的输出
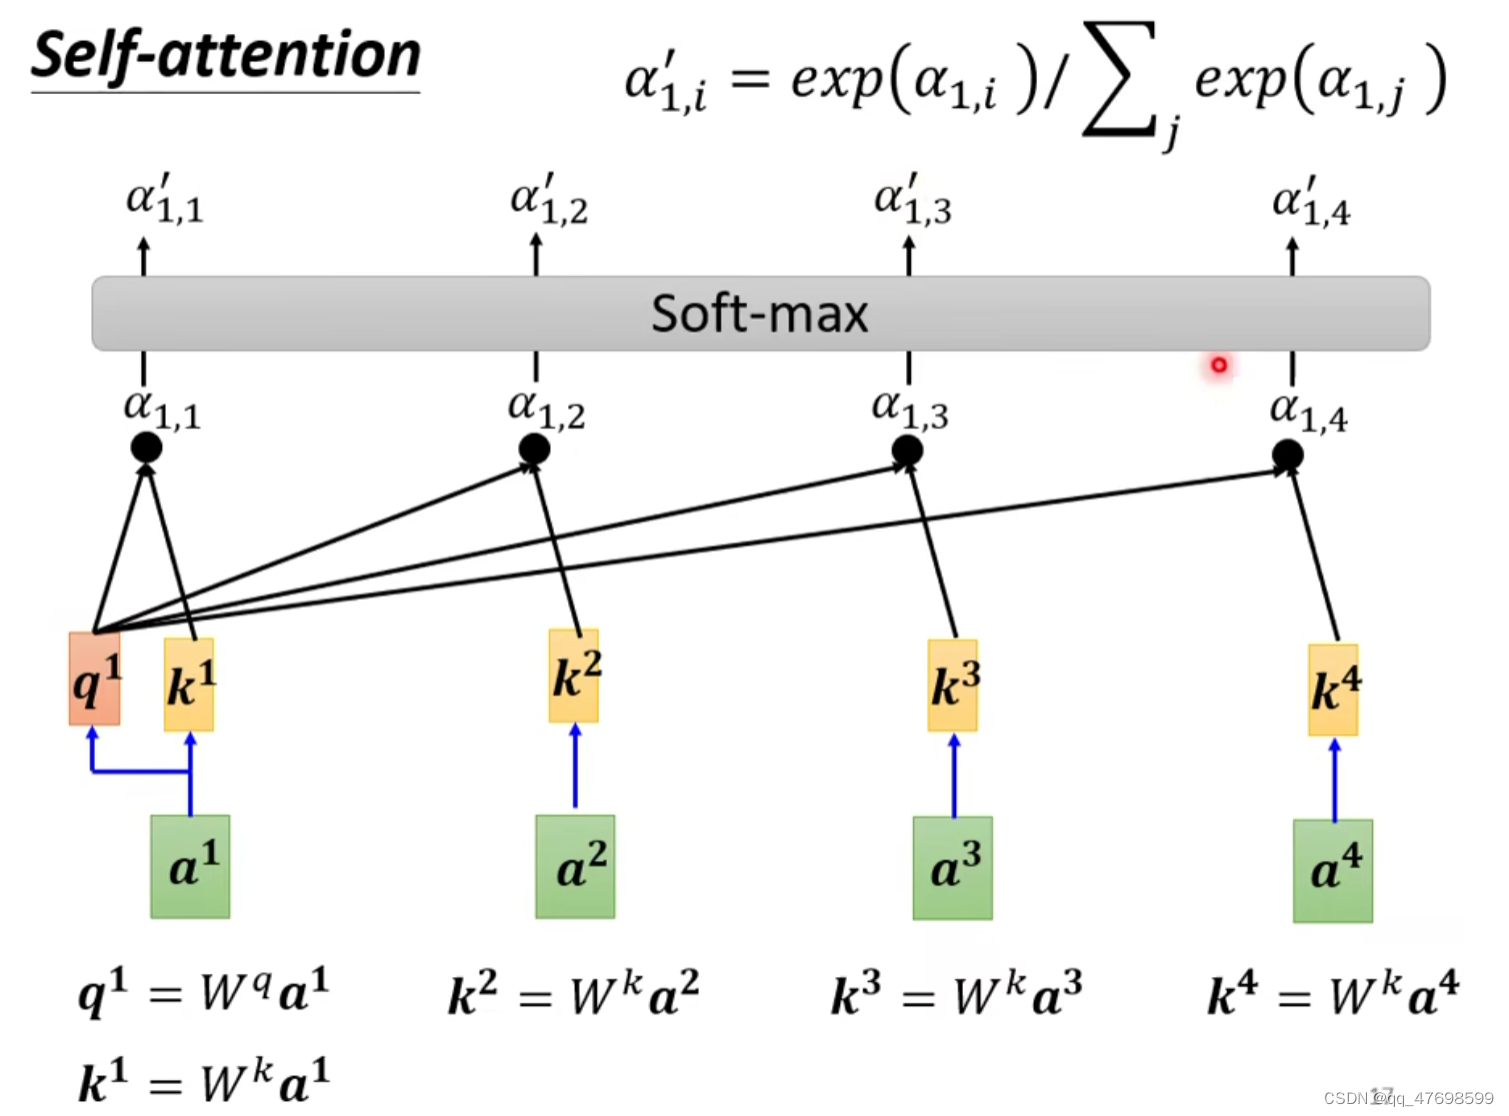
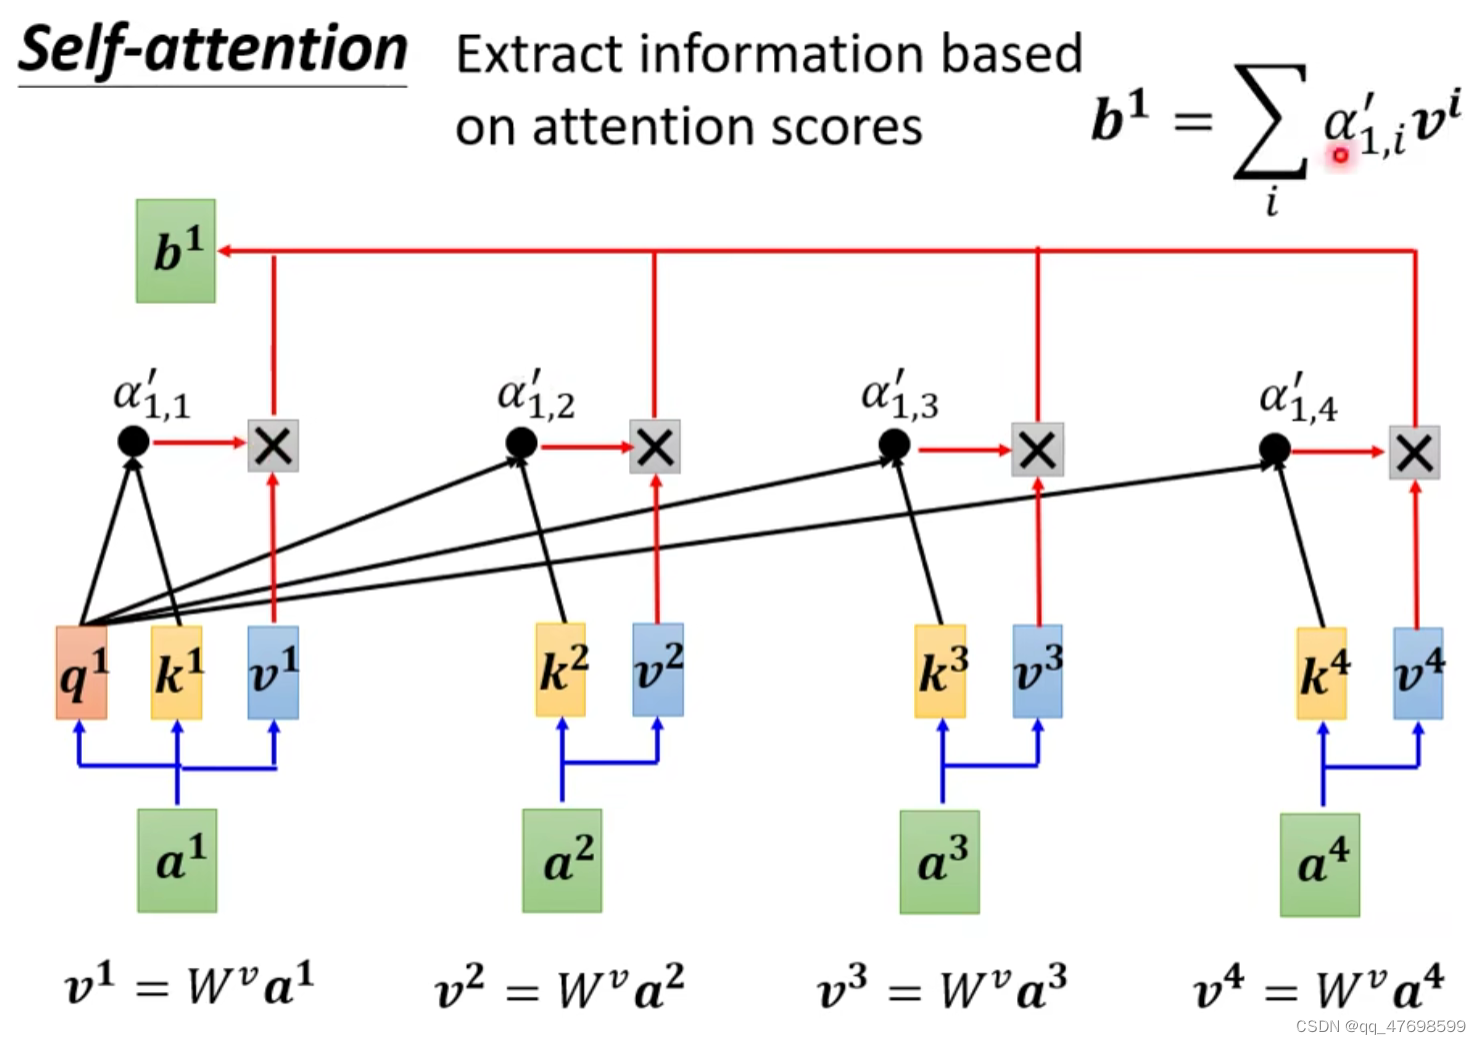
self-attention中需要训练的参数有:Wq,Wk,Wv
上述所有计算都可以用矩阵求解的方法并行计算,这样的计算速度很快
self-attention for graph
对于node,只考虑与node相连的nodes,这样形成一个0-1的稀疏矩阵,可以在计算注意力时不考虑不相连的vectors
multi-head self-attention
这的多头是指多个query、key和v,将一个ai与多个wq1,wk1,wv1;wq2,wk2,wv2相乘后得到qi1,ki1,vi1;qi2,ki2,vi2,并且相同组合之间进行注意力计算,不同组合之间不干涉,最后将不同组合的输出b进行concat,得到唯一向量进行输出,即自注意力的输出
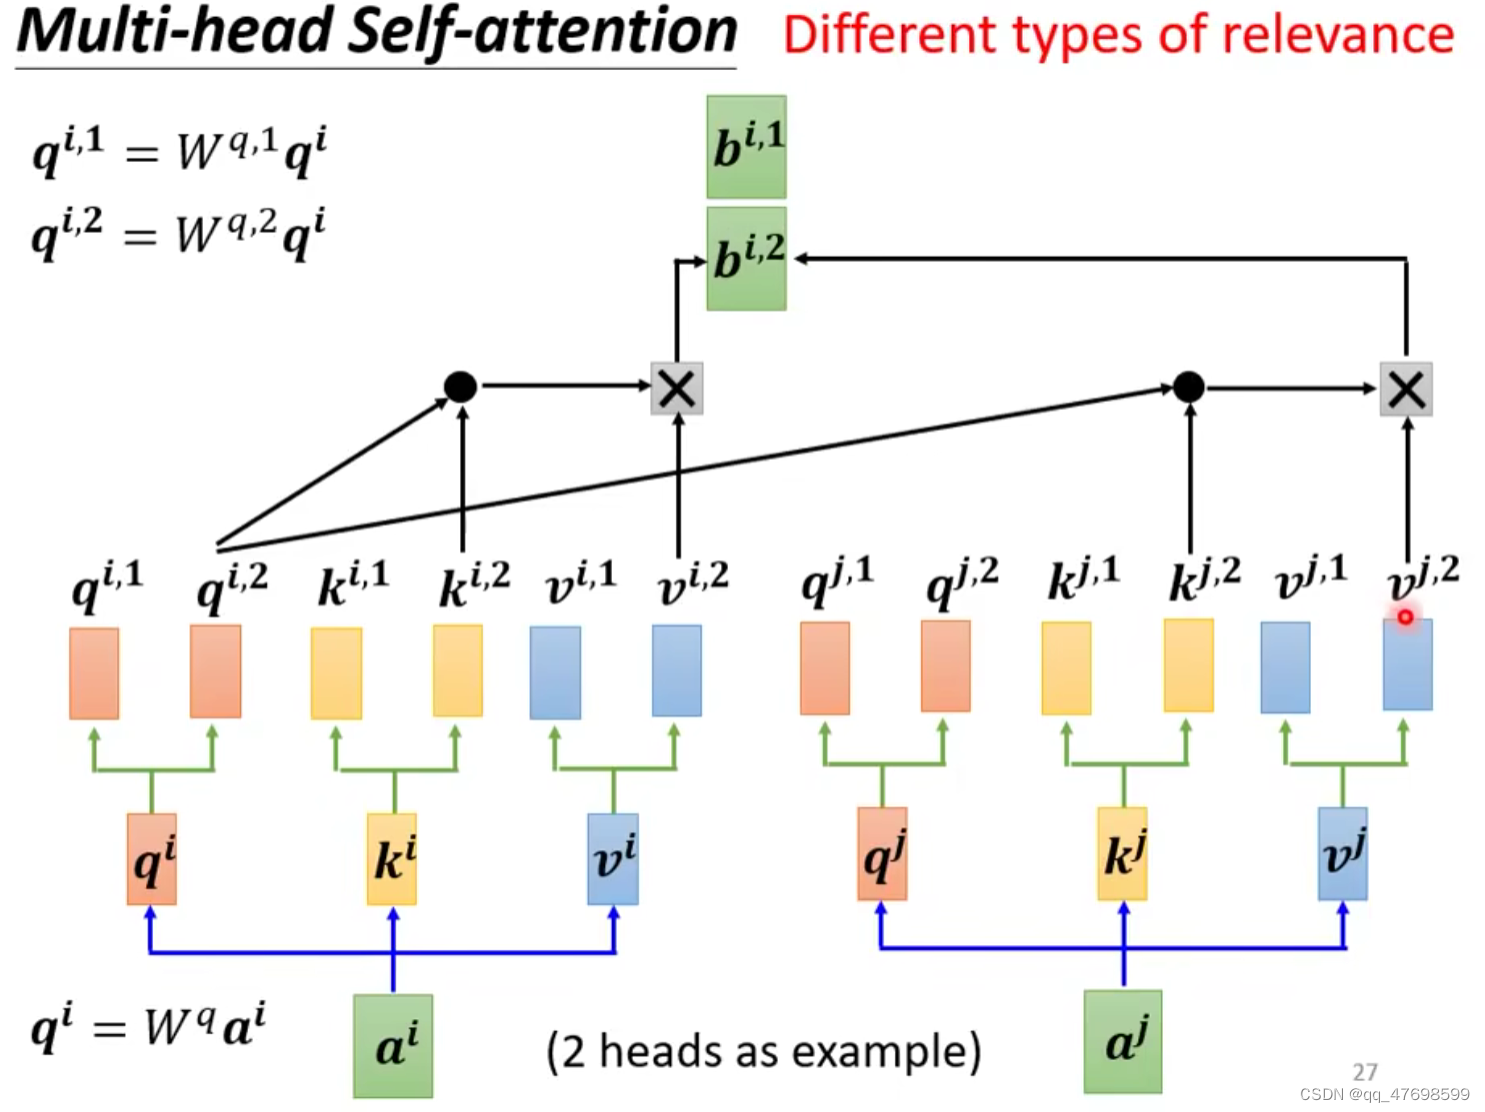
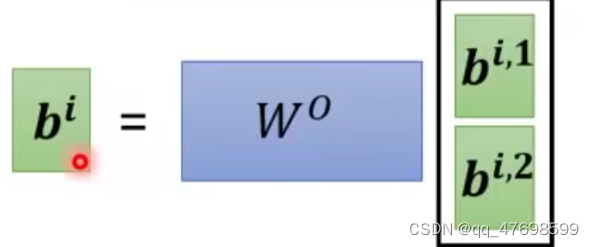
Positional Encoding
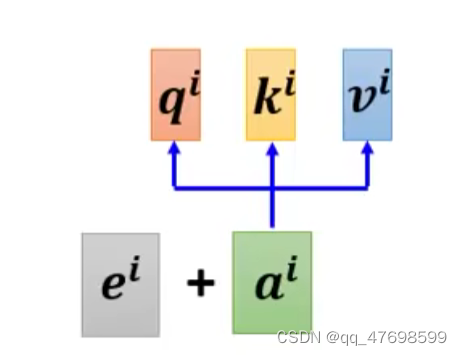
上述的自注意力都是将一整个Sequence进行计算,没有考虑各个vector在Sequence中的位置,Positional Encoding引入ei,表示向量ai在序列中的位置,可以是hand-crafted人为定义的,也可以是通过网络训练出来的
transformer
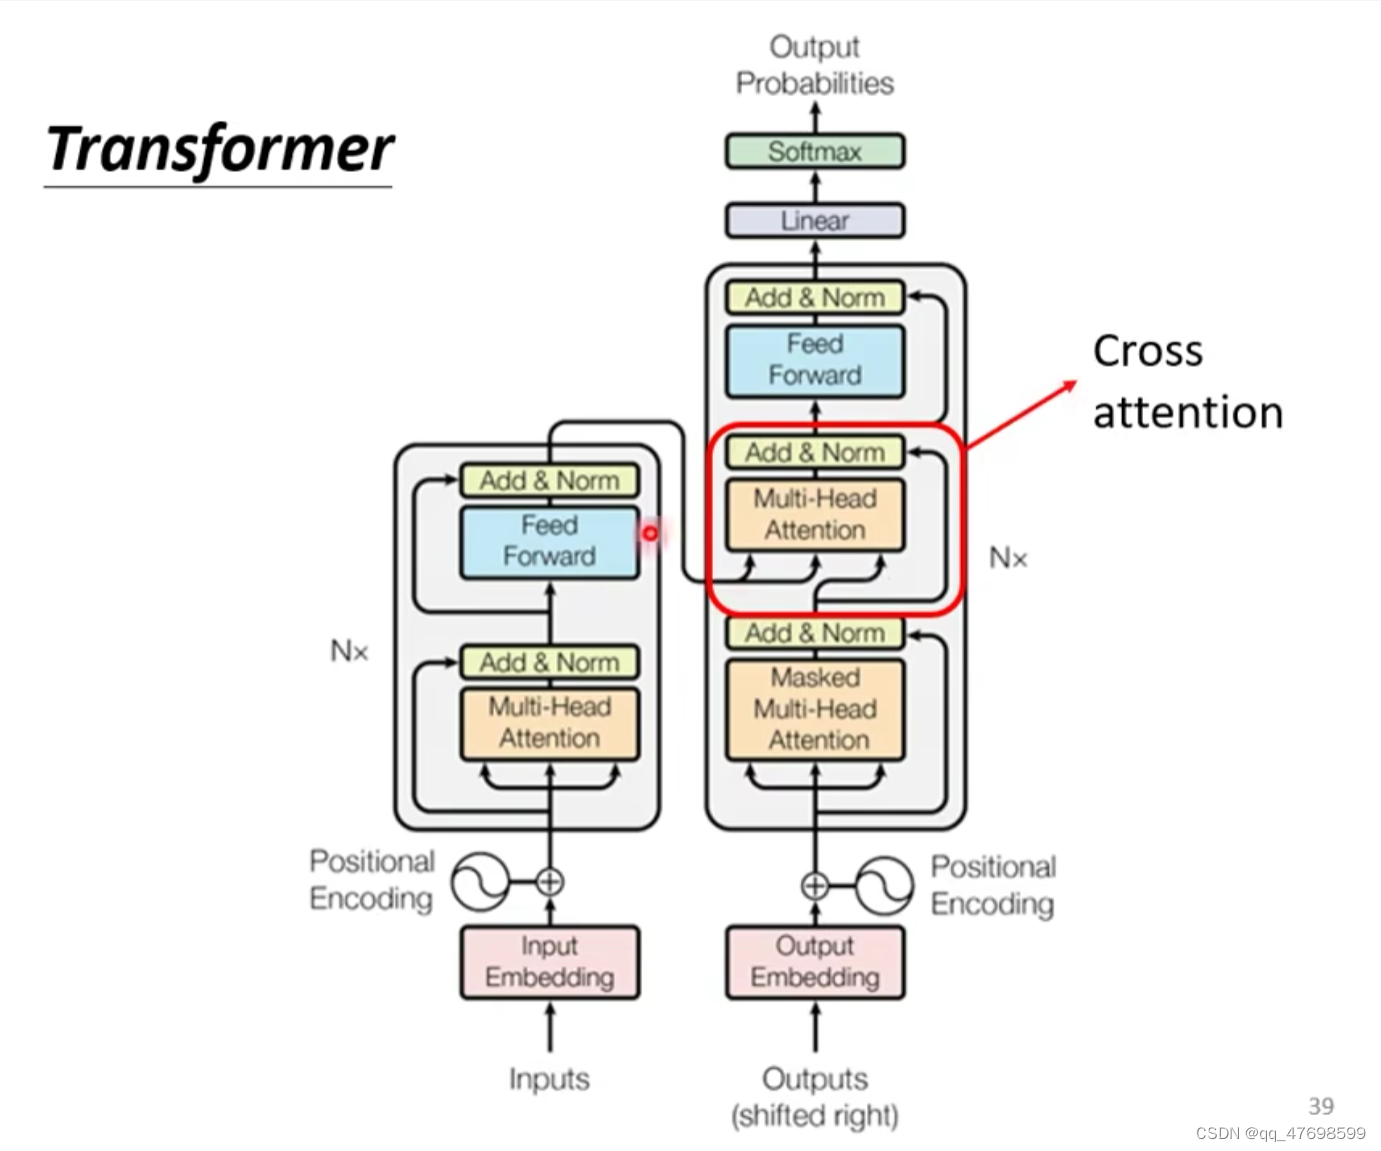
transformer分为encoder和decoder两部分,其实也就是一个Seq2Seq模型。
下图为transformer的encoder和decoder的总体概括图:左边是encoder,右边是decoder,两者的区别在于block中是否有cross attention
Encoder
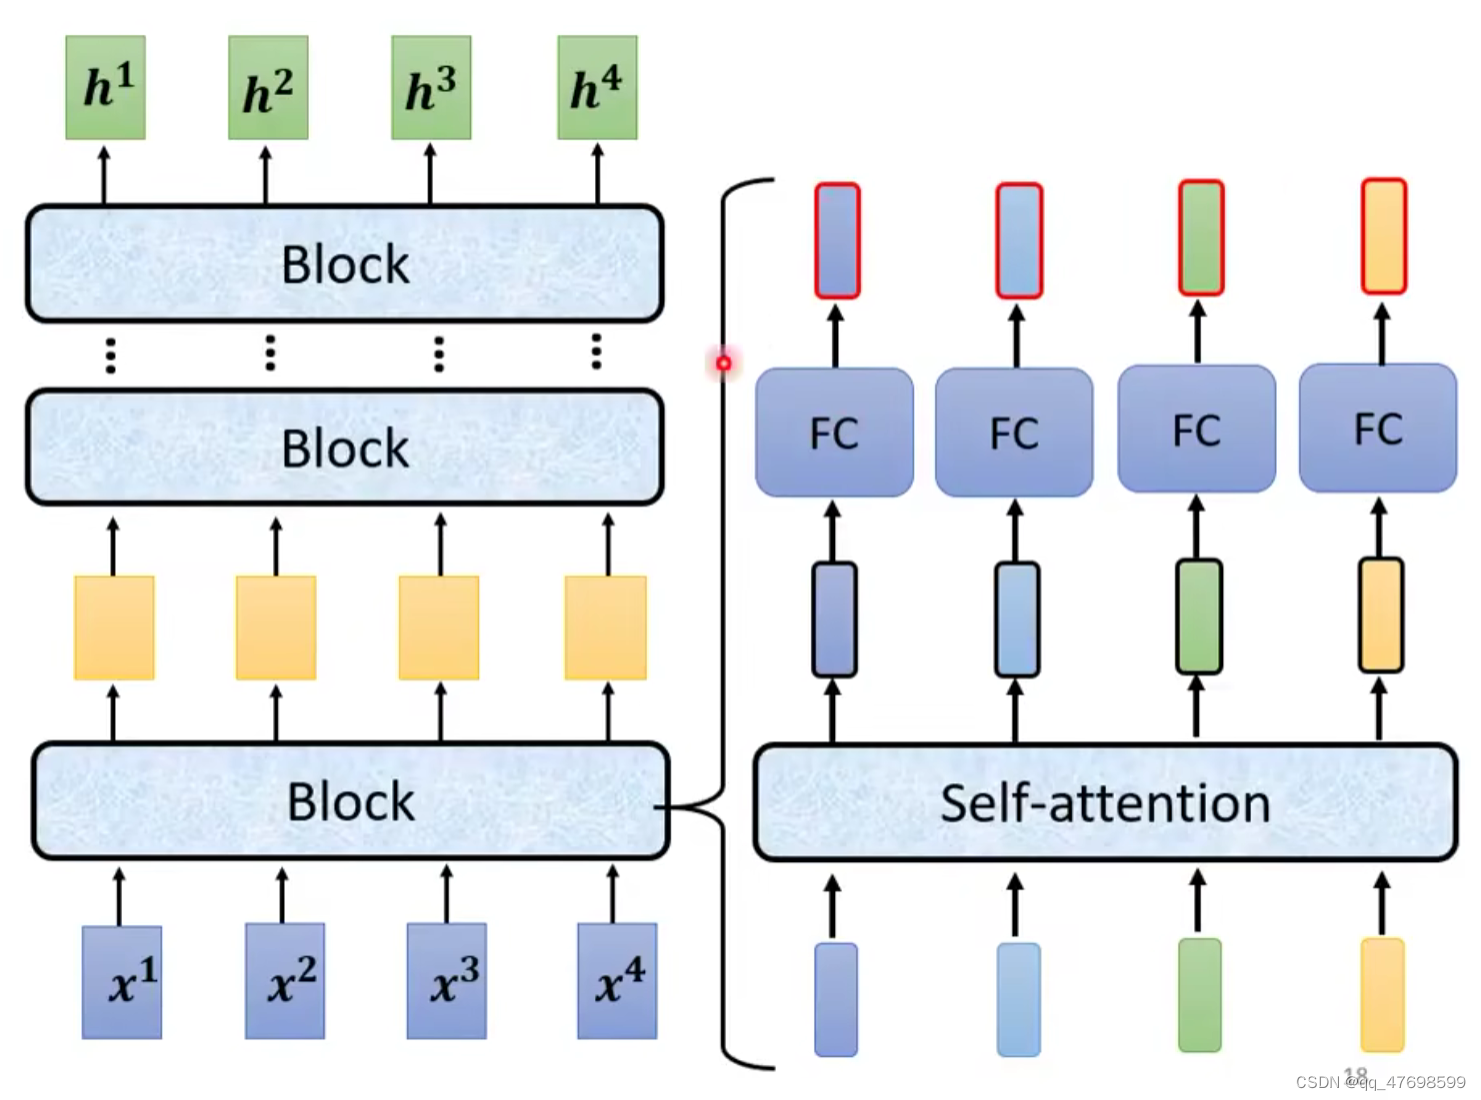
下图为简易的encoder结构,只需要将input输入到自注意力中,输出再经过FC即可得到输出,这与前面的自注意力机制一模一样。
带有residual connection的block
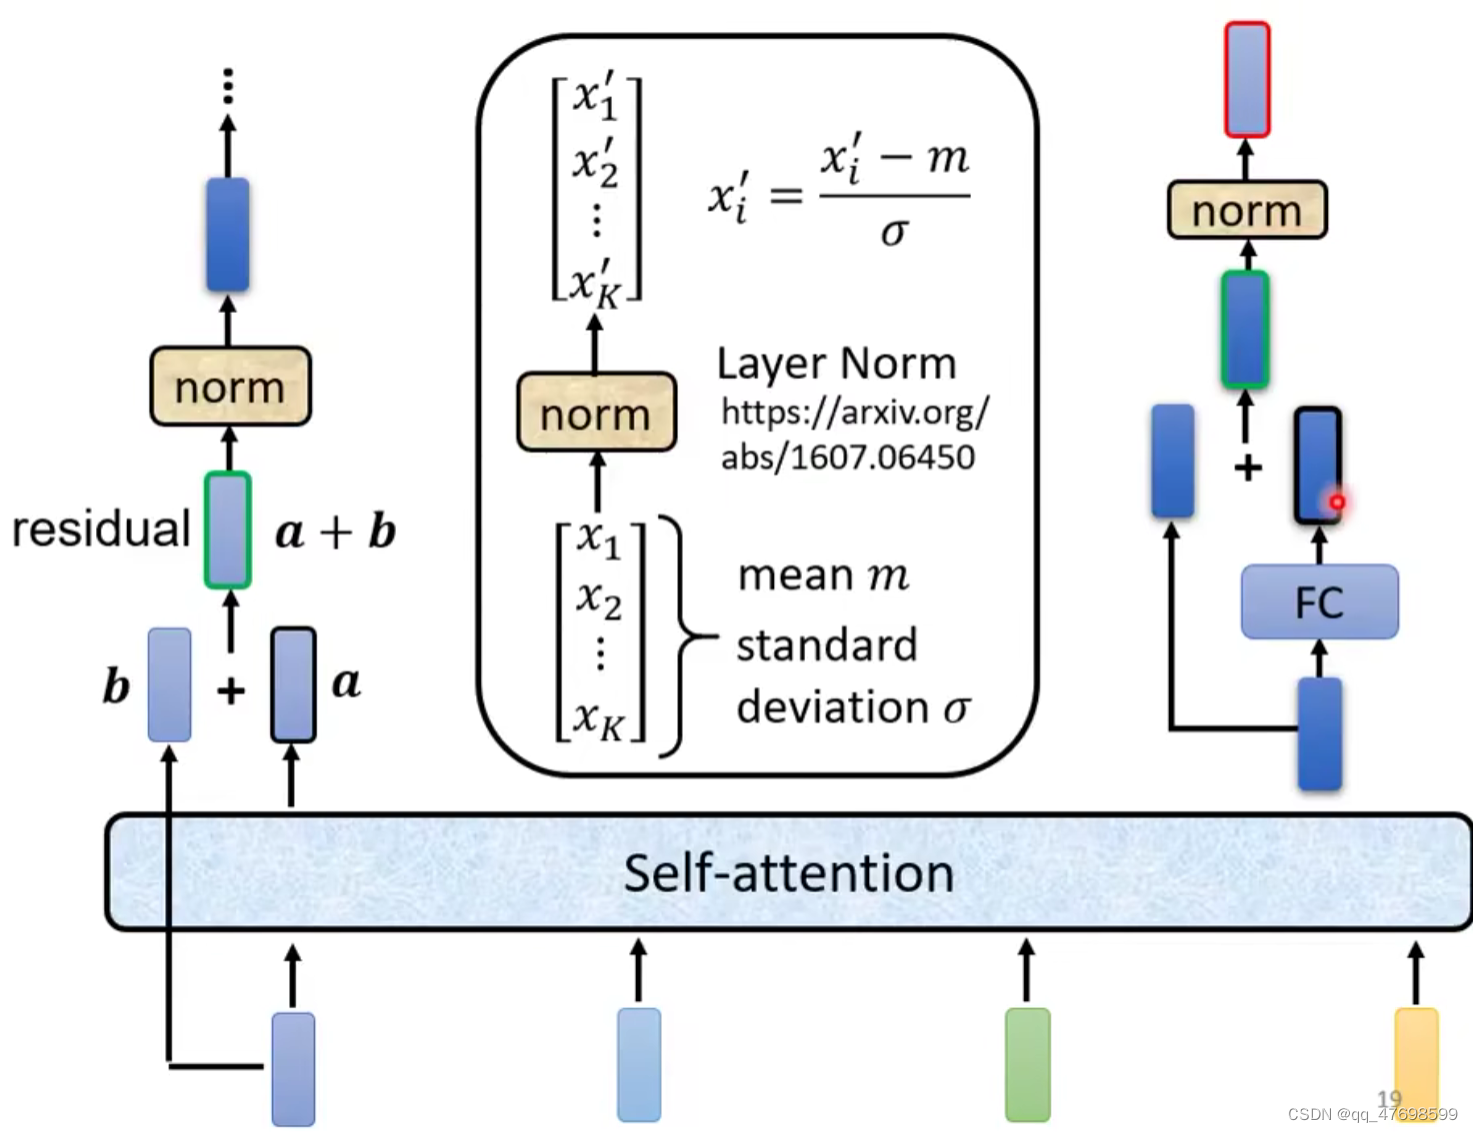
下图为带有residual connection的block,self-attention的输出加和输入,经过layer norm(layer norm是指对样本特征之间使用标准化,而batch norm是指对样本之间使用标准化);再将输出导入到FC中,将FC的输出与输入加和,得到的结果输入到layer norm中,完成这个Block的输出。
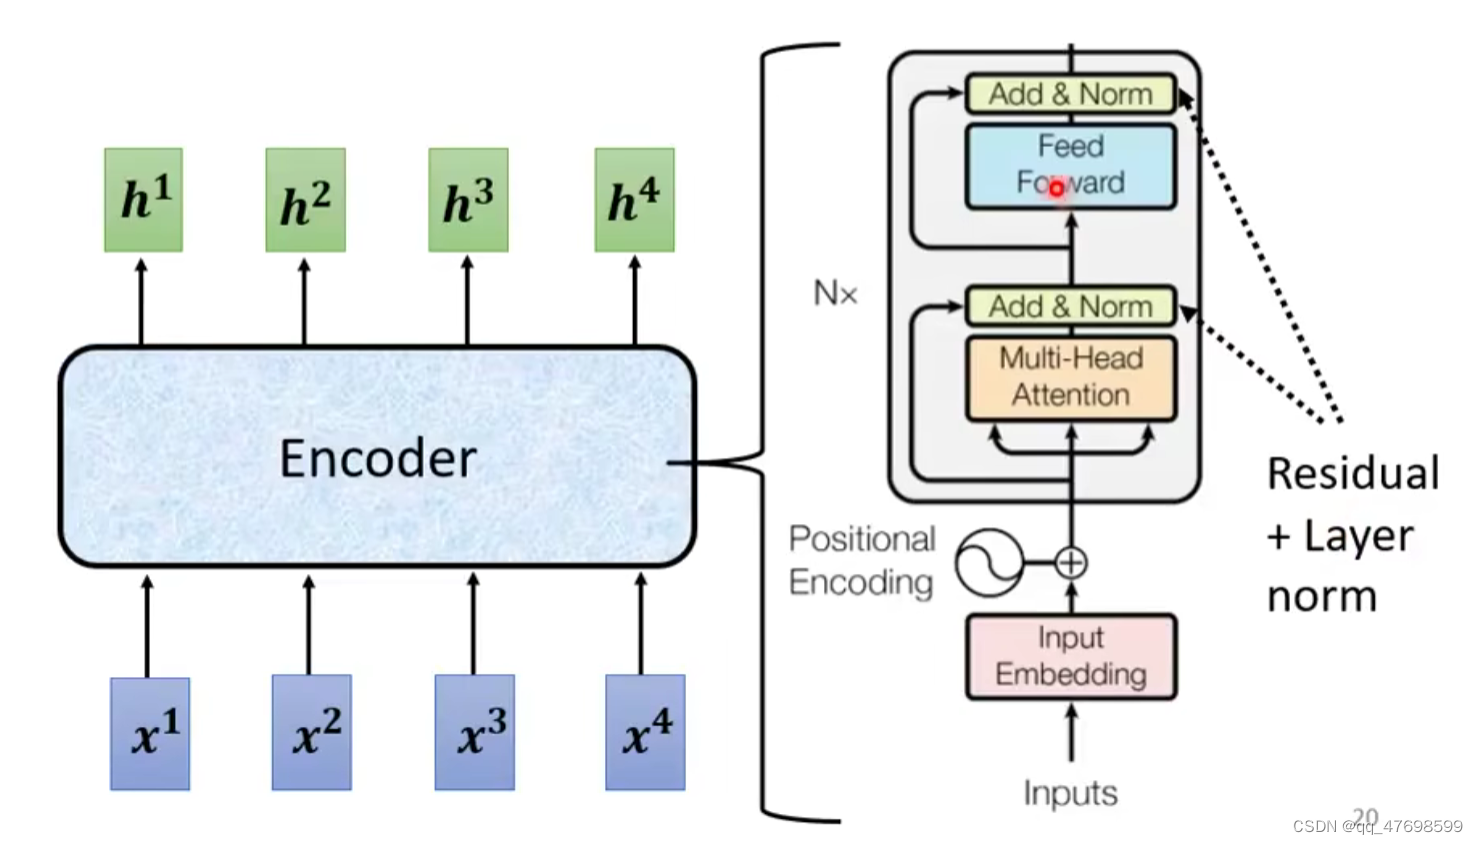
encoder的结构
下图是encoder的结构图,add&norm是实现residual和layer norm的地方,feed forward就是FC,multi-head就是上面的多头机制,将输入化为多个输入进行注意力的计算。
Decoder
几种decoder的形式
autoregressive
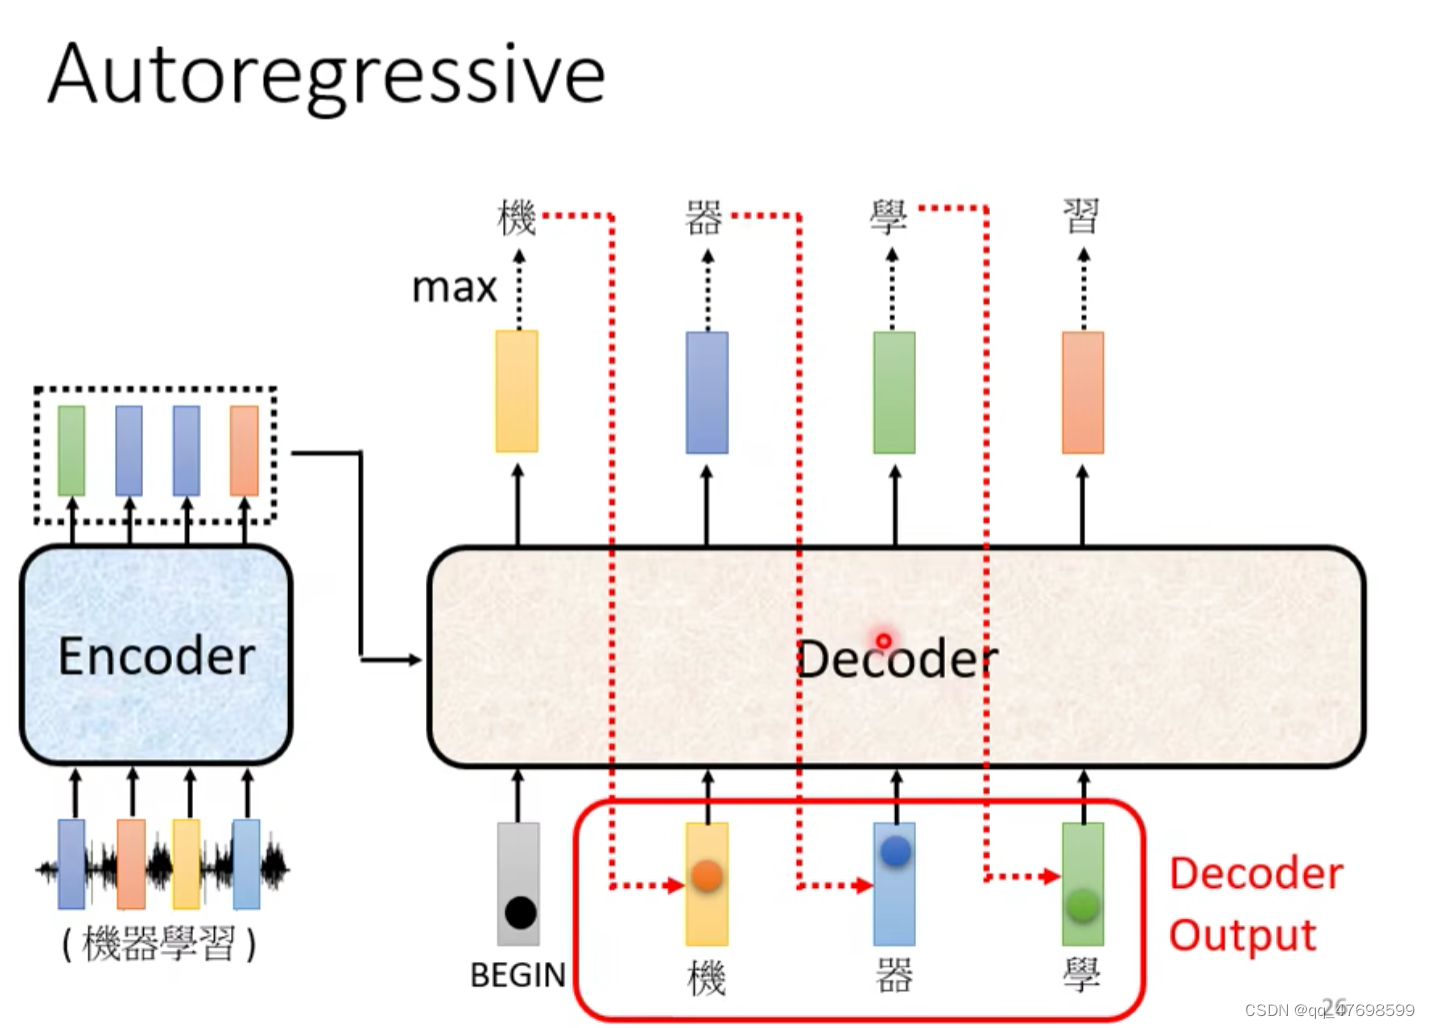
下图为decoder的autoregressive格式,其特点是
- 引入了BOS(BEGIN)字符作为Sequence起始位置标识;
- 在输入Encoder的输出的前提下,将Decoder的output带入到下一个字符的预测中,则当前字符的预测不仅取决于Encoder,还取决于前面的输出字符,这样可能会导致error propagation,也就是一步错步步错;
- 为解决error propagation,在训练的时候使用ground thruth作为输入标签,这种做法称为teacher forcing;
- teacher forcing中可能会导致test时出现较大偏差,这时引入噪声合成训练集,该噪声可以是替换了某个字符。
masked self-attention
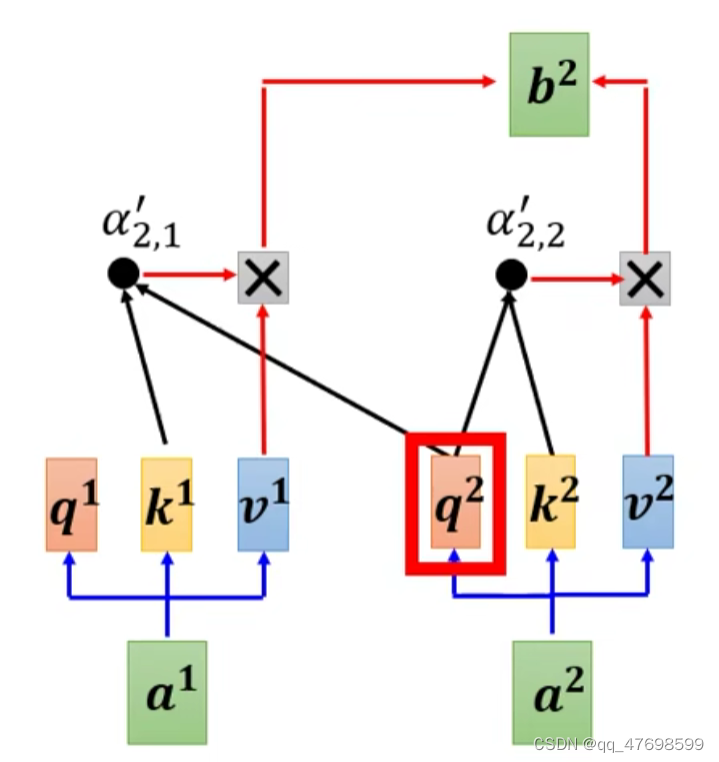
下图为masked self-attention的结构,其核心是query指考虑之前words的key,不考虑之后的key,这样能够符合句子的时序逻辑
Non-autoregression
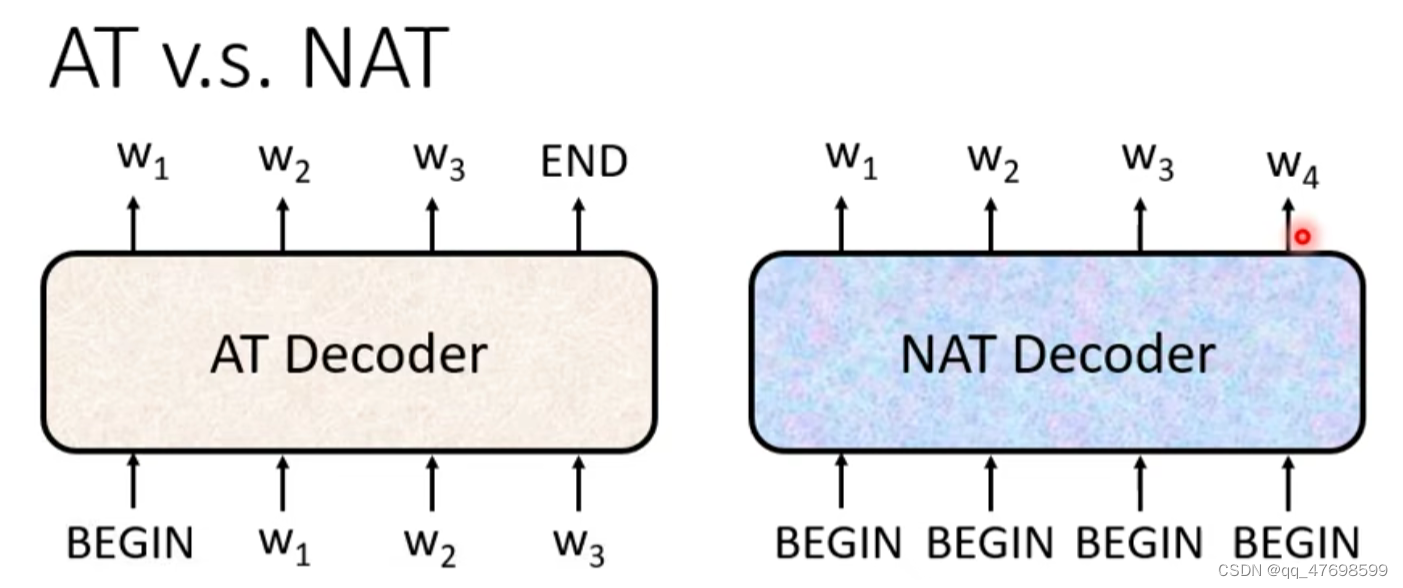
Non-autoregression实现的是将Sequence一次性全部输出,而不是像AT一样当前输出字符取决于前一个字符输出
字符长度的确定
如何让机器自动确定字符长度?在输出引入End字符的预测,如果达到END则标识输出终止。或者另外train一个predictor进行输出长度的预测
Decoder的结构
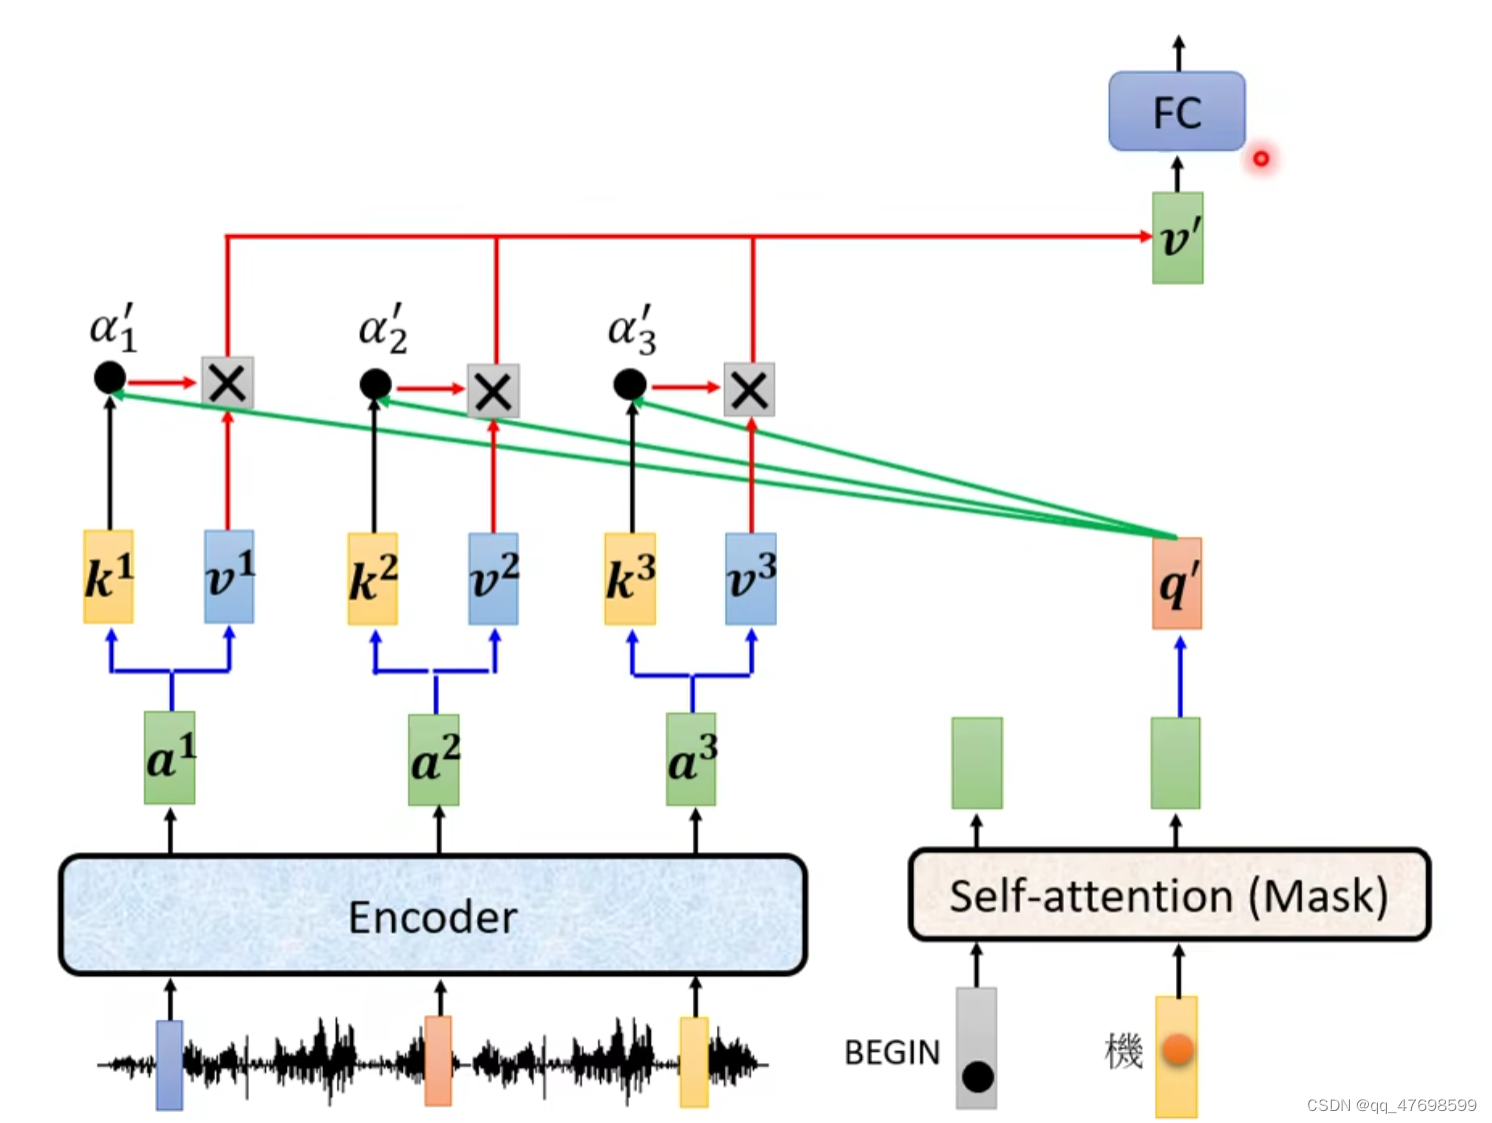
如上面transformer结构图可知,decoder与encoder的不同就是多了个cross attention
下图是cross attention的结构,将mask self-attention的输出作为query,结合encoder的输出得到的key和vi,得到scores和乘积加和后的v’,最后通过FC得到的输出,作为输入通入到decoder的下一级。
训练流程
最小化cross entropy,这其实就是一个分类问题,得到的是vocabulary database对应的probability,再取出概率最大的字符。
accuracy metric采用BLUE score,在validation阶段,选择BLUE score最大的模型
Tips
- 应用copy mechanism,对于一些没必要训练、在输入中存在的一样的语句,可以复制到输出
- Beam Search,对于有创造性的任务(如文章形成)有帮助,就是不适用贪婪的方式进行每一步的优化,而是有时采用次佳的解决方案

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)