用于多目标跟踪的点跟踪匹配方式总结与复习(一)——CVPR2024
用于多目标跟踪的点跟踪匹配方式(数据关联)总结与复习
文章目录
主要用于复习回顾NetTrack(CVPR2024)中用点作为外观特征是如何在完成点的匹配之后对应的完成实例之间的匹配的。可以为结合图的匹配和网络结构的设计上找一些对应的思路。
NetTrack的匹配策略
之前自己曾经学习过NetTrack这篇论文的主要的内容,这次复习是为了细化点的采样和匹配机制的部分获取一些新的思路。因此这里在整理的时候,理论部分只是整理对应MOT应用点跟踪的部分,其他的部分进行省略。
核心思想与相关介绍
NetTrack构建了一个动态感知的关联与细粒度的网络,利用点级的视觉线索。相应地,细粒度采样器和匹配方法已被纳入。
- 细粒度采样方法
- 动态感知关联(历史目标框的点和候选框中点匹配完成后,目标框与候选框的匹配)
NetTrack引入细粒度学习来解决关联和定位问题(定位主要是检测器的性能问题那里)
- 关于关联,NetTrack利用对象外观上的物理点,这些物理点不易受对象动态性的影响,并形成细粒度的视觉线索。
用于动态感知关联的细粒度网络
不是将对象视为粗粒度实体,而是使用细粒度网络跟踪对象
其利用对象外观表面上的兴趣点(POI)。通过改变全局相对位置和外观特征分布诸如变形、扭曲POI之间的内部关系的动态性,而点本身的细粒度表示,诸如局部外观颜色和与相邻点的关系,很少受到影响并且表现出鲁棒性.
整个网络需要学习的理论与代码的重点概括如下所示:
设计了一个细粒度采样器来发现潜在的兴趣点,并利用这些点的细粒度视觉线索,沿着新兴的物理点跟踪方法,以实现稳健的跟踪。随后,提出了一种简单而有效的细粒度相似度计算方法来确定跟踪的兴趣点和候选对象之间的包含关系。提出的细粒度的相似性分数与现有的粗粒度的结合,以实现更强大的动态对象的关联。
-
提出了一种简单而有效的细粒度相似度计算方法来
确定跟踪的兴趣点和候选对象之间的包含关系 -
细粒度的相似性分数与现有的粗粒度的结合,以实现更强大的动态对象的关联
NetTrack点跟踪核心方法理论
NetTrack框架 提出了一个“细粒度的网络(fine-grained Net)”,其目的是解决 动态感知物体关联 和 动态感知定位 的问题。
动态感知物体关联 意味着在物体的属性(如位置、外观等)随时间变化的情况下,系统能够有效地关联并跟踪这些动态物体。
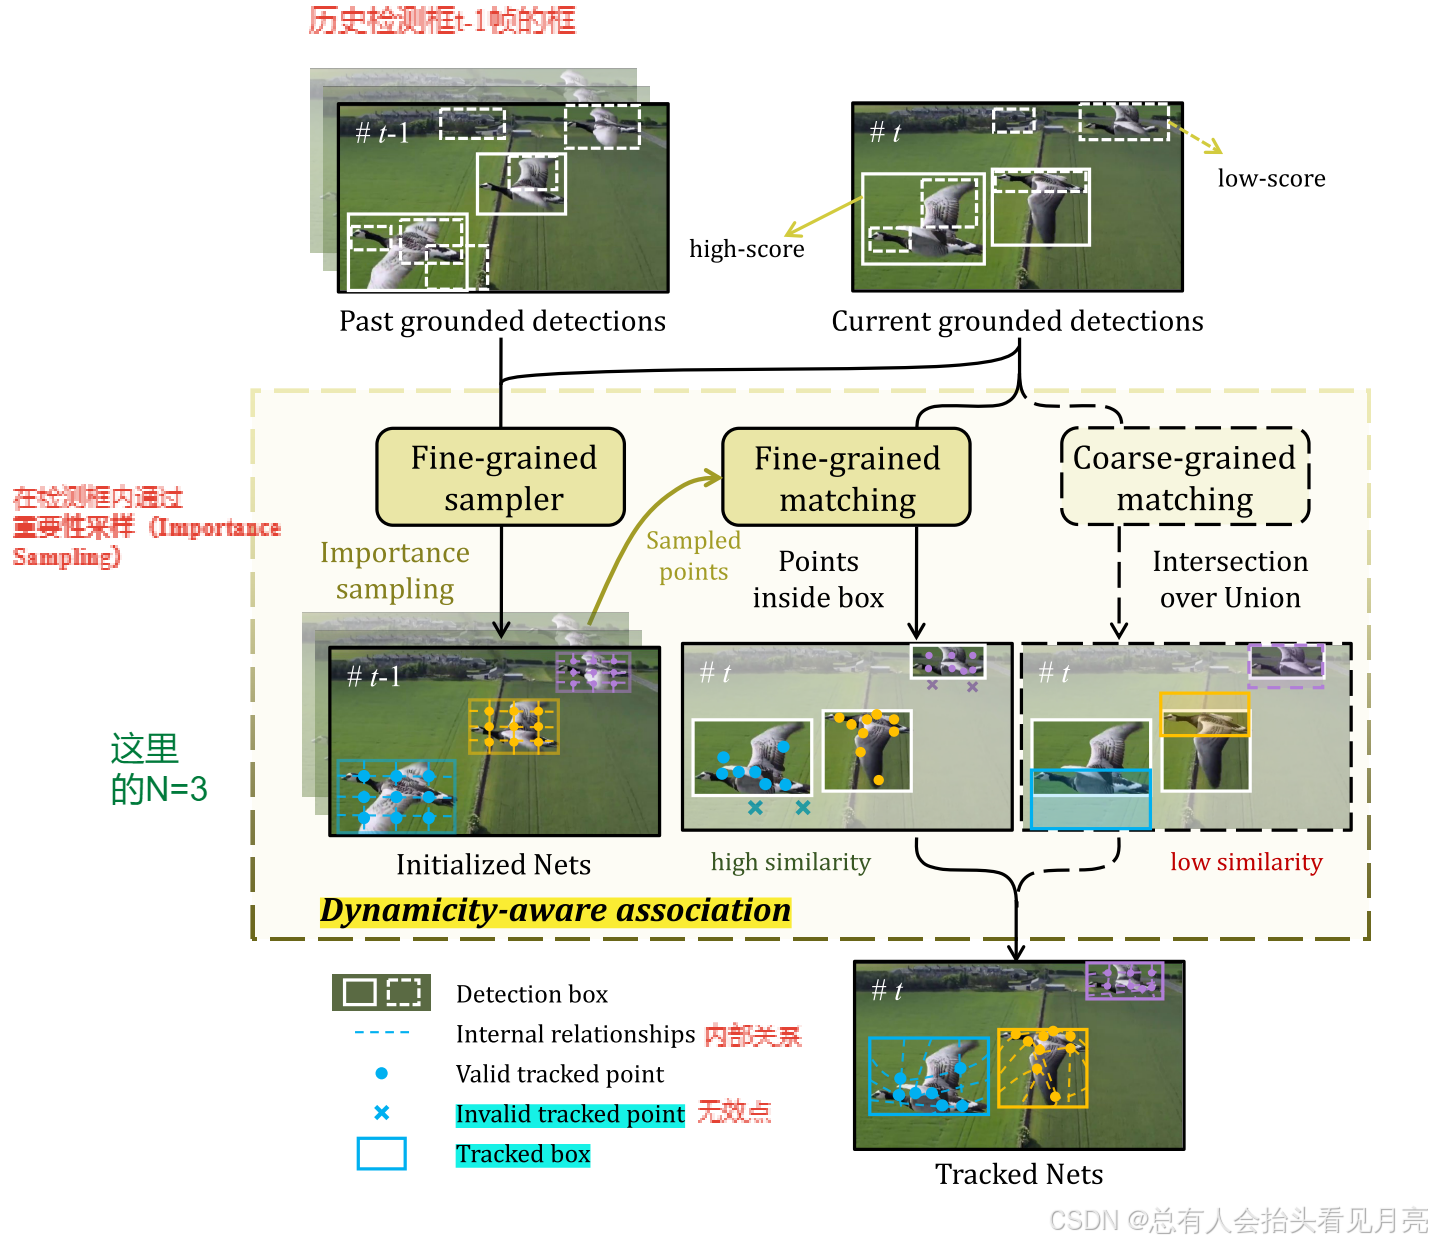
细粒度网络与采样
细粒度采样器和匹配方法组成。
-
Fine-grained sampler
-
Fine-grained matching
-
细粒度采样器这项工作引入了点级视觉线索,以形成具有兴趣点(POI)的细粒度Nets。
理想情况下,采样POI应该准确地捕获每个感兴趣对象表面上的每个有价值的点,避免背景干扰或冗余的计算负担。一个简单的想法是在跟踪对象的框内采样POI,并逐帧更新点。然而,这种方法可能会造成一定的计算负担、忽略假阴性样本以及视觉上下文不足。因此,提出了一种细粒度采样器来对跨帧POI进行采样。
假阴性指的是那些应被采样却被遗漏的兴趣点。例如,部分物体可能因为遮挡或检测错误而未被采样到。
这里对应的就是跨帧来进行采样,8帧正好和CoTracker的默认的窗口大小是一致的情况。还是和之前的想法一样这个跨帧的采样是为了凑还是真的考虑计算复杂度不太好确定。
-
将POI的预期分布表示为f(x),其中x是指图像I中的点。
-
卡尔曼滤波器:提供对物体运动的粗略估计,预测新物体在 S帧内的分布范围。
会先有一个粗略的轨迹分布的情况。S在粗略分布的基础上进行采样
- 然后可以将分布转换为点级形式:(点级概率分布:)
p ( x ∣ T o coarse , { I } i = 1 S ) p\left(\mathbf{x} \mid \mathcal{T}_{\mathrm{o}}^{\text {coarse }},\{\mathbf{I}\}_{i=1}^{\mathcal{S}}\right) p(x∣Tocoarse ,{I}i=1S)
粗粒度轨迹分布
T o coarse \mathcal{T}_{o}^{\text {coarse }} Tocoarse
表示通过卡尔曼滤波等方法粗略估计得到的目标物体的轨迹分布。粗粒度轨迹分布为后续操作提供了一个初步的参考范围。
点级概率分布:
p ( x ∣ T o coarse , { I } i = 1 S ) p\left(\mathbf{x} \mid \mathcal{T}_{\mathrm{o}}^{\text {coarse }},\{\mathbf{I}\}_{i=1}^{\mathcal{S}}\right) p(x∣Tocoarse ,{I}i=1S)
-
表示基于粗粒度轨迹分布 𝑇𝑜coarse 和 S帧图像序列推导出的点级概率分布。
-
该分布描述了图像中某个点 𝑥 是否属于潜在兴趣点的概率。分布是 二值分布(binary distribution),用于判定某点是否可能是潜在兴趣点。
-
p(·)是发现潜在POI的二进制分布。此分布用作重要性权重以对POI进行采样
- 给定点数K,则可以使用重要性采样将预期的POI公式化为:
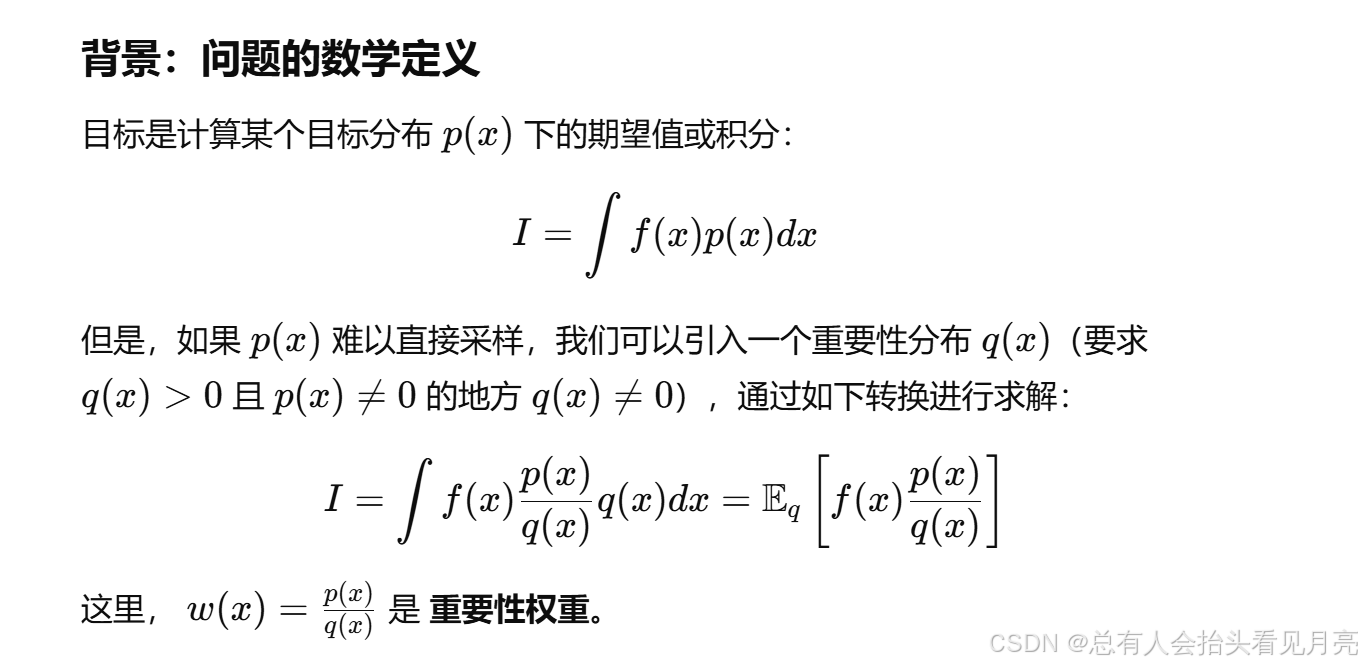
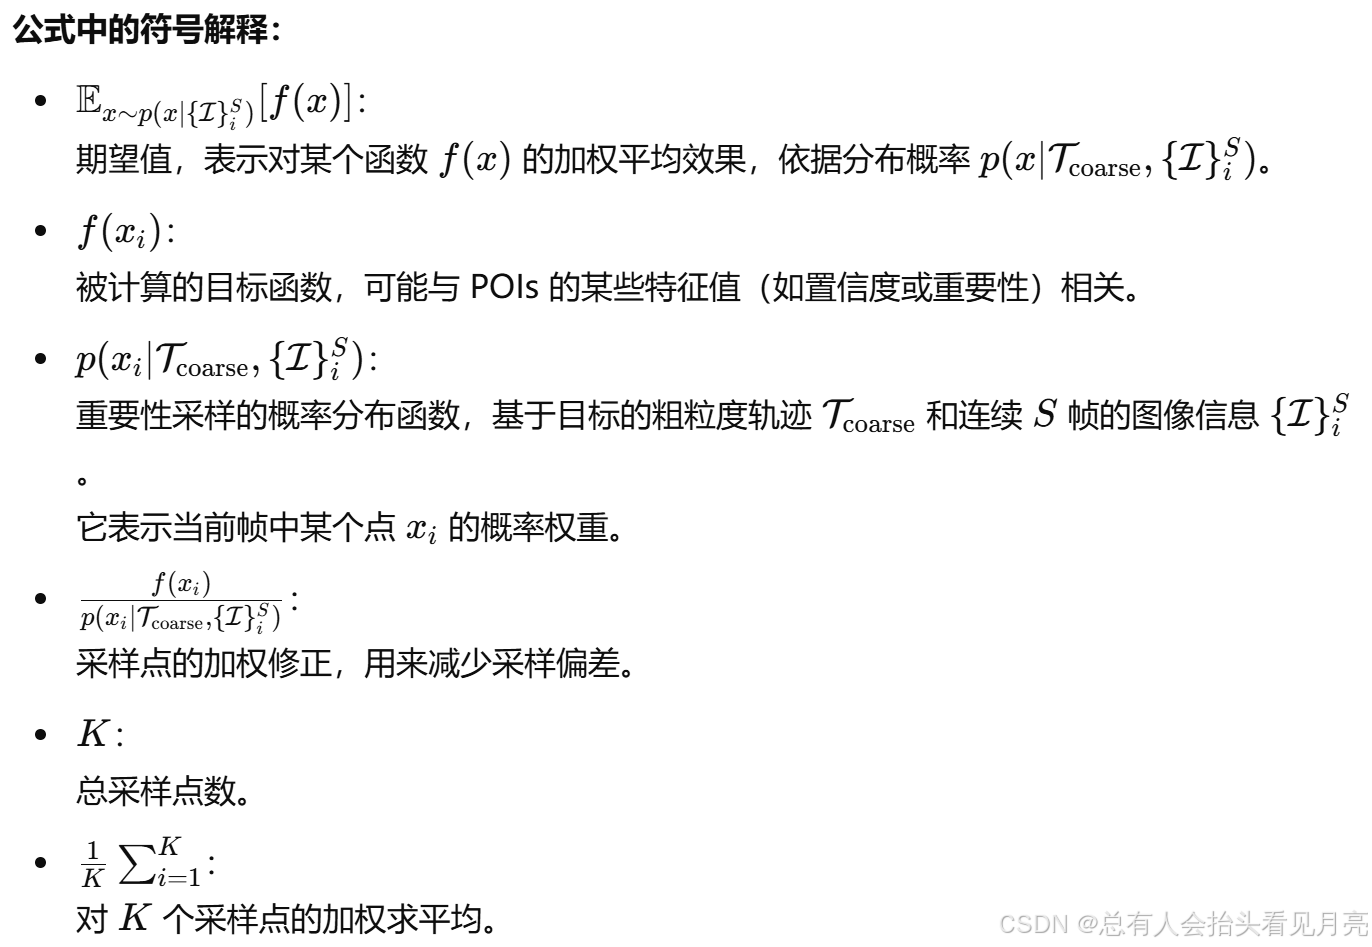
E x ∼ p ( x ∣ { I } i = 1 S ) [ f ( x ) ] = 1 K ∑ i = 1 K f ( x i ) p ( x i ∣ T O coarse , { I } i = 1 S ) \mathbb{E}_{\mathbf{x} \sim p\left(\mathbf{x} \mid\{\mathbf{I}\}_{\mathbf{i}=\mathbf{1}}^{\mathcal{S}}\right)}[f(\mathbf{x})]=\frac{1}{K} \sum_{i=1}^{K} \frac{f\left(\mathbf{x}_{i}\right)}{p\left(\mathbf{x}_{i} \mid \mathcal{T}_{\mathrm{O}}^{\text {coarse }},\{\mathbf{I}\}_{i=1}^{\mathcal{S}}\right)} Ex∼p(x∣{I}i=1S)[f(x)]=K1i=1∑Kp(xi∣TOcoarse ,{I}i=1S)f(xi)
公式的核心思想:是通过重要性采样,使用K个采样点的期望来近似f(x)的整体分布。权重1/p(xi)用来调整采样点分布和目标分布之间的差异,保证估计结果准确。
之后对细粒度网络和匹配策略在结合论文复习一下
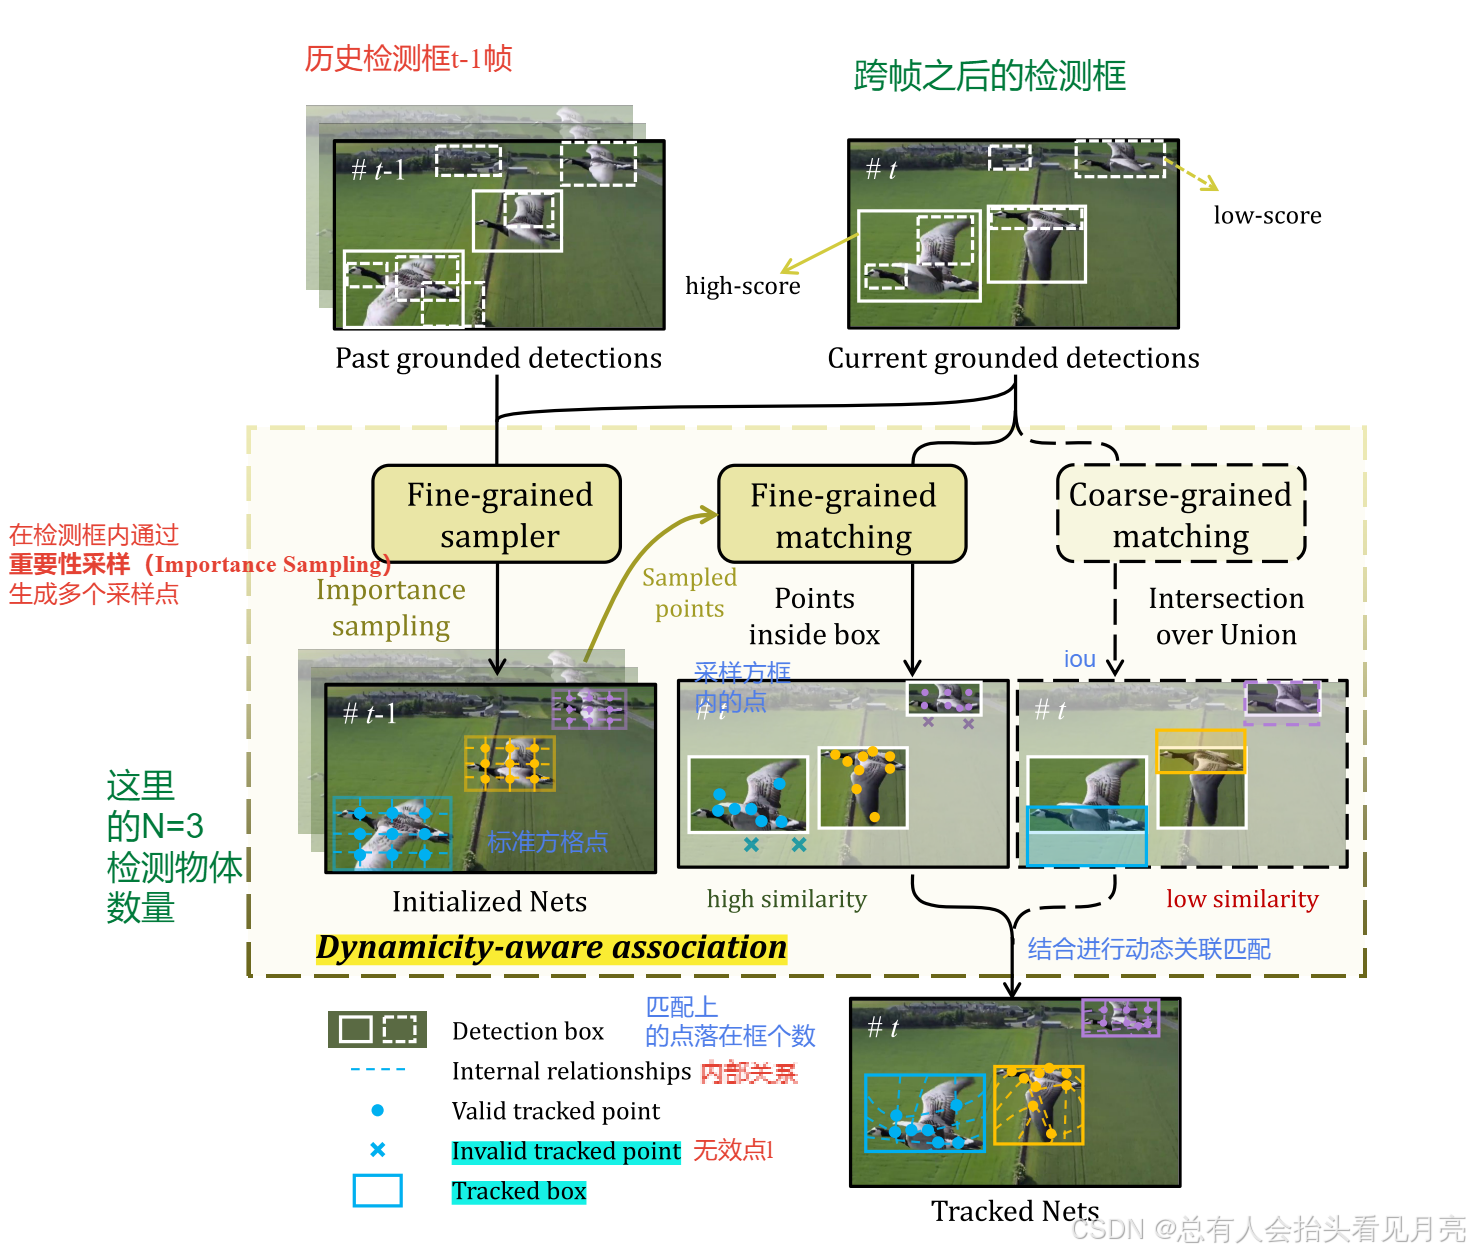
帧#t-1处确定细粒度POI并且在帧#t处利用点跟踪模型来估计细粒度POI。
细粒度匹配策略
- 利用细粒度网络进行跟踪需要基于时间相似性将存储的POI与当前检测结果进行匹配。
利用时间相似性将历史信息(过去帧中跟踪的POIs)与当前帧的检测结果关联起来。
-
兴趣点提取与存储:
-
在每一帧中,从检测到的目标区域中提取兴趣点,并存储它们的位置、视觉特征、运动状态等信息。
-
这些兴趣点是上一帧的跟踪结果,代表目标的局部细节。
-
-
当前帧兴趣点提取:
- 对当前帧的检测结果进行分析,提取新的兴趣点。
-
时间相似性计算:
- 位置相似性:基于历史运动轨迹(例如使用卡尔曼滤波预测的运动位置),判断当前兴趣点的位置是否与存储的兴趣点接近。
- 外观相似性:通过细粒度视觉特征(如颜色、纹理)计算当前帧兴趣点与存储兴趣点的相似性。
- 时序一致性:考虑物体在相邻帧中的运动连续性,防止跨目标混淆。
利用细粒度网络进行跟踪的过程依赖于存储的POIs和当前帧检测结果之间的时间相似性匹配。通过结合位置、外观、和时序信息,可以有效实现对目标的动态跟踪。相比传统方法,这种方法更加鲁棒,适合复杂场景和快速变化的动态目标。
- 给定点跟踪器模型
Trp,可以在上述时段中获得估计点轨迹Tp。
Net中的估计点:这些点是通过细粒度网络生成的,代表目标物体的局部细节或关键特征点(例如,边缘点、纹理点)。每个点携带空间位置、特征信息,能够反映目标的局部外观特征。
- 细粒度匹配方法通过计算Net中点
落入检测框的数量,实现了细粒度相似性的衡量。相比传统的粗粒度匹配方法(如IOU),这种方法更关注目标的局部特征,更适合动态场景中的目标跟踪任务。
- 假设N是帧#t-1中被跟踪对象的数量
N个估计点:
{
P
i
}
i
=
1
N
\left\{\mathbf{P}_{i}\right\}_{i=1}^{N}
{Pi}i=1N
和M个检测框:
{ b j } j = 1 M \left\{\mathbf{b}_{j}\right\}_{j=1}^{M} {bj}j=1M
的匹配细粒度得分矩阵S的元素Si,j可以表示为:
S i , j = w i , j ∣ P i ∩ b j ∣ ∣ P i ∣ , w i , j = min { 1 , A ( b ^ i ) A ( b j ) } \mathbf{S}_{i, j}=w_{i, j} \frac{\left|\mathbf{P}_{i} \cap \mathbf{b}_{j}\right|}{\left|\mathbf{P}_{i}\right|}, \quad w_{i, j}=\min \left\{1, \frac{\mathcal{A}\left(\hat{\mathbf{b}}_{i}\right)}{\mathcal{A}\left(\mathbf{b}_{j}\right)}\right\} Si,j=wi,j∣Pi∣∣Pi∩bj∣,wi,j=min⎩ ⎨ ⎧1,A(bj)A(b^i)⎭ ⎬ ⎫
N的匹配细粒度得分矩阵S的元素Sij
公式中的含义分析与解释:
Sij表示:细粒度相似性分数,用于评估第 𝑖个跟踪目标(Net 𝑃𝑖)与第 𝑗个候选检测框 𝑏𝑗的相似性。
∣ P i ∣ : Net P i 中所有点的数量,即细粒度网络中的所有估计点数。 \begin{array}{l} \left|P_{i}\right|: \text {Net } P_{i} \text { 中所有点的数量,即细粒度网络中的所有估计点数。 } \end{array} ∣Pi∣:Net Pi 中所有点的数量,即细粒度网络中的所有估计点数。
∣ P i ∩ b j ∣ : \left|P_{i} \cap b_{j}\right|: ∣Pi∩bj∣:
这些在图中就表述为有效点
- 落入检测框bi内的点数量这些点是从第个NetPi中选取的,表示与候选检测框bj的空间重叠程度。
∣ P i ∩ b j ∣ ∣ P i ∣ : \frac{\left|P_{i} \cap b_{j}\right|}{\left|P_{i}\right|}: ∣Pi∣∣Pi∩bj∣:
-
归一化比例,即第i个Net的点有多大比例落入候选框bj,用于衡量重叠程度。
-
Wij为权重因子:用于惩罚候选检测框过大的情况。当检测框过大时,即使目标和框实际不匹配,也会有很多点误落入框中,导致潜在误判。引入权重wij对其进行约束。
上面的解释就是如何得到用于匈牙利算法中最重要的矩阵S用来衡量第i个点集和下一帧(不一定是连续)的相似性程度
这里的S在于粗粒度匹配得到的cost矩阵进行融合之后进行二部图的匹配就可以了。
权重系数的解释:
A ( b ^ i ) : 预测框 b ^ i 的面积,即上一个时刻第 i 个跟踪目标的预测边界框面积。 \mathcal{A}\left(\hat{\mathbf{b}}_{i}\right):\text { 预测框 } \hat{b}_{i} \text { 的面积,即上一个时刻第 } i \text { 个跟踪目标的预测边界框面积。 } A(b^i): 预测框 b^i 的面积,即上一个时刻第 i 个跟踪目标的预测边界框面积。
A ( b j ) : \mathcal{A}\left(b_{j}\right): A(bj):
- 候选检测框bj的面积
权重限制,取预测框面积和候选框面积的比值,确保权重值 𝑤𝑖,𝑗不超过 1。这可以有效地抑制过大检测框对细粒度相似性的负面影响。
w i , j = min { 1 , A ( b ^ i ) A ( b j ) } , w_{i, j}=\min \left\{1, \frac{\mathcal{A}\left(\hat{\mathbf{b}}_{i}\right)}{\mathcal{A}\left(\mathbf{b}_{j}\right)}\right\}, wi,j=min⎩ ⎨ ⎧1,A(bj)A(b^i)⎭ ⎬ ⎫,
总结以上就是:多目标跟踪的点跟踪匹配方式和一些采样方式与设计方法在NetTrack这篇论文中的理论部分的总结。
未完待续:之后会结合一些代码绘制一些图在细节的实现方式上在进行一些总结。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献5条内容

所有评论(0)