transformer架构解析{模型构建,模型创建}(含代码)-8
·
目录
前言
前面一节我们学习了输出部分组成部分(线形层+softmax),以及代码实现,接下来万事俱备,我们可以来构建模型。
编码器-解码器结构
学习目标
掌握编码器-解码器结构的实现过程
掌握Transformer模型的构建过程
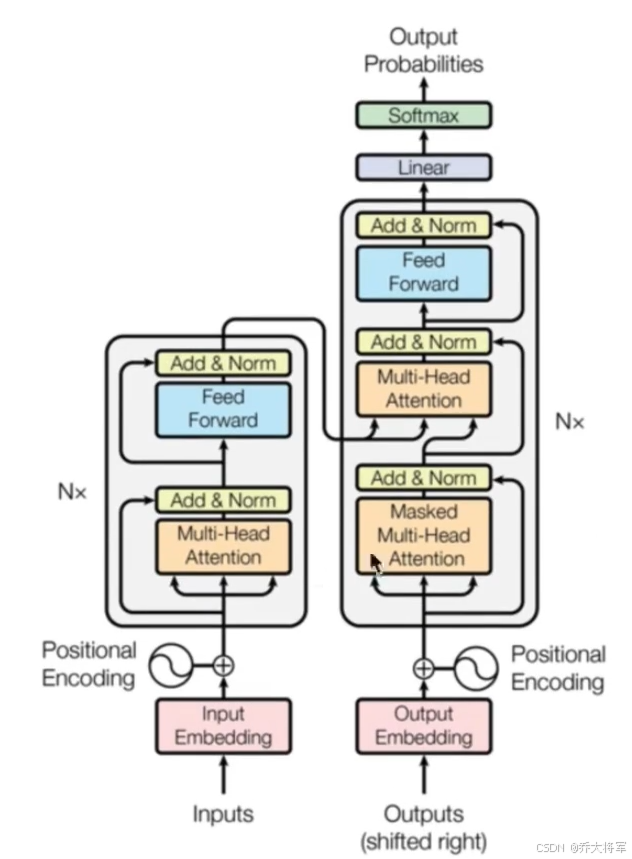
编码器-解码器结构连接
从图中我们可以看到,编码器和解码器的连接是将编码器的输出当作解码器的第二个子层的输入即多头注意力机制K=V=解码器输出,最后经过输出部分达到目标输出。
编码器-解码器的代码实现
#编码器-解码器结构的代码实现
#使用EncoderDecoder类来实现编码器-解码器结构
class EncoderDecoder(nn.Module):
    def __init__(self, encoder,decoder,source_embed,target_embed,generator):
        #初始化参数:编码器对象,解码器对象,原数据嵌入函数,目标数据嵌入函数,以及输出部分的生成器对象
        super(EncoderDecoder,self).__init__()

        #将参数传入到类中
        self.encoder = encoder
        self.decoder = decoder
        self.src_embed = source_embed
        self.tgt_embed = target_embed
        self.generator = generator

    def encode(self,source,source_mask):
        #编码函数,以source和source_mask为参数
        #使用src_embed对source处理,然后和source_mask一起传给self.encoder
        return self.encoder(self.src_embed(source),source_mask)

    def decode(self,memory,source_mask,target,target_mask):
        #编码函数,以memory即编码器的输出,source_mask,target,target_mask为参数
        #使用target_embed对target处理,然后和source_mask,target_mask,memory一起传给self.decoder
        return self.decoder(self.tgt_embed(target),memory,source_mask,target_mask)

    def forward(self,source,target,source_mask,target_mask):
        #在forward函数中,有4个参数,source代表原数据,target代表目标数据
        #source_mask和target_mask代表对应的掩码张量

        #在函数中,将source,source_mask转入编码器函数,得到结果后
        #与source_mask,target,和target_mask一同传入解码器函数
        return self.decode(self.encode(source,source_mask),source_mask,target,target_mask)
#实例化参数
vocab_size = 1000
d_model = 512
encoder = en
decoder = de
source_embed = nn.Embedding(vocab_size,d_model)
target_embed = nn.Embedding(vocab_size,d_model)
generator = gen#造数据
source = target = Variable(torch.LongTensor([[100,2,421,508],[491,998,1,221]]))
source_mask = target_mask = Variable(torch.zeros(2,4,4))
ed = EncoderDecoder(encoder,decoder,source_embed,target_embed,generator)
ed_result = ed(source,target,source_mask,target_mask)
print(ed_result)
print(ed_result.shape)
print(ed_result.dtype)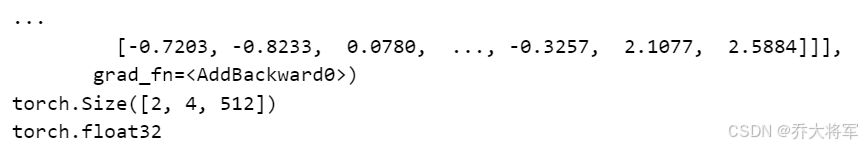
构建模型
构建模型的作用是实现初始化模型
#接着将基于以上的结构构建用于训练的模型
def make_model(source_vocab,target_vocab,N=6,d_model=512,d_ff=2048,head=8,dropout=0.1):
    #该函数用来构建模型,有7个参数,分别是原数据特征(词汇)总数,目标数据特征(词汇)总数,编码器
    #和解码器堆叠数,词向量映射维度,前馈全连接网络中变换矩阵的维度,多头注意力结构中的多头数,以及置零比率dropout

    #首先得到一个深度拷贝的命令,接下来很多结构都需要进行深度拷贝
    #来保证他们彼此之间相互独立,不受干扰
    c = copy.deepcopy

    #实例化多头注意力类,得到对象attn
    attn = MutiHeadedAttention(head,d_model)

    #实例化前馈全连接类,得到对象ff
    ff = PositionwiseFeedForward(d_model,d_ff,dropout)

    #实例化位置编码类,得到对象position
    position = PositionalEncoding(d_model,dropout)

    #根据结构图,最外层是EncoderDecoder,在EncoderDecoder中,分别是编码器层,解码器层,源数据层Embedding层和位置编码组成
    #有序结构,目标数据Embedding层和位置编码组成的有序结构,以及类别生成器
    #在目标编码层中有attention子层以及前馈全连接子层
    #在解码器层中有两个attention子层以及前馈全连接层
    model = EncoderDecoder(
        Encoder(EncoderLayer(d_model,c(attn),c(ff),dropout),N),
        Decoder(DecoderLayer(d_model,c(attn),c(attn),c(ff),dropout),N),
        nn.Sequential(Embeddings(d_model,source_vocab),c(position)),
        nn.Sequential(Embeddings(d_model,target_vocab),c(position)),
        Generator(d_model,target_vocab)
    )
    #模型结构完成后,接下来就是初始化模型中的参数,比如线性层中的变换矩阵
    #这里一旦判断参数的维度大于1,则会将其初始化成一个服从均匀分布的矩阵
    for p in model.parameters():
        if p.dim() > 1:
            nn.init.xavier_uniform(p)
    return model
#输入参数
source_vocab = 11
target_vocab = 11
N = 6
res = make_model(source_vocab,target_vocab,N)
print(res)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)