大模型微调:原理、实现与效果对比
1、前缀调优
前缀调优(Prefix-Tuning)作为自然语言生成任务中的一种创新性轻量级微调方法,其核心思想是通过引入可训练的连续前缀向量来引导预训练语言模型的生成行为,而无需调整模型原有参数。这种技术的精妙之处在于它将传统的离散提示(prompt)转化为可优化的连续向量空间表示,在完全冻结原始语言模型参数的前提下,仅需训练占模型总参数量极小比例的前缀向量,就能实现特定任务性能的显著提升。其技术突破主要体现在参数效率、架构创新和训练稳定性三个维度:在保持预训练知识完整性的同时大幅降低计算资源需求,将离散提示映射为连续可微的向量表示,并通过注意力机制实现隐式引导,有效避免了传统微调方法中常见的灾难性遗忘问题。这种"冻结主体+优化引导"的范式为大规模预训练模型的高效适配提供了新的技术路径。如图1所示
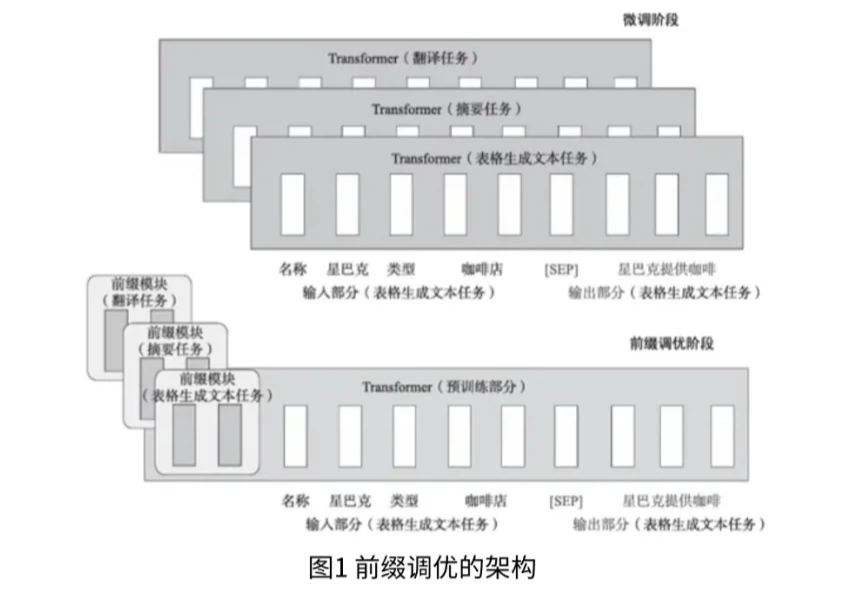
由于在训练中只需要为每个任务存储前缀,前缀调优的轻量级设计避免了存储和计算资源的浪费,同时保持了模型的性能,具有模块化和高效利用空间的特点,有望在NLP任务中提供高效的解决方案。
2、前缀调优
提示调优(PromptTuning)方法是由BrianLester在论文“ThePower of Scale for Parameter-Efficient Prompt Tuning,”中提出的。
提示调优采用“软提示”(SoftPrompt)的方式,通过冻结整个预训练模型,只允许每个下游任务在输入文本前面添加k个可调的标记(Token)来优化模型参数,赋予语言模型能够执行特定的下游任务的能力,如图2所示
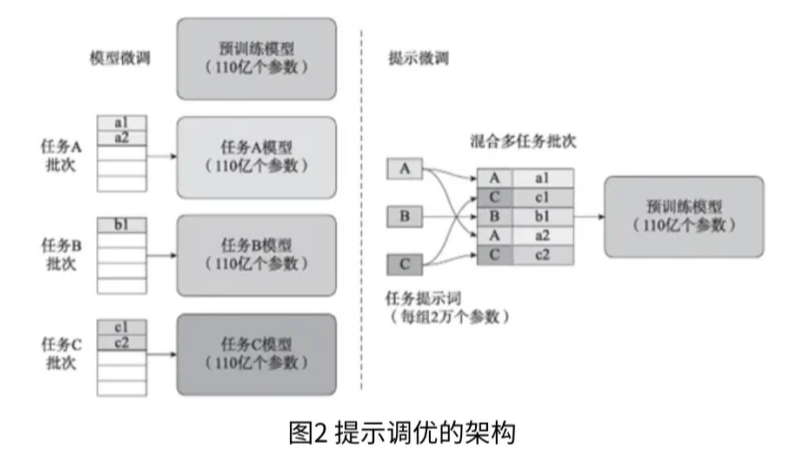
在论文的实验对比中,对于T5-XXL模型,每个经过调整的模型副本需要110亿个参数,相较于为每个下游任务制作特定的预训练模型副本,提示调优需要的参数规模仅为20480个参数。该方法在少样本提示方面表现出色。
3、P-Tuning v2
尽管提示调优在相应任务上取得了一定的效果,但当底座模型规模较小,特别是小于1000亿个参数时,效果表现不佳。为了解决这个问题,清华大学的团队提出了针对深度提示调优的优化和适应性实现–P-Tuning v2方法。
该方法最显著的改进是对预训练模型的每一层应用连续提示,而不仅仅是输入层。
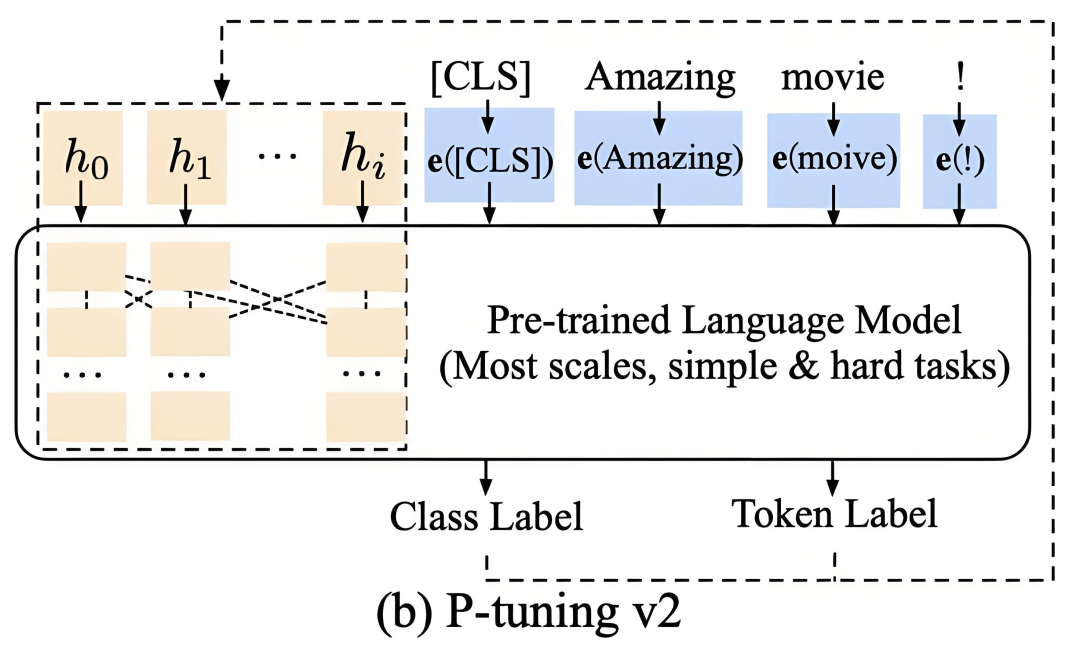
这实际上是一种针对大型语言模型的软提示方法,主要是将大型语言模型的词嵌入层和每个Transformer网络层前都加上新的参数。
深度提示调优增加了连续提示的功能,并缩小了在各种设置之间进行微调的差距,特别是对于小型模型和困难的任务。
4、LORA
微软公司在2021年提出了一种名为Low-RankAdaptation(LORA,低秩适配器)的方法。
LORA的核心思想是通过冻结预训练模型的权重,并将可训练的秩分解矩阵注入Transformer架构的每一层,从而显著减少下游任务中可训练参数的数量。
在训练过程中,只需要固定原始模型的参数,然后训练降维矩阵A和升维矩阵B,如图3所示
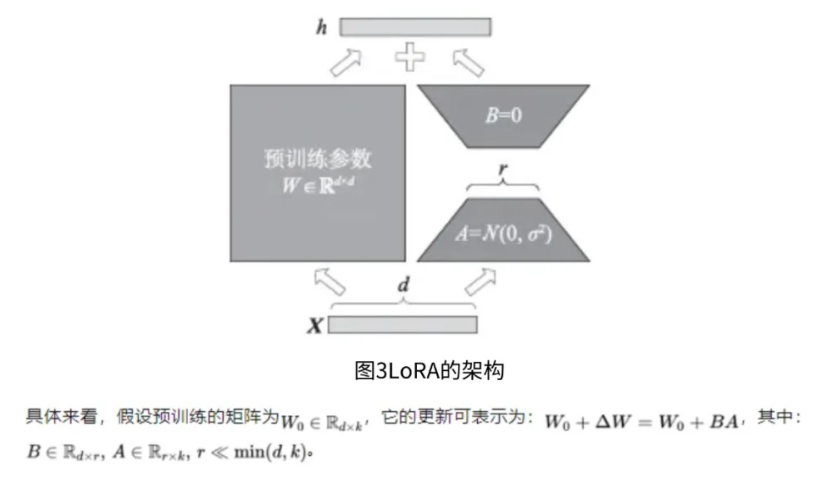
与使用Adam微调的GPT-3175B相比,LORA可以将可训练参数的数量减少10000倍,并将GPU内存需求减少3倍。
尽管LORA的可训练参数较少,训练吞吐量较高,但与ROBERTa、DeBERTa、GPT-2和GPT-3等模型相比,LORA在模型质量性能方面与微调相当,甚至更好
5、DyLORA
但随着研究的深入,LORA块存在两大核心问题
(1)一旦训练完成后,LORA块的大小便无法更改,若要调整LORA块的秩,则需重新训练整个模型,这无疑增加了大量时间和计算成本。
(2)LORA块的大小是在训练前设计的固定超参,优化秩的过程需要精细的搜索与调优操作,仅设计单一的超参可能无法有效提升模型效果。
为解决上述问题,研究者引入了一种全新的方法-DyLORA(动态低秩适应)
研究者参考LORA的基本架构,针对每个LORA块设计了上投影(Wup)和下投影(Wdw)矩阵及当前LORA块的规模范围R。
为确保增加或减少秩不会明显阻碍模型的表现,在训练过程中通过对LORA块对不同秩的信息内容进行排序,再结合预定义的随机分布中进行抽样,来对LORA块镜像上投影矩阵和下投影矩阵截断,最终确认单个LORA块的大小,如图4所示
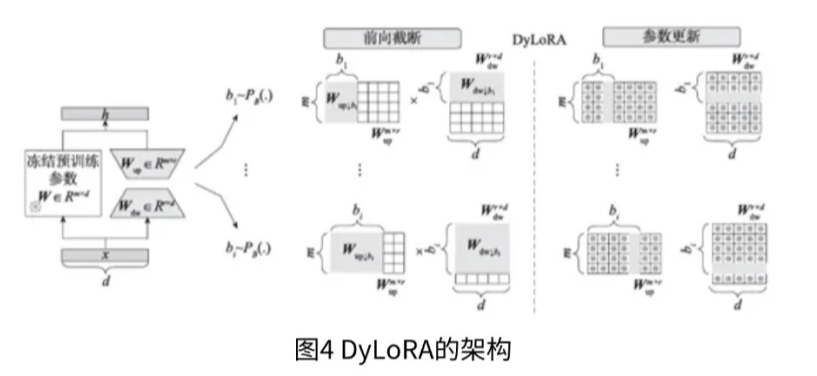
研究结果表明,与LORA相比,使用DyLORA训练出的模型速度可提升4~7倍,且性能几乎没有下降。此外,与LORA相比,该模型在更广泛的秩范围内展现出了卓越的性能。
6、AdaLORA
正如DyLORA优化方法一样,提出AdaLORA的研究者也发现,当前LORA存在的改进方向:
由于权重矩阵在不同LORA块和模型层中的重要性存在差异,因此不能提前制定一个统一规模的秩来约束相关权重信息,需要设计可以支持动态更新的参数矩阵
需要设计有效的方法来评估当前参数矩阵的重要性,并根据重要性程度,为重要性高的矩阵分配更多参数量,以提升模型效果,对重要性低的矩阵进行裁剪,进一步降低计算量根据上述思想。
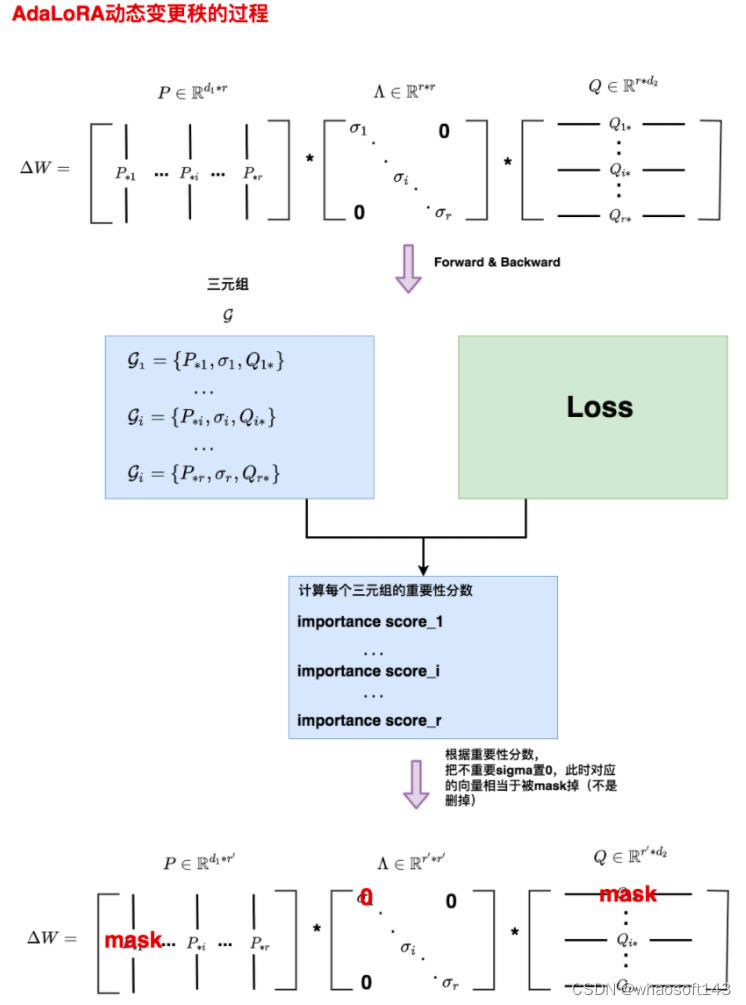
研究者提出了AdaLORA方法,可以根据权重矩阵的重要性得分,在权重矩阵之间自适应地分配参数规模。
在实际操作中,AdaLoRA采用奇异值分解(SVD)的方法来进行参数训练,根据重要性指标剪裁掉不重要的奇异值来提高计算效率,从而进一步提升模型在微调阶段的效果。
7、QLORA
TimDettmers等研究者在论文“QLORA:Efficient Finetuning ofQuantized LLMs”中提出了一种高效的模型微调方法–OLORA,如图5所示
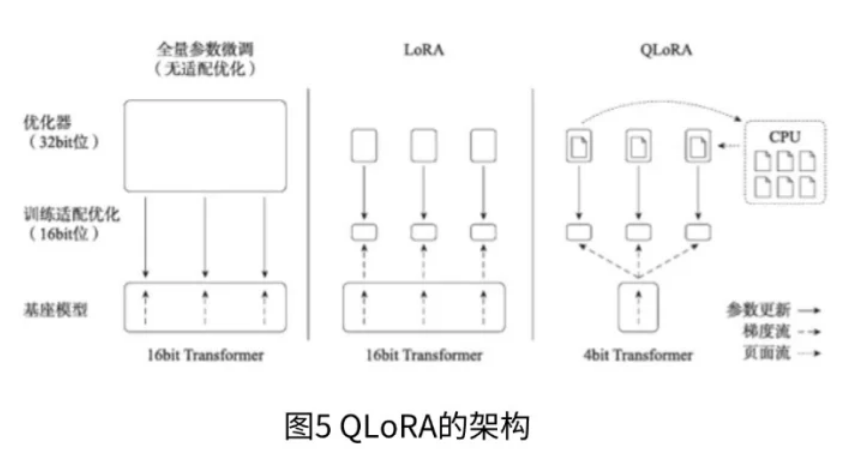
OLORA的创新内容主要如下:
4bit NormalFloat(NF4)。NF4是一种新型数据类型,它对正态分布的权重来说是信息理论上的最优选择
双重量化技术。双重量化技术减少了平均内存的使用,它通过对已量化的常量进行再量化来实现
分页优化器。分页优化器有助于管理内存峰值,防止梯度检查点时出现内存不足的错误
实验表明,QLORA技术使得研究者能够在单个48GBGPU上微调650亿个参数规模的模型,同时维持16bit精度任务的完整性能。
例如,在训练Guanaco模型时,仅需在单个GPU上微调24h,即可达到与ChatGPT相当的99.3%性能水平。通过OLORA微调技术,可以有效降低模型微调时的显存消耗
8、OA-LORA
在论文“OA-LoRA: Quantization-aware Low-rank Adaptation oflargelanguagemodels”中,研究者提出了一种量化感知的低秩适应(OA-LORA)算法。该方法来源于量化和适应的自由度不平衡的思想。
研究者提出采用分组运算符的方式,旨在增加量化自由度的同时减少适应自由度。
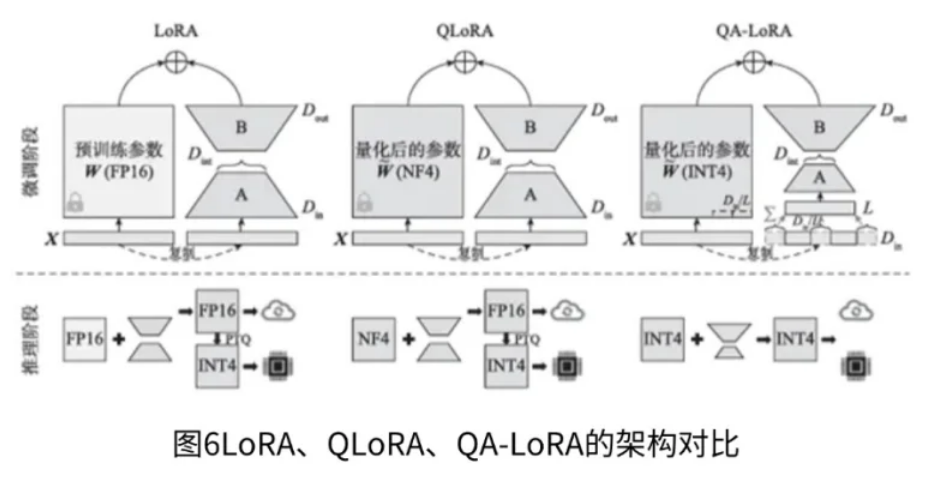
QA-LORA的实现简便,仅需几行代码,同时赋予原始的LORA两倍的能力:在微调过程中,LLM的权重被量化(如INT4),以降低时间和内存的使用
微调后,LLM和辅助权重能够自然地集成到一个量化模型中,而不损失准确性
通过在LLaMA和LLaMA2模型系列的实验中证明,QA-LORA在不同的微调数据集和下游场景中验证了其有效性。
如图6所示,与之前的适应方法LORA和QLORA相比,OA-LORA在微调和推理阶段都具有更高的计算效率。
由于不需要进行训练后量化,因此它不会导致准确性损失。在图6中展示了INT4的量化,但OA-LORA可以推广到INT3和INT2
9、LongLORA
通常情况下,用较长的上下文长度训练大型语言模型的计算成本较高,需要大量的训练时间和GPU资源。
为了在有限的计算成本下扩展预训练大型语言模型的上下文大小,研究者在论文“LongLoRA: Efficient Fine-tuningof Long-ContextLarge LanguageModels”中提出了LongLORA的方法,如图7所示
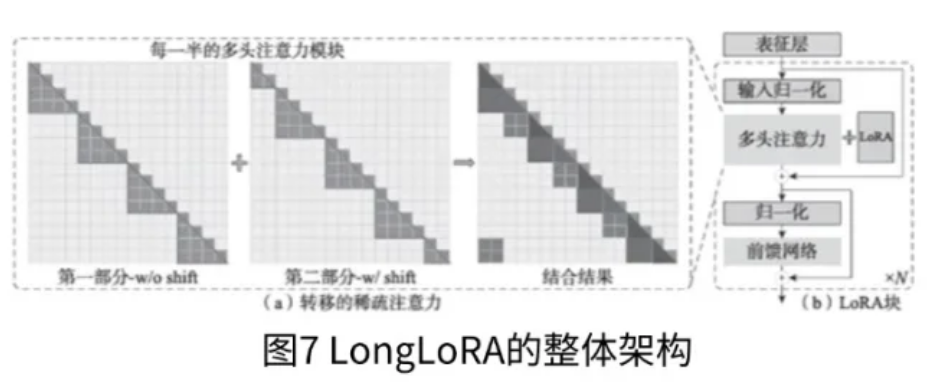
LongLORA在两个方面进行了改进:
虽然在推理过程中需要密集的全局注意力,但通过采用稀疏的局部注意力,可以有效地进行模型微调。
在LongLORA中,引入的转移短暂的注意力机制能够有效地实现上下文扩展,从而在性能上与使用香草注意力(Vanilla Attention)进行微调的效果相似
通过重新审视上下文扩展的参数高效微调机制,研究者发现在可训练嵌入和规范化的前提下,用于上下文扩展的LORA表现良好
LongLORA在从70亿、130亿到700亿个参数的LLaMA2模型的各种任务上都取得了良好的结果。
LongLORA采用LLaMA2-7B型,将上下文长度从4000个Token扩展到10万个Token,展现了其在增加上下文长度的同时保持了高效计算的能力。
这为大型语言模型的进一步优化和应用提供了有益的思路。
10、VeRA
LORA是一种常用的大型语言模型微调方法,它在微调大型语言模型时能够减少可训练参数的数量。
然而,随着模型规模的进一步扩大或者需要部署大量适应于每个用户或任务的模型时,存储问题仍然是一个挑战。
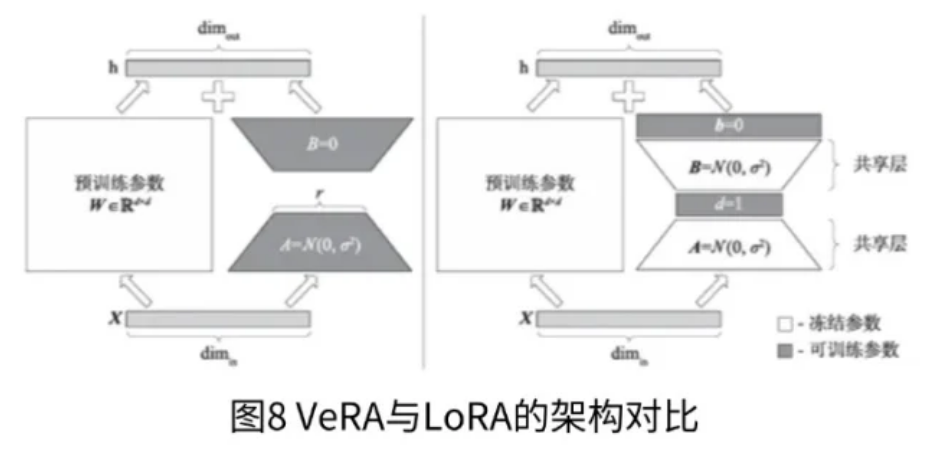
研究者提出了一种基于向量的随机矩阵适应(Vector-based Randommatrix Adaptation,VeRA)的方法,VeRA的实现方法是通过使用:
对低秩矩阵在所有层之间共享,并学习小的缩放向量来实现这一目标。
与LORA相比,VeRA成功将可训练参数的数量减少了10倍,同时保持了相同的性能水平,如图8所示,LORA通过训练低秩矩阵和来更新权重矩阵,中间秩为。
在VeRA中,这些矩阵被冻结,在所有层之间共享,并通过可训练向量和进行适应,从而显著减少可训练参数的数量。
在这种情况下,低秩矩阵和向量可以合并到原始权重矩阵中,不引入额外的延迟。
这种新颖的结构设计使得VeRA在减少存储开销的同时,还能够保持和LORA相媲美的性能,为大型语言模型的优化和应用提供了更加灵活的解决方案。
实验证明,VeRA在GLUE和E2E基准测试中展现了其有效性,并在使用LLaMA2 7B模型时仅使用140万个参数的指令就取得了一定的效果。
这一方法为在大型语言模型微调中降低存储开销提供了一种新的思路,有望在实际应用中取得更为显著的效益。
11、S-LORA
LORA作为一种参数高效的大型语言模型微调方法,通常用于将基础型适应到多种任务中,从而形成了大量派生自基础模型的LORA模型。
由于多个采用LORA形式训练的模型的底座模型都为同一个,因此可以参考批处理模式进行推理。
据此,研究者提出了一种S-LoRA(Servingthousandsofcon currentLoRAadapters)方法,S-LORA是一种专为可伸缩地服务多个LORA适配器而设计的方法。
S-LORA的设计理念是将所有适配器存储在主内存中,并在GPU内存中动态获取当前运行查询所需的适配器。
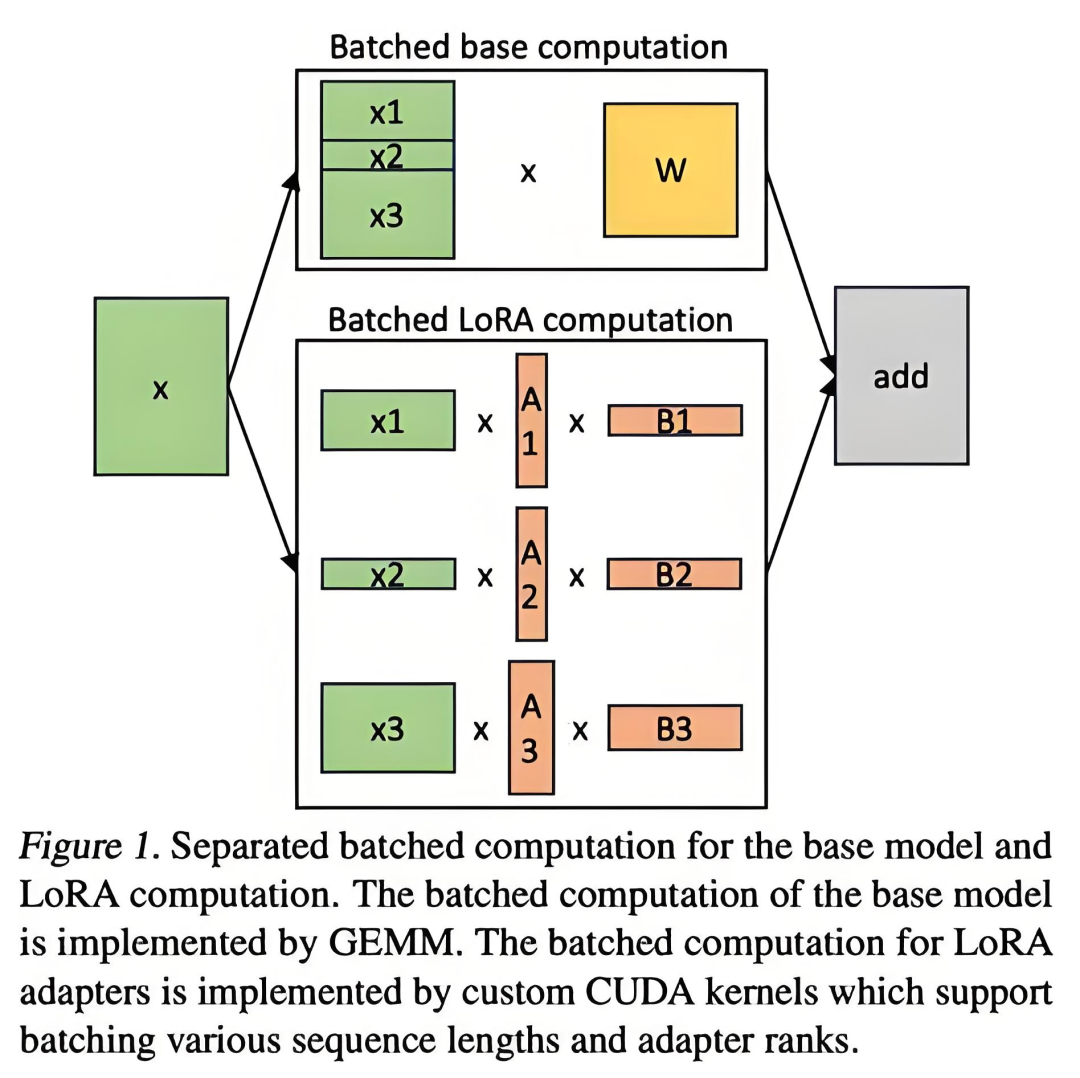
为了高效使用GPU内存并减少碎片,S-LORA引入了统一分页。统一分页采用统一的内存池来管理具有不同秩的动态适配器权重以及具有不同序列长度的KV缓存张量。
此外,S-LORA还采用了一种新颖的张量并行策略和高度优化的自定义CUDA核心,用于异构批处理LORA计算。
这些特性使得S-LORA能够在单个GPU或跨多个GPU上提供数千个LORA适配器,而开销相对较小。通过实验发现,S-LORA的吞吐量提高了4倍多,并且提供的适配器数量增加了数个数量级。
因此,S-LORA在实现对许多任务特定微调模型的可伸缩服务方面取得了显著进展,并为大规模定制微调服务提供了潜在的可能性。
随着大模型的持续火爆,各行各业纷纷开始探索和搭建属于自己的私有化大模型,这无疑将催生大量对大模型人才的需求,也带来了前所未有的就业机遇。**正如雷军所说:“站在风口,猪都能飞起来。”**如今,大模型正成为科技领域的核心风口,是一个极具潜力的发展机会。能否抓住这个风口,将决定你是否能在未来竞争中占据先机。
那么,我们该如何学习大模型呢?
人工智能技术的迅猛发展,大模型已经成为推动行业变革的核心力量。然而,面对复杂的模型结构、庞大的参数量以及多样的应用场景,许多学习者常常感到无从下手。作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。
为此,我们整理了一份全面的大模型学习路线,帮助大家快速梳理知识,形成自己的体系。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一、大模型全套的学习路线
大型预训练模型(如GPT-3、BERT、XLNet等)已经成为当今科技领域的一大热点。这些模型凭借其强大的语言理解和生成能力,正在改变我们对人工智能的认识。为了跟上这一趋势,越来越多的人开始学习大模型,希望能在这一领域找到属于自己的机会。
L1级别:启航篇 | 极速破界AI新时代
- AI大模型的前世今生:了解AI大模型的发展历程。
- 如何让大模型2C能力分析:探讨大模型在消费者市场的应用。
- 行业案例综合分析:分析不同行业的实际应用案例。
- 大模型核心原理:深入理解大模型的核心技术和工作原理。

L2阶段:攻坚篇 | RAG开发实战工坊
- RAG架构标准全流程:掌握RAG架构的开发流程。
- RAG商业落地案例分析:研究RAG技术在商业领域的成功案例。
- RAG商业模式规划:制定RAG技术的商业化和市场策略。
- 多模式RAG实践:进行多种模式的RAG开发和测试。

L3阶段:跃迁篇 | Agent智能体架构设计
- Agent核心功能设计:设计和实现Agent的核心功能。
- 从单智能体到多智能体协作:探讨多个智能体之间的协同工作。
- 智能体交互任务拆解:分解和设计智能体的交互任务。
- 10+Agent实践:进行超过十个Agent的实际项目练习。

L4阶段:精进篇 | 模型微调与私有化部署
- 打造您的专属服务模型:定制和优化自己的服务模型。
- 模型本地微调与私有化:在本地环境中调整和私有化模型。
- 大规模工业级项目实践:参与大型工业项目的实践。
- 模型部署与评估:部署和评估模型的性能和效果。

专题集:特训篇
- 全新升级模块:学习最新的技术和模块更新。
- 前沿行业热点:关注和研究当前行业的热点问题。
- AIGC与MPC跨领域应用:探索AIGC和MPC在不同领域的应用。

掌握以上五个板块的内容,您将能够系统地掌握AI大模型的知识体系,市场上大多数岗位都是可以胜任的。然而,要想达到更高的水平,还需要在算法和实战方面进行深入研究和探索。
- AI大模型学习路线图
- 100套AI大模型商业化落地方案
- 100集大模型视频教程
- 200本大模型PDF书籍
- LLM面试题合集
- AI产品经理资源合集
以上的AI大模型学习路线,不知道为什么发出来就有点糊,高清版可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

二、640套AI大模型报告合集
这套包含640份报告的合集,全面覆盖了AI大模型的理论探索、技术落地与行业实践等多个维度。无论您是从事科研工作的学者、专注于技术开发的工程师,还是对AI大模型充满兴趣的爱好者,这套报告都将为您带来丰富的知识储备与深刻的行业洞察,助力您更深入地理解和应用大模型技术。

三、大模型经典PDF籍
随着人工智能技术的迅猛发展,AI大模型已成为当前科技领域的核心热点。像GPT-3、BERT、XLNet等大型预训练模型,凭借其卓越的语言理解与生成能力,正在重新定义我们对人工智能的认知。为了帮助大家更高效地学习和掌握这些技术,以下这些PDF资料将是极具价值的学习资源。
四、AI大模型商业化落地方案
AI大模型商业化落地方案聚焦于如何将先进的大模型技术转化为实际的商业价值。通过结合行业场景与市场需求,该方案为企业提供了从技术落地到盈利模式的完整路径,助力实现智能化升级与创新突破。

希望以上内容能对大家学习大模型有所帮助。如有需要,请微信扫描下方CSDN官方认证二维码免费领取相关资源【保证100%免费】。

祝大家学习顺利,抓住机遇,共创美好未来!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献8条内容

所有评论(0)