YOLO-v8.3部署案例:无人机避障视觉系统集成
YOLO-v8.3部署案例:无人机避障视觉系统集成
1. 技术背景与应用场景
随着无人机在物流、巡检、农业等领域的广泛应用,自主避障能力成为其安全飞行的核心需求。传统的激光雷达或超声波传感器受限于重量、成本和环境适应性,难以满足复杂动态场景下的实时感知需求。基于深度学习的视觉感知方案逐渐成为主流,其中YOLO(You Only Look Once)系列模型因其高精度与实时性优势,被广泛应用于嵌入式视觉系统中。
YOLO由华盛顿大学的Joseph Redmon和Ali Farhadi于2015年首次提出,是一种端到端的目标检测框架,其核心思想是将目标检测任务视为一个回归问题,直接在单次前向传播中完成边界框定位与类别预测。这一设计显著提升了推理速度,使其适用于对延迟敏感的应用场景,如无人机避障、自动驾驶和机器人导航。
YOLO-v8.3作为Ultralytics公司发布的最新稳定版本之一,在检测精度、模型轻量化和部署灵活性方面进行了多项优化,尤其适合资源受限的边缘设备部署。本文将以实际工程落地为目标,详细介绍如何基于YOLO-v8.3构建一套完整的无人机避障视觉系统,并结合CSDN星图平台提供的YOLO-V8镜像实现快速开发与部署。
2. 系统架构设计与技术选型
2.1 整体架构概述
本系统的整体架构分为三个层级:感知层、处理层和控制层。
- 感知层:搭载广角摄像头采集前方环境图像数据,支持1080p@30fps视频流输入。
- 处理层:运行在嵌入式AI计算单元(如NVIDIA Jetson系列)上的YOLO-v8.3模型,负责实时执行目标检测任务,识别障碍物类别(行人、车辆、树木、电线等)及其空间位置。
- 控制层:飞控系统接收检测结果后,结合SLAM算法输出的位姿信息,规划安全路径并调整飞行姿态。
该架构的关键在于确保从图像采集到决策响应的全链路延迟低于100ms,以满足高速飞行中的避障需求。
2.2 模型选型依据
在众多YOLO变体中选择YOLO-v8.3主要基于以下几点:
| 维度 | 分析说明 |
|---|---|
| 推理速度 | YOLOv8n(nano版本)在Jetson Nano上可达45 FPS,满足实时性要求 |
| 检测精度 | 在COCO val2017数据集上mAP@0.5达到44.9%,优于YOLOv5s |
| 模型体积 | 最小版本参数量仅3.2M,便于部署至边缘设备 |
| 训练效率 | 支持自动数据增强、标签平滑和分布式训练,缩短迭代周期 |
| 部署生态 | 提供ONNX、TensorRT、TFLite导出接口,兼容多种硬件平台 |
此外,YOLO-v8.3取消了Anchor机制,采用Task-Aligned Assigner进行正负样本匹配,进一步简化了模型结构并提升了小目标检测性能,这对远距离障碍物识别尤为重要。
3. 基于YOLO-V8镜像的环境搭建与部署流程
3.1 使用CSDN星图YOLO-V8镜像快速初始化
为加速开发进程,本文采用CSDN星图平台提供的“YOLO-V8”预置镜像。该镜像已集成PyTorch 1.13 + torchvision + CUDA 11.7 + Ultralytics库,省去繁琐的依赖配置过程。
镜像基本信息
- 基础操作系统:Ubuntu 20.04
- 深度学习框架:PyTorch 1.13, CUDA 11.7, cuDNN 8
- 预装工具包:
ultralytics==8.3.0opencv-python,numpy,matplotlib- JupyterLab, SSH服务
- 默认工作目录:
/root/ultralytics
通过该镜像可一键启动包含完整开发环境的容器实例,极大提升部署效率。
3.2 开发环境访问方式
方式一:JupyterLab交互式开发
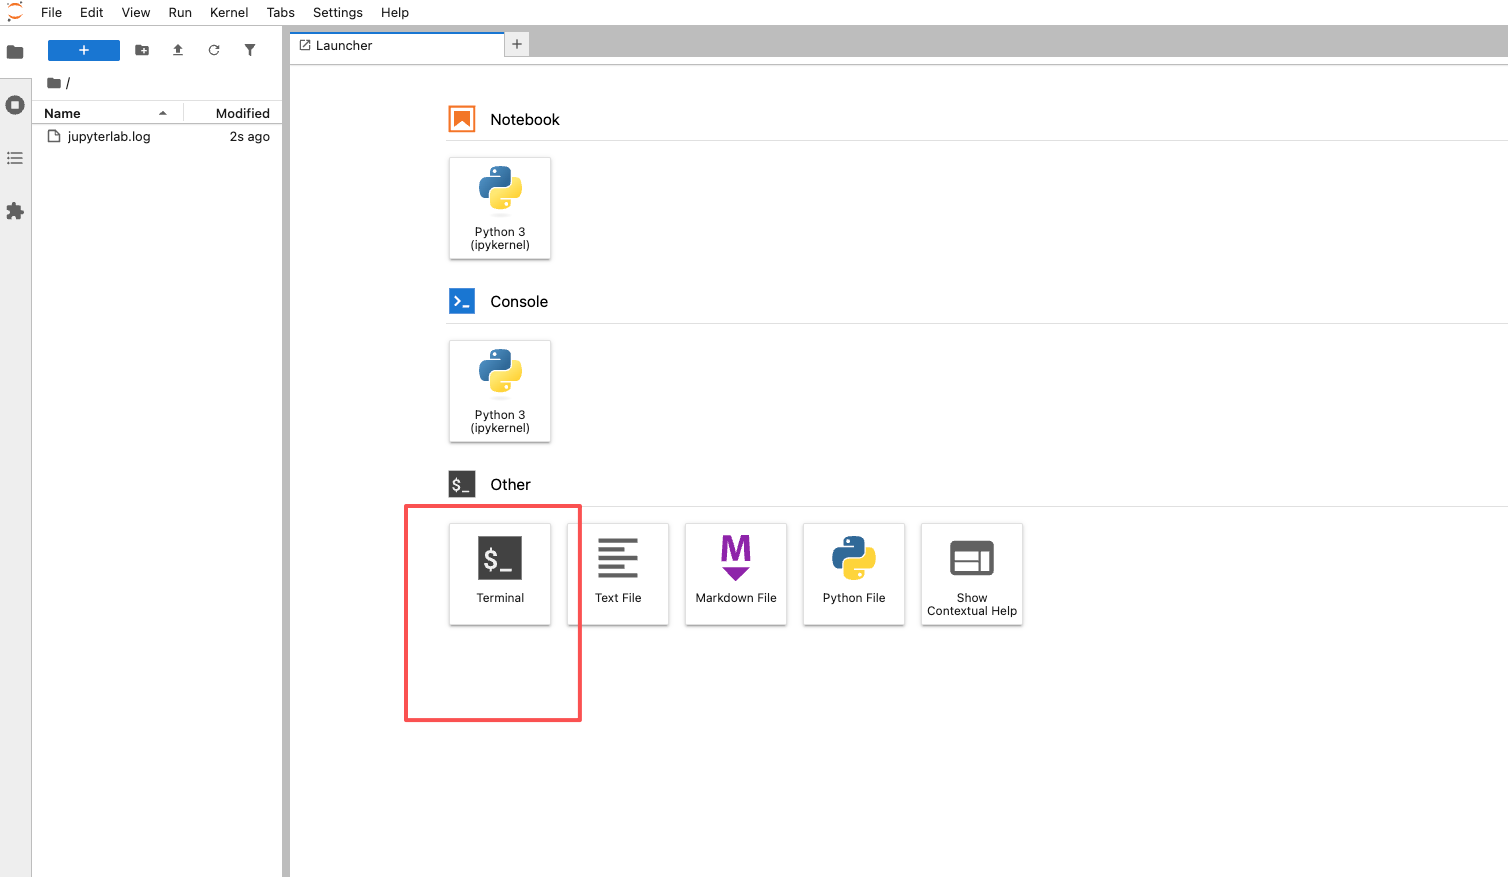
登录系统后可通过浏览器访问JupyterLab界面(默认端口8888),进行代码调试与可视化分析。
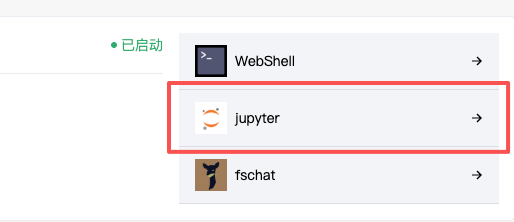
用户可在Notebook中加载预训练模型,测试图像推理效果,如下所示:
from ultralytics import YOLO
import cv2

# 加载预训练模型
model = YOLO("yolov8n.pt")

# 读取测试图像
img = cv2.imread("test_scene.jpg")

# 执行推理
results = model(img)

# 显示带标注的结果图
results[0].plot()
cv2.imshow("Detection Result", results[0].plot())
cv2.waitKey(0)
方式二:SSH远程终端操作
对于自动化脚本部署或后台服务运行,推荐使用SSH连接方式进行操作。
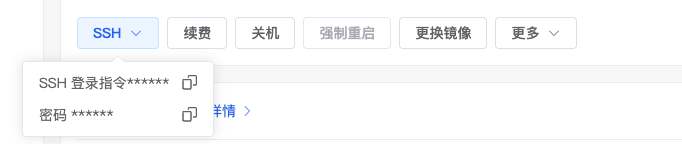
通过SSH登录后,可直接进入项目目录并运行Python脚本:
cd /root/ultralytics
python detect_obstacle.py --source rtsp://camera_ip:554/stream --weights yolov8n.pt
3.3 核心功能实现代码示例
以下为无人机避障系统的核心检测模块实现代码:
from ultralytics import YOLO
import cv2
import torch
import numpy as np

# 设置设备
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# 加载YOLOv8模型
model = YOLO("yolov8n.pt").to(device)

# 定义障碍物类别(COCO类别)
obstacle_classes = ['person', 'bicycle', 'car', 'motorcycle', 'tree', 'traffic light', 'fire hydrant']

def is_obstacle(cls_name):
    return cls_name in obstacle_classes

def detect_and_alert(frame):
    # 模型推理
    results = model(frame, conf=0.5, imgsz=640)

    detections = results[0].boxes
    alert = False
    annotated_frame = results[0].plot()

    for box in detections:
        cls_id = int(box.cls.cpu().numpy())
        cls_name = model.names[cls_id]

        if is_obstacle(cls_name):
            confidence = float(box.conf.cpu().numpy())
            # 判断是否位于飞行路径前方中心区域
            x_center = (box.xyxy[0][0] + box.xyxy[0][2]) / 2
            frame_width = frame.shape[1]
            if abs(x_center - frame_width / 2) < frame_width * 0.3:  # 中心±30%
                alert = True
                print(f"[ALERT] Obstacle detected: {cls_name} ({confidence:.2f})")

    return annotated_frame, alert

# 主循环:从摄像头读取帧并检测
cap = cv2.VideoCapture("rtsp://drone-camera-stream")  # 替换为实际视频源

while cap.isOpened():
    ret, frame = cap.read()
    if not ret:
        break

    result_frame, need_avoidance = detect_and_alert(frame)

    if need_avoidance:
        # 向飞控发送避障指令(伪代码)
        send_avoidance_command("STOP_FORWARD")

    cv2.imshow("Drone Vision", result_frame)
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
关键说明: - 使用
conf=0.5过滤低置信度检测结果,减少误报 - 仅关注飞行方向前方中心区域的目标,避免侧方无关物体干扰 - 检测结果通过results[0].plot()自动绘制边界框和标签 - 实际部署时应将send_avoidance_command替换为MAVLink协议通信逻辑
4. 性能优化与工程挑战应对
4.1 推理延迟优化策略
尽管YOLO-v8.3本身具备较高推理速度,但在嵌入式平台上仍需进一步优化以满足实时性要求。以下是几种有效的优化手段:
-
模型量化:将FP32模型转换为INT8格式,可提升2~3倍推理速度
bash model.export(format='engine', half=True, dynamic=True) # TensorRT引擎导出 -
输入分辨率调整:根据实际视距将
imgsz从640降至320,在精度损失<5%的情况下提速约40% -
异步处理流水线:采用双线程架构,一个线程负责图像采集,另一个线程执行模型推理,消除I/O等待时间
4.2 小目标检测增强
无人机高空飞行时常面临远处障碍物像素占比小的问题。为此可采取以下措施:
- 使用高分辨率相机(如4K)配合数字裁剪聚焦关键区域
- 引入特征金字塔改进模块(如BiFPN)增强多尺度特征融合能力
- 在训练阶段增加小目标数据增强(如mosaic、copy-paste)
4.3 动态环境适应性
户外光照变化、雨雾天气等因素会影响检测稳定性。建议:
- 在训练集中加入不同光照、天气条件下的真实场景数据
- 使用自监督预训练(如MAE)提升模型鲁棒性
- 结合红外摄像头构建多模态感知系统,提升夜间或低能见度下的表现
5. 总结
本文围绕YOLO-v8.3在无人机避障视觉系统中的集成应用,系统阐述了从技术选型、环境搭建到核心代码实现的完整流程。通过利用CSDN星图平台提供的YOLO-V8预置镜像,开发者能够快速构建具备目标检测能力的嵌入式视觉系统,大幅降低部署门槛。
YOLO-v8.3凭借其优异的速度-精度平衡特性,已成为边缘端视觉感知的理想选择。在实际工程中,还需结合具体硬件平台进行性能调优,并针对应用场景定制训练数据集,以实现更精准、更可靠的避障能力。
未来可探索的方向包括: - 融合语义分割实现更精细的环境理解 - 结合BEV(Bird's Eye View)转换实现三维空间建模 - 利用NAS技术搜索更适合无人机场景的轻量级网络结构
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献23条内容

所有评论(0)