即插即用系列 | CVPR 2025 DFormerv2:用于Rgbd语义分割的几何自注意力
论文名称:DFormerv2: Geometry Self-Attention for RGBD Semantic Segmentation
论文原文 (Paper):https://arxiv.org/abs/2504.04701
代码 (code):https://github.com/VCIP-RGBD/DFormer
哔哩哔哩视频讲解:https://space.bilibili.com/57394501?spm_id_from=333.337.0.0
本论文的完整复现代码(即插即用版)已更新至专栏
即插即用系列(代码实践) | CVPR 2025 DFormerv2:用于Rgbd语义分割的几何自注意力
1. 核心思想
本文提出了一种名为 DFormerv2 的新型 RGBD 语义分割网络,旨在解决现有方法中 RGB 和深度信息融合计算成本高、编码不一致的问题。其核心创新在于不再使用神经网络显式编码深度图,而是将深度信息转化为 几何先验(Geometry Prior),并将其嵌入到自注意力机制中,提出 几何自注意力(Geometry Self-Attention, GSA)。通过这种方式,DFormerv2 在不增加额外深度编码器的情况下,有效地利用了 3D 几何信息指导视觉特征的交互,实现了 SOTA 性能的同时大幅降低了计算成本(如在 NYU Depth V2 上仅用不到一半的 FLOPs 就超越了次优方法)。
2. 背景与动机
-
文本角度总结:
RGBD 语义分割通过引入深度信息来增强对复杂场景的理解。现有的主流方法(如双流网络或统一编码器)通常将深度图视为与 RGB 图像类似的模态,使用卷积或 Transformer 进行特征编码和融合。这带来了两个主要问题:- 计算冗余:使用两个独立的编码器或在统一编码器中处理双模态数据会导致显著的计算开销。
- 特征分布偏移:大多数模型是在 RGB 数据集(如 ImageNet)上预训练的,直接输入深度图或 RGB-D 拼接数据会导致预训练与微调阶段的输入分布不一致,影响性能。
本文的动机是:深度图本质上提供了场景的几何结构信息。与其将其视为图像进行编码,不如直接将其作为一种 几何先验 来指导 RGB 特征的注意力分配,从而更高效地利用深度信息。
-
动机图解分析:
-
结合图 1 (Fig. 1):
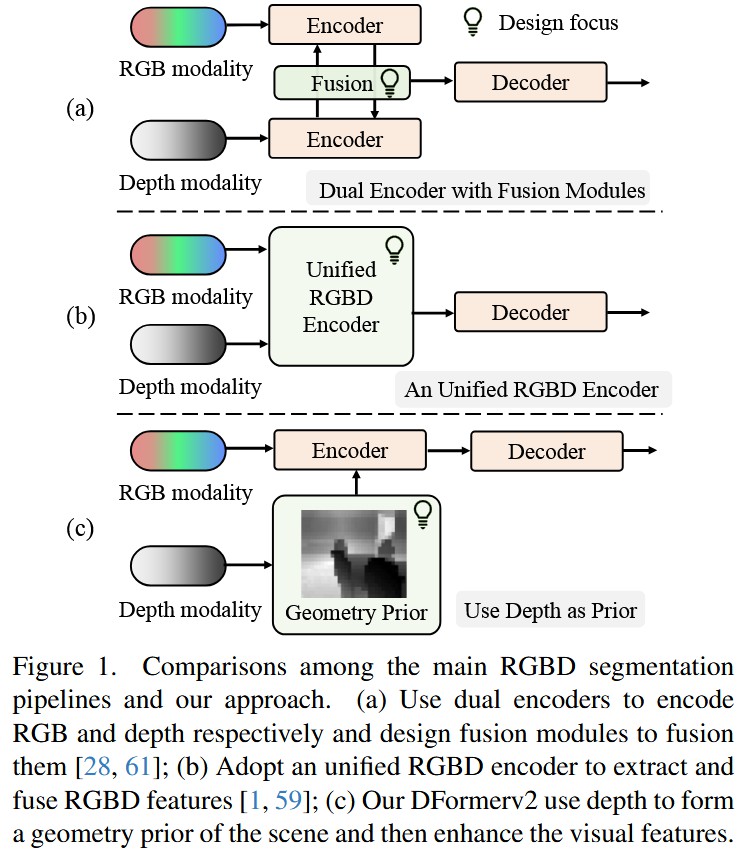
- (a) 双编码器架构:展示了当前主流方法(如 CMX),使用两个独立的编码器分别处理 RGB 和 Depth,并在中间进行复杂的融合。这导致了参数量和计算量的双倍增加。
- (b) 统一编码器架构:展示了近期方法(如 DFormer),将 RGB 和 Depth 拼接输入同一个编码器。虽然减少了部分参数,但仍需处理额外的通道,且忽略了深度数据的几何特性。
- © DFormerv2 架构(本文):展示了本文的思路。不再对深度图进行特征编码,而是直接从深度图中提取 几何先验(Geometry Prior),并将其注入到 RGB 编码器的自注意力机制中。这种设计不仅去除了深度编码分支,还显式地利用了物理几何信息。
-
结合图 2 (Fig. 2):
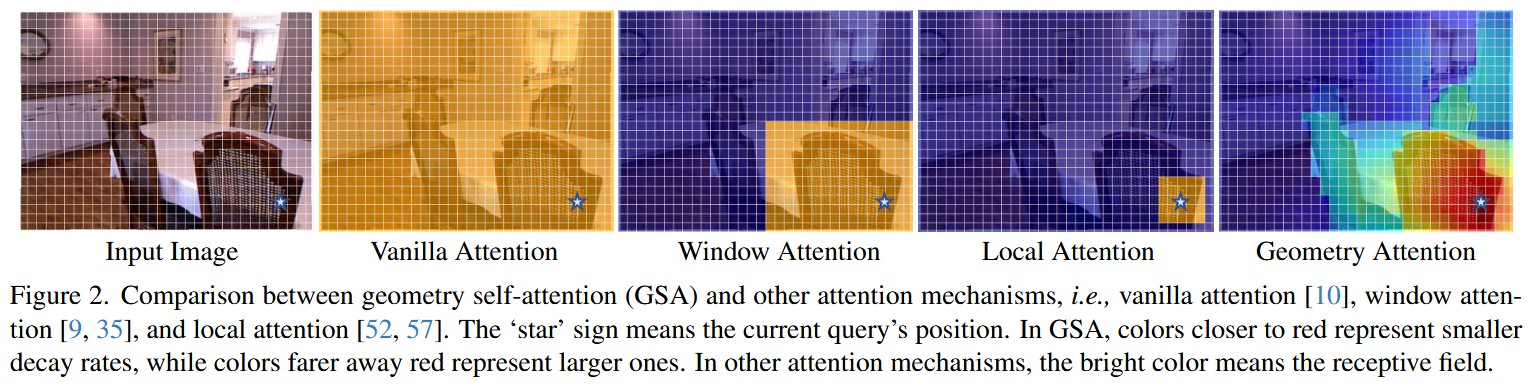
- 对比了不同注意力机制的感受野。Vanilla Attention 关注全局但缺乏重点;Local/Window Attention 仅关注局部窗口。
- Geometry Attention(本文):可视化显示,通过引入深度几何先验,注意力权重能够自适应地聚焦于几何上相邻或属于同一物体的区域(如红/黄色高亮区域)。这意味着模型能够理解“虽然像素在图像上相邻,但在 3D 空间中可能相距甚远”的情况,从而实现更合理的特征聚合。
-
3. 主要创新点
- 几何先验生成(Geometry Prior Generation):提出了一种无需神经网络编码,直接从深度图和空间坐标中计算几何关系矩阵的方法,融合了深度距离和空间曼哈顿距离,构建了全面的 3D 几何先验。
- 几何自注意力机制(Geometry Self-Attention, GSA):设计了一种将几何先验融入自注意力的机制。通过将几何距离转化为注意力权重的衰减因子(Decay Rate),显式地指导模型关注几何上相关的区域,增强了特征的物理可解释性。
- DFormerv2 网络架构:构建了一个高效的 RGBD 编码器,仅需单流 RGB 输入,利用 GSA 模块高效集成深度信息。该架构在保持高性能的同时,显著降低了计算复杂度和参数量(例如在 NYU Depth V2 上仅用 67.2G FLOPs 就达到了 57.7% mIoU)。
4. 方法细节
-
整体网络架构:
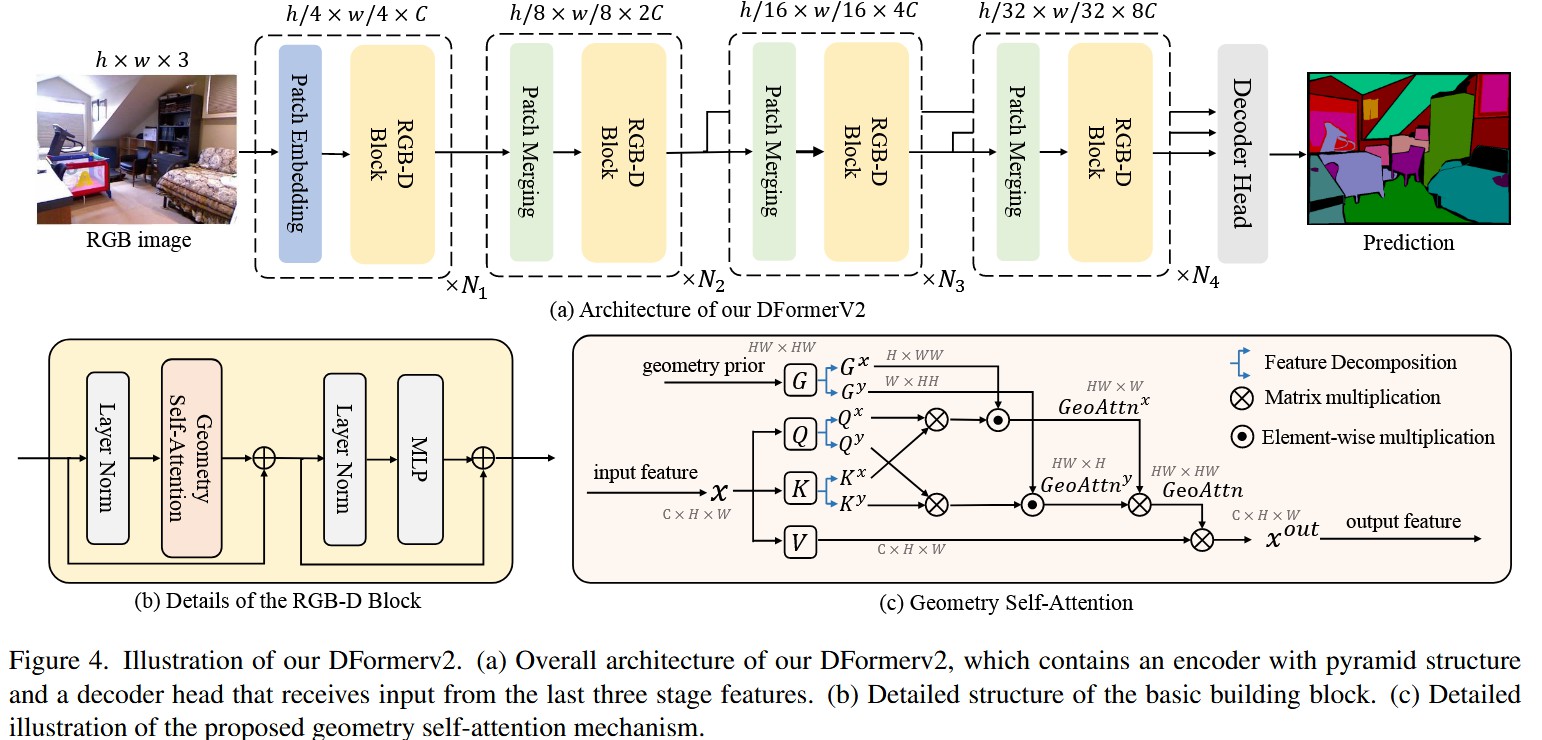
- 结构概览(Fig. 4a):DFormerv2 采用典型的分层(Hierarchical)编码器-解码器结构。
- 输入:
- RGB 图像: h × w × 3 h \times w \times 3 h×w×3,进入 Patch Embedding 层。
- 深度图:不直接作为特征输入,而是通过**下采样(平均池化)**生成对应不同阶段分辨率(1/4, 1/8, 1/16, 1/32)的深度图,用于生成几何先验。
- 编码器阶段(Stage 1-4):
- 包含 4 个阶段,每个阶段由多个 RGB-D Block 堆叠而成。
- 每个 Block 接收 RGB 特征和对应分辨率的 几何先验 G G G。
- 特征分辨率逐级降低( H / 4 H/4 H/4 到 H / 32 H/32 H/32),通道数逐级增加。
- 解码器:采用轻量级的 MLP 解码头(类似 SegFormer),融合最后三个阶段的特征,上采样并预测最终的语义分割图。
-
核心创新模块详解:
-
模块 A:几何先验生成模块(Fig. 3 & 公式 1-2):
- 输入:下采样后的深度图 z z z 和像素的空间坐标 ( i , j ) (i, j) (i,j)。
- 深度关系矩阵 D D D:计算所有 Patch 之间的深度差绝对值, D i j , i ′ j ′ = ∣ z i j − z i ′ j ′ ∣ D_{ij, i'j'} = |z_{ij} - z_{i'j'}| Dij,i′j′=∣zij−zi′j′∣。
- 空间关系矩阵 S S S:计算所有 Patch 之间的曼哈顿距离, S i j , i ′ j ′ = ∣ i − i ′ ∣ + ∣ j − j ′ ∣ S_{ij, i'j'} = |i-i'| + |j-j'| Sij,i′j′=∣i−i′∣+∣j−j′∣。
- 融合:通过两个可学习的参数矩阵(Memory Weights)对 D D D和 S S S 进行加权求和,得到最终的几何先验矩阵 G G G(形状为 H W × H W HW \times HW HW×HW)。
- 设计目的:构建一个能够反映图像 Patch 之间真实 3D 空间距离的矩阵,作为注意力的指导信号。
-
模块 B:几何自注意力模块 (GSA)(Fig. 4c & 公式 3-7):
- 分解机制:为了降低 O ( N 2 ) O(N^2) O(N2) 的复杂度,采用轴向分解(Axial Decomposition),将 G G G 分解为水平方向 G x G^x Gx 和垂直方向 G y G^y Gy。
- 注意力计算:
- 输入:RGB 特征 X X X 经过线性投影生成 Q , K , V Q, K, V Q,K,V。
- 几何注入:计算标准 Attention Map ( Q K T QK^T QKT) 后,不是直接 Softmax,而是乘以一个基于几何先验的衰减项 β G \beta^G βG( β ∈ ( 0 , 1 ) \beta \in (0, 1) β∈(0,1) 是可学习的衰减率)。
- 公式: G e o A t t n ( Q , K , V , G ) = ( S o f t m a x ( Q K T ) ⊙ β G ) V GeoAttn(Q, K, V, G) = (Softmax(QK^T) \odot \beta^G)V GeoAttn(Q,K,V,G)=(Softmax(QKT)⊙βG)V。这意味着几何距离越远( G G G 越大), β G \beta^G βG 越小,对应的注意力权重就被抑制。
- 串行处理:先进行垂直方向的 GSA,再进行水平方向的 GSA(或者反之),最后输出特征。
- 设计目的:利用几何先验显式地“告诉”模型哪些区域在 3D 空间上是接近的,从而让模型聚焦于语义相关的区域,同时通过轴向分解降低计算量。
-
-
理念与机制总结:
- 几何引导(Geometry-Guided):核心理念是“距离产生隔阂”。在 3D 空间中距离近的物体,其特征应该更相关。通过 β G \beta^G βG 这种指数衰减机制,将几何距离直接转化为注意力权重的“过滤器”。
- 隐式编码 vs. 显式先验:与 DFormer 隐式地让网络学习深度特征不同,DFormerv2 显式地构建了几何关系。这种做法更符合物理直觉,且避免了为深度图单独分配大量参数。
-
图解总结:
- Fig. 4© 清晰地展示了 GSA 的数据流:RGB 特征负责生成 Q , K , V Q, K, V Q,K,V(内容信息),而深度图生成的几何先验 G G G 负责生成注意力偏置(Bias)或掩码(Mask)。两者在注意力图计算阶段汇合,通过点乘操作( ⊙ \odot ⊙)将几何约束施加在视觉特征上。
- 这种设计巧妙地让深度信息“搭便车”,在不增加特征维度的前提下,极大地增强了特征的几何感知能力。
5. 即插即用模块的作用
论文中的核心模块具有很好的通用性,可应用于其他任务:
-
几何自注意力模块 (GSA)
- 适用场景:任何有 RGB-D 数据 或 立体视觉数据 的任务,如 3D 目标检测、RGB-D 显著性检测、深度补全等。
- 具体应用:
- 替换 ViT 的 Attention:在处理 RGB-D 数据时,可以直接用 GSA 替换标准 Vision Transformer 中的 Self-Attention 层。只需提供对应的深度图用于生成 G G G,即可让模型具备几何感知能力,提升对物体边界和空间结构的理解。
- 多模态融合:在需要融合几何信息的场景下,GSA 提供了一种比简单的 Concat 或 Cross-Attention 更高效的融合方式,因为它不需要对几何信息进行复杂的特征编码。
-
几何先验生成策略 (Geometry Prior Generation)
- 适用场景:需要利用空间关系或深度关系的图神经网络(GNN)或注意力模型。
- 具体应用:
- 位置编码增强:该模块生成的 G G G 矩阵本质上是一种相对位置编码的 3D 升级版。可以将其作为一种通用的 3D 位置编码(3D RPE),加到任何 Transformer 模型的 Attention Map 上,以增强模型对 3D 结构的感知,特别适用于室内场景理解或自动驾驶中的 BEV 感知。
到此,所有的内容就基本讲完了。如果觉得这篇文章对你有用,记得点赞、收藏并分享给你的小伙伴们哦😄。
6. 获取即插即用代码关注 【AI即插即用】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 42
 0
- 0


 已为社区贡献2条内容

所有评论(0)