Carla仿真系列:6_实时图像语义分割,SegFormer 和 YOLOPv2 实测对比
·
系列做到第6期,前面已经跑通了环境、NPC、YOLO检测、四路相机和BEV拼接。这期做语义分割——让模型理解图像里每个像素是什么:路面、车道线、车辆、行人、建筑。
1 为什么做语义分割
目标检测告诉你"哪里有车",语义分割告诉你"这个像素是路,那个像素是车"。
| 对比 | 目标检测 | 语义分割 |
|---|---|---|
| 输出 | 检测框 | 像素级分类 |
| 精度 | 知道"在哪" | 知道"是什么+在哪" |
| 用途 | 障碍物检测 | 可通行区域、车道线、场景理解 |
对于自动驾驶,语义分割是理解场景的重要基础——地面提取、可行驶区域、车道线检测都靠它。
2 整体流程
启动环境(前几期一样)
    ↓
发布相机图像(TCP桥接)
    ↓
创建NPC交通流
    ↓
运行语义分割模型(SegFormer / YOLOPv2)
第一步到第五步:准备阶段
环境启动、ROS Bridge、TCP图像传输、NPC生成,都跟之前一样:
# 终端1-3:启动环境 + Carla + ROS Bridge

# 终端4:发布相机图像
cd /opt/carla_ws
python tcp_bridge/tcp_bridge_server_multi_camera_py2.py  # 四路环视相机
python tcp_bridge/tcp_bridge_server_py2.py               # 仅前视相机

# 终端5:创建NPC
python scripts/spawn_random_npc_py2.py _vehicle_count:=20 _walker_count:=10
第六步:运行语义分割
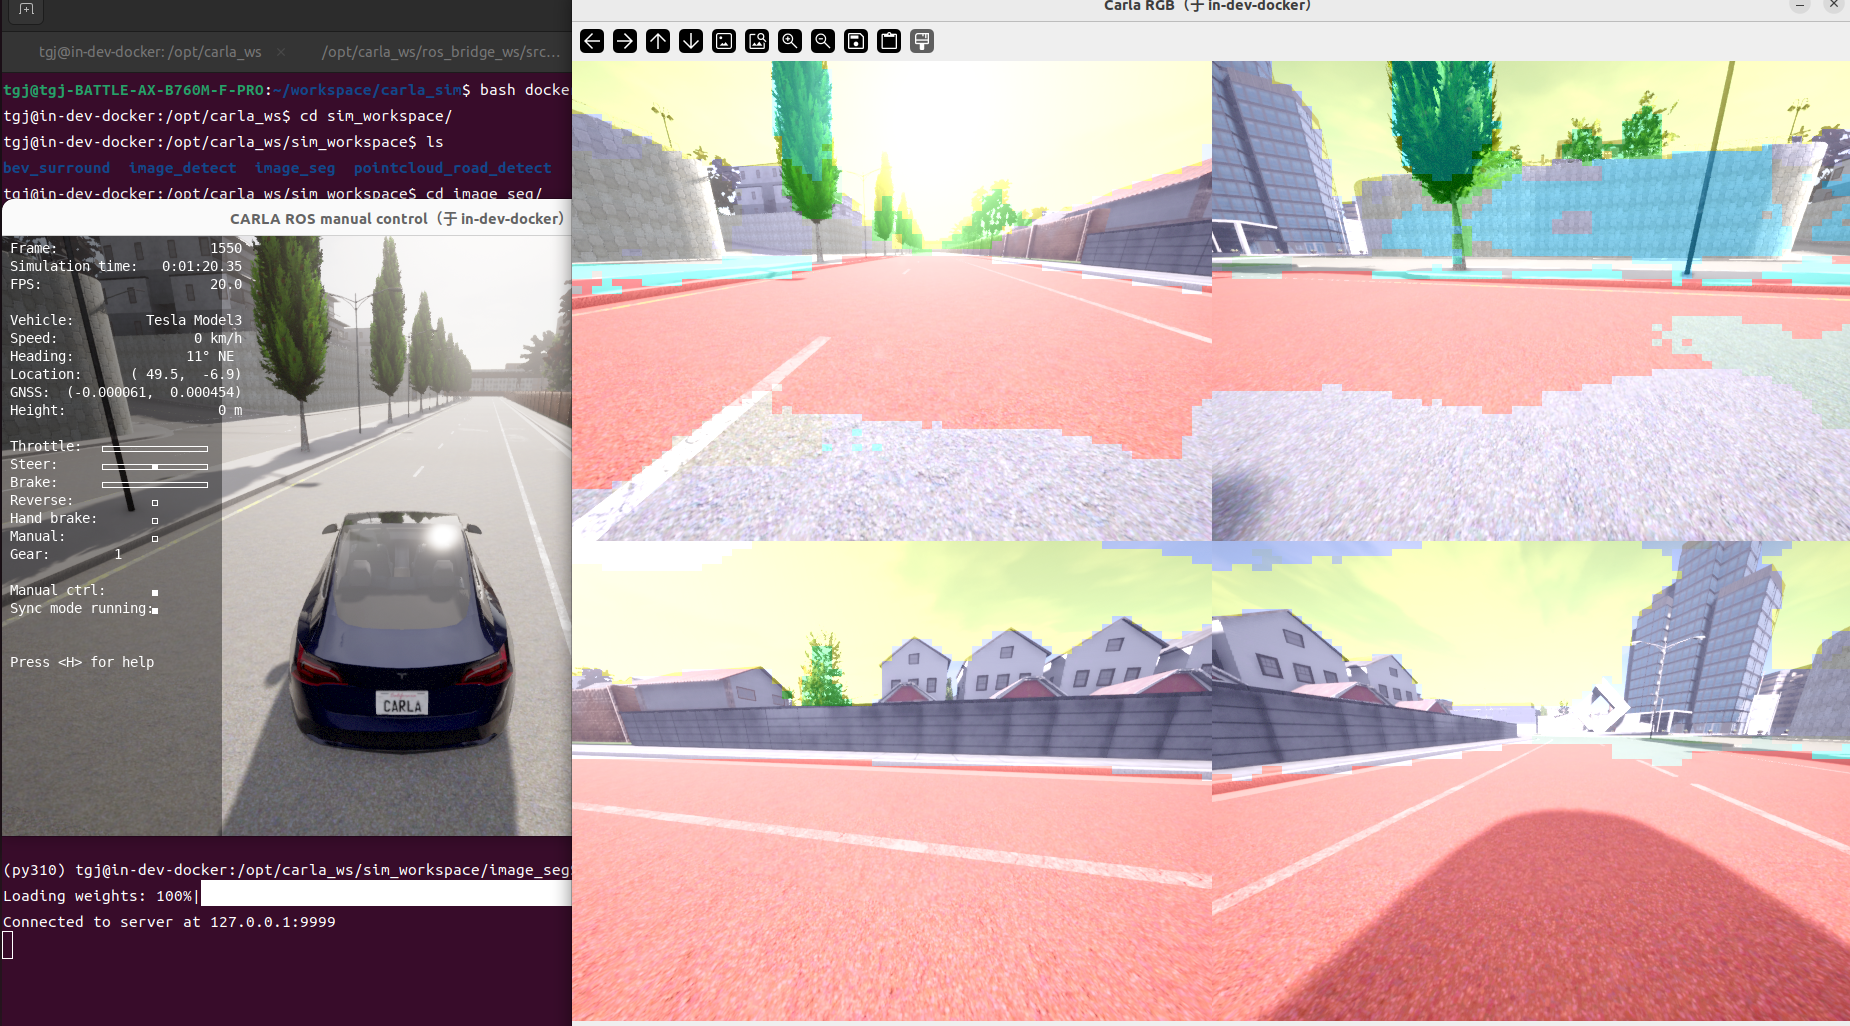
方案一:SegFormer
SegFormer 是 transformer 架构的语义分割模型,性能均衡。
cd /opt/carla_ws/sim_workspace/image_seg

# 在线实时分割(直接获取carla图像数据)
python image_seg_segformer_online.py

# 离线分割(处理已保存图像)
python image_seg_segformer.py
方案二:YOLOPv2
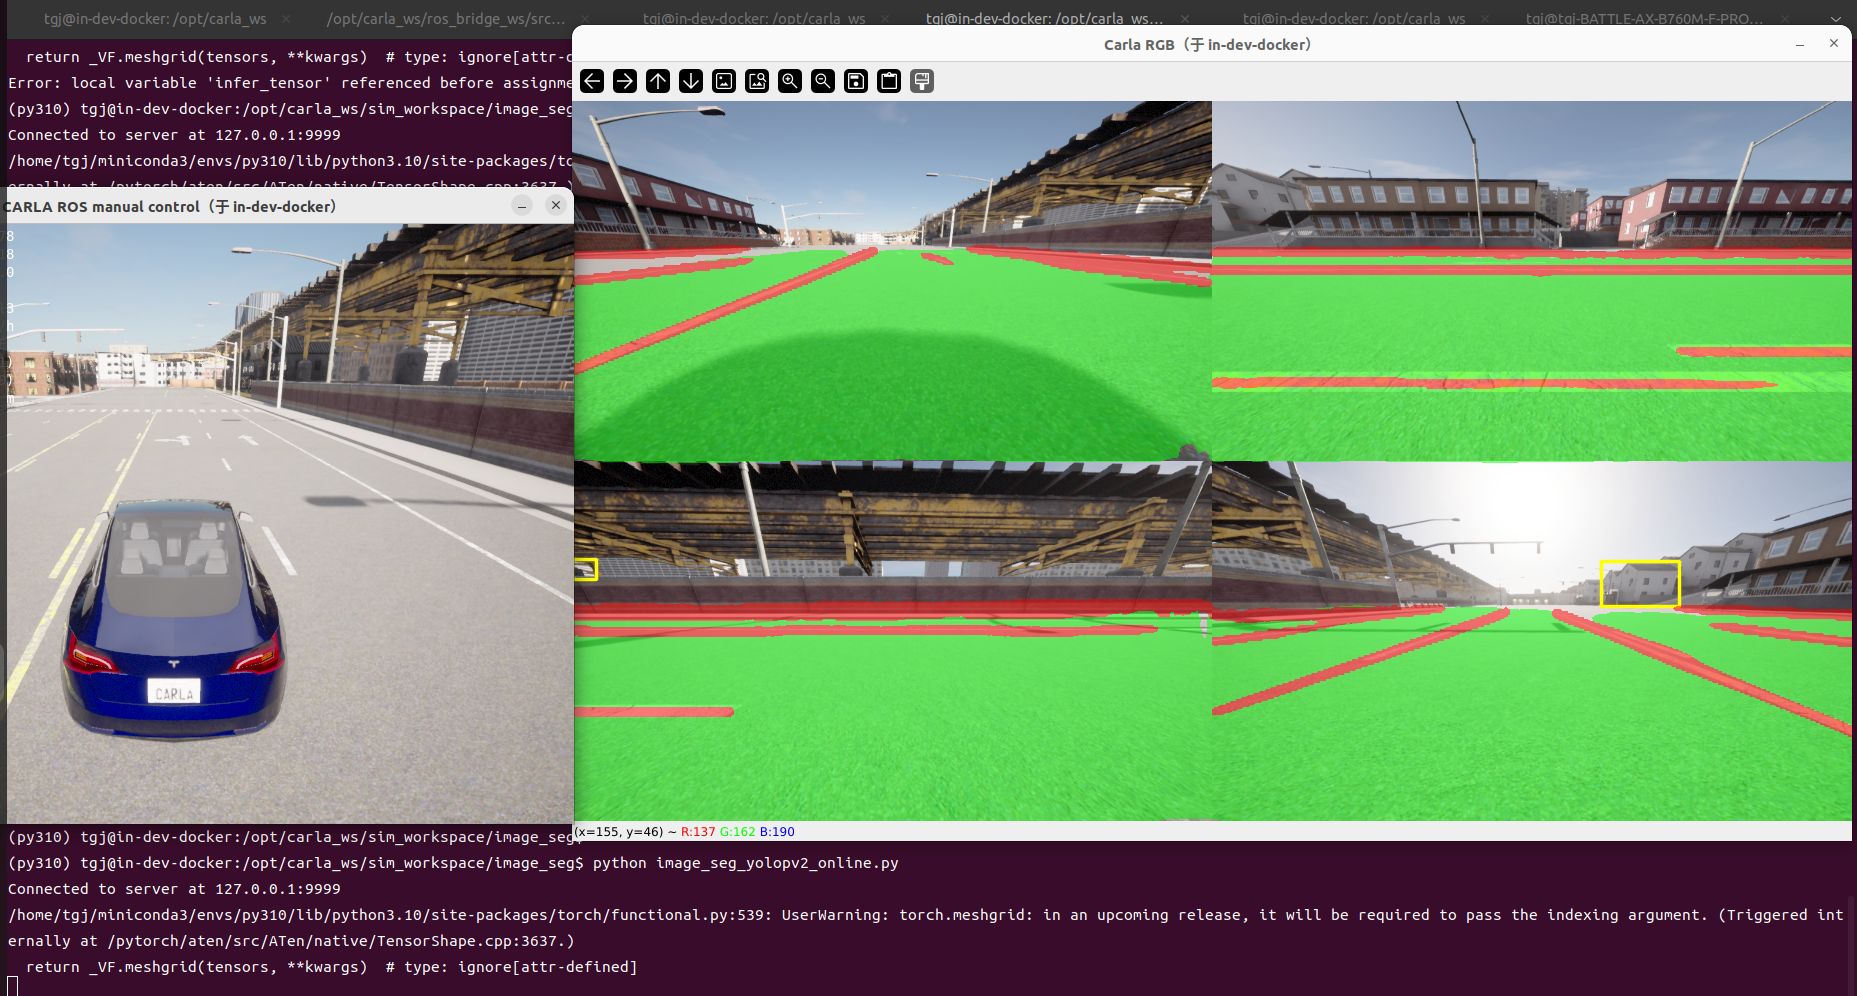
YOLOPv2 是个"三合一"模型——同时做目标检测 + 车道线分割 + 可行驶区域分割,一个模型搞定三个任务。
cd /opt/carla_ws/sim_workspace/image_seg

# 在线实时分割
python image_seg_yolopv2_online.py

# 离线分割
python image_seg_yolopv2.py
3 实测对比
两个模型都能正常工作,但效果差异明显:
| 对比 | SegFormer | YOLOPv2 |
|---|---|---|
| 语义分割效果 | 一般 | 好很多 |
| 车道线 | 无 | ✅ 专门优化 |
| 地面/可行驶区域 | 有 | ✅ 专门优化 |
| 目标检测 | 无 | ✅ 内置 |
| 单模型多任务 | 否 | ✅ 是 |
YOLOPv2 的语义分割效果明显更好,而且一个模型同时输出检测+车道线+地面,对自动驾驶场景更实用。我这是在仿真的环境中对比,在真实环境中可能会不一样,只是提供一个参考,从框架来看,YOLOPv2 的输出结果更满足自动驾驶的需要。
4 几个关键点
| 要点 | 说明 |
|---|---|
| 模型选择 | 场景理解用YOLOPv2,通用分割用SegFormer |
| 与BEV结合 | 分割结果可以投影到BEV,做可行驶区域分析 |
6_Carla实时图像的语义分割
5 下一期
下期将语义分割的结果投影到BEV空间下,得到语义BEV。
往期回顾
- Carla仿真系列:5_Carla 四路相机标定与BEV环视拼接
- Carla仿真系列:4_在 Carla 的 Tesla 上装 4 路摄像头,并创建网格为环视拼接做准备
- Carla仿真系列:3_Carla 仿真中跑通 YOLOv8 实时目标检测
- Carla仿真系列:2_Carla 仿真中批量添加 NPC,让场景动起来
- Carla仿真系列:1_Carla + ROS 仿真环境从零搭建,跑通完整数据流
如果本文对你有帮助,欢迎点赞、关注、收藏。
遇到问题可以评论区留言交流,也欢迎转发给需要的朋友。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)