翻译:SplatAD:用于自动驾驶的实时激光雷达和相机渲染的三维高斯点绘制技术
SplatAD:用于自动驾驶的实时激光雷达和相机渲染的三维高斯点绘制技术
Supplementary Material
在补充材料中,我们提供了我们方法和基线的实现细节、评估细节以及额外的结果。在附录 A 中,我们描述了激光雷达渲染的细节。在附录 B 中,我们更详细地描述了我们的训练设置,并提供了超参数。在附录 C 中,我们描述了如何使用我们的基线生成点云的过程。在附录 D 中,我们提供了卷帘快门建模的更多细节和解释。在附录 E 中,我们给出了我们方法和基线的更多定性示例。最后,在附录 F 中,我们提供了评估细节。
A. 激光雷达渲染细节
A.1. 激光雷达分块
激光雷达栅格化的分块处理方式是使每个分块包含相同数量的激光雷达点进行栅格化。在水平方向上,我们定义每个分块覆盖 Nϕlidar 个点,对应于 Nϕ·resϕdegrees ,其中 resϕis 为方位角分辨率。在垂直方向上,每个分块覆盖 Nωelevation 个通道,其中仰角通道由激光雷达规格定义。我们将仰角分块边界设置在仰角通道之间。因此,每个激光雷达分块可以栅格化 Nϕ·Nωlidar 个点。我们设置 Nϕ= 为 32, Nω= 为 8,这样 Nϕ·Nω= 为 256,类似于图像分块中的 16×16 = 256 像素。此外,一个激光雷达点云在水平方向上对应 Mϕ= ⌈360 ◦/(Nϕ·resϕ)⌉ 个分块,在垂直方向上对应 Mω = Nbeams/Nω 个分块,其中 Nbeams 是激光雷达的光束/通道数量。
如第 3.3 节所述,为了找到所有高斯分布与瓦片之间的交点,每个高斯分布都由一个轴对齐包围盒(AABB)[(ϕlow,ωlow),(ϕhigh,ωhigh)]定义,该包围盒以高斯分布的二维均值在球坐标系中的 µS 为中心。AABB 的范围对应于高斯分布投影的 3σ 大小,并进一步根据其速度进行扩展。对于每个高斯分布,我们将这些球坐标转换为瓦片坐标,例如,(2,3)表示水平方向上第二个、垂直方向上第三个的瓦片。这将得到瓦片坐标中的 AABB [(Φlow,Ωlow),(Φhigh,Ωhigh)]。通过计算下限为包含关系,上限为不包含关系,用瓦片坐标表示的 AABB 的面积对应于该高斯分布的交点数量。
在查找方位角瓦片坐标时,我们必须考虑角度的环绕。尽管高斯分布的二维均值被限定在 [0◦ 和 360◦) 之间,但其包围盒(AABB)坐标不受此限制。此外,最后一个方位角瓦片可能会超出 360°,因为 ϕmax = Mϕ·Nϕ·resϕ≥360°。在环绕角度时,这可能会导致第一列和最后一列瓦片之间出现重叠。由于最后一列瓦片的重叠区域没有对应的激光雷达点(这些点已由第一列瓦片处理),因此不应将其纳入交集的考虑范围。因此,下限的确定方式为
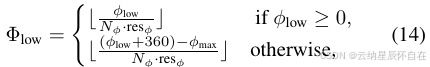
和上限为
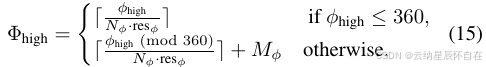
给定 Φlow 和 Φhigh,水平方向上覆盖的瓦片数量为 Φhigh - Φlow。对于图像情况,每个交点处的高斯函数都会被复制,并根据相交的瓦片和高斯函数的深度关联一个唯一的标识符。此唯一标识符用于全局排序。然而,在创建此标识符之前,交点的方位角瓦片坐标会被映射到 [0, Mϕ) 范围内。
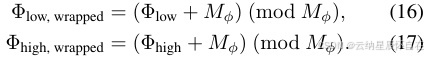
对于高程瓦片坐标,我们遍历排序后的高程边界,并将 Ωlow 设为小于 ωlow 的最后一个边界,将 Ωhigh 设为大于 ωhigh 的最后一个边界。
A.2. 激光雷达点到栅格化点
在训练和评估期间,我们根据收集到的激光雷达数据提供用于光栅化的方位角和仰角值。首先,我们通过将激光雷达点的坐标相对于捕获时传感器的姿态进行表达来消除任何自运动补偿。为此,我们假设在激光雷达扫描捕获期间运动是线性的。接下来,对于每个激光雷达点 x = [x, y, z]T],我们将其转换为球坐标。
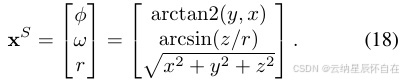
然后,每个点都按照与处理高斯分布相同的方法映射到单个瓦片上,同时假设每个激光雷达点的范围为零。
在某些情况下,此过程可能会为一个瓦片分配略多于 256 个激光雷达点。例如,如果违反了用于去除自身运动的线性运动假设,就会出现这种情况。在训练期间,我们会在每次迭代时打乱点的顺序,并丢弃超过 256 个的点。在评估期间,我们会运行多次光栅化操作,并将结果连接起来。
对于点数少于 256 个的瓦片,我们仍然会为光栅化生成 256 个线程。与达到足够累积的线程仅用于将新的高斯分布批次加载到共享内存中类似,我们也会利用未分配激光雷达点的线程来实现相同的目的。
B. 培训详情
在本节中,我们将介绍模型的细节以及训练方法。
优化:我们模型的所有参数均联合优化 30,000 步,使用 Adam [17] 优化器。不同参数的学习率见表 6,在适用时采用指数衰减调度器进行调度。依照 [14] 的做法,我们从比原始分辨率小 4 倍的图像开始优化,并在 3,000 步和 6,000 步时将图像上采样 2 倍。
初始化:高斯分布是从激光雷达点和随机点的混合中初始化的。对于静态世界,我们使用最多 200 万个激光雷达点,并为每个对象在框内随机添加 500 个点。除了激光雷达点之外,我们还从随机点初始化 60,000 个高斯分布。其中一半的点在激光雷达范围内均匀采样,另一半则由均匀采样的方向和在激光雷达范围之外按距离倒数线性采样的距离生成,最大距离为 10 千米。由激光雷达点生成的高斯分布使用将点投影到最近图像中获取的颜色进行初始化,而由随机点生成的高斯分布则使用随机颜色进行初始化。高斯分布的尺度初始化为其三个最近邻点的平均距离的 20%,不透明度初始化为 0.5。
损失超参数:我们的模型通过最小化公式(13)进行优化,其中 λr = 0.8,λdepth = 0.1,λlos = 0.1,λintens = 1.0,λraydrop = 0.1。除了 λr 与文献 [14] 中的值相同外,其余超参数均是凭经验设定的。公式(13)中的 MCMC 损失函数源自文献 [16],由不透明度正则化项和尺度正则化项组成。
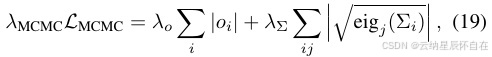
其中我们使用 λo = 0.005 和 λΣ= = 0.001。对于与激光雷达点 p 相交的高斯分布的视线损耗的实现方式为
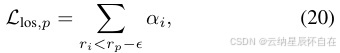
表 6.不同参数组的学习率(LR)。学习率调度采用指数衰减的方式进行。
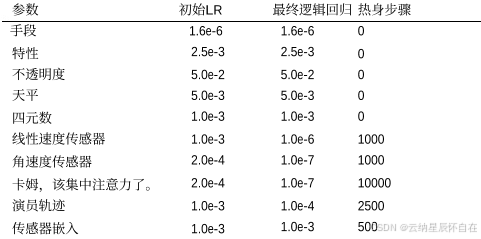
其中 ri 是高斯分布 i 的范围,rp 是激光雷达点 p 的范围,且 ϵ = 0.8 。
致密化策略:我们采用文献 [16] 中介绍的 MCMC 策略,使用相同的超参数,并将高斯分布的最大数量设置为 500 万。
特点:除了三个颜色通道外,我们的高斯分布还具有 13 维的相关特征。我们为特定传感器的嵌入赋予大小为 8 的尺寸。用于解码视相关效果的小型卷积神经网络(CNN)由两个隐藏维度为 32、卷积核大小为 3 的残差块组成,最后接一个线性层。用于解码激光雷达强度和光线丢失概率的多层感知机(MLP)也很轻量,仅包含 2 层,隐藏维度为 32。
C. 基准详情
我们所考虑的三个基于 3DGS 的基线模型 PVG [6]、Street Gaussians [43] 和 OmniRe [7] 均在开源代码库 drivestudio [8] 中实现。我们对代码库进行了修改,以实现点云渲染,具体方法如 [7] 中所述,即将激光雷达点投影到深度图像中,获取其深度值,然后将其投影到三维空间中。
为了生成点云,我们在激光雷达原点处放置了 6 个虚拟相机,每个相机的水平视场角为 60◦。这些相机经过旋转,使其共同覆盖 360◦。焦距设置为每个数据集的水平焦距的中位数。这样可以确保渲染出的深度图像与模型训练时的分辨率相似。
接下来,渲染六个深度图像。这里,深度指的是相机坐标系中高斯分布的α混合 z 坐标。对于每个激光雷达点,将其投影到深度图像中,并对附近的像素值进行双线性插值。然后将 z 深度值除以激光雷达点的方向与相应相机 z 轴方向之间的夹角的余弦值,将其转换为距离 t。最后,使用真实的激光雷达点的原点 o 和方向 d,将点放置在三维空间中,即 o + dt。
D. 卷帘门详情
我们的卷帘快门补偿是根据图像空间中的近似速度计算得出的,这些速度被称为像素速度。我们假设在时间 t 传感器 C 的运动可以用线速度 vC 和角速度 ωC 来建模,这些速度是在传感器的坐标系中表示的,如图 6 所示。对于在该传感器坐标系中表示的静态高斯分布 i,因此我们可以描述其相对于传感器的速度为
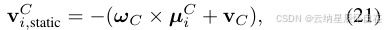
其中,µC i 是高斯分布的均值,在传感器 C 的坐标系中表示。请注意,速度的符号为负,因为我们关注的是高斯分布相对于传感器的速度。
如果高斯分布与动态角色相关联,我们还必须考虑由该角色移动所引起的速度贡献。为此,我们引入“角色坐标系”,该坐标系与角色当前的姿态对齐,但在世界坐标系中处于固定的位置和旋转。对于由线速度 vact 和角速度 ωact 建模的角色,如图 6 所示,我们可以将高斯分布 i 的速度描述为
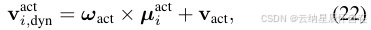
其中,µact i 是高斯分布的均值,所有向量均以演员坐标系表示。此外,我们还可以通过演员到世界坐标系和世界到相机坐标系的变换组合 T act→C ,将此速度表示为传感器 C 的坐标系中的速度。

为了同时考虑来自传感器的速度和来自动态对象的速度,我们将这两个速度源结合起来。我们将速度贡献相加,从而得到高斯分布 i 相对于传感器 C 的完整速度。
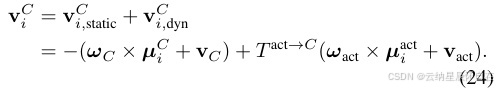
在此,动态物体的变换速度保留其符号,因为它已经是相对于传感器的。最后,通过使用文献[31]中关于像素坐标相对于相机运动的导数推导,我们通过将结果与投影变换的雅可比矩阵相乘,得到高斯分布 i 投影到传感器 C 上的像素速度。
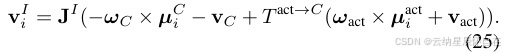
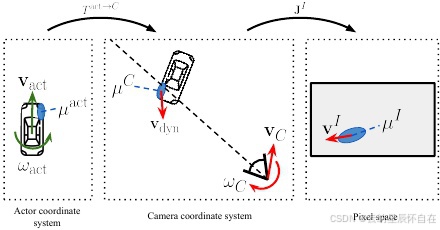
图 6. 像素速度方程中各组成部分的一个示例的可视化展示。
E. 其他定性结果
我们针对 nuScenes(图 7)、PandaSet(图 8)和 Argoverse 2(图 9)数据集,为 NVS 任务提供了 SplatAD 与我们基线方法之间的更多定性比较。由于 OmniRe 的渲染结果在大多数情况下与 Street Gaussians 非常相似,因此我们未将其纳入比较。此外,我们还展示了我们激光雷达渲染的一个定性示例(图 10),突出了我们方法能够预测出逼真的强度值的能力。
F. 评估详情
在此,我们给出评估中各数据集的具体细节。所有数据集均采用相同的评估协议。对于 NVS 任务,我们采用 50% 的数据集划分,即每隔一帧用于训练,其余帧用于保留验证。在重建任务中,我们使用所有帧和激光雷达扫描进行训练和评估。
PandaSet:在 PandaSet 上进行训练和评估时,我们使用包含六个摄像头和一个激光雷达的完整传感器套件。我们从后置摄像头中裁剪掉底部 260 像素,以去除对自身车辆的拍摄视角。我们选择与 [45] 和 [35] 中相同的 10 个序列:001、011、016、028、053、063、084、106、123、158。
Argoverse2:对于 Argoverse2,我们使用七个环视摄像头和两个激光雷达。我们裁剪掉前中心、左后和右后摄像头底部的 250 像素,以去除对自身车辆的拍摄视角。同样,我们选择与 [35] 相同的 10 个序列:
05fa5048-f355-3274-b565-c0ddc547b315, (由于此内容为一串字符,无实际意义,故直接翻译为中文)
0b86f508-5df9-4a46-bc59-5b9536dbde9f, (此部分为一串字符,无实际意义,故直接保留原样)
185d3943-dd15-397a-8b2e-69cd86628fb7 这个字符串没有实际意义,因此无法翻译成中文。如果您有其他需要翻译的内容,请提供。
25 e5c600 - 36 - fe - 3245 - 9 - cc0 40 - ef91620c22
27be7d34-ecb4-377b-8477-ccfd7cf4d0bc, 由于您提供的内容仅是一个字符串,没有实际的语句或段落,因此无法进行翻译。如果您有需要翻译的文本内容,请提供完整的信息。
280269 f9 - 6111 - 311 - d - b351 ce9f63f88c81
2f2321d2-7912-3567-a789-25e46a145bda, (此为一串字符,无实际意义,故直接照搬)
这段内容看起来是一个随机生成的字符串,而非实际需要翻译的文字。因此,无法将其翻译成中文。如果您有其他需要翻译的文本内容,请提供详细信息。
44adf4c4-6064-362f-94d3-323ed42cfda9 这个字符串看起来像是一个随机生成的标识符或唯一键,没有实际的中文翻译内容。如果您需要翻译的内容是其他类型的文本,请提供详细信息。
5589de60-1727-3e3f-9423-33437fc5da4
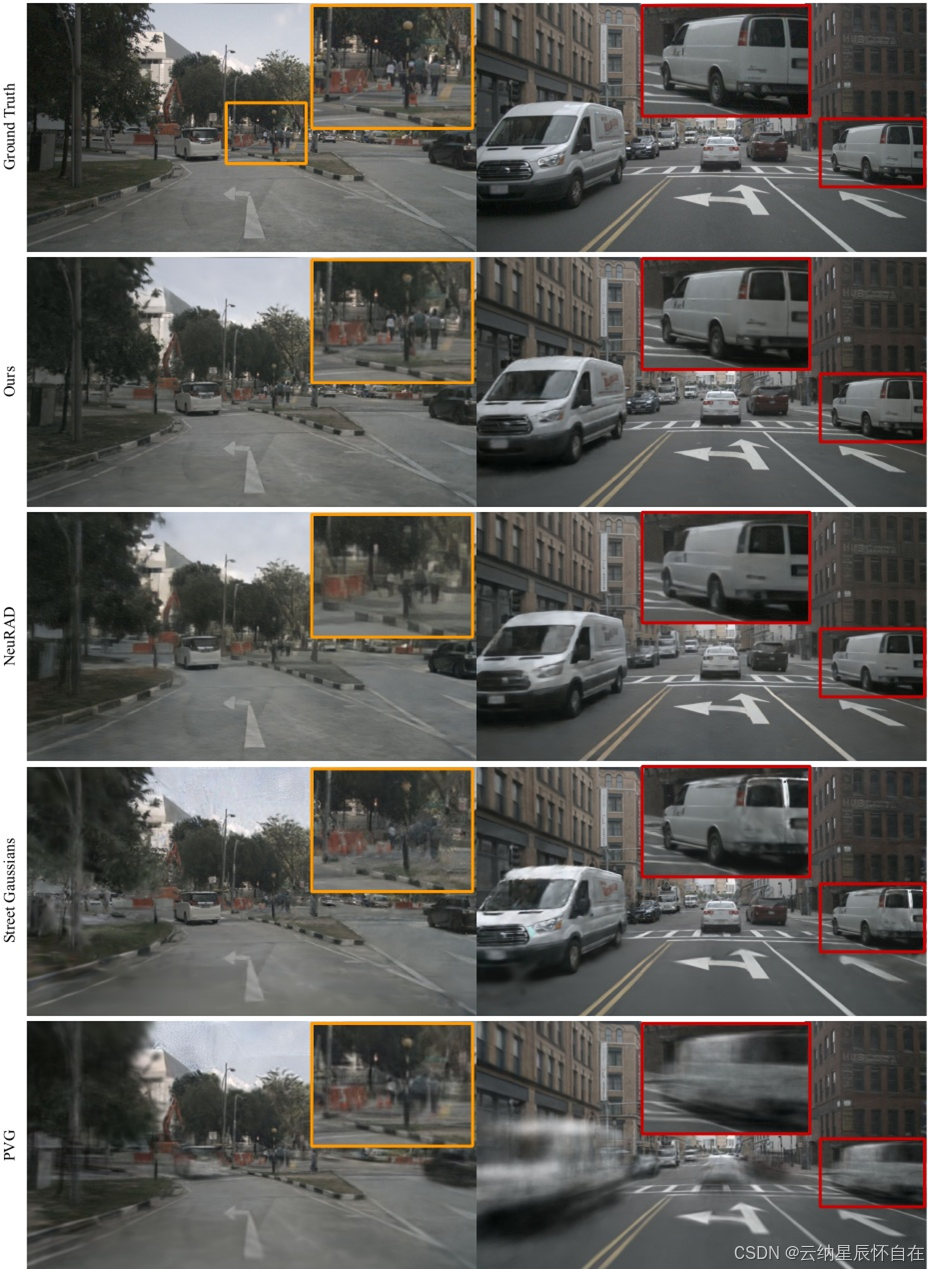
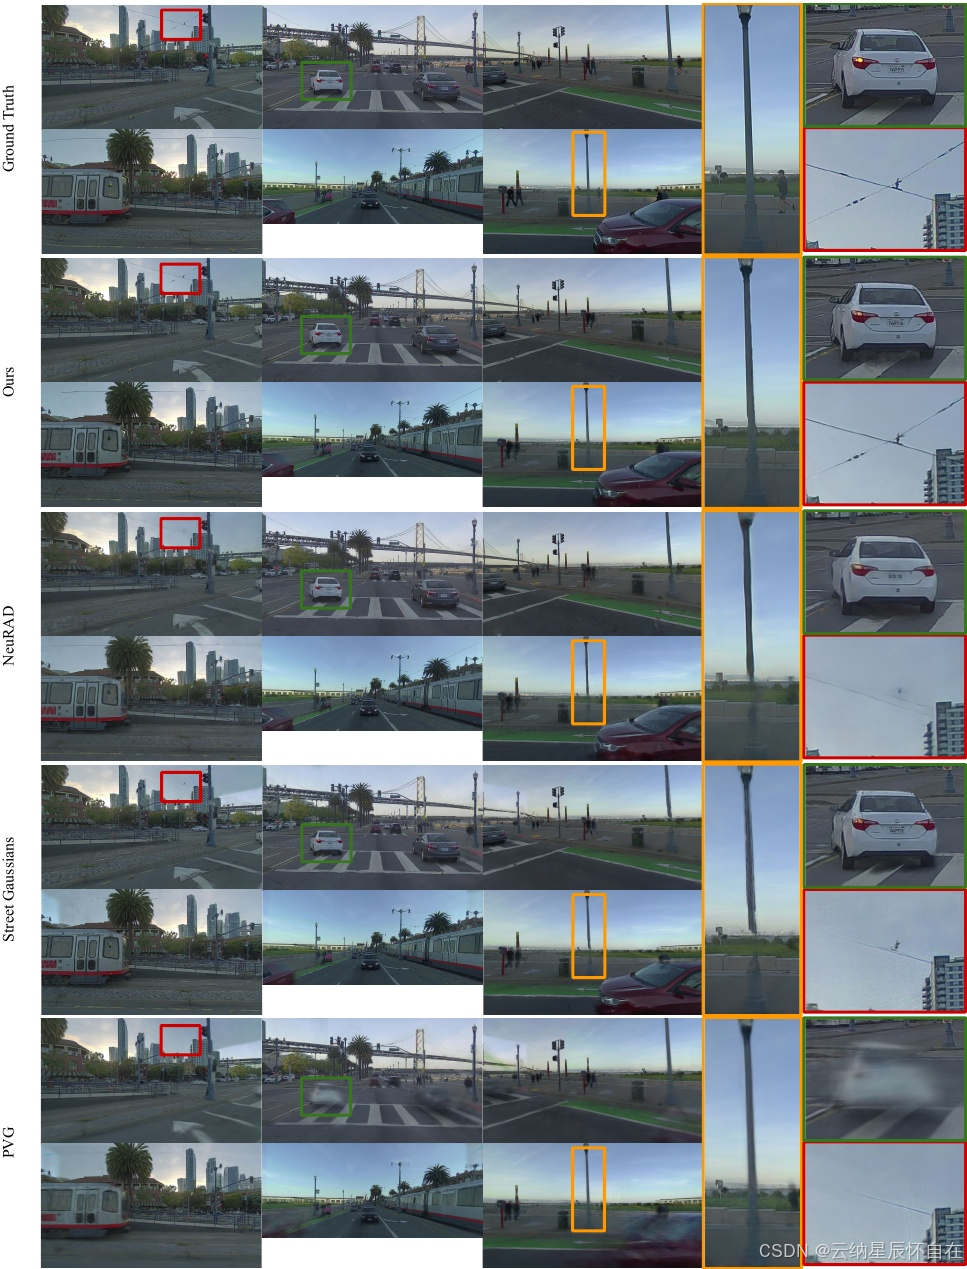
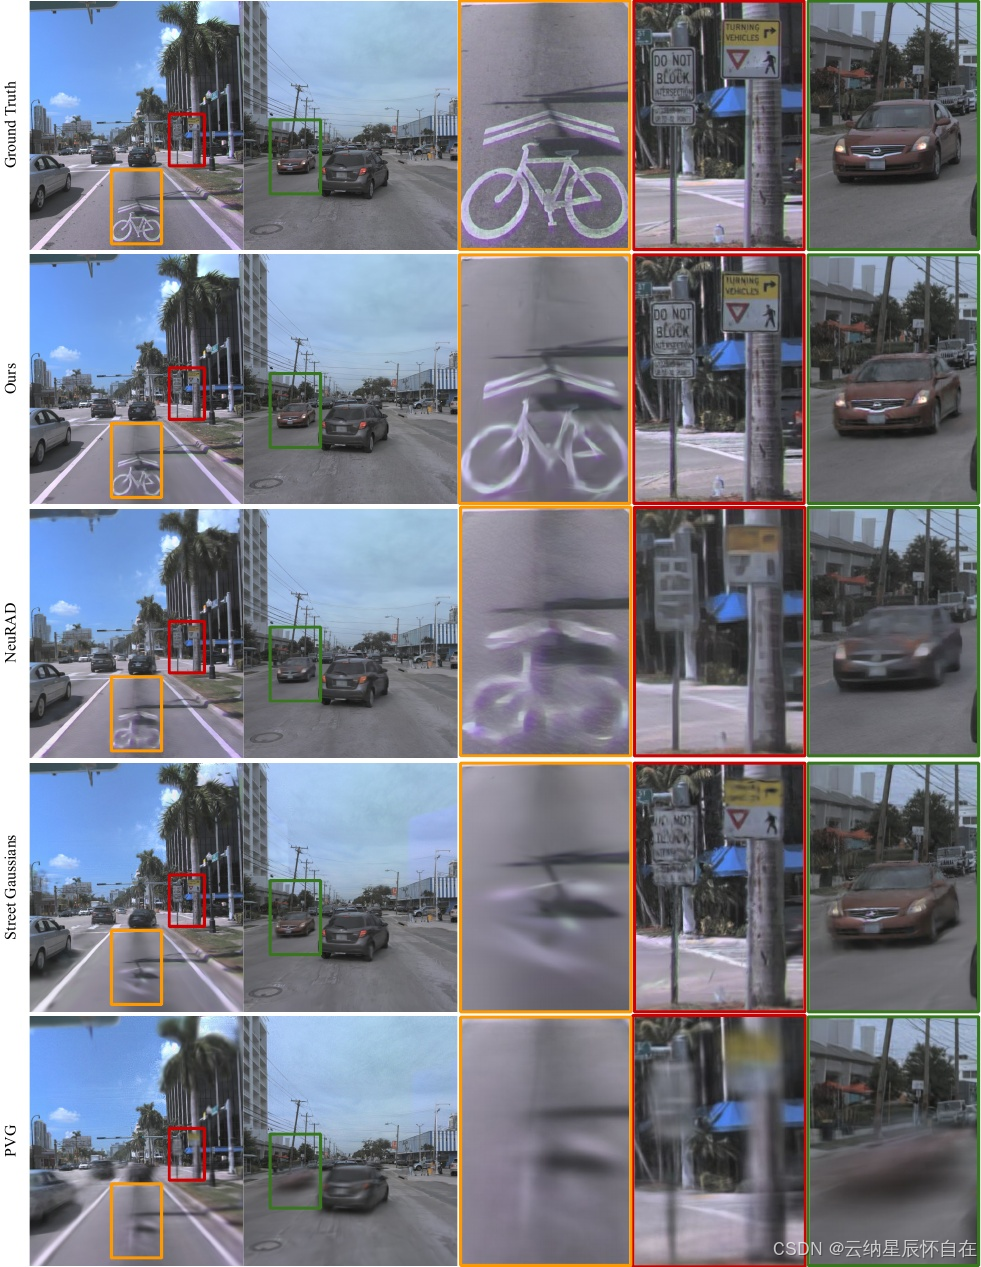
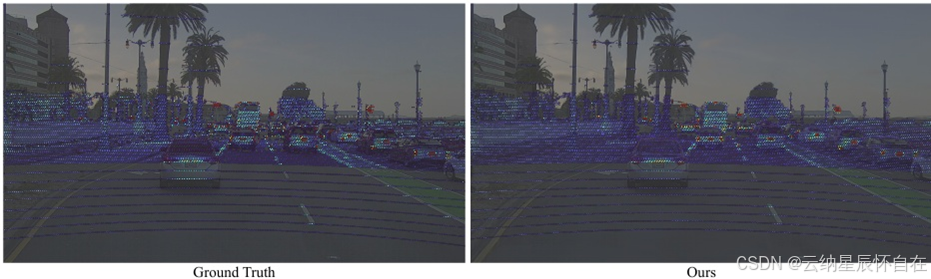
图 10. 我们激光雷达强度渲染的定性 NVS 示例。我们展示了用预测强度绘制的渲染点云,将其投影并叠加在对应的 RGB 图像上。为了突出强度颜色,已将 RGB 图像调暗并使其更透明。
nuScenes 数据集:我们使用了该数据集中全部六台可用的摄像头以及顶部的激光雷达。为避免出现自车的画面,我们裁剪掉了后置摄像头底部的 80 像素。我们选取了以下 10 个序列:0039、0054、0061、0066、0104、0108、0122、0176、0180、0193。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)