用强化学习实现LLM的模型性能跨越式进步
来gongzhonghao【图灵学术计算机论文辅导】,快速拿捏更多计算机SCI/CCF发文资讯~
在当下,强化学习与大型语言模型(LLM)的融合正成为 AI 领域的关键发展方向,相关研究在顶会顶刊上热度持续攀升。从图像描述到机器人操作,诸多前沿成果不断涌现,展现出该技术在提升模型性能、适应性和泛化能力方面的巨大潜力。
本文精心整理了 3 篇聚焦强化学习与 LLM 融合的前沿论文,旨在助力大家洞悉前沿动态、把握研究思路。
SC-Captioner: Improving Image Captioning with Self-Correction by Reinforcement Learning
方法:这篇文章提出了一种名为 SC-Captioner 的强化学习框架,旨在提升多模态大模型(MLLM)在图像描述任务中的自我修正能力。它利用场景图解析算法将预测和参考描述分解为对象、属性和关系集合,通过计算初始和自我修正描述之间的集合差异来识别添加和删除的元素,并与参考集合匹配以计算准确修正的奖励和错误添加或删除的惩罚,最终形成用于训练的奖励信号。
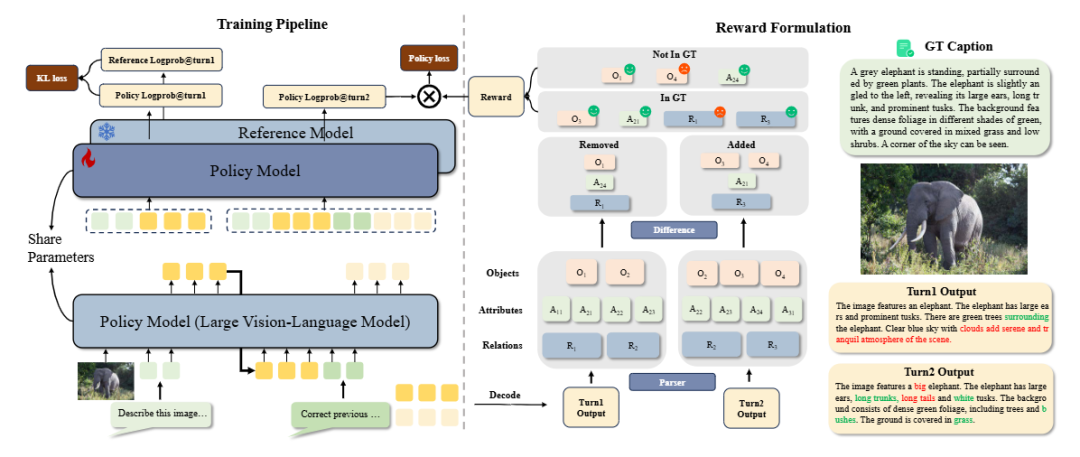
创新点:
-
首次引入自我修正训练策略到多模态大模型(MLLM)的图像描述任务中,通过强化学习框架和新颖的修正奖励函数,使模型能够有效识别并修正初始描述中的错误。
-
提出了一套改进自 CAPTURE 的评估指标,针对其不完整的精确度评估和低效的关系匹配问题进行了优化,为模型训练和性能评估提供了更可靠的依据。
-
构建了一个名为 RefinedCaps 的细粒度标注图像描述数据集,通过人工专家对初始描述进行修正,为模型训练提供了高质量的训练资源。
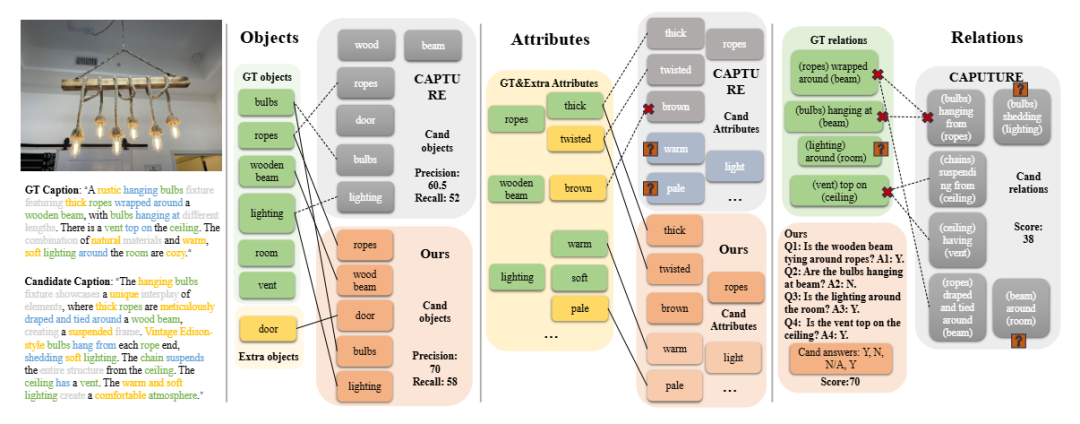
总结:这篇文章通过强化学习框架 SC-Captioner,为多模态大模型(MLLM)在图像描述任务中引入了自我修正能力,显著提升了描述的准确性和召回率。
RLPF: Reinforcement Learning from Prediction Feedback for User Summarization with LLMsLatent Reward: LLM-Empowered Credit Assignment in Episodic Reinforcement Learning
方法:这篇文章针对用户个性化摘要生成任务,提出了利用预测反馈强化学习提升大语言模型(LLM)摘要质量的新方案,旨在解决传统监督方法难以捕捉用户细微偏好的问题。
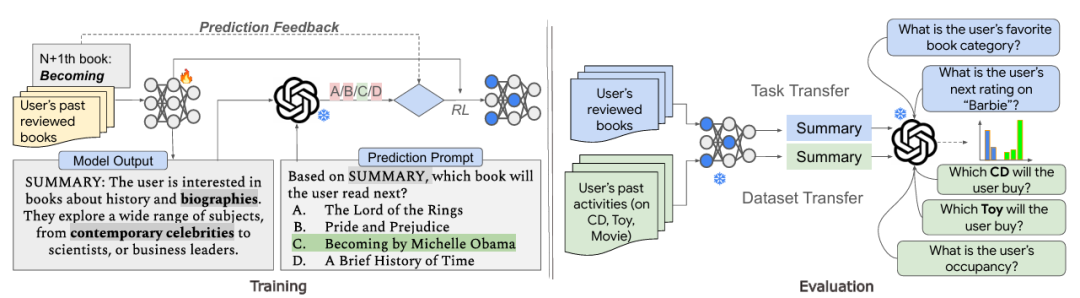
创新点:
-
首次引入预测反馈机制,将模型对未来表现的预测作为强化信号,优化摘要生成过程。
-
构建了端到端的强化学习框架,实现用户历史行为与LLM生成摘要之间的高效互动。
-
设计了自适应奖励策略,动态调整模型学习目标以适应用户多样化需求,提升下游任务表现。
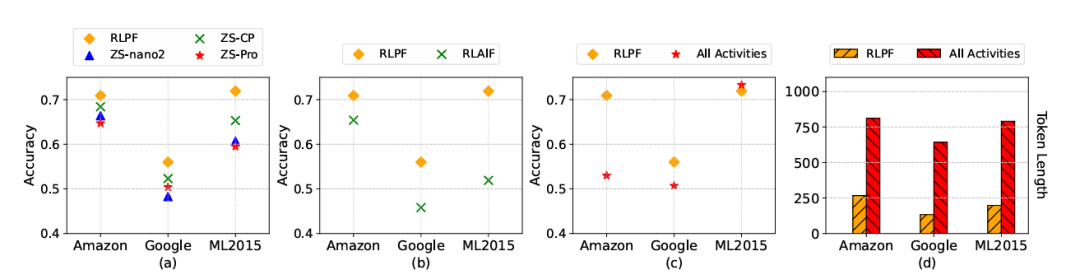
总结:文章通过将用户历史数据输入大语言模型,结合预测反馈信号,构建了一个强化学习回路,使模型能够基于用户行为优化摘要生成。具体方法采用了用户行为预测网络,将摘要结果与用户真实偏好进行对比,从而生成奖励信号,整个系统实现了个性化、多样化的摘要生成。
纠结选题?导师放养?投稿被拒?对论文有任何问题的同学,欢迎来gongzhonghao【图灵学术计算机论文辅导】,获取顶会顶刊前沿资讯~
Latent Reward: LLM-Empowered Credit Assignment in Episodic Reinforcement Learning
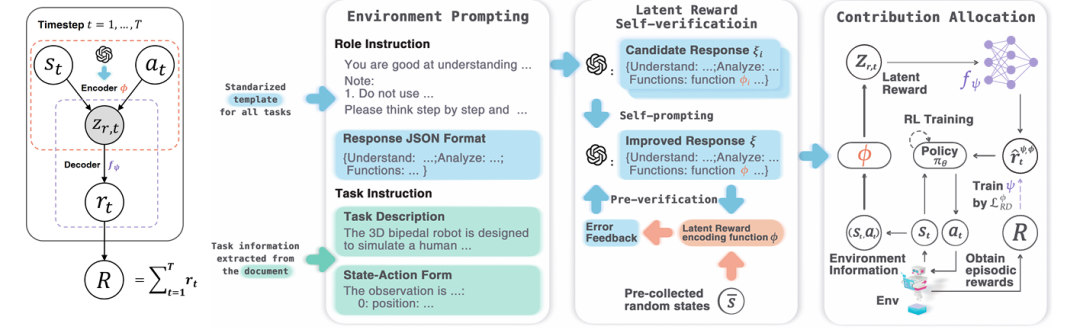
方法:这篇文章聚焦于利用大语言模型(LLM)提升强化学习中的信用分配准确性,创新性地解决了在复杂多步任务中奖励稀疏和分配不明确的问题。
创新点:
-
首创性地引入LLM辅助奖励重分配机制,实现对序列决策过程中的关键步骤精准识别。
-
设计了Latent Reward框架,通过自然语言理解能力挖掘潜在的奖励信号,显著增强多智能体协作任务的性能。
-
提出了基于任务语境的奖励映射方法,使得模型能够动态调整奖励分配,从而加速学习过程。
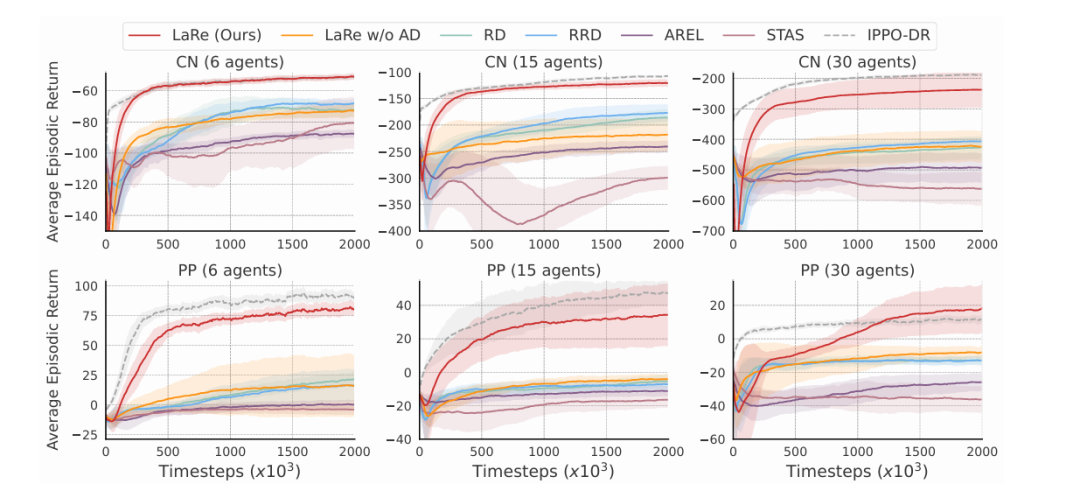
总结:文章首先利用大语言模型对整个任务序列进行语义分析,识别出影响最终奖励的关键决策点,并据此生成潜在奖励分布,通过Latent Reward框架将这些潜在奖励信号反馈给强化学习代理,有效提升了多步任务中模型的学习速度和最终表现,尤其在多智能体环境下展现出显著优势。
关注gongzhonghao【图灵学术计算机论文辅导】,快速拿捏更多计算机SCI/CCF发文资讯~

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 34
 0
- 0


 已为社区贡献3条内容

所有评论(0)