开源地理空间智能项目中的本体思想 01:QLever——单机万亿三元组的 RDF 查询引擎
“把阿拉斯加的河流按弯曲程度排个名。”
这不是脑筋急转弯,是一套知识图谱评测基准里的真实考题 [1]。它的标准答案是一条 40 行的 SPARQL 查询:圈定阿拉斯加州境内的全部河流(106,679 条),取每条河的河道长度和首尾两点的直线距离,相除得弯曲度,再排序。这条查询在装满全球地图数据的引擎上秒级跑完。
能回答这种问题的系统,是怎么组织知识的?
一、Why:为什么要搞它
知识图谱落地的第一道坎是规模。Wikidata 全量 RDF 约 166 亿条三元组(2025-04 官方口径 [8]),全球 OpenStreetMap(OSM)的 RDF 化数据是 2,229 亿条 [2]。这个量级上,传统 RDF 数据库要么查询以分钟计,要么要集群,要么许可证昂贵;跨数据集分析则要靠人工下载、导出、写脚本对齐。QLever 要回答的问题:能否在单台普通服务器上装下这些数据,查询以秒计,还完全开源。
它做到了什么,用评测基准的五类真实考题说明(口径说明见附录 A.1):
| 类别 | 真实考题 | 标准答案的结果规模 |
|---|---|---|
| 全局过滤 | 全球所有报社在哪里? | 6,706 个(其中 6,444 家有名字) |
| 空间包含 | 菲律宾境内的报社有哪些? | 41 个 |
| 全球聚合 | 全球标注最多的 100 种菜系是什么?底特律用得最多的标签是什么? | Top 100 榜单;976 行统计 |
| 几何推导 | 把阿拉斯加的河流按弯曲度排名;给俄克拉荷马的行政区按形状紧凑度排名 | 106,679 条河流参与计算 |
| 跨库关联 | OSM 对象挂了 Wikidata 链接、但 Wikidata 没有反向链接的有哪些? | 133 万处不一致 |
这五类题各自击中传统方法的一个痛点:OSM 官方查询服务(Overpass)有超时限制,全球聚合跑不下来;几何推导要求每个要素的面积、长度预先算好,原始数据里没有;跨库一致性检查要同时持有两个独立数据集。一条查询秒级完成,就是 QLever 存在的理由。
二、What:它是什么
QLever(发音同 Clever)是德国弗莱堡大学 Hannah Bast 教授团队的 RDF 图数据库 [3]。RDF(资源描述框架,W3C 标准)规定数据怎么存——全部存成"主语—谓语—宾语"三元组;SPARQL 规定数据怎么查;QLever 是执行这两者的引擎,C++ 编写,Apache-2.0 开源,GitHub 仓库创建于 2014 年,官方声明单机可扩展到超过一万亿条三元组 [3]。
三元组是真实可查的数据,不是抽象概念。从在线服务取回的一条真实记录长这样(三亚市中心节点,为排版缩短了编号前缀):
> <node/847859864> <rdf#sfIntersects>      <relation/2128284> .   # 与三亚市相交
> <node/847859864> <rdf#sfIntersects>      <relation/2128285> .   # 与海南省相交
> <node/847859864> <key#wikidata>          <.../entity/Q319804> . # 链接到 Wikidata
> <node/847859864> <wiki/Key:wikidata>     "Q319804" .            # 原始标签保留
> ```
>
> 每行一个三元组:主语是对象,谓语是关系或属性名,宾语是另一个对象或一个字面量。
团队同时把引擎和 17 个大规模公开数据集打包成在线服务(qlever.dev),免部署即可查询:通用知识(Wikidata、DBpedia)、地理(全球现行地图 OSM Planet、历史地图 OHM Planet)、生命科学(UniProt 蛋白质、PubChem 化合物)、文献与媒体等。这些数据集以 Wikidata 为枢纽互相挂接,一条查询可以跨库(联邦查询,解释见附录 A.2)[4]。
QLever 从 2014 年起是纯粹的存储与查询引擎,与大模型无关;两者的关联始于 2025 年的 GRASP 系统(见下一章)。
三、How:怎么构建和使用
数据怎么进来(构建管线)。以地理数据为例:转换工具 osm2rdf 每周把全球 OSM 重新转换一次——保留全部标签和全部几何坐标,一个要素不丢;同时预计算六种空间关系、Wikidata 和维基百科的实体链接、每个要素的面积与长度,一并写成三元组 [2]。全球 2,229 亿条三元组压缩包 783 GB,按大洲和国家分文件下载。QLever 拿到三元组后建索引,之后全部查询沿索引走路。这条管线本地可复现:自己下载区域 PBF,用 osm2rdf 转换,自建 QLever 实例。
查询怎么快(性能方法)。一句话:预存换效率。能预计算的都在建库时算好(空间拓扑、实体链接、长度面积),查询时零几何计算、零跨库搬运;不能预计算的(比如"距离某点 5 公里以内"这类任意半径条件)就是能力边界,慢甚至不可用(实测见附录 A.3)。理解 QLever,就是理解这笔交换。
大模型怎么接入。2025 年的 GRASP 系统(ISWC’25 论文 [5])让大语言模型把自然语言问题翻译成 SPARQL、在 QLever 上执行、读结果修正——模型管翻译,引擎管计算,答案可复核。开头的 32 道考题就是它的评测基准,已完整下载到本地;最强的商用大模型在这 32 题上平均得分 16.3(满分 100)。
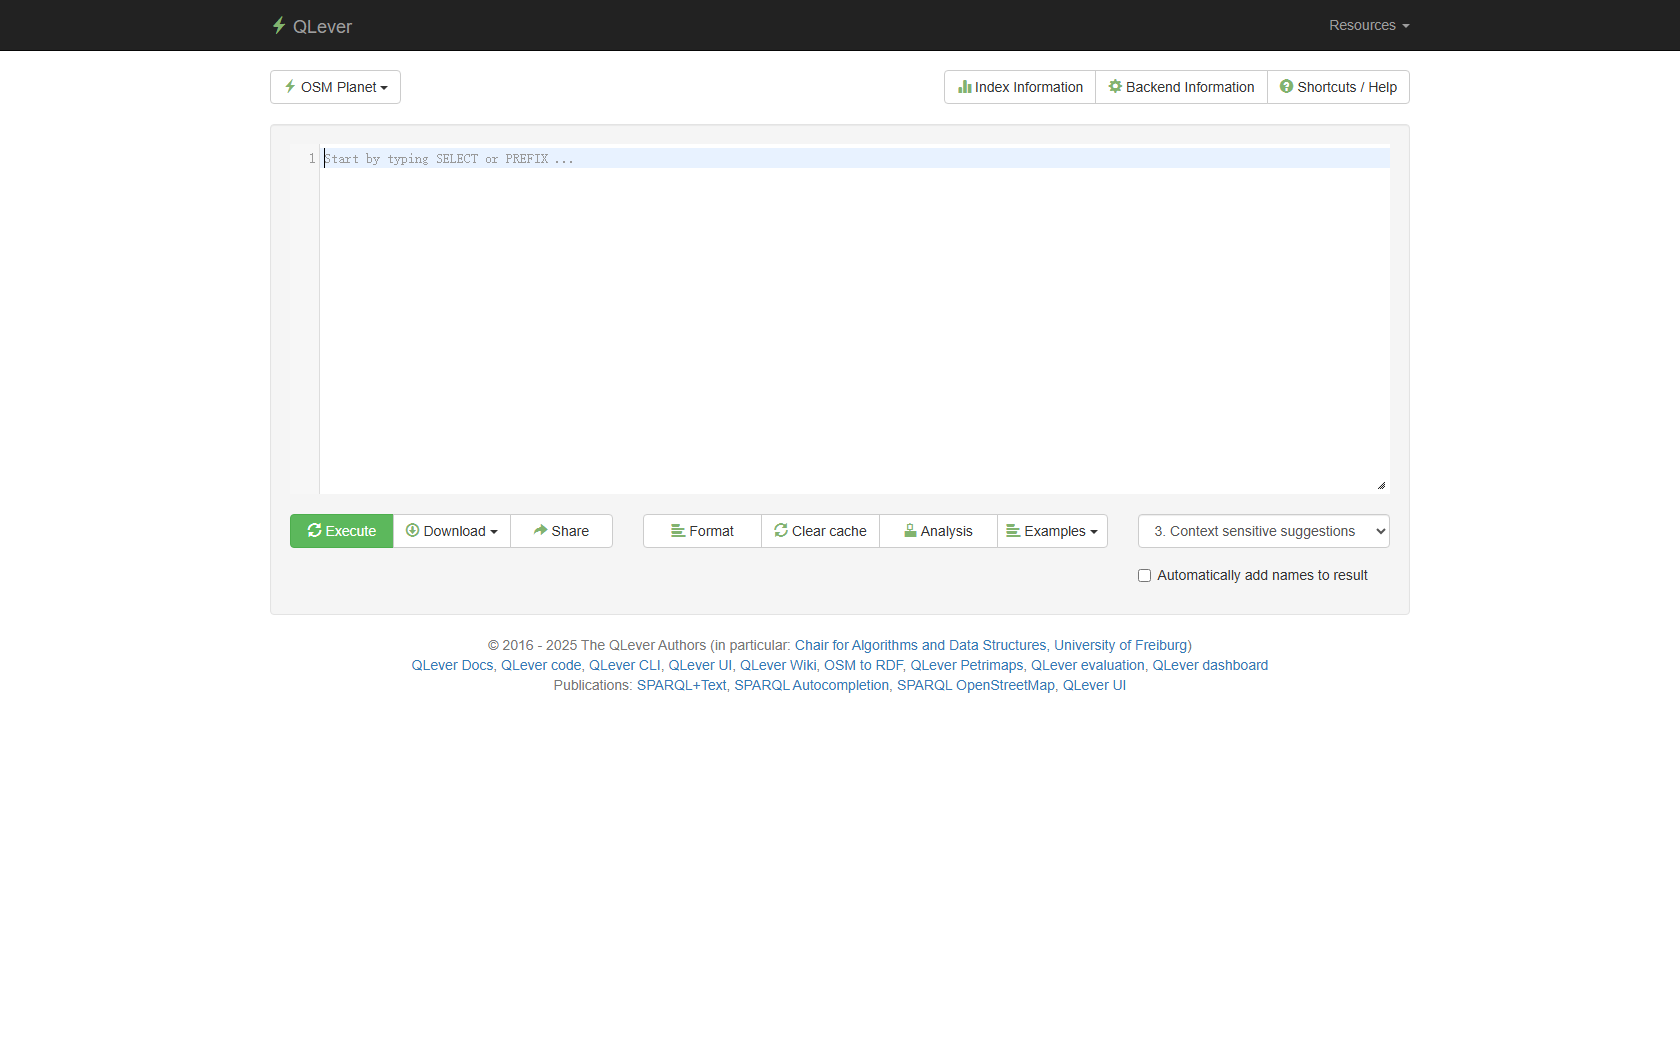
服务怎么用。三条路:网页界面(qlever.dev,选数据集、写查询、看结果,适合即席问答);HTTP API(POST 一条查询拿 JSON,适合程序调用);自部署(Docker 或源码,装载自己的三元组,适合私有数据)。
四、与本体的关系:做了对象、属性、关系,没做动作、规则、权限
最后评估 QLever 与本体思想的关系。评估框架来自动态本体:把系统能力分两层——语义层(对象、属性、关系,描述世界有什么、谁连着谁)和动力层(动作、函数、规则、权限、写回,规定如何改变世界)[6]。
语义层:对象、属性、关系都做到了工程极限。
- 对象:每个实体(OSM 的点、线、面,Wikidata 的条目)都有全局唯一的 IRI(形如网址的编号)。跨库考题之所以可能,全靠这条:OSM 对象在建库时已挂上指向 Wikidata 实体的 IRI,两个独立数据集才有了一致性检查的公共锚点。
- 属性:OSM 的自由标签(键值对)原样转成谓词词表,对象的名称、人口、长度、面积都是可查询的属性。
- 关系:六种空间关系(相交、包含、覆盖、相接、重叠、交叉,来自 GeoSPARQL 标准 [7])在建库时预先算好、物化成三元组——"谁包含谁"不是查询时算出来的,是数据里已经存好的边。阿拉斯加那道题能秒级跑完,是因为河道长度、行政边界包含关系都已预付成数据。本体推理是从显式事实推出隐含事实;QLever 用预计算替代了实时推理,可算推理思想的一种工程变体。
语义层内部也只做了一半:不执行 OWL(网络本体语言)推理——不会自动推导隐含事实,不检查数据一致性;没有公理和约束,OSM 标签合不合法,引擎不管。需要推理时,工程惯例是先用专门的推理机把隐含三元组推导出来再导入:推理机管推导,QLever 管毫秒级查询推导结果。
动力层:五个要素全部缺席。
- 函数:只有一批内置函数(字符串、数学、少量空间函数)。实测:模型在考题里调用
geof:length(长度函数),跑了 949 秒后引擎报错"不支持此函数"(附录 A.4)。没有用户自定义函数的注册机制。 - 动作:没有"受控操作"的概念。SPARQL 标准里有 UPDATE 写语法,但演示服务只读;即便自部署可写,也没有动作类型、审批、回滚这一层语义。
- 规则:没有触发器和事件机制,数据变了不会有任何东西自动发生。
- 权限:没有动态安全控制——演示服务全公开,自部署也没有行级、列级的访问控制。
- 写回:不存在的概念,它不是业务系统的前端。
这个格局不是疏漏,是定位:QLever 要做"装得下、查得快"的基础设施,不是业务操作平台。但它划出了开源地理项目的普遍边界——描述世界的部分高度成熟,改变世界的部分无人接手。设计地理空间网格本体时,这一半空白是要正面回答的问题。
回到开头那道题。"把阿拉斯加的河流按弯曲度排名"能成立,是因为"河流—河道长度—首尾节点—州界—包含关系"早已被组织成一张约定好的关系网:对象是命名的,关系是预存的,属性是齐全的。QLever 证明了对象、属性、关系这三件事的工程可以做到什么程度;动作、规则、权限、写回,是"数据变成行动"还差的部分。
附录
A.1 五类考题的来源与口径
题目和标准查询来自 GRASP 评测材料站的 OSM Planet 基准(osm-planet/examples/test.jsonl,共 32 题),结果规模来自官方运行记录的 target 字段——即专家标注的标准查询在图谱上的执行结果,执行时点为 2025 年论文评测期间。图谱每周更新,今天重跑数字会有出入:实测已观察到数据漂移(如"全球有名字的报社"从 6,444 增至 6,842)。全部材料已下载到本地 code/grasp-benchmarks/ [1]。
A.2 联邦查询
联邦查询是 SPARQL 1.1 的标准机制:一条查询里用 SERVICE 子句把部分条件发给另一个数据集执行,结果在本地汇合。前提是两边数据存在共同的实体编号(本文中即 OSM 对象预存的 Wikidata IRI 链接)。实测示例:从 OSM 的三亚市中心节点跳到 Wikidata 取人口(1,031,396)与面积(1,919.6 km²),1.19 秒返回(2026-08-05)[4]。
A.3 "预存换效率"的边界实测
六种物化空间谓词(相交、包含、覆盖、相接、重叠、交叉)之外的条件没有现成数据可走。实测:在托管实例上执行任意多边形的空间函数查询返回 HTTP 500;调用"距离某点 30 米内"这类谓词仅限预置的固定距离档位。能力边界由预计算内容划定,这是选择该架构的代价 [2][4]。
参考文献
[1] GRASP 评测材料,OSM Planet 基准与模型运行记录:https://ad-publications.cs.uni-freiburg.de/grasp/benchmark/ (2026-08-07 下载)
[2] osm2rdf 官网与数据下载页(转换规则、六种空间谓词、数据规模):https://osm2rdf.cs.uni-freiburg.de/ (2026-08 核查)
[3] QLever GitHub 仓库(README 性能声明、许可证、星数):https://github.com/ad-freiburg/qlever (2026-08-05 核查)
[4] QLever 在线服务与各数据集端点:https://qlever.dev/ (2026-08-05 起多次实测)
[5] Walter, S. & Bast, H. GRASP: Generic Reasoning And SPARQL Generation across Knowledge Graphs. ISWC 2025,预印本 arXiv:2507.08107;评测材料站见 [1]
[6] 动态本体框架(语义层/动力层划分):《动态本体:为什么、是什么、怎么做》,内部书稿,2026-06
[7] OGC GeoSPARQL 标准(空间谓词体系):http://www.opengis.net/ont/geosparql
[8] Wikimedia 基金会:Wikidata Query Service graph database reload at home, 2025 edition(“about 16.6 billion triples”):https://diff.wikimedia.org/2025/04/08/wikidata-query-service-graph-database-reload-at-home-2025-edition/

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)