云网络丢包故障定位_netdev_max_backlog,2024年最新面试题分享
先自我介绍一下,小编浙江大学毕业,去过华为、字节跳动等大厂,目前阿里P7
深知大多数程序员,想要提升技能,往往是自己摸索成长,但自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年最新软件测试全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友。
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,涵盖了95%以上软件测试知识点,真正体系化!
由于文件比较多,这里只是将部分目录截图出来,全套包含大厂面经、学习笔记、源码讲义、实战项目、大纲路线、讲解视频,并且后续会持续更新
如果你需要这些资料,可以添加V获取:vip1024b (备注软件测试)
正文

网线接触不良:
如果网卡统计里面存在 crc error 计数增长,很可能是网线接触不良,可以通知网管排查一下:
#ethtool -S eth0

解决方案:一般试着重新插拔一下网线,或者换一根网线,排查插口是否符合端口规格等;
报文长度丢包
网卡有接收正确报文长度范围,一般正常以太网报文长度范围:64-1518,发送端正常情况会填充或者分片来适配,偶尔会发生一些异常情况导致发送报文不正常丢包;
查看:
#ethtool -S eth1|grep length_errors

解决方案:
1、调整接口MTU配置,是否开启支持以太网巨帧;
2、发送端开启PATH MTU进行合理分片;
简单总结一下网卡丢包:

网卡驱动丢包
查看:ifconfig eth1/eth0 等接口

1、RX errors:表示总的收包的错误数量,还包括 too-long-frames 错误,Ring Buffer 溢出错误,crc 校验错误,帧同步错误,fifo overruns 以及 missed pkg 等等。
2、RX dropped:表示数据包已经进入了 Ring Buffer,但是由于内存不够等系统原因,导致在拷贝到内存的过程中被丢弃。
3、RX overruns:表示了 fifo 的 overruns,这是由于 Ring Buffer(aka Driver Queue) 传输的 IO 大于 kernel 能够处理的 IO 导致的,而 Ring Buffer 则是指在发起 IRQ 请求之前的那块 buffer。很明显,overruns 的增大意味着数据包没到 Ring Buffer 就被网卡物理层给丢弃了,而 CPU 无法即使的处理中断是造成 Ring Buffer 满的原因之一,上面那台有问题的机器就是因为 interruprs 分布的不均匀(都压在 core0),没有做 affinity 而造成的丢包。
4、RX frame:表示 misaligned 的 frames。对于 TX 的来说,出现上述 counter 增大的原因主要包括 aborted transmission,errors due to carrirer,fifo error,heartbeat erros 以及 windown error,而 collisions 则表示由于 CSMA/CD 造成的传输中断。
驱动溢出丢包
netdev_max_backlog 是内核从 NIC 收到包后,交由协议栈(如IP、TCP)处理之前的缓冲队列。每个 CPU 核都有一个 backlog 队列,与 Ring Buffer 同理,当接收包的速率大于内核协议栈处理的速率时,CPU 的 backlog 队列不断增长,当达到设定的 netdev_max_backlog 值时,数据包将被丢弃。
查看:
通过查看 /proc/net/softnet_stat 可以确定是否发生了 netdev backlog 队列溢出:

其中:每一行代表每个 CPU 核的状态统计,从 CPU0 依次往下;每一列代表一个 CPU 核的各项统计:第一列代表中断处理程序收到的包总数;第二列即代表由于 netdev_max_backlog 队列溢出而被丢弃的包总数。从上面的输出可以看出,这台服务器统计中,并没有因为 netdev_max_backlog 导致的丢包。
解决方案:
netdev_max_backlog 的默认值是 1000,在高速链路上,可能会出现上述第二统计不为 0 的情况,可以通过修改内核参数 net.core.netdev_max_backlog 来解决:
$ sysctl -w net.core.netdev_max_backlog=2000
单核负载高导致丢包
单核 CPU 软中断占有高, 导致应用没有机会收发或者收包比较慢,即使调整 netdev_max_backlog 队列大小仍然会一段时间后丢包,处理速度跟不上网卡接收的速度;
查看:mpstat -P ALL 1

单核软中断占有 100%,导致应用没有机会收发或者收包比较慢而丢包;
解决方案:
1.调整网卡 RSS 队列配置:
查看:ethtool -x ethx;
调整:ethtool -X ethx xxxx;
2.看一下网卡中断配置是否均衡 cat /proc/interrupts
调整:
1) irqbalance 调整;
查看当前运行情况
service irqbalance status
终止服务
service irqbalance stop
2) 中断绑CPU核 echo mask > /proc/irq/xxx/smp_affinity
3.根据 CPU 和网卡队列个数调整网卡多队列和 RPS 配置
-CPU 大于网卡队列个数:
查看网卡队列 ethtool -x ethx;
协议栈开启 RPS 并设置 RPS;
echo mask(CPU配置)>/sys/class/net/mask(CPU配置)> /sys/class/net/mask(CPU配置)>/sys/class/net/eth/queues/rx-i/rpscpusecho4096(网卡buff)>/sys/class/net/i/rps_cpusecho 4096(网卡buff)> /sys/class/net/i/rpscpusecho4096(网卡buff)>/sys/class/net/eth/queues/rx-$i/rps_flow_cnt2)CPU小于网卡队列个数,绑中断就可以,可以试着关闭RPS看一下效果:echo 0 > /sys/class/net//queues/rx-/rps_cpu
4.numa CPU 调整,对齐网卡位置,可以提高内核处理速度,从而给更多 CPU 给应用收包,减缓丢包概率;
查看网卡 numa 位置:
ethtool -i eth1|grep bus-info
lspci -s bus-info -vv|grep node
上面中断和 RPS 设置里面 mask 需要重新按 numa CPU 分配重新设置;
5.可以试着开启中断聚合(看网卡是否支持)
查看 :
ethtool -c ethx
Coalesce parameters for eth1:
Adaptive RX: on TX: on
stats-block-usecs: 0
sample-interval: 0
pkt-rate-low: 0
pkt-rate-high: 0
rx-usecs: 25
rx-frames: 0
rx-usecs-irq: 0
rx-frames-irq: 256
tx-usecs: 25
tx-frames: 0
tx-usecs-irq: 0
tx-frames-irq: 256
rx-usecs-low: 0
rx-frame-low: 0
tx-usecs-low: 0
tx-frame-low: 0
rx-usecs-high: 0
rx-frame-high: 0
tx-usecs-high: 0
tx-frame-high: 0
调整:
ethtool -C ethx adaptive-rx on
简单总结一下网卡驱动丢包处理:

内核协议栈丢包
1、以太网链路层丢包
neighbor 系统 arp 丢包
arp_ignore 配置丢包
arp_ignore 参数的作用是控制系统在收到外部的 arp 请求时,是否要返回 arp 响应。arp_ignore 参数常用的取值主要有 0,1,2,3~8 较少用到;
查看:
#sysctl -a|grep arp_ignore

解决方案:根据实际场景设置对应值;
1、响应任意网卡上接收到的对本机 IP 地址的 arp 请求(包括环回网卡上的地址),而不管该目的 IP 是否在接收网卡上。
2、只响应目的 IP 地址为接收网卡上的本地地址的 arp 请求。
3、只响应目的 IP 地址为接收网卡上的本地地址的 arp 请求,并且 arp 请求的源 IP 必须和接收网卡同网段。
4、如果 ARP 请求数据包所请求的 IP 地址对应的本地地址其作用域(scope)为主机(host),则不回应 ARP 响应数据包,如果作用域为全局(global)或链路(link),则回应 ARP 响应数据包。

arp_filter 配置丢包
在多接口系统里面(比如腾讯云的弹性网卡场景),这些接口都可以回应arp请求,导致对端有可能学到不同的mac 地址,后续报文发送可能由于 mac 地址和接收报文接口 mac 地址不一样而导致丢包,arp_filter 主要是用来适配这种场景;
查看:
#sysctl -a | grep arp_filter

解决方案:
根据实际场景设置对应的值,一般默认是关掉此过滤规则,特殊情况可以打开;
0:默认值,表示回应arp请求的时候不检查接口情况;
1:表示回应arp请求时会检查接口是否和接收请求接口一致,不一致就不回应;
arp 表满导致丢包
比如下面这种情况,由于突发 arp 表项很多超过协议栈默认配置,发送报文的时候部分 arp 创建失败,导致发送失败,从而丢包:

查看:
查看 arp 状态:cat /proc/net/stat/arp_cache ,table_fulls 统计:

查看 dmesg 消息(内核打印):
dmesg|grep neighbour
neighbour: arp_cache: neighbor table overflow!
- 查看当前 arp 表大小:ip n|wc -l
查看系统配额:
sysctl -a |grep net.ipv4.neigh.default.gc_thresh
gc_thresh1:存在于ARP高速缓存中的最少层数,如果少于这个数,垃圾收集器将不会运行。缺省值是128。
gc_thresh2 :保存在 ARP 高速缓存中的最多的记录软限制。垃圾收集器在开始收集前,允许记录数超过这个数字 5 秒。缺省值是 512。
gc_thresh3 :保存在 ARP 高速缓存中的最多记录的硬限制,一旦高速缓存中的数目高于此,垃圾收集器将马上运行。缺省值是1024。
一般在内存足够情况下,可以认为 gc_thresh3 值是 arp 表总大小;

**解决方案:**根据实际 arp 最大值情况(比如访问其他子机最大个数),调整 arp 表大小
$ sudo sysctl -w net.ipv4.neigh.default.gc_thresh1=1024
$ sudo sysctl -w net.ipv4.neigh.default.gc_thresh2=2048
$ sudo sysctl -w net.ipv4.neigh.default.gc_thresh3=4096
$ sudo sysctl -p
arp 请求缓存队列溢出丢包
查看:
#cat /proc/net/stat/arp_cache ,unresolved_discards是否有新增计数
解决方案:根据客户需求调整缓存队列大小 unres_qlen_bytes:

网络 IP 层丢包
接口 IP 地址配置丢包
1、本机服务不通,检查lo接口有没有配置地址是 127.0.0.1;
2、本机接收失败, 查看 local 路由表:ip r show table local|grep 子机 IP 地址;这种丢包一般会出现在多 IP 场景,子机底层配置多 IP 失败,导致对应 IP 收不到包而丢包;

解决方案:
1、配置正确接口 IP 地址;比如 ip a add 1.1.1.1 dev eth0
2、如果发现接口有地址还丢包,可能是 local 路由表没有对应条目,紧急情况下,可以用手工补上:比如 ip r add local 本机ip地址 dev eth0 table local ;
路由丢包
路由配置丢包
查看:
1.查看配置 路由是否设置正确(是否可达),是否配置策略路由(在弹性网卡场景会出现此配置)ip rule:

然后找到对应路由表。查看路由表:

或者直接用 ip r get x.x.x.x,让系统帮你查找是否存在可达路由,接口是否符合预期;
2.查看系统统计信息
#netstat -s|grep “dropped because of missing route”
解决方案:重新配置正确的路由;
反向路由过滤丢包
反向路由过滤机制是 Linux 通过反向路由查询,检查收到的数据包源IP是否可路由(Loose mode)、是否最佳路由(Strict mode),如果没有通过验证,则丢弃数据包,设计的目的是防范IP地址欺骗攻击。
查看:
rp_filter 提供三种模式供配置:
1、不验证
2、RFC3704定义的严格模式:对每个收到的数据包,查询反向路由,如果数据包入口和反向路由出口不一致,则不通过
3、RFC3704定义的松散模式:对每个收到的数据包,查询反向路由,如果任何接口都不可达,则不通过
查看当前 rp_filter 策略配置:
$cat /proc/sys/net/ipv4/conf/eth0/rp_filter
如果这里设置为1,就需要查看主机的网络环境和路由策略是否可能会导致客户端的入包无法通过反向路由验证了。
从原理来看这个机制工作在网络层,因此,如果客户端能够Ping通服务器,就能够排除这个因素了。
解决方案:
根据实际网络环境将 rp_filter 设置为 0 或 2:
$ sysctl -w net.ipv4.conf.all.rp_filter=2或
$ sysctl -w net.ipv4.conf.eth0.rp_filter=2
防火墙丢包
客户设置规则导致丢包
查看:
#iptables -nvL |grep DROP ;
解决方案:修改防火墙规则;
连接跟踪导致丢包
连接跟踪表溢出丢包
kernel 用 ip_conntrack 模块来记录 iptables 网络包的状态,并把每条记录保存到 table 里(这个 table 在内存里,可以通过 /proc/net/ip_conntrack 查看当前已经记录的总数),如果网络状况繁忙,比如高连接,高并发连接等会导致逐步占用这个 table 可用空间,一般这个 table 很大不容易占满并且可以自己清理,table 的记录会一直呆在 table 里占用空间直到源 IP 发一个 RST 包,但是如果出现被攻击、错误的网络配置、有问题的路由/路由器、有问题的网卡等情况的时候,就会导致源 IP 发的这个 RST 包收不到,这样就积累在 table 里,越积累越多直到占满。无论,哪种情况导致 table 变满,满了以后就会丢包,出现外部无法连接服务器的情况。内核会报如下错误信息:kernel: ip_conntrack: table full,dropping packet;
查看当前连接跟踪数 :
cat /proc/sys/net/netfilter/nf_conntrack_max
解决方案:
增大跟踪的最大条数
net.netfilter.nf_conntrack_max = 3276800
减少跟踪连接的最大有效时间
net.netfilter.nf_conntrack_tcp_timeout_established = 1200
net.netfilter.nf_conntrack_udp_timeout_stream = 180
net.netfilter.nf_conntrack_icmp_timeout = 30
ct 创建冲突失导致丢包
查看:当前连接跟踪统计:cat /proc/net/stat/nf_conntrack,可以查各种 ct 异常丢包统计
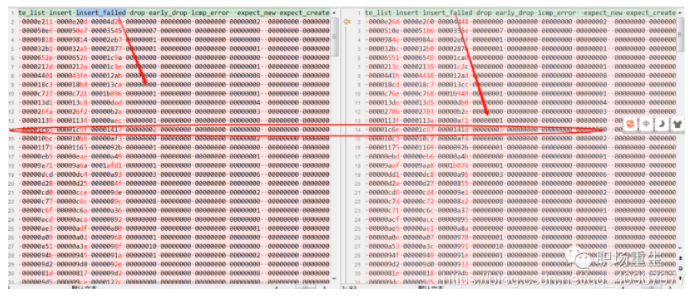
解决方案:内核热补丁修复或者更新内核版本(合入补丁修改);
3、传输层 UDP/TCP 丢包
TCP连接跟踪安全检查丢包
丢包原因:由于连接没有断开,但服务端或者client之前出现过发包异常等情况(报文没有经过连接跟踪模块更新窗口计数),没有更新合法的window范围,导致后续报文安全检查被丢包;协议栈用nf_conntrack_tcp_be_liberal 来控制这个选项:
1:关闭,只有不在 TCP 窗口内的rst包被标志为无效;
0:开启,所有不在 TCP 窗口中的包都被标志为无效;
查看:
查看配置 :
sysctl -a|grep nf_conntrack_tcp_be_liberal
net.netfilter.nf_conntrack_tcp_be_liberal = 1
查看 log:
一般情况下 netfiler 模块默认没有加载 log,需要手动加载;
modprobe ipt_LOG11
sysctl -w net.netfilter.nf_log.2=ipt_LOG
然后发包后在查看 syslog;
解决方案:根据实际抓包分析情况判断是不是此机制导致的丢包,可以试着关闭试一下;
分片重组丢包
情况总结:超时
查看:
#netstat -s|grep timeout
601 fragments dropped after timeout
解决方法:调整超时时间
net.ipv4.ipfrag_time = 30
sysctl -w net.ipv4.ipfrag_time=60
frag_high_thresh,分片的内存超过一定阈值会导致系统安全检查丢包
查看:
netstat -s|grep reassembles
8094 packet reassembles failed
解决方案:调整大小
net.ipv4.ipfrag_high_thresh
net.ipv4.ipfrag_low_thresh
分片安全距检查离丢包
查看:
网上学习资料一大堆,但如果学到的知识不成体系,遇到问题时只是浅尝辄止,不再深入研究,那么很难做到真正的技术提升。
需要这份系统化的资料的朋友,可以添加V获取:vip1024b (备注软件测试)
一个人可以走的很快,但一群人才能走的更远!不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
30
sysctl -w net.ipv4.ipfrag_time=60
frag_high_thresh,分片的内存超过一定阈值会导致系统安全检查丢包
查看:
netstat -s|grep reassembles
8094 packet reassembles failed
解决方案:调整大小
net.ipv4.ipfrag_high_thresh
net.ipv4.ipfrag_low_thresh
分片安全距检查离丢包
查看:
网上学习资料一大堆,但如果学到的知识不成体系,遇到问题时只是浅尝辄止,不再深入研究,那么很难做到真正的技术提升。
需要这份系统化的资料的朋友,可以添加V获取:vip1024b (备注软件测试)
[外链图片转存中…(img-XjEkHTjT-1713453023918)]
一个人可以走的很快,但一群人才能走的更远!不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 22
 0
- 0


 已为社区贡献4条内容

所有评论(0)