Attention is all you need注意力机制代码解析

在这篇文章中,我以逐行实施的形式介绍了本文的“注释”版本。 我已经重新排序并从原始论文中删除了一些部分,并在全文中添加了评论。 本文档本身是一个有效的笔记本,应完全可用。 总共有400行库代码,可在4个GPU上每秒处理27,000个token。
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import math, copy, time
from torch.autograd import Variable
import matplotlib.pyplot as plt
import seaborn
seaborn.set_context(context="talk")
%matplotlib inline
背景
减少顺序计算的目标也构成了扩展神经GPU,ByteNet和ConvS2S的基础,它们全部使用卷积神经网络作为基本构建块,可以并行计算所有输入和输出位置的隐藏表示。在这些模型中,关联来自两个任意输入或输出位置的信号所需的操作数在位置之间的距离中增加,对于ConvS2S线性增长,而对于ByteNet则对数增长。这使得学习远距离之间的依赖性变得更加困难。在本文中,此操作被减少为恒定的操作次数,尽管这是由于平均注意力加权位置而导致有效分辨率降低的代价,我们用多头注意力来抵消这种效果。
自我注意(有时称为内部注意)是一种与单个序列的不同位置相关的注意力机制,目的是计算序列的表示形式。自我注意已成功用于各种任务中,包括阅读理解,抽象概括,文本蕴涵和学习与任务无关的句子表示。端到端内存网络基于递归注意机制,而不是序列对齐的递归,并且已被证明在简单语言问答和语言建模任务中表现良好。
据我们所知,Transformer是第一个完全依靠自我注意力来计算其输入和输出表示的转导模型,而无需使用序列对齐的RNN或卷积。
大多数有效神经序列转导模型都具有编码器-解码器结构。 在此,编码器将符号表示形式(x 1,…,x n)的输入序列映射到连续表示形式z =(z 1,…,z n)的序列。 给定z,则解码器然后一次生成一个元素的符号的输出序列(y 1,…,y m)。 在每个步骤中,模型都是自回归的(引用),在生成下一个时,会将先前生成的符号用作附加输入。
class EncoderDecoder(nn.Module):
    """
    A standard Encoder-Decoder architecture. Base for this and many
    other models.
    """
    def __init__(self, encoder, decoder, src_embed, tgt_embed, generator):
        super(EncoderDecoder, self).__init__()
        self.encoder = encoder
        self.decoder = decoder
        self.src_embed = src_embed
        self.tgt_embed = tgt_embed
        self.generator = generator

    def forward(self, src, tgt, src_mask, tgt_mask):
        "Take in and process masked src and target sequences."
        return self.decode(self.encode(src, src_mask), src_mask,
                            tgt, tgt_mask)

    def encode(self, src, src_mask):
        return self.encoder(self.src_embed(src), src_mask)

    def decode(self, memory, src_mask, tgt, tgt_mask):
        return self.decoder(self.tgt_embed(tgt), memory, src_mask, tgt_mask)
class Generator(nn.Module):
    "Define standard linear + softmax generation step."
    def __init__(self, d_model, vocab):
        super(Generator, self).__init__()
        self.proj = nn.Linear(d_model, vocab)

    def forward(self, x):
        return F.log_softmax(self.proj(x), dim=-1)
Encoder and Decoder Stacks
Encoder
transformer遵循这种总体架构,对编码器和解码器使用堆叠式自注意力和point-wise,全连接层,分别如图1的左半部分和右半部分所示。

编码器由N = 6个相同层的堆栈组成。
def clones(module, N):
    "Produce N identical layers."
    return nn.ModuleList([copy.deepcopy(module) for _ in range(N)])
class Encoder(nn.Module):
    "Core encoder is a stack of N layers"
    def __init__(self, layer, N):
        super(Encoder, self).__init__()
        self.layers = clones(layer, N)
        self.norm = LayerNorm(layer.size)

    def forward(self, x, mask):
        "Pass the input (and mask) through each layer in turn."
        for layer in self.layers:
            x = layer(x, mask)
        return self.norm(x)
我们在两个子层的每一层周围都采用了残差连接(引用),然后进行层归一化(引用)。
class LayerNorm(nn.Module):
    "Construct a layernorm module (See citation for details)."
    def __init__(self, features, eps=1e-6):
        super(LayerNorm, self).__init__()
        self.a_2 = nn.Parameter(torch.ones(features))
        self.b_2 = nn.Parameter(torch.zeros(features))
        self.eps = eps

    def forward(self, x):
        mean = x.mean(-1, keepdim=True)
        std = x.std(-1, keepdim=True)
        return self.a_2 * (x - mean) / (std + self.eps) + self.b_2
也就是说,每个子层的输出为L a y e N o r m(x + S u b l a y e r(x)),其中S u b l a y e r(x)是子层本身实现的功能。 在将每个子层的输出添加到子层输入并对其进行规范化之前,我们将其应用到子层的输出中。
为了促进这些剩余连接,模型中的所有子层以及嵌入层均产生dmodel = 512维度的输出。
class SublayerConnection(nn.Module):
    """
    A residual connection followed by a layer norm.
    Note for code simplicity the norm is first as opposed to last.
    """
    def __init__(self, size, dropout):
        super(SublayerConnection, self).__init__()
        self.norm = LayerNorm(size)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, sublayer):
        "Apply residual connection to any sublayer with the same size."
        return x + self.dropout(sublayer(self.norm(x)))
每层都有两个子层。 第一个是多头自我关注机制,第二个是简单的位置完全连接的前馈网络。
class EncoderLayer(nn.Module):
    "Encoder is made up of self-attn and feed forward (defined below)"
    def __init__(self, size, self_attn, feed_forward, dropout):
        super(EncoderLayer, self).__init__()
        self.self_attn = self_attn
        self.feed_forward = feed_forward
        self.sublayer = clones(SublayerConnection(size, dropout), 2)
        self.size = size

    def forward(self, x, mask):
        "Follow Figure 1 (left) for connections."
        x = self.sublayer[0](x, lambda x: self.self_attn(x, x, x, mask))
        return self.sublayer[1](x, self.feed_forward)
Decoder
解码器还由N = 6个相同层的堆栈组成。
class Decoder(nn.Module):
    "Generic N layer decoder with masking."
    def __init__(self, layer, N):
        super(Decoder, self).__init__()
        self.layers = clones(layer, N)
        self.norm = LayerNorm(layer.size)

    def forward(self, x, memory, src_mask, tgt_mask):
        for layer in self.layers:
            x = layer(x, memory, src_mask, tgt_mask)
        return self.norm(x)
除了每个编码器层中的两个子层之外,解码器还插入第三子层,该第三子层对编码器堆栈的输出执行多头关注。 与编码器类似,我们在每个子层周围采用残余连接,然后进行层归一化。
class DecoderLayer(nn.Module):
    "Decoder is made of self-attn, src-attn, and feed forward (defined below)"
    def __init__(self, size, self_attn, src_attn, feed_forward, dropout):
        super(DecoderLayer, self).__init__()
        self.size = size
        self.self_attn = self_attn
        self.src_attn = src_attn
        self.feed_forward = feed_forward
        self.sublayer = clones(SublayerConnection(size, dropout), 3)

    def forward(self, x, memory, src_mask, tgt_mask):
        "Follow Figure 1 (right) for connections."
        m = memory
        x = self.sublayer[0](x, lambda x: self.self_attn(x, x, x, tgt_mask))
        x = self.sublayer[1](x, lambda x: self.src_attn(x, m, m, src_mask))
        return self.sublayer[2](x, self.feed_forward)
Attention
注意功能可以描述为将查询和一组键值对映射到输出,其中查询,键,值和输出都是向量。 将输出计算为值的加权总和,其中分配给每个值的权重是通过查询与相应键的兼容性函数来计算的。
我们将我们的特别关注称为“点状产品关注度”。 输入由维数为d k的查询和键以及维数为d v的值组成。 我们使用所有键计算查询的点积,将每个键除以√d k,然后应用softmax函数来获得值的权重。

实际上,我们在一组查询上同时计算注意力函数,将它们打包成矩阵Q。 键和值也打包到矩阵K和V中。 我们将输出矩阵计算为:
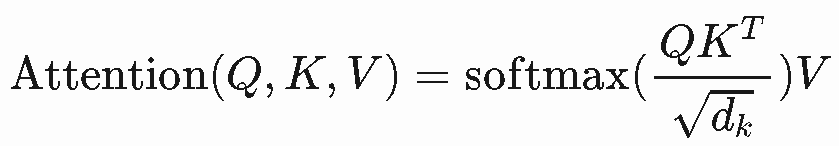
def attention(query, key, value, mask=None, dropout=None):
    "Compute 'Scaled Dot Product Attention'"
    d_k = query.size(-1)
    scores = torch.matmul(query, key.transpose(-2, -1)) \
             / math.sqrt(d_k)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, -1e9)
    p_attn = F.softmax(scores, dim = -1)
    if dropout is not None:
        p_attn = dropout(p_attn)
    return torch.matmul(p_attn, value), p_attn
两个最常用的注意力功能是加性注意力(引用)和点乘(乘法)注意力。 点积注意与我们的算法相同,除了比例因子 。 加法注意力使用具有单个隐藏层的前馈网络来计算兼容性函数。 尽管两者在理论上的复杂度相似,但是在实践中点积的关注要快得多,并且空间效率更高,因为可以使用高度优化的矩阵乘法代码来实现。
尽管对于较小的值,这两种机制的作用类似,而对于较大的
加和注意优于点积注意。 我们怀疑对于较大的
值,点积会增大幅度,从而将softmax函数推入梯度极小的区域(为说明为什么点积变大,请假设q和k的分量是独立随机的) 均值为0且方差为1的变量,则其点积
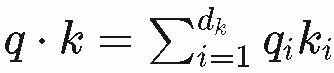 ,均值为0且方差为
。为了抵消这种影响,我们将点积缩放
。


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)