强化学习的数学原理:值函数近似
概述
在上次课介绍了 TD Learning,实际上这次课依然是介绍 TD ,但是上次是用的表格形式介绍的,这次课我们将会介绍基于函数的方式。
算法其实不太难,难的是思路和想法,另外这一节将引入神经网络。
另外最经典的 Deep Q-learning 在这里也会学习到。
大纲如下:

Motivating examples:curve fitting
这一节将使用 曲线拟合 的例子来进行表格到函数的过渡。
虽然没有明说,但是到目前为止实际上 state value 和 action value 全部都假设它们是用表格的形式表达出来的,比如下图中的 action value 就由两个下标可以围城一个表格(在代码实现当中也都是用一个一个矩阵或者三维数组表示出来的),在编程的时候我们会将这样的表格重组成向量矩阵或者是数组,其优缺点也很明显:

优点是非常直观,分析也非常容易。
缺点同样明显,它没办法处理非常大的 state space 或者是 action space ,或者 state space 是连续的情况,这些表格都无法处理(在编程实现当中就是不好存储),另外这样的方式泛化性能也是比较差的(什么意思?就是当有很多的 state action pair 你必须全部访问到它们才能估计出来它们的值,但是因为太多了而没办法完全访问到,此时泛化性能就会很差)。
而通过函数近似的方法我们可以很好的解决其存在的缺点:

如上图所示,横坐标是 S ,其表示状态空间中的每个状态,而纵坐标表示的是 state value,那些 state value 分别就对应了那些离散的圆点。
那现在的问题是如果状态的个数非常非常多,如果要把它全部存储下来,其实要花非常大的内存,那有没有可能用一个曲线把这些离散的点给它串起来?然后用这个曲线来代表这些点呢?为什么要用曲线呢就是因为这个曲线它所对应的参数的个数其实是非常少的,我只要存储比较少的参数就能来表示所有的这些状态它的 state value。
答案肯定是可以的,最最简单的情况就是我们用一条直线来拟合这些点:

直线方程如上,如果横坐标是 s 的话,就是 as+b,a 和 b 在这里是两个参数,函数使用 v hat 来表示,v 表示对值的近似,hat 一般是代表估计的意思。然后这个 v hat 是两个量的函数,第一个量 s 是状态,第二个量 w 是参数,这个 w 是怎么回事呢?从上图等号右侧可以发现这个函数可以被写成由两个向量相乘的方式,因此 w 的意思就是参数向量。同时 fai(s) 则被称为特征向量。
因此 v hat 则是对 w 成一个线性的关系。
当然也可以是非线性的,但先从简单的入手嘛。

有了上面这个函数之后,我们就不需要存储大量的数据了,只需要根据近似的 vhat(s, w),第一步先计算出来特征向量 fai(s),然后再用这个特征向量和参数向量 w 相乘就可以计算得到 state value ,也就是 vhat。这样我就只需要保存 w 就可以了,这样就极大地节省了很多内存。
但其缺点就是精度有缺失,明显的这样一条直线很难拟合所有的点,这也是为什么这种方法叫 值近似 。
接下来我们就可以使用更高阶的曲线来进行拟合:

在这种情况下,参数向量和特征向量的维数虽然提高了但是好处也是显而易见的,其拟合精度是有可能提高的。

简单小结一下:

Algorithm for state value estimation
第二节包含了很多小节,它介绍了值函数近似这种方法的思想和概念还有相关细节。
Objective function
先来看一下 objective function:

首先 vΠ(s) 是对 s 的真的 state value,v hat 是它估计的一个值。我们的目标就是要让这个估计值尽可能地去接近真值。然后当这个 v hat 函数它的结构确定的时候,比如说之前我们知道它是一个线性的函数,它是一个直线抛物线或者说它是一个神经网络,当它神经网络的结构确定的时候剩下我们可以调节的就是 w,我们要做的就是找到一个最优的 w 使得这个 v hat 尽可能地去接近 vΠ 。
因此这个问题实际上就是一个 policy evaluation 的问题。因为你给我一个策略,我要找到一个近似的函数 v hat 尽可能地去接近它真实的 state value,然后之后我们会再推广得到这个 action value ,再推广得到怎么样去找最优的策略,一步一步来嘛。
先来看怎么做 policy evaluation,这个和我们上节课介绍 TD 算法其实也是一样的。
下面的我们目标就是找最优的 w,怎么找呢?
第一步是正式的把目标函数给很好的定义一下。
第二步就是去优化这个目标函数。
怎么定义目标函数:

上图中的函数就是值函数近似这种方法它的目标函数 J(w),w 是我们要优化的参数。它等于等式右边的一个期望,期望内是一个误差,是state value 真值和估计值之间的误差。
我们的目标就是找到最优的 w 然后去优化这样一个目标函数。
值得指出的是这里边的 S 实际上是一个随机变量,随机变量它一定是有概率分布的,那么 S 它的概率分布是什么呢?
这个问题换另一个角度问就是说这里边不是有一个 expectation 吗?expectation 本质上就是做 average,我对所有的状态求一个平均,这个平均应该怎么个平均?
有两种方法来定义 S 的概率分布:

第一种方式采用平均分布,它的意思就是把所有的状态把它们认为是 equally important,大家都是平等的。那我给每一个人的概率或者说给每一个求平均时候的权重都是一样的。假设一共有 N 个状态,那么每一个人的概率或者权重就是 1/N 。
但这显然有缺陷(怎么可能所有状态都是同等重要的呢?),但这种缺陷将在第二种方式平稳分布中被解决:

第二种方式的思想就是只想关注重要的状态而尽量忽略不重要的状态,意思就是给重要的状态以更大的权重,而给不重要的状态以更小的权重,这样来定义 S 的概率分布。这种方式被称为 稳定分布。
这是一个非常重要的概念,它描述了 long-run behavior 。
简单介绍一下,后面会有例子。
什么是 long-run behavior 呢?就是我从某一个状态出发,然后我按照一个策略我采取 action,然后我不断地去和环境进行交互,然后我一直采取这个策略,采取了非常非常多次之后,实际上我就达到了一种平稳的状态,在这个平稳状态下我能告诉你在每一个状态 agent 出现它的概率是多少。
后面会有例子,现在只要先知道它就是一个概率分布就可以了。
我们使用 dΠ 来表示 dΠ(s) 就是在 s 它的概率。
更进一步的介绍 稳定分布:

简单说明的一个例子:


Optimization algorithms
有了刚才的目标函数,下面我们要去优化这个目标函数,来看一下这个优化的算法是什么。
第一个该想到的就应该梯度下降:

上图使用梯度下降的优化方法得到了 true gradient,但是其表达式还存在一个 expectation,我们怎么去避免计算这个 expectation 呢?在实际当中我们很自然的就想到使用 随机梯度 来代替这个 true gradient 。
就是之前将 SGD 的时候说过的,使用采样来代替期望:

从上图可以看到,αt 后面这一长串本来是在 expectation 里面,但是现在我们把它去掉,并且把里面所有的 random variable 用采样 st 来代替了。
另外还要注意本来式子中还有个 2,但是为了式子的简洁性将 2αk 合并到了一起以 αk 来表示。
到此为止,算法形式基本就介绍完了,但是只介绍了一半?为什么?
因为表达式中出现了 vΠ(s) 这个我们是不知道的,实际上这个是我们要求解的数,所以这个算法在实际当中肯定是不能使用的,但是不要慌,我们可以用其它的量来代替 vΠ(st) ,怎么来代替呢?
也有两种方法:

根据上图所示,第一种是蒙特卡洛的方法,我们不是不知道 vΠ(st) 吗?我们用这个 gt 来代替,什么是 gt 呢?从 st 出发我有一个 episode,然后沿着那个 episode 我有一系列的 reward,我得到的 discounted return 就是 gt 。我用这个 gt 来作为 vΠ(st) 的一个估计值。这时候所得到的这个算法就是蒙特卡洛的方法。
第二种方法是 TD 的方法,就是用 TD 算法将 vΠ (st)给换了下来:
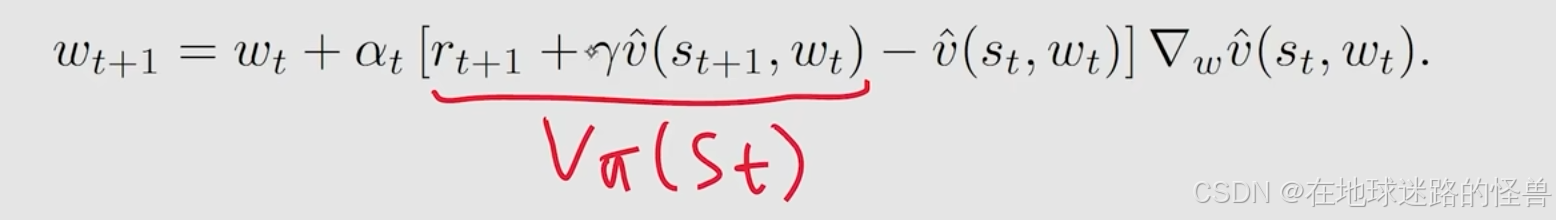
其算法伪代码如下:

到此为止我们就基本上介绍完了优化的算法,但是要注意这些优化算法究竟是在做什么事情呢?其实就是来估计一个给定了策略的 state value,之后我们才会去推广到去估计 action value ,然后再推广到怎么去和 policy improvement 相结合去搜索最优策略的这样一个算法。
但是不管怎样,我们现在去求解 state value 的这样的算法是非常关键的。能够帮助我们理解值函数近似这种方法核心思想的一个算法,所以也是比较关键的。
Selection of function approximators
之前提过要用一个函数 v hat 去逼近这个 vΠ,但是 v hat 怎么样去选取呢?其实之前我们也提到了,这里我们再着重介绍一下。
基本上有两种方法:

第一种方法是之前非常广泛使用的,这时候 v hat 是一个线性的函数,之前在 motivating example 当中提过,就不再赘述。
第二种方法则是目前非常广泛使用的,用神经网络来逼近这样一个函数,也就是我不知道这个神经网络的表达式,但是我可以输入一个 s 然后它就能输出一个 v hat (s, w) ,它的参数也就是 w。这个神经网络可以认为是 w 的一个非线性的函数。
再来看一下线性的情况,分析之后就会明白为什么它会被神经网络所慢慢取代,其实就是特征不好手动提取嘛:


事实上,之前所学习的 tabular 的情况其实是一种特殊的 值函数近似 :


Illustrative examples
接下来给出一些例子。


那么 TD Linear 是不是也能很好地去估计出来 state value:


Summary of the story

尽管上述说的这一套流程对于理解值函数近似的思想是有帮助的,但从数学上来说是不严谨的。
Theoretical analysis
简单从数学上分析一下:


Sarsa with function approximation


Q-learning with function approximation


Deep Q-learning
这个算法的介绍是可咸可淡,这里老师会介绍的比较细致,要仔细的学一下嗷。

Deep Q-learning 又被称为 DQN,Deep Q-Network,最早是在原论文当中这么叫的。当然 Deep Q-learning 也是比较广泛的一种叫法,之所以这么叫是因为想突出该算法实际上是 Q-learning 的一种变形。
这个算法是最早的也是最成功的一个把深度神经网络引入到强化学习中的一个算法,虽然在它之前也有人这么做过,但是效果不好,所以 DQN 才是最早取得应用成功的算法。
它取得成功主要是在应用和方法这两个点上,在应用上它取得了非常好的效果,就是在一系列的游戏的控制上已经到达了人类控制的水平。然后在方法上它也使用了一些关键的技术,这些技术在后边很多方法当中也被广泛的使用。
神经网络在这里边所扮演的角色从本质上说当然就是一个非线性函数。
在正式介绍 DQN 之前要先澄清一个问题:为什么我们已经有 Q-learning with function approximation 了却还要引入一个 DQN 呢?
因为不使用 DQN 的话,我们就需要对神经网络进行非常底层的运算,要计算梯度然后要去赋值对参数进行修改等等,而现在神经网络的工具包呢已经非常成熟了,对我们很多人而言,它就是一个黑盒,我们把数据送进去它就能够选择非常合适的参数和非常底层的算法去做很好的训练。
因此我们引入 DQN 。
我们如果要训练神经网络,那么我们就需要一个损失函数,也就是下面的 J(w) :

有了这个损失函数,那么我们就可以进行优化了:

要优化自然而然就能想到是用梯度下降的方式,那么如何去计算这个损失函数的 gradient?
是有一点小技巧的,这也是 DQN 的一个重点的贡献。
分析一下,要想计算 J 相对于 w 的梯度,这里要注意在 J(w) 的表达式中有两个 w 参数:
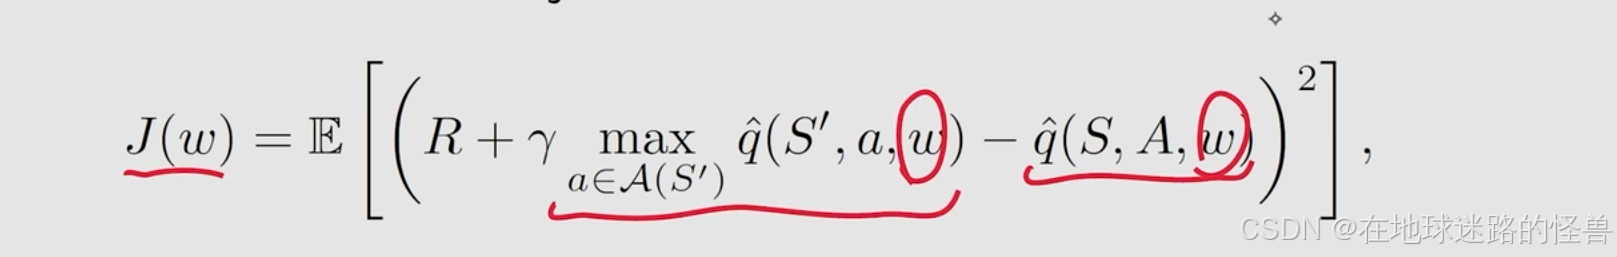
上图中右边的这个 w 计算梯度相对来说是比较简单的,那就是直接对 q hat 进行求导嘛。
但左边这个就稍微麻烦一些了,在 DQN 当中是怎么做的呢?
它把整个左边含 w 的式子假设成 y,然后 y 里边是包含了 w:
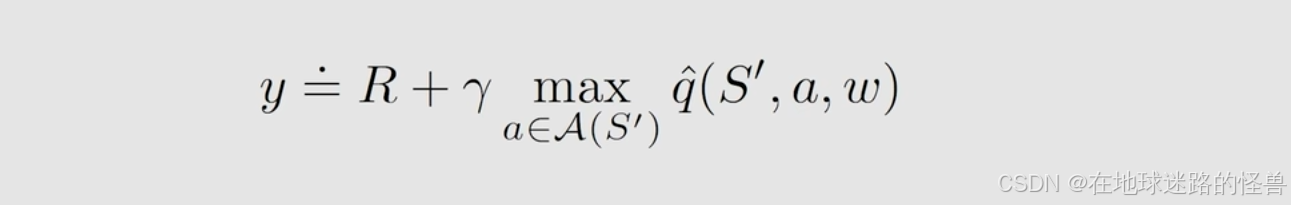
假设这个 y 里面的 w 是一个常数,那这时候这个 J(w) 实际上就只是相关于右边这个 w 的一个函数了。那么这个时候再去求解它的梯度就会相对简单一些,这就是它的基本的思想。
我们重点来看一下它是怎么做的:

为了实现这个技巧,在 DQN 当中引入了两个 network(对应 function),第一个 network 就是叫 main network,它对应的就是上图中的 q hat(s, a, w)。第二个 network 是 target network 对应的是 q hat(s, a, wT) ,下标 T 表示 target。
main network 实际上它的 w 一直在被更新,也就是有新的采样进来的时候 w 就会更新,但是 target network 它不是一直更新的,它是隔一段时间之后会把 main network 它的 w 给赋值给赋过来。
这就是这个技巧的基本思想。
基于刚才的目标损失函数,我们可以计算出来它的梯度就是下图这样:

可以从上图中看到只有关于蓝色部分的这个 q hat 的梯度,红色部分的就不求梯度了。
DQN 一共采用了两种比较精妙的技巧,其中一种就是刚刚说的采用了两个 network:

而还有一种技巧就是 Experience replay,经验回放。
一共要说两个问题,第一个是什么是经验回放?

在收集数据的时候,也就是收集经验 experience sample 的时候一定是有先后顺序的,但是我们在使用这些 sample 的时候,不一定要按照它们先后顺序,不是说谁先来我就先使用谁,那我们怎么使用呢?
我们把所有的这些数据放到一个集合当中,这个集合的名字就叫做 replay buffer。
然后每次要训练神经网络的时候我不是说谁先来的我就先用谁来训练神经网络,而是说我把它们全部混到一起然后从这个集合当中去拿一些样品出来来训练这个神经网络。
然后在拿的时候呢,就是拿过来再用的这个过程实际上就叫做 experience replay,因为那个经验已经在那儿了,我再把它用一次那不就是叫回放吗?
最后在拿数据的时候一定要注意,一定要服从 均匀分布 。也就是里面每一个数据点它被拿到的概率应该是相同的。
还有一个问题是为什么要使用经验回放?另外采样的时候为什么要服从平均分布呢?

这问题的答案要依赖于这个目标损失函数,在这个目标函数中有几个随机变量,R、S prime、S 和 A,那我要对这些随机变量求 expectation 我就必须要知道它们的分布,具体看上图以及下图的分析。

因为采用均匀分布,所有的 (S, A) 它们所对应的概率都应该是相同的。那么问题就来了,数学上要求(S, A)是均匀分布,但是采集数据的时候它一定是有先后顺序,并且是按照其它的概率分布采集的,这时候该怎么办?
非常简单,就不按照它先后顺序进行使用就行了。也就是使用这个经验回放的方法,我把所有的 sample 拿到一起然后进行打散,然后从里面均匀地进行采样。这样就可以打破不同 sample 之间的 correlation 。这也就是为什么经验回放这个技巧是必须的。
回顾一下看看之前基于表格方式的算法是否有涉及到经验回放的操作:

该算法伪代码如下:

DQN Implementation
import random

import numpy as np
import time
import os

import torch.nn
from matplotlib import pyplot as plt


def get_reward(location, action, graph):
    # r, c 表示地图的行数和列数
    r, c = len(graph), len(graph[0])
    reward = -1  # 默认奖励为 -1,因为要求走最短路径
    # row, col 表示当前所在行列位置
    row, col = location
    # 采取行动为0,表示往上,那么当前位置的行数+1
    if action == 0:
        row = row - 1
    # 采取行动为1,表示往下,那么当前位置的行数-1
    elif action == 1:
        row = row + 1
    # 采取行动为2,表示往左,那么当前位置的列数-1
    elif action == 2:
        col = col - 1
    # 采取行动为3,表示往右,那么当前位置的列数+1
    elif action == 3:
        col = col + 1

    # 如果采取了action后的所在行列位置越界了,reward-1
    if row < 0 or row > r - 1 or col < 0 or col > c - 1:
        reward = -1
    # 如果采取了action后的所在行列位置在forbidden area,reward-100
    # 这表示我们并不想让 agent 走进 forbidden area
    elif graph[row][col] == '×':
        reward = -100
    # 如果采取了action后的所在行列位置在目标位置了,reward+20
    elif graph[row][col] == '●':
        reward = 20

    # 控制边界约束, 防止越界异常
    row = max(0, row)
    row = min(r - 1, row)
    col = max(0, col)
    col = min(c - 1, col)
    # 返回下一个状态以及奖励
    return row, col, reward


# 在Python 3中,几乎所有的类都默认继承自object类,即使你不显式地写出来
class Solver(object):
    def __init__(self, r: int, c: int):
        """
        :param r: 代表当前地图行数
        :param c: 代表当前地图列数
        """
        # 初始化动作空间
        # 在Python中,大括号 {} 通常用来表示一个字典(dictionary)。
        # 字典是Python中一种内置的数据结构,用于存储键值对(key-value pairs)。
        # 每个键(key)都是唯一的,并且与一个值(value)相关联。
        self.idx_to_action = {0: '↑', 1: '↓', 2: '←', 3: '→', 4: 'O'}
        # 初始化地图行数、列数、动作个数
        self.r, self.c, self.action_nums = r, c, len(self.idx_to_action)
        # 随机初始化状态价值矩阵
        self.state_value_matrix = np.random.randn(r, c)
        # 随机初始化动作价值矩阵,这是一个三维矩阵
        # 这个矩阵用于表示在某个状态(由r和c指定)下,执行不同动作(由len(self.idx_to_action)确定)的“价值”或“评分”。
        self.action_value_matrix = np.random.randn(r, c, len(self.idx_to_action))
        # 随机初始化当前最优策略
        # self.cur_best_policy 被赋予了这个二维数组,它用于表示在当前学习或评估过程中,
        # 对于每个状态(由 r 行和 c 列定义的状态空间中的每个点),算法认为的最佳动作(或动作索引)。
        # 然而,由于这些值是随机抽取的,所以它们并不代表真正的最优策略,而只是作为初始值或某种随机策略的一部分。
        # np.random.choice 是 NumPy 库中的一个函数,用于从给定的一维数组中随机抽取元素,或者从指定的范围中随机生成整数
        # size=(r, c) 指定了输出数组的形状。
        # 因此,np.random.choice 会生成一个形状为 (r, c) 的二维数组,其中每个元素都是从上述范围内随机抽取的一个整数
        self.cur_best_policy = np.random.choice(len(self.idx_to_action), size=(r, c))
        self.cnt = 0

    # 打印当前的最优策略
    def show_policy(self):
        # [self.idx_to_action[idx] for idx in i] 是一个列表推导式,
        # 它遍历 i 中的每个元素(假设 i 是一个可迭代对象,比如列表或元组,且其元素是索引),
        # 并使用这些索引从 self.idx_to_action(假设这是一个字典或列表,将索引映射到动作名称或动作本身)中检索对应的动作。
        # 然后,print 函数的星号操作符 * 用于解包这个列表,使得列表中的每个元素都作为 print 函数的一个单独的位置参数,
        # 从而它们会被打印出来,并且默认会在它们之间添加空格作为分隔符。
        # 更具体的解释可以看本文代码后面的相关语法解析
        for i in self.cur_best_policy.tolist():
            print(*[self.idx_to_action[idx] for idx in i], sep=' ')

    # 显示地图
    def show_graph(self, graph):
        for i in graph:
            print(*i, sep=' ')

    # 清空控制台
    def clear_console(self):
        """
        通过os.name属性,可以获取一个字符串,该字符串表示Python正在运行的操作系统。
        对于Windows系统,os.name的值是'nt'(代表“New Technology”,是Windows NT及其后续版本的缩写)。
        对于大多数Unix-like系统(包括Linux和macOS),os.name的值是'posix'。
        对于代码 _ = os.system(...):
            其使用了_(通常用作Python中的“don't care”变量,即一个用于接收不需要使用的值的变量名)来接收os.system(...)的返回值。
        如果不关心返回值的话,不写 _ 也是可以的,但这是一种良好的编程习惯
        """
        if os.name == 'nt':  # 对于 windows 系统
            _ = os.system('cls')
        else:  # 对于 Linux 和 mac
            _ = os.system('clear')

    # 打印点到点的动态运行过程
    def show_point_to_point(self, start_point, end_point, graph):
        # 越界检测
        assert (0 <= start_point[0] < self.r) and (
                0 <= start_point[1] < self.c), f'The start_point is {start_point}, is out of range.'
        assert (0 <= end_point[0] < self.r) and (
                0 <= end_point[1] < self.c), f'The end_point is {end_point}, is out of range.'

        # 记录起始点
        row, col = start_point
        i = 0
        # 开始展示动态运行过程
        while True:
            # 在起始点根据当前的最优策略选择采取的行动
            graph[row][col] = self.idx_to_action[self.cur_best_policy[row][col]]
            # 选择行动之后,清空控制台
            self.clear_console()
            # 显示地图
            self.show_graph(graph)
            # 为了方便观察,沉睡 0.5 s
            time.sleep(0.5)
            # 根据最优策略选择action后所进入的下一个状态[row][col]以及对应得到的 reward 值
            # 对于打印动态运行过程来说 reward 并没有用,因此这里没有接收 reward 值
            row, col, _ = get_reward((row, col), self.cur_best_policy[row][col], graph)
            # 循环退出条件为:要么已经到达最终状态,要么i已经大于了 r*c 大小
            # 因为如果进行轮次数 i 已经比网格世界的格子数还大了,那么说明无解,当然可以结束
            if (row, col) == end_point or i > self.r * self.c:
                break
            # 轮次数量+1
            i += 1

        # epsilon 贪婪法,当 epsilon = 0,完全贪婪法

    def get_epsilon_greedy_action(self, state, epsilon=0.1):
        row, col = state
        # 找最优动作
        best_action = np.argmax(self.action_value_matrix[row][col]).item()
        # epsilon贪婪法,当 epsilon != 0时,才有可能进入该 if 语句,否则直接返回最优动作
        """
        < 右侧的式子表示的是 greedy action 被选择的概率
        < 左侧的式子表示的是其它的 action 被选择的概率
        使用 random.random 随机数与 greedy action 的概率值进行随机比较这样才不会总是返回最优动作
        同时这样的做法也会更倾向于选择概率值较大的 greedy action
        """
        if random.random() < epsilon * (self.action_nums - 1) / self.action_nums:
            # 随机选择除了当前最佳 action 之外的其它 action
            # 因为其它的 action 被选择的概率都是一样的,所以随机选就可以
            actions = list(self.idx_to_action.keys())
            actions.remove(best_action)
            return random.choice(actions)
        return best_action

    def mplot(self, x, y, ax, fmt, title, x_label, y_label, legend):
        ax.plot(x, y, fmt)
        ax.set_xlim(x[0], x[-1] + 0.4)  # 设置X轴范围
        # ax.set_xticks(x)  # 用于设置X轴上要显示的刻度值
        ax.set_xlabel(x_label)
        ax.set_ylabel(y_label)
        ax.legend(legend)
        ax.set_title(title)


class DQN(Solver):
    def __init__(self, r: int, c: int, n_features: int, hidden_dims: int, learning_rate: float):
        super(DQN, self).__init__(r, c)
        """target network,延迟更新"""
        self.target_model = torch.nn.Sequential(torch.nn.Linear(n_features, hidden_dims), torch.nn.ReLU(),
                                                torch.nn.Linear(hidden_dims, hidden_dims), torch.nn.ReLU(),
                                                torch.nn.Linear(hidden_dims, self.action_nums))
        """main network,频繁更新"""
        self.eval_model = torch.nn.Sequential(torch.nn.Linear(n_features, hidden_dims), torch.nn.ReLU(),
                                              torch.nn.Linear(hidden_dims, hidden_dims), torch.nn.ReLU(),
                                              torch.nn.Linear(hidden_dims, self.action_nums))
        # 损失函数
        self.loss_fn = torch.nn.MSELoss()
        # 优化器
        self.optimizer = torch.optim.Adam(self.eval_model.parameters(), lr=learning_rate)
        # 记录数据
        self.datas = []

    def get_feature(self, state):
        """
        :param state: 状态
        :return: 代入 state 后归一化的结果
        """
        row, col = state
        # 归一化到 [0, 1] 之间
        x_normalized = (col + 1) / self.c
        y_normalized = (row + 1) / self.r
        data = [x_normalized, y_normalized]
        return torch.tensor(data, dtype=torch.float32).reshape(-1, 2)

    def update_data(self, graph, start_state=None):
        # 起点随机生成
        if start_state is None:
            # 随机生成初始状态
            cur_state = (random.randint(0, self.r - 1), random.randint(0, self.c - 1))
        else:
            # 指定起点
            cur_state = start_state

        cur_action = self.get_epsilon_greedy_action(cur_state)
        j = 0
        while graph[cur_state[0]][cur_state[1]] != '●' or len(self.datas) < 100:
            *next_state, reward = get_reward(cur_state, cur_action, graph)
            next_action = self.get_epsilon_greedy_action(next_state)
            self.datas.append((cur_state, cur_action, reward, next_state))
            cur_state = next_state
            cur_action = next_action
            j += 1
            if j > 100:
                break
        # 只保留最近的1000个数据
        self.datas = self.datas[-1000:]

    # epsilon等于1,采用离线学习
    def get_epsilon_greedy_action(self, state, epsilon=1):
        x = self.get_feature(state)  # 特征向量
        with torch.no_grad():
            # 输出所有的动作价值
            out_put = self.eval_model(x.reshape(-1, 2))
        # 选取最优动作
        best_action = torch.argmax(out_put).item()

        if random.random() < epsilon * (self.action_nums - 1) / self.action_nums:
            actions = list(self.idx_to_action.keys())
            actions.remove(best_action)
            return random.choice(actions)
        return best_action

    def sample_data(self, batch_size=32):
        # 随机采样
        data = random.sample(self.datas, batch_size)
        # 当前状态
        cur_states = torch.stack([self.get_feature(i[0])[0] for i in data], dim=0)
        # 当前动作
        cur_actions = torch.tensor([i[1] for i in data])
        # 奖励
        rewards = torch.tensor([i[2] for i in data])
        # 下一个状态
        next_states = torch.stack([self.get_feature(i[3])[0] for i in data], dim=0)
        return cur_states, cur_actions, rewards, next_states

    def update_model(self, epoch, graph, start_state=None, gama=0.9):
        # 记录损失
        loss_cache = []
        for i in range(epoch):
            # 更新数据
            self.update_data(graph, start_state)
            loss = 0
            for j in range(200):
                # 采样数据
                cur_states, cur_actions, rewards, next_states = self.sample_data()
                # 当前状态价值
                value = self.eval_model(cur_states).gather(1, cur_actions.reshape(-1, 1))
                with torch.no_grad():
                    # 下一个状态价值
                    target_value = self.target_model(next_states).max(dim=1)[0].reshape(-1, 1)
                # 目标价值
                target_value = rewards.reshape(-1, 1) + gama * target_value
                # 计算损失
                loss = self.loss_fn(value, target_value)
                # 梯度清零
                self.optimizer.zero_grad()
            loss_cache.append(loss.item())
            # i 每增加 5 更新一次目标网络模型参数
            if (i + 1) % 5 == 0:
                # 更新目标网络
                self.target_model.load_state_dict(self.eval_model.state_dict())

            print(f"epoch:{i + 1}, loss:{loss.item()}")
        # 打印策略
        self.show_policy(graph)
        # 保存模型参数
        torch.save(self.eval_model.state_dict(), "model.pkl")
        _, axs = plt.subplots(1, 1, figsize=(4, 3), dpi=150)
        self.mplot(list(range(len(loss_cache))), loss_cache, axs, 'b', 'loss change', 'epoch', 'loss', ['loss curve'])
        # plt.savefig("./2.png", bbox_inches='tight')  # 这里有横轴截断问题
        plt.tight_layout()
        plt.show()

    # 加载模型
    def load_model(self, path=None):
        assert path is not None, "path is None!!!"
        self.eval_model.load_state_dict(torch.load(path))

    def show_policy(self, graph=None):
        assert graph is not None, "graph is None!!!"
        # 打印策略
        with torch.no_grad():
            for i in range(self.r):
                for j in range(self.c):
                    if graph[i][j] != '●':
                        print(self.idx_to_action[self.get_epsilon_greedy_action((i, j), epsilon=0)], end=" ")
                    else:
                        print('●', end=" ")
                print()


if __name__ == "__main__":
    # 定义地图,□ 表示可以正常走的,× 表示 forbidden area,● 表示终点
    graph = [['□', '□', '□', '□', '□'],
             ['□', '×', '×', '□', '□'],
             ['□', '□', '×', '□', '□'],
             ['□', '×', '●', '×', '□'],
             ['□', '×', '□', '□', '□']]
    r = len(graph)
    c = len(graph[0])

    start_state = (0, 0)
    end_point = (3, 2)  # 改地图的时候注意改终点坐标位置

    """DQN"""
    dqn_iterator = DQN(r, c, 2, 64, 5e-3)
    dqn_iterator.update_model(5000, graph)
    # dqn_iterator.load_model("./DQN_model/model_v1.pkl")  # 加载模型
    # dqn_iterator.load_model("./DQN_model/model_v2.pkl")
    dqn_iterator.show_policy(graph)
举一些例子:


这些例子说明了就算再强大的算法也得有好的数据,没有好的数据还是不行的。
Summary
就不总结了,就是前面各个章节的内容,看看标题就能回忆起来。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献5条内容

所有评论(0)