cuda第一次计算耗时_nms的cuda实现解析
代码
https://github.com/rbgirshick/py-faster-rcnn/blob/master/lib/nms/nms_kernel.cugithub.comnms是不太好在cuda上实现的,因为nms的计算过程是有依赖关系的,比如A,B,C三个置信度由大到小的检测框,如果IOU(A,B)大于阈值,那么BC的IOU则不必再计算了,由于依赖关系会限制cuda的发挥,因此cuda实现中,所有的box之间的IOU都是需要计算的,不过有的结果是不需要的。
代码中nms的输出是长度为
 的unsigned long long的数组dev_mask,dev_mask是以每一个box为基准计算出来的所有boxes是否丢弃的结果,本来dev_mask应该是一个
 的bool类型二维数组,其中true代表需要删除,false代表保留,第一行表示以置信度最高的box为基准,和其他box计算的结果;第二行则是以置信度次高的box为基准,和其他box计算的结果。有了dev_mask之后可以通过行间的或运算获得最终的mask结果
bool dev_mask[boxes_num][boxes_num];
// nms kernel ...
bool mask[boxes_num];
for (int i = 0; i < boxes_num; ++i) {
  // 如果当前的基准box被删除,则不用计算当前的结果
  if (mask[i]) continue;
  // 前面的不用算,因为都是置信度高于当前基准box的
  for (int j = i + 1; j < boxes_num; ++j) {
    mask[boxes_num] |= dev_mask[i][j];
  }
}
作者用unsigned long long则是将64位的unsigned long long的每一个bit当做一个box的结果,bit位1则删除,为0则保留,dev_mask变为
的大小再来看看作者的实现
  int const threadsPerBlock = sizeof(unsigned long long) * 8;
  const int col_blocks = DIVUP(boxes_num, threadsPerBlock);
  std::vector<unsigned long long> remv(col_blocks);
  memset(&remv[0], 0, sizeof(unsigned long long) * col_blocks);
  int num_to_keep = 0;
  for (int i = 0; i < boxes_num; i++) {
    // 计算当前box的索引
    int nblock = i / threadsPerBlock;
    int inblock = i % threadsPerBlock;

    // 如果当前box没有被删除,即remv[nblock]的inblock位为0
    if (!(remv[nblock] & (1ULL << inblock))) {
      keep_out[num_to_keep++] = i;
      // p为当前box结果数组的首地址
      unsigned long long *p = &mask_host[0] + i * col_blocks;
      // nblock前面的remv不用更新
      for (int j = nblock; j < col_blocks; j++) {
        remv[j] |= p[j];
      }
    }
  }
再来看看nms kernel的实现,首先kernel的grid是2D的,block是1D的
  dim3 blocks(DIVUP(boxes_num, threadsPerBlock),
              DIVUP(boxes_num, threadsPerBlock));
  dim3 threads(threadsPerBlock);
  nms_kernel<<<blocks, threads>>>(boxes_num,
                                  nms_overlap_thresh,
                                  boxes_dev,
                                  mask_dev);
其中每一个thread计算dev_mask中的一个值,可以通过一个示意图更好地理解并行的逻辑
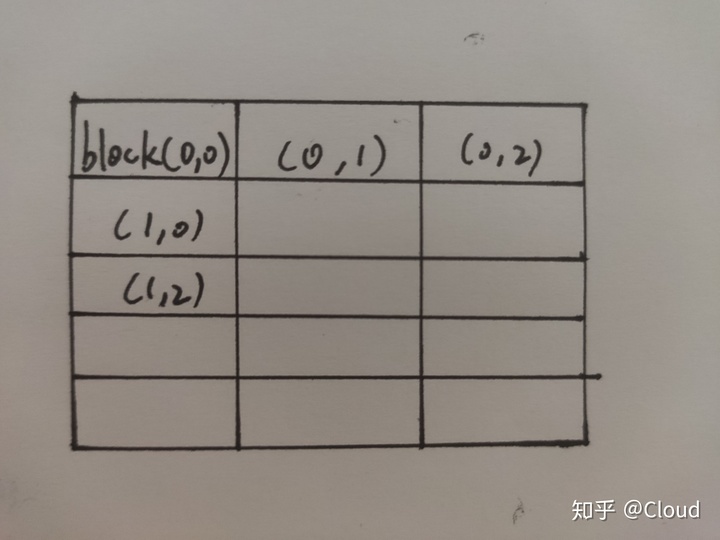
其中第i行的block计算以第
 个box为基准的dev_mask结果,举例如下
block(0,0) 计算[0,threadsPerBlock](基准) x [0,threadsPerBlock](其他)的dev_mask
block(0,1) 计算[0,threadsPerBlock] x [threadsPerBlock,threadsPerBlock*2]的dev_mask
block(0,2) 计算[0,threadsPerBlock] x [threadsPerBlock*2,threadsPerBlock*3]的dev_mask
...
block(i,j) 计算
[i*threadsPerBlock, (i+1)*threadsPerBlock](基准)x [j*threadsPerBlock,(j+1)*threadsPerBlock](其他)的devmask结果,如果把dev_mask看成二维数组更好理解,dev_mask的第一维是基准box的索引,第二维是其他box的索引
更新:
从更简单的形式开始分析会更好理解,比如只有一个block,block的大小是2D的,为nxn,n为检测框数量,假设n=6,并行逻辑如下图
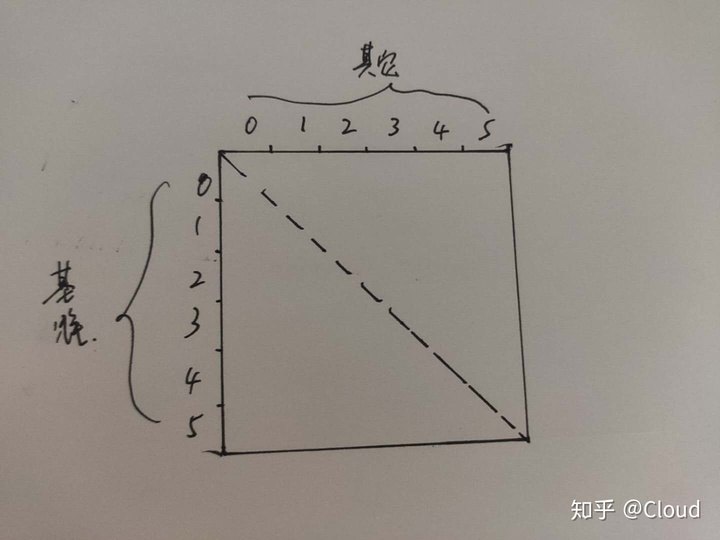
每个thread计算一对box的IOU(只用计算上三角部分)作者的实现则是将6x6的分成3x3的小block,每个block的thread为2,即
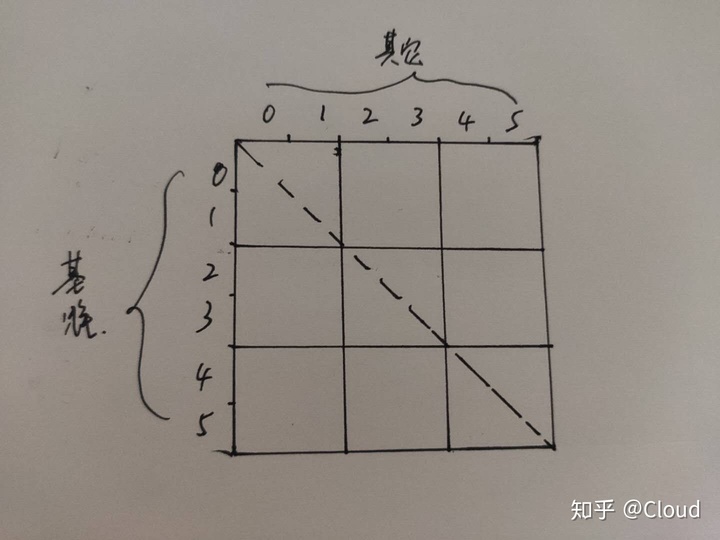
这样做的好处是减少CUDA资源占用,原来需要36个thread,现在只要18个thread(每个thread要计算2对box的IOU)并且每个小的block的其他box可以存入共享内存,减少全局内存的访问
__global__ void nms_kernel(const int n_boxes, const float nms_overlap_thresh,
                           const float *dev_boxes, unsigned long long *dev_mask) {
  // row_start表示当前基准box的起始block索引
  // col_start表示当前其他box的起始block索引
  const int row_start = blockIdx.y;
  const int col_start = blockIdx.x;

  // 如果其他box比基准box的置信度大则不用计算
  // if (row_start > col_start) return;

  // row_size是当前block基准box的大小
  // col_size是当前block其他box的大小
  // 因为griddim的大小经过向上取整,所以有些thread是不用计算的
  const int row_size =
        min(n_boxes - row_start * threadsPerBlock, threadsPerBlock);
  const int col_size =
        min(n_boxes - col_start * threadsPerBlock, threadsPerBlock);

  // 每个block内的thread加载对应的box进入共享内存
  // 共享内存访问速度比全局内存快很多,减少了耗时的全局内存访问
  __shared__ float block_boxes[threadsPerBlock * 5];
  if (threadIdx.x < col_size) {
    block_boxes[threadIdx.x * 5 + 0] =
        dev_boxes[(threadsPerBlock * col_start + threadIdx.x) * 5 + 0];
    block_boxes[threadIdx.x * 5 + 1] =
        dev_boxes[(threadsPerBlock * col_start + threadIdx.x) * 5 + 1];
    block_boxes[threadIdx.x * 5 + 2] =
        dev_boxes[(threadsPerBlock * col_start + threadIdx.x) * 5 + 2];
    block_boxes[threadIdx.x * 5 + 3] =
        dev_boxes[(threadsPerBlock * col_start + threadIdx.x) * 5 + 3];
    block_boxes[threadIdx.x * 5 + 4] =
        dev_boxes[(threadsPerBlock * col_start + threadIdx.x) * 5 + 4];
  }
  __syncthreads();

  if (threadIdx.x < row_size) {
    // 计算当前基准box的索引
    const int cur_box_idx = threadsPerBlock * row_start + threadIdx.x;
    const float *cur_box = dev_boxes + cur_box_idx * 5;
    int i = 0;
    unsigned long long t = 0;
    int start = 0;
    // 如果相等,基准box和其他box是同样范围的,因此基准box不需要和置信度大于自己的其他box计算
    if (row_start == col_start) {
      start = threadIdx.x + 1;
    }
    // 遍历其他box,计算当前基准box和其他box的IOU,如果大于nms阈值,则置对应的位为1,即删除
    for (i = start; i < col_size; i++) {
      if (devIoU(cur_box, block_boxes + i * 5) > nms_overlap_thresh) {
        t |= 1ULL << i;
      }
    }
    const int col_blocks = DIVUP(n_boxes, threadsPerBlock);
    // 结果写入dev_mask
    dev_mask[cur_box_idx * col_blocks + col_start] = t;
  }
}
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)