强化学习的入门模型:多臂老虎机
强化学习的入门模型:多臂老虎机(上)(上下同篇)
参考教材:Reinforcement Learning: An Introduction (Sutton & Barto, 2nd Ed.)
1. 引言:智慧源于“试错”
在深入那些复杂的神经网络和算法之前,我们先思考一个最原始的问题:智能(Intelligence)究竟是如何产生的?
当我们还是婴儿时,没有人给我们写好一本“走路说明书”,告诉我们每一步肌肉该收缩多少牛顿。我们是通过一次次的尝试(Trial)——摔倒、爬起、再摔倒——并根据结果的反馈(是疼痛还是前进了),逐渐掌握了平衡的技巧。
这种 “通过与环境交互,在试错中学习” 的过程,就是 强化学习(Reinforcement Learning, RL) 的灵魂。
强化学习 vs. 监督学习
很多同学接触AI是从“监督学习”(Supervised Learning)开始的(比如猫狗分类)。
- 监督学习是指导性的(Instructive):老师直接告诉你“这道题选C是对的”,“这个数字是9(MNIST)”。
- 强化学习是评价性的(Evaluative):没人告诉你标准答案。你投了一个篮,环境只告诉你“进了(+2分)”或者“没进(0分)”。至于刚才手肘是不是应该抬高一点?这需要你自己去试。
为了研究这种纯粹的“试错学习”,我们需要剥离掉所有复杂的因素(比如延迟奖励、状态转移,这些我们以后再接触),只保留最核心的矛盾。于是,我们来到了强化学习的新手村——多臂老虎机 (Multi-armed Bandit)。
2. 场景设定:赌场里的决策难题
🎰 什么是 K-臂老虎机?
想象你站在一家赌场里,面前有一台奇怪的老虎机。它不是只有一个拉杆,而是有 kkk 个拉杆(比如 k=10k=10k=10)。
- 动作 (Action):每一轮,你可以选择拉动其中一个拉杆。
- 奖励 (Reward):拉动后,你会得到一定数量的金币。
- 规则:
- 每个拉杆吐钱的概率分布不一样。有的拉杆很大方(平均给10块),有的很吝啬(平均给1块)。
- 关键问题:你完全不知道哪个好,哪个坏。
你的目标:在有限的次数内(比如拉1000次),通过策略赢走尽可能多的金币。
3. 数学形式化:像科学家一样思考
为了解决这个问题,我们需要建立数学模型。这是学习RL必须掌握的第一组符号:
假设我们在第 ttt 步进行选择:
- AtA_tAt:我们在 ttt 时刻选择的动作(拉杆)。
- RtR_tRt:我们在 ttt 时刻获得的奖励。
(牢记他们!这是强化学习最基本的概念!)
(1) 上帝视角的真实价值:q∗(a)q_*(a)q∗(a)
如果我们是上帝,我们知道每个拉杆 aaa 的真实价值,即它带来的期望奖励:
q∗(a)≐E[Rt∣At=a] q_*(a) \doteq \mathbb{E}[R_t \mid A_t = a] q∗(a)≐E[Rt∣At=a]
如果知道这个值,策略就很简单:永远只拉 q∗(a)q_*(a)q∗(a) 最大的那个杆。
(2) 凡人的估计价值:Qt(a)Q_t(a)Qt(a)
现实中我们不知道真值,只能根据历史经验来估计:
Qt(a)≈q∗(a) Q_t(a) \approx q_*(a) Qt(a)≈q∗(a)
最直观的估计方法就是求平均值(Sample-Average Method):
Qt(a)≐动作 a 历史奖励的总和动作 a 被选中的次数 Q_t(a) \doteq \frac{\text{动作 } a \text{ 历史奖励的总和}}{\text{动作 } a \text{ 被选中的次数}} Qt(a)≐动作 a 被选中的次数动作 a 历史奖励的总和
根据大数定律,只要尝试次数足够多,Qt(a)Q_t(a)Qt(a) 最终会收敛到 q∗(a)q_*(a)q∗(a)。
4. 核心矛盾:探索 vs. 利用
有了估计值 Qt(a)Q_t(a)Qt(a),我们该如何决策?这引出了RL领域最著名的探索与利用权衡 (Exploration-Exploitation Trade-off)。
-
利用 (Exploitation):
- 做法:永远选当前估计分 Qt(a)Q_t(a)Qt(a) 最高的那个拉杆。
- 心态:“我相信我现在的经验是准确的,我要落袋为安。”
- 风险:如果一开始运气不好,那个其实能赚大钱的拉杆只给了你1块钱,你可能就会误以为它是个烂拉杆,从此再也不碰它,陷入局部最优。
-
探索 (Exploration):
- 做法:偶尔选一些估计分低的、或者没试过的拉杆。
- 心态:“虽然这看起来会亏钱,但我希望能收集更多信息,万一发现了新大陆呢?”
解决方案:ε\varepsilonε-Greedy 算法
为了平衡两者,我们引入一个参数 ε\varepsilonε(比如 0.1):
- 掷一枚硬币(生成 0~1 的随机数)。
- 如果随机数 >ε> \varepsilon>ε:利用(选当前最好的)。
- 如果随机数 <ε< \varepsilon<ε:探索(闭眼随机选一个)。
即设置一个比例,比如设有10%的概率去尝试拉下别的杆,剩下90%只拉当前测下来表现最好的杆。
但这是不是一个好策略呢?接下来我们用代码来模拟一下~
5. 算法实现:增量更新公式
在写代码前,还有一个工程问题:如何高效计算平均值?
如果玩了100万次,我们需要存储100万个数字来求平均吗?不需要。我们有一个极其优雅的增量更新公式。
设 QnQ_nQn 是前 n−1n-1n−1 次的平均值,第 nnn 次奖励为 RnR_nRn,则新平均值 Qn+1Q_{n+1}Qn+1 为:
Qn+1=1n∑i=1nRi =Qn+1n[Rn−Qn] \begin{aligned} Q_{n+1} &= \frac{1}{n} \sum_{i=1}^{n} R_i \ &= Q_n + \frac{1}{n} [ R_n - Q_n ] \end{aligned} Qn+1=n1i=1∑nRi =Qn+n1[Rn−Qn]
这对应了强化学习通用的更新范式:
NewEstimate←OldEstimate+StepSize×[Target−OldEstimate] \text{NewEstimate} \leftarrow \text{OldEstimate} + \text{StepSize} \times [\text{Target} - \text{OldEstimate}] NewEstimate←OldEstimate+StepSize×[Target−OldEstimate]
6. 代码实战:Python 模拟赌场
Talk is cheap, show me the code. 我们用 Python 来构建这个环境,并对比不同策略的效果。
import numpy as np
import matplotlib.pyplot as plt

class Bandit:
    def __init__(self, k=10, epsilon=0.0):
        self.k = k                  # 拉杆数量
        self.epsilon = epsilon      # 探索概率
        self.time_step = 0

        # 1. 初始化真实价值 (上帝视角)
        # 每个拉杆的真实平均奖励服从正态分布 N(0, 1)
        self.q_true = np.random.randn(self.k)

        # 2. 初始化估计价值 (玩家视角)
        self.q_estimation = np.zeros(self.k)
        self.action_count = np.zeros(self.k)

    def choose_action(self):
        """核心策略:Epsilon-Greedy"""
        if np.random.rand() < self.epsilon:
            # 探索:随机选一个
            return np.random.randint(self.k)
        else:
            # 利用:选估计值最高的
            # 注意:如果多个最大值,np.argmax只返回第一个,
            # 更严谨的做法是随机打破平局,这里简化处理
            return np.argmax(self.q_estimation)

    def step(self, action):
        """执行动作,获得奖励,更新认知"""
        # 1. 生成奖励:真实价值 + 噪声 N(0, 1)
        reward = np.random.randn() + self.q_true[action]

        # 2. 更新计数
        self.time_step += 1
        self.action_count[action] += 1

        # 3. 增量更新公式 Q(a) <- Q(a) + 1/n * (R - Q(a))
        alpha = 1.0 / self.action_count[action]
        self.q_estimation[action] += alpha * (reward - self.q_estimation[action])

        return reward

def run_experiment(epsilon, steps=1000, runs=2000):
    """
    运行实验
    steps: 一局玩多少次
    runs: 重复玩多少局 (为了消除随机性取平均)
    """
    avg_rewards = np.zeros(steps)

    for i in range(runs):
        bandit = Bandit(epsilon=epsilon)
        for t in range(steps):
            action = bandit.choose_action()
            reward = bandit.step(action)
            avg_rewards[t] += reward

    return avg_rewards / runs

# --- 开始实验 ---
print("正在模拟 2000 局游戏,请稍候...")

# 1. 贪婪策略 (epsilon = 0)
greedy_rewards = run_experiment(epsilon=0)

# 2. 小幅探索 (epsilon = 0.01)
eps_001_rewards = run_experiment(epsilon=0.01)

# 3. 适度探索 (epsilon = 0.1)
eps_01_rewards = run_experiment(epsilon=0.1)

# --- 绘图 ---
plt.figure(figsize=(12, 6))
plt.plot(greedy_rewards, label="Greedy (e=0)", color='red')
plt.plot(eps_001_rewards, label="Epsilon=0.01", color='blue')
plt.plot(eps_01_rewards, label="Epsilon=0.1", color='green')

plt.xlabel('Steps')
plt.ylabel('Average Reward')
plt.title('Performance of Epsilon-Greedy Strategies')
plt.legend()
plt.grid(True)
plt.show()
7. 结果分析与总结
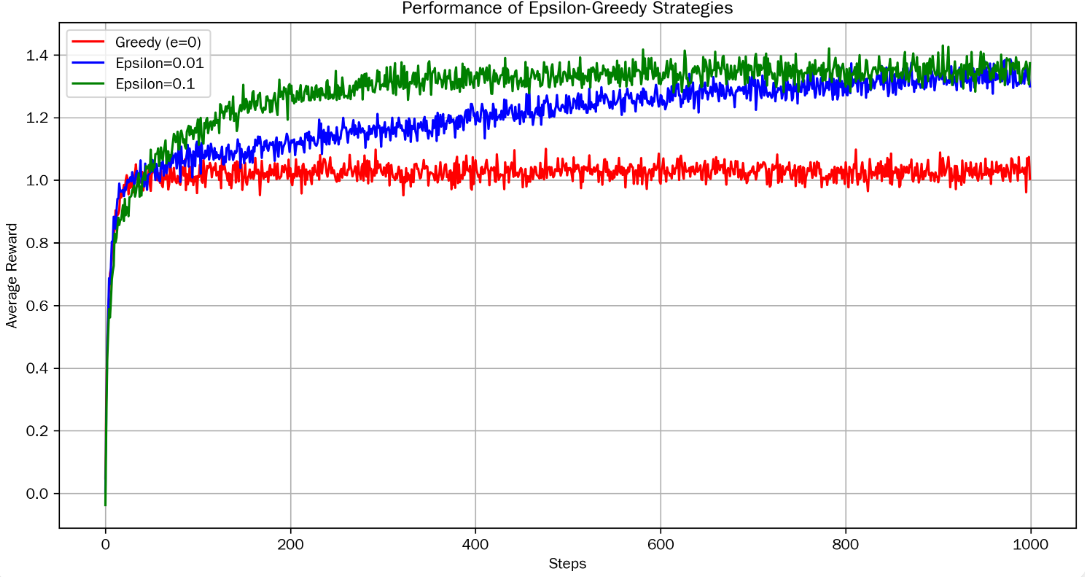
运行上述代码,你将得到一张经典的对比图:
-
红线 (Greedy, ε=0\varepsilon=0ε=0):
- 表现:起步很快,但迅速卡在一个较低的水平。
- 原因:它太急功近利,经常锁死在一个“还凑合”的拉杆上,错失了真正的最优解。
-
绿线 (ε=0.1\varepsilon=0.1ε=0.1):
- 表现:虽然初期因为经常瞎选而表现一般,但它最终收敛到了最高的平均奖励。
- 原因:适度的探索是发现最优解的必要成本。
💡 关键结论
通过这几十行代码,我们量化了一个人生哲理:完全不犯错(不探索),往往意味着你永远无法做到最好。
思考:
ε\varepsilonε-Greedy 策略虽然有效,但它有一个缺点:哪怕它已经明知哪个拉杆最差,它还是会以固定的概率去选它(盲目探索)。有没有一种更聪明的探索方式,优先去探索那些“潜力最大”或者“最不确定”的拉杆呢? 这就引出了接下来我们将要介绍的进阶介绍:
强化学习的入门模型:多臂老虎机(下)
前置知识:多臂老虎机定义,ϵ\epsilonϵ-Greedy 算法
1. 引言:量化“好奇心”的百年战争
在上一篇文章中,我们介绍了强化学习的“Hello World”——多臂老虎机 (Multi-Armed Bandit, MAB) 问题,并实现了一个最基础的策略:ϵ\epsilonϵ-Greedy。
ϵ\epsilonϵ-Greedy 的逻辑非常简单:扔个骰子,要么贪婪(利用),要么瞎选(探索)。虽然有效,但在科学家眼里,它充满了 “智力上的懒惰” :
- 盲目性:它探索时一视同仁。面对一个还没试过的潜力股和一个已经试过100次确实很烂的垃圾股,它的探索概率竟然是一样的。
- 非最优:除非手动调节 ϵ\epsilonϵ,否则它永远无法收敛,永远在以固定的概率犯错。
为了解决这些问题,统计学家和计算机科学家们进行了长达半个多世纪的探索,演化出了四大流派。如果不理解这些流派,你就无法真正理解现代深度强化学习(Deep RL)中那些复杂的 Actor-Critic 或 PPO 算法是从何而来的。
今天,我们将带上数学显微镜,解剖这四条进化路线。
2. 流派一:确定性乐观派 (Deterministic Optimism)
代表算法:UCB (Upper Confidence Bound)
这个流派的核心哲学是:“面对不确定性,保持理性的乐观。” (Optimism in the Face of Uncertainty)
2.1 直觉:为什么“盲目自信”是有用的?
想象你在评价一家餐厅。
- 餐厅 A:你去过 10 次,平均分 0.7。你非常确定它的水平就在 0.7 左右。
- 餐厅 B:你只去过 1 次,那次体验不好,打了 0.4 分。
如果用贪婪策略(只看平均分),你会永远去餐厅 A。但理性的探索者会想:“餐厅 B 我只试了一次,样本太少,误差可能很大。也许它真实的水平是 0.9,只是我第一次运气不好呢?”
UCB 的核心逻辑是:我们不仅看平均分(估计值),还要看那个分数的“上限”可能在哪里。
- 对于不确定的餐厅 B,我们假设它可能是极好的(赋予一个很高的置信上限)。
- 如果你选了 B,发现它确实烂,那它的“不确定性”会减小,上限也会塌缩,下次你就死心了。
- 如果你选了 B,发现它其实很好,那你不仅消除了不确定性,还发现了一个新宝藏。
这种 “先假设你是最好的,直到数据证明你不是” 的策略,就是 UCB。
2.2 数学引擎:从霍夫丁不等式到 UCB
这一段是本章的硬核部分,我们将一步步推导出那个根号公式的由来。
我们的目标是找到一个增量 Ut(a)U_t(a)Ut(a),使得真实价值 q∗(a)q_*(a)q∗(a) 有极大的概率低于 Qt(a)+Ut(a)Q_t(a) + U_t(a)Qt(a)+Ut(a)。这个 Qt(a)+Ut(a)Q_t(a) + U_t(a)Qt(a)+Ut(a) 就是我们要寻找的上置信界。
第一步:引入霍夫丁不等式 (Hoeffding’s Inequality)
这是一个统计学定律,用来衡量“样本均值”偏离“真实均值”的概率。
设 X1,…,XnX_1, \dots, X_nX1,…,Xn 是在 [0,1][0, 1][0,1] 之间的随机变量,则样本均值 Xˉn\bar{X}_nXˉn 偏离真实均值 μ\muμ 的概率边界为:
P(μ>Xˉn+U)≤e−2nU2 P(\mu > \bar{X}_n + U) \le e^{-2nU^2} P(μ>Xˉn+U)≤e−2nU2
在我们的赌博机场景中:
- μ\muμ 是真实价值 q∗(a)q_*(a)q∗(a)。
- Xˉn\bar{X}_nXˉn 是当前的估计均值 Qt(a)Q_t(a)Qt(a)。
- nnn 是该动作被选中的次数 Nt(a)N_t(a)Nt(a)。
- UUU 是我们想求的加分项 Ut(a)U_t(a)Ut(a)。
第二步:设定犯错概率
我们希望“真实值超过上限”这件事发生的概率极小。设这个概率为 ppp。
e−2Nt(a)Ut(a)2=p e^{-2N_t(a) U_t(a)^2} = p e−2Nt(a)Ut(a)2=p
我们希望随着时间 ttt 的推移,我们的置信度越来越高(犯错概率 ppp 越来越小)。一个常见的设定是令 p=t−4p = t^{-4}p=t−4(即随时间以 4 次方速度衰减)。
e−2Nt(a)Ut(a)2=t−4 e^{-2N_t(a) U_t(a)^2} = t^{-4} e−2Nt(a)Ut(a)2=t−4
第三步:求解 Ut(a)U_t(a)Ut(a)
现在我们解这个方程,求出 Ut(a)U_t(a)Ut(a):
- 两边取自然对数:
−2Nt(a)Ut(a)2=ln(t−4)=−4lnt -2N_t(a) U_t(a)^2 = \ln (t^{-4}) = -4 \ln t −2Nt(a)Ut(a)2=ln(t−4)=−4lnt - 消去负号并除以系数:
Ut(a)2=4lnt2Nt(a)=2lntNt(a) U_t(a)^2 = \frac{4 \ln t}{2N_t(a)} = \frac{2 \ln t}{N_t(a)} Ut(a)2=2Nt(a)4lnt=Nt(a)2lnt - 开平方:
Ut(a)=2lntNt(a) U_t(a) = \sqrt{\frac{2 \ln t}{N_t(a)}} Ut(a)=Nt(a)2lnt
第四步:引入调节参数 ccc
在实际应用中,我们可能不需要 t−4t^{-4}t−4 这么严格的收敛速度,或者奖励范围不完全在 [0,1][0,1][0,1] 之间。因此,我们将系数(如 2\sqrt{2}2)抽象为一个超参数 ccc。
这就得到了 Sutton 书中的经典公式:
At=argmaxa[Qt(a)⏟∗Exploit: 均值+clntNt(a)⏟∗Explore: 不确定性] A_t = \underset{a}{\text{argmax}} \left[ \underbrace{Q_t(a)}*{\text{Exploit: 均值}} + \underbrace{c \sqrt{\frac{\ln t}{N_t(a)}}}*{\text{Explore: 不确定性}} \right] At=aargmaxQt(a)∗Exploit: 均值+cNt(a)lnt∗Explore: 不确定性
2.3 深度解析:公式在做什么?
让我们盯着这个公式,看看它是如何自动平衡探索与利用的:
-
分母 Nt(a)N_t(a)Nt(a) (被选次数):
- 如果你总是选动作 A,它的 Nt(A)N_t(A)Nt(A) 会变得很大。
- 导致 …\sqrt{\dots}… 这一项趋近于 0。
- 结果:对于熟悉的动作,UCB 退化为贪婪算法(只看均值)。
-
分子 lnt\ln tlnt (总时间):
- 如果你一直不选动作 B,它的 Nt(B)N_t(B)Nt(B) 保持不变。
- 但是总时间 ttt 在增加,所以 lnt\ln tlnt 在缓慢变大。
- 结果:只要一个动作很久没被宠幸,它的加分项就会慢慢膨胀,直到有一天超过当前的“第一名”,强迫 Agent 再次去探索它。
2.4 科学意义:为什么它比 ϵ\epsilonϵ-Greedy 强?
- ϵ\epsilonϵ-Greedy 的遗憾(Regret,即你损失的钱)是线性的 O(T)O(T)O(T)。因为它直到世界末日,还在以固定的概率瞎选。
- UCB 的遗憾是对数级的 O(logT)O(\log T)O(logT)。这是数学上证明的理论极限。这意味着随着时间推移,UCB 犯错的次数会越来越少,最终它可以无限逼近最优策略,而不像 ϵ\epsilonϵ-Greedy 那样永远只有“次优”的表现。
3. 流派二:偏好梯度派 (Gradient-Based Optimization)
代表算法:Gradient Bandits
这个流派完全抛弃了“估计动作价值 Q(a)Q(a)Q(a)”的传统思路。他们提出一个更根本的问题:
“既然我的最终目的是选择最好的动作,我为什么要费劲去估计每一个动作具体值多少钱呢?我直接学习‘应该以多大的概率选它’不就行了吗?”
这是现代 Deep RL 中 Policy Gradient (策略梯度) 方法的鼻祖。
3.1 核心逻辑:从价值到偏好
我们不再维护 QQQ 值,而是为每个动作维护一个数值偏好 (Preference) Ht(a)H_t(a)Ht(a)。
- Ht(a)H_t(a)Ht(a) 本身的大小没有物理意义(它不是奖励)。
- 重要的是它相对于其他动作的大小。
为了把这些无界的偏好值转化为合法的概率分布(和为 1,且非负),我们使用神经网络中标志性的 Softmax 分布:
πt(a)≐P(At=a)=eHt(a)∑b=1keHt(b) \pi_t(a) \doteq P(A_t=a) = \frac{e^{H_t(a)}}{\sum_{b=1}^k e^{H_t(b)}} πt(a)≐P(At=a)=∑b=1keHt(b)eHt(a)
这里 πt(a)\pi_t(a)πt(a) 就是我们的策略 (Policy):在 ttt 时刻选择动作 aaa 的概率。
3.2 数学引擎:随机梯度上升 (Stochastic Gradient Ascent)
这一段我们将展示那个看似复杂的更新公式是如何像魔术一样被推导出来的。
第一步:定义目标
我们的目标非常明确:最大化总期望奖励。
设目标函数 J(Ht)J(H_t)J(Ht) 为当前策略下的期望收益:
J(Ht)≐E[Rt]=∑xπt(x)q∗(x) J(H_t) \doteq \mathbb{E}[R_t] = \sum_{x} \pi_t(x) q_*(x) J(Ht)≐E[Rt]=x∑πt(x)q∗(x)
其中 q∗(x)q_*(x)q∗(x) 是动作 xxx 的真实价值(虽然我们不知道,但推导时可以假设存在)。
第二步:梯度上升
为了最大化 JJJ,我们需要让参数 Ht(a)H_t(a)Ht(a) 沿着梯度的方向移动:
Ht+1(a)=Ht(a)+α∂E[Rt]∂Ht(a) H_{t+1}(a) = H_t(a) + \alpha \frac{\partial \mathbb{E}[R_t]}{\partial H_t(a)} Ht+1(a)=Ht(a)+α∂Ht(a)∂E[Rt]
第三步:对数似然技巧 (Log-Likelihood Trick) —— 核心魔法
经过一系列微积分运算(利用 ∂π∂H\frac{\partial \pi}{\partial H}∂H∂π 的性质),我们可以推导出梯度的解析形式。这里省略中间繁琐的求导,直接展示那个著名的结论:
∂E[Rt]∂Ht(a)=E[(Rt−Rˉt)∂lnπt(At)∂Ht(a)] \frac{\partial \mathbb{E}[R_t]}{\partial H_t(a)} = \mathbb{E} \left[ (R_t - \bar{R}_t) \frac{\partial \ln \pi_t(A_t)}{\partial H_t(a)} \right] ∂Ht(a)∂E[Rt]=E[(Rt−Rˉt)∂Ht(a)∂lnπt(At)]
这就导出了我们在代码中使用的随机梯度更新公式:
Ht+1(a)=Ht(a)+α(Rt−Rˉ∗t)(I∗a=At−πt(a)) H_{t+1}(a) = H_t(a) + \alpha (R_t - \bar{R}*t)(\mathbb{I}*{a=A_t} - \pi_t(a)) Ht+1(a)=Ht(a)+α(Rt−Rˉ∗t)(I∗a=At−πt(a))
3.3 深度解析:直观理解更新公式
让我们抛开微积分,用人话看看这个公式到底在干什么。
新偏好=旧偏好+步长×(Rt−Rˉ∗t)⏟∗表现评价×(I∗a=At−πt(a))⏟∗方向调节 \text{新偏好} = \text{旧偏好} + \text{步长} \times \underbrace{(R_t - \bar{R}*t)}*{\text{表现评价}} \times \underbrace{(\mathbb{I}*{a=A_t} - \pi_t(a))}*{\text{方向调节}} 新偏好=旧偏好+步长×(Rt−Rˉ∗t)∗表现评价×(I∗a=At−πt(a))∗方向调节
这个公式把动作分为了两类进行更新:
情况 A:对于刚才被选中的动作 (a=Ata = A_ta=At)
- 这里的 Ia=At=1\mathbb{I}_{a=A_t} = 1Ia=At=1。
- 公式变为:Hnew=Hold+α(Rt−Rˉt)(1−πt)H_{new} = H_{old} + \alpha (R_t - \bar{R}_t)(1 - \pi_t)Hnew=Hold+α(Rt−Rˉt)(1−πt)。
- 如果 Rt>RˉtR_t > \bar{R}_tRt>Rˉt (表现优于平均):第一项是正的。我们增加该动作的偏好 HHH。即:“刚才这把赢了,下次还选它!”
- 如果 Rt<RˉtR_t < \bar{R}_tRt<Rˉt (表现劣于平均):第一项是负的。我们减少该动作的偏好 HHH。即:“刚才这把亏了,下次少选它。”
情况 B:对于刚才没被选中的动作 (a≠Ata \neq A_ta=At)
- 这里的 Ia=At=0\mathbb{I}_{a=A_t} = 0Ia=At=0。
- 公式变为:Hnew=Hold−α(Rt−Rˉt)πtH_{new} = H_{old} - \alpha (R_t - \bar{R}_t)\pi_tHnew=Hold−α(Rt−Rˉt)πt。
- 这是一个反向操作。如果被选中的那个家伙表现很好(RtR_tRt 高),我们就降低其他没被选中的人的偏好。
- 这体现了概率的归一化性质:既然大家都想选 A,那留给 B、C、D 的概率自然就要减少。
3.4 关键点:基线 (Baseline) 的科学意义
公式中的 Rˉt\bar{R}_tRˉt(历史平均奖励)不仅仅是一个参考线,它有着深刻的数学作用。
-
问题背景:
如果赌场里所有拉杆的奖励都是正数(比如 A 给 1000 分,B 给 10 分)。如果没有基线,RtR_tRt 永远是正的,导致所有动作的偏好 HHH 都在不停地增加。虽然相对大小可能保持,但这会让数值极其不稳定。 -
方差缩减 (Variance Reduction):
引入 Rˉt\bar{R}_tRˉt 后,我们将奖励中心化了。- 比平均好的动作,梯度为正。
- 比平均差的动作,梯度为负。
数学上可以证明:引入任何不依赖于动作 aaa 的基线 btb_tbt,都不会改变梯度的期望(即不会学歪),但能极大地降低梯度的方差。
-
启示:
这一思想直接启发了后来深度强化学习中著名的 Actor-Critic 算法。在那里面,Critic 网络的作用本质上就是在这个 Baseline,告诉 Actor:“你刚才那一步做得是比平时好,还是比平时差?”
4. 流派三:贝叶斯流派 (The Bayesian Path)
代表算法:汤普森采样 (Thompson Sampling)
UCB 是“构建边界”,而贝叶斯流派则是“模拟上帝掷骰子”。这是目前推荐系统(如今日头条、Netflix)中最主流的算法之一。
4.1 核心哲学:概率匹配 (Probability Matching)
如果你不确定拉杆 A 是好是坏,UCB 会给它一个固定的加分。而贝叶斯主义者说:“你的认知本身就是一个概率分布。”
- 如果数据很少,你心中的拉杆 A 价值分布是一个宽宽的胖曲线(可能是 0.1,也可能是 0.9)。
- 如果数据很多,分布就会变成一个尖尖的瘦曲线(确定是 0.5 左右)。
4.2 算法流程 (Beta-Bernoulli 模型)
假设奖励是 0 或 1(点击/不点击)。我们用 Beta 分布 Beta(α,β)\text{Beta}(\alpha, \beta)Beta(α,β) 来模拟每个拉杆的中奖率。
- α\alphaα:赢的次数 + 1
- β\betaβ:输的次数 + 1
汤普森采样步骤:
- 采样 (Sample):不看平均值,而是从每个拉杆的 Beta 分布里随机抽签产生一个数 θ^a\hat{\theta}_aθ^a。
- 竞争 (Argmax):选抽签数最大的那个动作。
- 贝叶斯更新 (Update):根据实际结果,更新该拉杆的 α\alphaα 或 β\betaβ(使分布变窄)。
4.3 科学意义
为什么它比 UCB 更强?
UCB 是根据数学不等式划定了一个硬性的“边界”,这在处理复杂、非线性奖励时往往过于保守。而汤普森采样利用后验分布进行采样,它天然地在探索(分布宽时容易抽到极端值)和利用(分布窄时抽值稳定)之间无缝切换。
5. 流派四:情境感知派 (Contextual Awareness)
代表算法:LinUCB (Linear UCB)
前三个流派都有一个共同的缺陷:盲目于环境。它们不看谁在拉杆,也不看现在是白天还是晚上。
但在现实中,给年轻人推荐科技新闻,给老年人推荐养生新闻,才是正道。
这就引入了上下文赌博机 (Contextual Bandits)。它是通向全功能强化学习的桥梁。
5.1 数学假设:线性关系
假设每个时刻我们拿到一个特征向量 xtx_txt(用户画像)。我们假设拉杆 aaa 的期望奖励是特征的线性组合:
E[r]=xtT⋅θa∗ \mathbb{E}[r] = x_t^T \cdot \theta_a^* E[r]=xtT⋅θa∗
我们需要估计未知的权重向量 θa∗\theta_a^*θa∗。
5.2 核心突破:岭回归与置信椭球
LinUCB 将 UCB 的思想扩展到了高维空间。它不再统计次数 NNN,而是利用岭回归 (Ridge Regression) 求解 θ\thetaθ,并计算预测方差。
其决策公式为:
At=argmaxa(xtTθ^∗a⏟∗预测分数+αxtTAa−1xt⏟不确定性) A_t = \underset{a}{\text{argmax}} \left( \underbrace{x_t^T \hat{\theta}*a}*{\text{预测分数}} + \alpha \sqrt{\underbrace{x_t^T A_a^{-1} x_t}_{\text{不确定性}}} \right) At=aargmaxxtTθ^∗a∗预测分数+α不确定性xtTAa−1xt
-
神奇的 A−1A^{-1}A−1:这里 AAA 是特征的相关矩阵。xTA−1xx^T A^{-1} xxTA−1x 衡量的是:当前这个用户特征 xxx,在过去的数据中是否常见?
- 如果常见(数据多),这一项很小 →\to→ 利用。
- 如果不常见(方向陌生),这一项很大 →\to→ 探索。
这是第一次,算法开始具有了**“泛化能力”**——它通过特征举一反三,而不是死记硬背每个拉杆。
6. 总结:四种智慧的殊途同归
| 算法家族 | 核心驱动力 | 数学本质 | 一句话评价 |
|---|---|---|---|
| ϵ\epsilonϵ-Greedy | 随机性 | 均匀分布采样 | “不管是啥,先试了再说。” (简单粗暴) |
| UCB | 乐观主义 | 霍夫丁不等式边界 | “只要没证明它差,我就假设它好。” (严谨理性) |
| Gradient | 软偏好 | 梯度上升 (SGD) | “我看你不爽就踩,看你爽就顶。” (进化论) |
| Thompson | 后验概率 | 贝叶斯推断 | “上帝掷骰子,我也掷骰子。” (道法自然) |
| LinUCB | 特征泛化 | 岭回归 & 矩阵代数 | “看人下菜碟,具体问题具体分析。” (走向现实) |
理解了这四种思路,你就掌握了强化学习中探索 (Exploration) 的所有底层逻辑。
下面是后四种方法的代码示例~
import numpy as np
import matplotlib.pyplot as plt

# ==========================================
# 1. 基础环境定义 (Environments)
# ==========================================

class BernoulliBandit:
    """
    经典多臂老虎机:奖励仅由拉杆的固定概率决定
    """
    def __init__(self, probabilities):
        self.probs = probabilities
        self.k = len(probabilities)
        self.best_prob = np.max(probabilities)

    def step(self, action):
        # 返回 1 (Win) 或 0 (Lose)
        return 1 if np.random.rand() < self.probs[action] else 0

class ContextualEnvironment:
    """
    情境老虎机环境:奖励由 (用户特征 * 拉杆权重) 决定
    用于测试 LinUCB
    """
    def __init__(self, n_arms, n_features):
        self.n_arms = n_arms
        self.n_features = n_features
        # 随机生成每个拉杆的真实权重参数 theta_star
        # 范围在 -1 到 1 之间
        self.true_thetas = [np.random.uniform(-1, 1, n_features) for _ in range(n_arms)]

    def get_context(self):
        # 模拟来了一个新用户,生成一个随机特征向量 x_t
        return np.random.uniform(-1, 1, self.n_features)

    def step(self, action, context):
        # 计算真实收益概率 (简单线性模型 + Sigmoid 归一化到 0-1 做概率)
        # 这里的逻辑是模拟:真实世界中,特征和权重的点积决定了点击率
        logit = np.dot(context, self.true_thetas[action])
        prob = 1 / (1 + np.exp(-logit))
        return 1 if np.random.rand() < prob else 0

# ==========================================
# 2. 算法类定义 (Agents)
# ==========================================

class UCBAgent:
    """流派一:确定性乐观派 (UCB)"""
    def __init__(self, k, c=2):
        self.k = k
        self.c = c
        self.N = np.zeros(k) # 每个拉杆被选次数
        self.Q = np.zeros(k) # 每个拉杆的平均奖励
        self.t = 0

    def select_action(self):
        # 优先选择从未选过的拉杆
        for a in range(self.k):
            if self.N[a] == 0:
                return a
        self.t += 1
        # UCB 公式
        uncertainty = self.c * np.sqrt(np.log(self.t) / self.N)
        return np.argmax(self.Q + uncertainty)

    def update(self, action, reward):
        self.N[action] += 1
        self.Q[action] += (reward - self.Q[action]) / self.N[action]

class GradientBanditAgent:
    """流派二:偏好梯度派 (Gradient)"""
    def __init__(self, k, alpha=0.1, use_baseline=True):
        self.k = k
        self.alpha = alpha
        self.use_baseline = use_baseline
        self.H = np.zeros(k) # 动作偏好
        self.prob_dist = np.zeros(k)
        self.avg_reward = 0  # 用于 Baseline
        self.t = 0

    def softmax(self, H):
        exp_H = np.exp(H - np.max(H)) # 减最大值防溢出
        return exp_H / np.sum(exp_H)

    def select_action(self):
        self.prob_dist = self.softmax(self.H)
        return np.random.choice(range(self.k), p=self.prob_dist)

    def update(self, action, reward):
        self.t += 1
        if self.use_baseline:
            self.avg_reward += (reward - self.avg_reward) / self.t
            baseline = self.avg_reward
        else:
            baseline = 0

        # 梯度更新: H = H + alpha * (R - avg_R) * (1 - pi)
        one_hot = np.zeros(self.k)
        one_hot[action] = 1
        self.H += self.alpha * (reward - baseline) * (one_hot - self.prob_dist)

class ThompsonSamplingAgent:
    """流派三:贝叶斯流派 (Thompson Sampling)"""
    def __init__(self, k):
        self.k = k
        self.alpha = np.ones(k) # Win + 1
        self.beta = np.ones(k)  # Lose + 1

    def select_action(self):
        # 从 Beta 分布采样
        sampled_theta = np.random.beta(self.alpha, self.beta)
        return np.argmax(sampled_theta)

    def update(self, action, reward):
        if reward == 1:
            self.alpha[action] += 1
        else:
            self.beta[action] += 1

class LinUCBAgent:
    """流派四:情境感知派 (LinUCB)"""
    def __init__(self, n_arms, n_features, alpha=1.0):
        self.n_arms = n_arms
        self.n_features = n_features
        self.alpha = alpha
        # 初始化 d*d 矩阵 A 为单位矩阵
        self.A = [np.identity(n_features) for _ in range(n_arms)]
        # 初始化 d 维向量 b 为零向量
        self.b = [np.zeros(n_features) for _ in range(n_arms)]

    def select_action(self, context_vector):
        x = np.array(context_vector)
        p_values = []

        for a in range(self.n_arms):
            # 岭回归求参数 theta
            A_inv = np.linalg.inv(self.A[a])
            theta = np.dot(A_inv, self.b[a])

            # 预测分数 + 置信区间
            prediction = np.dot(theta.T, x)
            uncertainty = self.alpha * np.sqrt(np.dot(x.T, np.dot(A_inv, x)))

            p_values.append(prediction + uncertainty)

        return np.argmax(p_values)

    def update(self, action, context_vector, reward):
        x = np.array(context_vector)
        # 更新 A 和 b
        self.A[action] += np.outer(x, x)
        self.b[action] += reward * x

# ==========================================
# 3. 实验运行与可视化 (Simulation)
# ==========================================

def run_experiment(agent, env, steps=1000):
    rewards = []
    cumulative_reward = 0
    avg_rewards = []

    for t in range(steps):
        action = agent.select_action()
        reward = env.step(action)
        agent.update(action, reward)

        rewards.append(reward)
        cumulative_reward += reward
        avg_rewards.append(cumulative_reward / (t + 1))

    return avg_rewards

def run_linucb_experiment(agent, env, steps=1000):
    rewards = []
    cumulative_reward = 0
    avg_rewards = []

    for t in range(steps):
        # 1. 获取当前用户特征 (Context)
        context = env.get_context()
        # 2. 基于特征选择动作
        action = agent.select_action(context)
        # 3. 执行动作
        reward = env.step(action, context)
        # 4. 更新模型
        agent.update(action, context, reward)

        cumulative_reward += reward
        avg_rewards.append(cumulative_reward / (t + 1))

    return avg_rewards

if __name__ == "__main__":
    # --- 实验 1: 经典算法大乱斗 (UCB vs Gradient vs Thompson) ---
    print("开始运行经典 MAB 实验...")

    # 设置真实概率:拉杆2 (索引2) 是最好的 (0.8)
    true_probs = [0.1, 0.4, 0.8, 0.2, 0.3]
    steps = 2000

    # 实例化算法
    ucb = UCBAgent(k=5, c=2)
    gradient = GradientBanditAgent(k=5, alpha=0.1)
    thompson = ThompsonSamplingAgent(k=5)

    # 运行实验
    # 注意:每次需重新实例化环境,保证公平(或者同一环境多次调用)
    res_ucb = run_experiment(ucb, BernoulliBandit(true_probs), steps)
    res_grad = run_experiment(gradient, BernoulliBandit(true_probs), steps)
    res_thomp = run_experiment(thompson, BernoulliBandit(true_probs), steps)

    # --- 实验 2: LinUCB 独立演示 ---
    print("开始运行 LinUCB 实验...")
    n_features = 5
    n_arms = 3
    lin_env = ContextualEnvironment(n_arms, n_features)
    lin_agent = LinUCBAgent(n_arms, n_features, alpha=0.5)
    res_linucb = run_linucb_experiment(lin_agent, lin_env, steps)

    # --- 绘图 ---
    plt.figure(figsize=(12, 5))

    # 子图1: 经典算法对比
    plt.subplot(1, 2, 1)
    plt.plot(res_ucb, label='UCB (c=2)')
    plt.plot(res_grad, label='Gradient (alpha=0.1)')
    plt.plot(res_thomp, label='Thompson Sampling')
    plt.axhline(y=0.8, color='r', linestyle='--', label='Optimal (0.8)')
    plt.title('Classic MAB: Average Reward over Time')
    plt.xlabel('Steps')
    plt.ylabel('Average Reward')
    plt.legend()
    plt.grid(True, alpha=0.3)

    # 子图2: LinUCB 学习曲线
    plt.subplot(1, 2, 2)
    plt.plot(res_linucb, color='purple', label='LinUCB')
    plt.title('Contextual Bandit: LinUCB Performance')
    plt.xlabel('Steps')
    plt.ylabel('Average Reward')
    plt.legend()
    plt.grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()

    print("运行结束,请查看生成的对比图。")
代码说明
-
运行方式:直接运行此脚本,会弹出一个包含两张图的窗口。
- 左图:对比 UCB、Gradient 和 Thompson Sampling。你会发现 Thompson Sampling 通常收敛极快(曲线迅速接近红色虚线)。
- 右图:展示 LinUCB 的学习过程。由于环境是随机生成的线性关系,你会看到它在短暂的震荡后,平均奖励会稳步上升,证明它学会了“看人下菜碟”。
-
LinUCB 的特别之处:请注意
run_linucb_experiment函数。与前三个不同,它在每一步select_action时都传入了context(模拟的用户特征),这正是它“情境感知”能力的体现。
如果你喜欢这篇博文,欢迎点赞、收藏、留言讨论!我们下期见。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 38
 0
- 0


 已为社区贡献2条内容

所有评论(0)